画像生成モデルは、自分が描くような椅子を画像から見つけられる?
Open Vision Bananaは領域分割と深度推定を画像編集の課題として扱います。研究用チェックポイント、評価条件、実際の確認方法を紹介します。
家具店が部屋の写真の背景を差し替えたいとします。編集者は椅子の輪郭、植物に隠れた箇所、ラグが椅子の脚の後ろまで延びているかを知る必要があります。画像生成モデルは新しい部屋をもっともらしく描けます。既存の椅子と周囲を分ける正確なマスクまで作れるかは、別の問題です。
Open Vision Bananaの著者は、2026年11月11日のプレプリントで、こうした画像認識の課題を画像編集として扱いました。40億および90億パラメータのFLUX.2 [klein] Base画像生成モデルを調整し、数種類の答えをRGB画像として出力します。マスクなら領域を示します。深度なら、表面同士の距離関係をモデルの表現に沿って符号化します。出力形式は共通でも、課題と誤差の測り方は異なります。
同じ基盤で複数の視覚タスクに取り組めますが、結果はタスクごとに確かめる必要があります。画像編集では、合成に耐えられるマスクか、近似した深度マップが編集に必要な前後関係を保っているかを確認します。この記事では部屋の写真を例に比較方法を見ていきます。
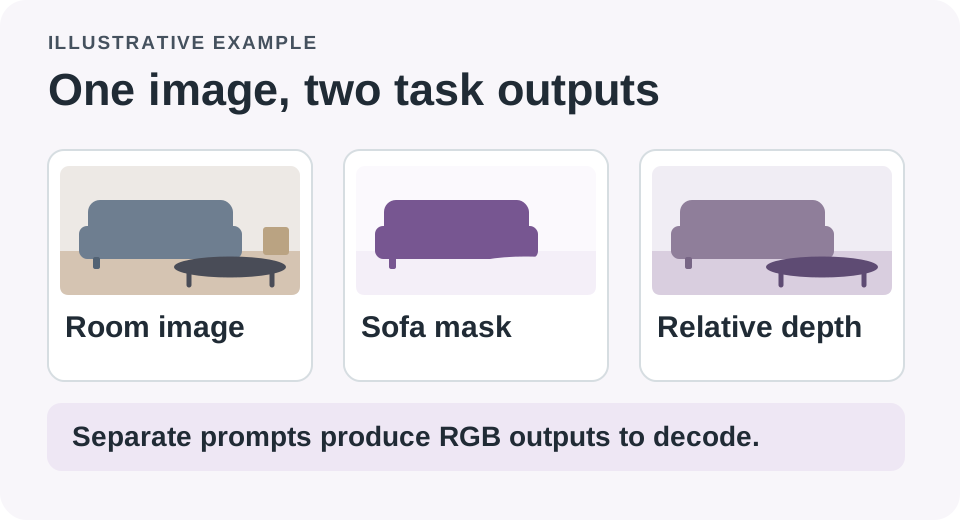
領域分割と深度は同じ出力形式を使いながら、一枚の画像について異なる問いに答えます。
一枚の画像から、異なる種類の答えを取り出せる
セマンティックセグメンテーションでは、椅子や床などのカテゴリを画素ごとに割り当てます。インスタンスセグメンテーションでは、同じカテゴリの別個の物体を分けます。左側のダイニングチェアと、よく似た右側の椅子を区別するということです。「窓のそばの椅子」といった説明を受け取り、それに該当する領域を探すのが、参照表現によるセグメンテーションです。深度マップは、見かけ上の距離によって場面を表します。このプロジェクトは、表面の向きを表す法線の推定にも対応しています。
Open Vision Bananaは入力画像とタスクを示すプロンプトを受け取り、答えを含む編集画像を生成します。領域分割のプロンプトでは、クラスと色を対応させる凡例を指定できます。生成されたラベルは凡例に従って読み取ります。深度出力には専用の復号方法と評価基準があります。著者は、プロンプト設計、色の符号化、パラメータ調整、複数の課題の組み合わせが学習の重要な要素だとしています。それぞれ有望な選択でも、すべて組み合わせて最善のマルチタスクモデルになるとは限りません。
部屋の写真では、椅子の輪郭を保ったまま背景を変えるためにマスクを使えます。別の素材を椅子の後ろ、壁の手前に置く構図なら、深度推定も確認に役立つ可能性があります。両者の品質基準は異なります。滑らかな深度画像でも、重なった植物を椅子の誤った側に置けば用途に合いません。椅子の大半を覆う見栄えのよいマスクでも、最終合成に必要な細い脚が欠けている場合があります。
| 出力 | 部屋の写真で確認する点 | プレビューで見落としやすい問題 |
|---|---|---|
| クラスマスク | 椅子の画素が床と壁から分かれているか | 細い脚や椅子の下の隙間が消える |
| 参照表現やインスタンスのマスク | 指定した椅子が他の椅子と分かれているか | カテゴリは正しいが別の個体を選ぶ |
| 深度推定 | 前景と背景が必要な前後関係を保つか | 滑らかでも、手前にある遮蔽物が別の物体の後ろへ移る |
ギャラリーでは著者の出力例を確認できます。上記は説明用に設定した場面です。自分が編集する部屋の写真で切り抜きを試す方が、選ばれたきれいな例を眺めるより、作業への適性が分かります。
高いスコアには評価条件がある
著者はCityscapesのセマンティックセグメンテーションで、ゼロショットの9Bモデルが73.9 mIoUを記録したと報告しています。先行するVision Bananaの報告値は69.9でした。mIoUは、予測領域と参照領域の重なりをベンチマークに沿って平均した指標です。公式の評価資料によると、Cityscapesの結果には凡例を使ったアンサンブルを20回適用しています。実行ごとに同じカテゴリへ別の色を割り当て、結果を統合します。一度と二十度では、かかる時間も費用も変わります。
論文には、モデルの重みを変えず、投票によってスコアが上がった例が示されています。著者によるベンチマークの条件で得られた結果です。自分の写真では、まず単純な設定で実行し、追加の実行が気になる問題を改善するか調べます。毎回、細く透けた縁を取りこぼすなら、多数決でより適切なツールの代わりはできません。プロンプトや凡例とカテゴリの対応が不安定な場合に役立ちます。この手法が想定したのは、その種の問題です。
プロジェクト文書は、ゼロショットと非ゼロショットの学習データの構成も区別します。非ゼロショットの構成には評価ベンチマークの学習用分割を含められます。プロジェクトの説明では、ゼロショットの構成からは該当する学習用分割を除きます。似た数字だけを見出しで比較するとこの違いを見落とします。また、一部のインスタンスセグメンテーションの評価では、対象が写っているかを別モデルで判定し、ReasonSegではクエリを書き換えます。論文によると、インスタンスセグメンテーションではVision Bananaとの開きが依然として大きいです。総合順位を決める表として読む前に、各タスクで何をどう測ったか確認します。
深度の数字にも条件があります。プロジェクトのNYUv2評価では、画像ごとに視差を整合させます。これにより、評価手順に沿って相対深度の主要な性質を比べられます。整合後のスコアが高くても、巻き尺で測るような絶対距離が求まるわけではありません。デザインの段階で前後関係を確認することはできますが、実寸、ロボットの通過余裕、物理的な安全の判断には、それぞれの目的に合わせて設計・検証されたシステムの根拠が必要です。
見栄えがよくても、境界や重なった領域は用途別に確認します。
編集モデルの共通化で接続コードは減っても、別の手間がかかる
あるタスクで専用モデルが優位でも、この方法を試す理由はあります。一つの研究で同じモデル系列を使い、領域のマスク、深度画像、編集案を似た手順で要求できる可能性があります。論文では、調整後のモデルも基盤の画像編集能力をおおむね保ったと報告しています。同じシステムで関連する入力を使い、マスクと編集案を作る実験ができます。現行のツールを外す前に、両方の出力を確かめます。
同じ対象に対し、生成モデルでの実行と専用マスクモデルを比較します。編集ソフトが受け取れるアルファマスクへ正しく変換できるか記録します。髪の毛、ガラス、空隙、影の間違いは、大きな不透明面の間違いと分けて集計します。机の写真なら一度の実行で足りるかもしれません。光を反射する家具が並ぶカタログでは、検査と修正の時間が、モデルを統一する便利さを上回ることがあります。
4Bと9Bのチェックポイントには、どちらもゼロショット版と非ゼロショット版があります。小さいチェックポイントは限られた評価を試す候補ですが、必要なメモリが決まるわけではありません。処理全体の使用量はパイプライン、解像度、精度、実行環境、反復回数に左右されます。モデル変更と設定変更を混同しないように、これらの条件を記録します。最短の予測時間より、使える出力に届くまでの総時間を比べます。
チームはコードとセットアップ手順、結果のギャラリーを公開しています。リポジトリによると、コードはApache 2.0で、公開された重みはFLUX Non-Commercial Licenseです。データには元のライセンスが適用されます。重みをダウンロードできるので研究に使えますが、商用カタログにそのまま使えるとは限りません。以下の比較で手法を理解し、採用前に予定の使い方に合う許可を確認します。
失敗を見た目で判断できる写真から始める
短時間の研究比較なら、対象を増やす必要はありません。自分で撮った写真か処理が認められている写真を使い、モデルに聞かなくても対象とおおよその前後関係が分かるものを選びます。輪郭が分かりやすい例と、重なりが判断しにくい例を入れます。比較する実行では画像サイズとタスクのプロンプトを固定します。選ばれたサンプルでしかうまく機能しないかもしれない工程を広げる前に、どの課題で何を間違うかを知ることが目的です。
- 少数の対象物と遮蔽部分を手作業で印付けします。実際には写っていない対象も一つ含め、もっともらしい誤検出を見つけやすくします。
- チェックポイント、プロンプト、画像サイズ、反復回数を決めて記録します。同一画像を使い、専用モデルと共通モデルを比較します。
- マスクや深度の最終出力は、想定した編集の中で確認します。切り抜きであれば、マスクだけを見るより、コントラストの高い背景に合成します。
- 修正時間と頻出する問題を記録します。共通モデルで編集作業が増えたり、重大な間違いに気付きにくくなったりする場合は、現行の専用ツールを維持します。
ある候補がよくないマスクを返す一方、元の画像の編集では説得力のある出力を作ったら、両方を記録します。それぞれ別の問いに答えるからです。複数のタスクを扱うと、平均点が、次の工程をやり直させる一つの弱い出力を見えにくくすることがあります。試験では一枚のスライドに並べる機能の数を増やすより、新モデルで確実に支援できる判断を少数選びます。
編集者にとって大切な事例は数えておきます。例えば、脚やフレームを手作業で修正した椅子の数、比較で前後関係が保たれた場面の数などです。手元の写真10枚で、広い範囲の精度を証明することはできません。ただ、実際の入力で何度も同じ失敗を起こすと分かれば、公開ベンチマークの平均では埋もれやすい問題を早い段階で発見できます。
処理の末端から何が出るかも比較します。RGBの可視化画像として出力されたマスクを透明度として使うには、変換が必要なことがあります。変換後も指定したクラスの凡例が保たれるか、保存した画像に解釈があいまいな画素ができるかを確認します。変換の不具合をモデルの失敗と取り違えないように、生成画像と変換後のマスクは分けて保存します。新しい色の凡例を試したら結果と一緒に保存し、後から画像内の色が何を示すか分かるようにします。
もう一つの例は、参考画像のライブラリです。「棚と棚の間にあるランプ」を探すデザイナーにとっては、公開用に求められる画素単位の精度がなくても、該当しそうな領域の提案が役立ちます。確信度の高そうな切り抜きを自動で返す方法より、候補をいくつか示して人が選べる方が使いやすいこともあります。導入基準は用途によって変わります。ムードボードに載せる候補をたまに見落とすときと、合成担当に輪郭がわずかに欠けた素材を渡すときでは、失敗の費用が違います。
見栄えと認識の正しさは別々に判断する
制作での用途があると、出力に果たしてほしい役割が明確になります。編集者が必要とするのは、領域らしく見える絵より、合成で実際に正しい境界を保てる領域です。Open Vision Bananaでは同じ系列のモデルでいくつかの課題に取り組めます。手法を検証できるだけの学習情報も公開されています。背景を変えた後も椅子の脚が4本とも残るか。それだけでも試せます。
出典
画像認識の作業フローを評価するときは、試験写真、プロンプト、比較メモを一か所にまとめましょう。Telli.shで最初のノートを始める。