ローカルAIが話し始める。OllamaのPhonon対応で何ができるようになる?
OllamaがGradiumのPhononによるローカル音声生成に対応。役立つ音声の使い方、現時点のmacOSという制約、最小モデルのライセンスを確認すべき理由を考えます。
ローカルの言語モデルが出す答えは、今もたいていターミナルやチャット画面の文字で終わります。質問を続けることはできても、画面を見続ける必要があります。回答を読み上げようとすると、別のアプリ、別のAPI、あるいはもう一つの手順が必要になります。
Ollamaが2026年10月24日に発表した更新は、そのローカルの流れに音声生成を加えます。最初に対応する音声モデルの系列は、Gradiumが開発した Phonon です。コマンドラインやOpenAI互換の音声エンドポイントを通じて文章を音声に変えられ、言語モデルの回答を音声モデルへ直接渡すこともできます。公式発表。
まだ使ったことのない読者向けに説明すると、Ollamaは自分のコンピューターにモデルをダウンロードして実行し、ローカルAPIから利用できるツールです。今回の更新に意味があるのは、その環境で音声がもう一つのモデルの能力になるからです。ローカルAIが声で返事をする道が開かれます。ただし重要な制約があります。発表された音声対応は現時点ではmacOS向けで、Phononの系列内でもモデルごとにライセンスが異なります。
 Ollama公式マーク。Ollamaリポジトリ、MITライセンスによるものです。縦横比を保ち、白地にラスター画像化しています。製品を識別する画像であり、スクリーンショットや生成音声ではありません。

役立つ声は、控えめな約束から始まる
すぐに使える能力は、テキストからの音声合成です。言葉を渡すと、合成された音声が返ってきます。生成された回答を耳で聞きやすくしたり、文書を個人的に聞くための下書きにしたり、ホスト型の音声サービスを最初から使わずに、開発者が音声インターフェースを試作したりできます。
それだけで、完全な音声アシスタントができるわけではありません。マイクから音を取り込むこと、話し終わりを判断すること、音声認識、再生の中断、許可された操作の判断は、アプリケーションの別々の部分です。流暢な声は、未完成のシステムを、実際以上に完成したもののように感じさせることがあります。
この違いは、最初に何を作るか決める際に役立ちます。承認済みの一段落を読み上げるのは、範囲の限られた作業です。依頼を聞き、非公開の資料を検索し、ツールを選び、結果を話すシステムには、はるかに幅広い責任があります。Phononはそのシステムの出力の声を提供できますが、手前の処理の正確さや権限を保証するものではありません。
そのため、最初の用途として有望なのは、文章の境界が分かりやすいものです。読み上げる内容を確認し、表現が適切か判断してから音声を生成できます。この単純な仕組みなら、声が実際の作業を改善するかどうかを確かめやすくなります。
提供開始時点には、プラットフォームと言語の境界がある
提供開始時の手順は、 Apple Silicon搭載MacとOllama 0.40.11以降 を条件とし、WindowsとLinuxへの対応は今後としています。ほかのOSでOllamaを使っている読者は、現在のインストール環境で、発表された音声の流れがすでに使えると思い込むべきではありません。ウェブ上でモデル一覧が見えることと、すべてのプラットフォームで実行機能が使えることは別の事実です。
Phononのライブラリページでは、モデルの選択肢も区別されています。基本のPhononモデルは英語向けとして紹介されています。40M系列には、英語、フランス語、ドイツ語、スペイン語、ポルトガル語の言語別モデルと、その五つを扱う多言語モデルがあります。
この一覧は、あらゆる言語の音声に対応するという主張ではありません。韓国語は挙げられた五言語に含まれないため、今回の提供開始によって韓国語の音声が使えるとまでは言えません。
英語を耳で聞く作業と、多言語の製品では、必要な評価が異なります。前者なら、自分の英語のメモを明瞭に読む声があればよいかもしれません。後者では、使うモデルの対応言語、固有名詞、発音、文中で言語が切り替わった際の動作を確かめる必要があります。言語名が付いているだけでは、こうした事例のすべてがうまく動くとは証明できません。
小さなモデルでも、利用条件は同じとは限らない
モデルの系列には、サイズだけを見ていると見落としやすいライセンスの違いがあります。基本のPhononモデルは Apache 2.0 、 40Mの各モデルはCC BY-NC 4.0 と記載されており、後者には非営利の制限があります。モデルとライセンスの情報。
つまり、最小のダウンロードが、商用製品にとって最も簡単な選択になるとは限りません。コンパクトなモデルは、控えめな性能のマシンでの実験には魅力的でも、そのモデルの利用条件が有料サービスや顧客の本番アプリに合わない場合があります。
| 確認する選択肢 | 変わる点 | 採用前に確かめたいこと |
|---|---|---|
| 基本のPhonon | Apache 2.0表記の英語音声モデル | 実際にダウンロードするモデル、表示義務、追加の音声素材 |
| 言語別の40Mモデル | 一覧にある一言語向けの小型モデル | 非営利の制限と、自分の資料での発音 |
| 40M多言語モデル | 一覧の五言語を扱う一つの小型モデル | 同じライセンス制限に加え、言語切り替えと混在時の動作 |
これは実務上の製品判断であり、特定のライセンスだから音声の性能が優れているという話ではありません。品質、実行コスト、許される用途は別々に比較してください。導入メモに単に「Phonon」と書くのではなく、試したモデルを正確に記録しましょう。
コマンドラインで新しい流れが見える
対応するmacOS環境について、公式発表は次の直接的なコマンドを示しています。
ollama run phonon "Hello from Ollama."
文章モデルの出力を音声へ渡す例もあります。
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon
これらは発表された使い方の例であり、私たちのハードウェアでの実測結果ではありません。興味深いのはパイプ接続です。一つのモデルが言葉を作り、もう一つが声を作ります。回答を短くし、内部の推論を読み上げる入力から除くと、受け渡しを理解しやすくなります。
発表には、生成音声をWAVファイルへ保存する例もあります。
ollama run phonon "Save this to a file." > speech.wav
対応環境で記載されたコマンドを使い、その結果のファイルを確かめてから、一括処理を組みましょう。音声ファイルが存在するだけでは、すべての文を読み上げたか、冒頭が欠けていないか、重要な数字を正しく発音したかまでは分かりません。
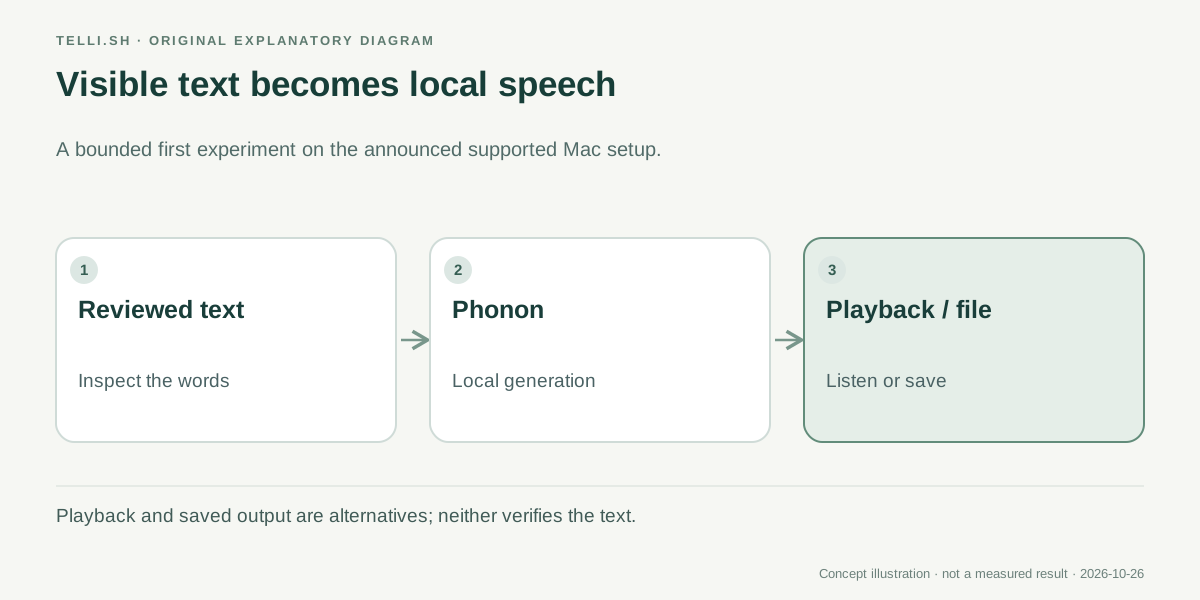 最初に役立つ境界は、目に見える文章です。音声は回答の伝え方を変えますが、回答そのものを独立して検証するわけではありません。
例1:送信前に文書を耳で確認する
英語のプロジェクト報告を確認しているコンサルタントを想像してください。文書には、何が変わり、何が不確かで、顧客に何を承認してもらう必要があるかが、密度の高い説明で書かれています。画面で読むと問題がなくても、聞いてみると、長すぎる一文や、追いにくい話のつながりに気付くかもしれません。
ローカルの音声モデルなら、その確認済みの文章を、耳で聞くための下書きにできます。コンサルタントは実際の表現を聞きながら、元の文書を修正します。音声モデルに要約を考えさせたり、重要な記述を選ばせたりする必要はありません。
利点は具体的です。文章を見直す方法が一つ増えます。聞く方が好きな人や、視覚と音声の作業を切り替えたい人にも役立つかもしれません。ただし、完全なアクセシビリティ対応を提供する証拠ではなく、生成音声が、対象となる人々の特定のニーズに必要な確認に代わるべきではありません。
この例では、プライバシーも考えやすくなります。音声生成が本当にローカルのプロセス内で完結するなら、その生成段階で文書をホスト型の音声事業者へ送る必要はありません。それでも、全体の流れにはクラウドのエディター、遠隔の言語モデル、テレメトリー、共有ストレージが含まれる場合があります。「ローカル音声」は一つの処理の境界を説明する言葉であり、周囲のすべてのアプリを説明するものではありません。
例2:文字でも確認できる音声回答を試作する
語学学習や案内端末の小さな試作品を作る開発者を考えてみましょう。アプリは短い回答を生成し、文章を表示して、聞くためのボタンを用意します。利用者は目で見る内容と耳で聞く内容を比べられ、開発者は、どの文章が音声モデルへ入ったかを推測せずに失敗を調べられます。
ここで関係するのが、ローカルの実行環境から提供される、OllamaのOpenAI互換 /v1/audio/speech エンドポイントです。公式発表は、アプリへ音声生成を組み込む方法として紹介しています。すでに音声APIを前提にしたソフトウェアでは、互換性によって接続の手間が減る可能性があります。ただし、遠隔の事業者が提供するすべてのオプションが、同じ形でローカルに実装されている証拠ではありません。
まずは、ドキュメントにあるモデル、音声、応答の動作から始めてください。アプリが特定のストリーミング形式、中断の動作、音声エンコーディングを必要とするなら、その条件を正確にテストします。一行のリクエストに成功しても、長い対話セッションが正しく動くとまでは言えません。
語学学習の例なら、対応する一言語と、確認済みの少数の文から始めます。固有名詞やなじみの薄い単語は別にテストしましょう。利用者が任意の文章を入力できる場合は、非対応の文字体系、極端に長い入力、共有の場所で読み上げるべきではない内容を、アプリがどう扱うかも決める必要があります。
最初の試用から判断材料を得るには
実験は、次の行動につながる問いに答えるとき、最も役に立ちます。「音が出るか」はインストールの確認には適していますが、採用基準としては弱いものです。文章作成ツールには、段落を理解して聞けることが必要です。対話型の試作品では、待ち時間が許容範囲で、確実に停止できることも求められます。
- プラットフォームと実行環境を確認する。 最新のOllama音声ドキュメントを確認します。提供開始時の手順では、Apple Silicon搭載MacとOllama 0.40.11以降が指定されています。今後対応すると発表されたプラットフォームは、将来の提供として扱います。
- 使うモデルを正確に選び、ライセンスを確認する。 ダウンロードサイズや速度を比べる前に、タグ、言語、意図する用途を記録します。
- 代表的な文章を用意する。 短い文、段落、数字、固有名詞、実際の作業で難しい事例を含めます。入力はそれぞれ保存します。
- 出力を最後まで聞く。 脱落、発音、不自然な間、単語の繰り返し、末尾まであるかを確認します。即時再生だけでなく、保存したファイルも試します。
- 自分のコンピューターで使い心地を測る。 マシン、モデル、入力の長さ、使える音声が出るまでの時間を記録します。同じ素材で選択肢を比較します。
- 確認と再生を分ける。 機密性の高い表現や、結果に影響する表現は、アプリが読み上げたり音声ファイルを配布したりする前に、人が確認できるようにします。
この手順に、大規模なベンチマークは必要ありません。小さなチームでも、範囲を絞った作業にローカル音声が十分役立つか、次にどの制約を調べるべきかを、繰り返し判断できます。
速度の主張には、テスト条件が必要
Ollamaの発表には、性能と音声品質の比較が含まれています。これは、記載されたモデル、ハードウェア、評価条件におけるベンダー報告の結果です。何を調べるかの手掛かりにはなりますが、別のコンピューター、別の声や言語でも同じ遅延になるという約束ではありません。
スループット と 最初に聞こえる音声が出るまでの時間 は分けてください。長い文章の全体を速く生成できるモデルでも、短いやり取りでは、始まるまでの待ち時間を長く感じることがあります。オーディオブックの下書きを一括で作る場合と、会話の返事では、この二つの測定値の重要度が異なります。
品質の測定にも文脈が必要です。生成音声に対する単語認識は、聞き取りやすさの問題を見つける助けになります。しかし、誤り率が低いだけでは、話す速さ、表情の豊かさ、固有名詞が聞き手にふさわしく聞こえるかを完全には評価できません。製品が実際に話す内容では、人が聞く評価も役立ちます。
この記事では、複数のマシンにまたがる独立した比較を実施していません。そのため、実務上の期待は、すべてのホスト型・ローカル音声システムに勝ったという宣言ではなく、評価できる新しいローカルの選択肢が増えたということです。
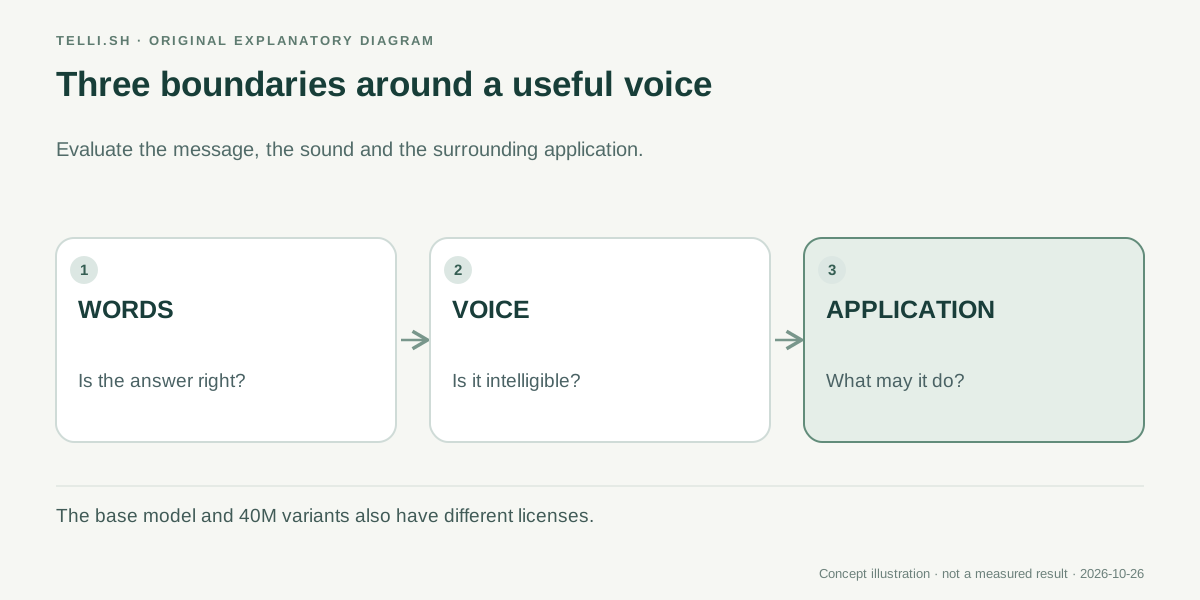 言葉、声、アプリは別々に確認しましょう。明瞭な声は、正しい答えと同じ明瞭さで、間違った答えも伝えられます。
ローカル音声は、この先何を変え得るか
今回の更新で期待できるのは、接続が当たり前のものになり得ることです。ローカルのモデルが短い説明を書き、別のモデルがそれを読み、アプリは確認できる文章を残す。音声は、コピーした文章を渡す別の行き先というより、組み合わせられる出力の能力に見えてきます。
ローカルでの文章の見直し、個人的に聞くための下書き、小さな音声インターフェースを試しやすくなるかもしれません。入力を理解するモデル、範囲を限った判断をするモデル、確認した結果を話すモデルなど、複数の専門モデルを組み合わせるアプリも促す可能性があります。
次の試験は具体的です。OS対応が広がれば、試せる人が増えます。対応言語が増えれば、届けられる相手が変わります。中断、音声の扱い、組み込みが改善されれば、対話型アプリの自然さが変わります。それぞれ異なる改善であり、実際に利用できるようになった時点で判断すべきです。
今のところ、OllamaのPhonon対応は、有用な最初の一歩を提供します。確認できる短い文章をローカルAIに話してもらい、その作業が、聞くことで良くなるかを判断する。声と同じように、モデルのライセンスとプラットフォームの制約も、見える場所に置いておきましょう。
出典
- Ollama:Speech models、2026年10月24日。
- Ollama:Phononモデル一覧とライセンス、2026年10月26日確認。
実験に使った文章、聞いたときのメモ、モデルの選択を検索できる記録に残しませんか。資料をTelli.shに集め、いつでも戻れるノートに育てましょう。