NVIDIA Speech Skills:専門用語を間違えるASRを、手順から改善する
NVIDIAの音声適応スキルを紹介。専門用語の誤りの調査、データ準備、必要に応じた学習、改善の評価を開発エージェントがどう支援するかを解説します。
文の構造は正しいのに、重要な名前だけが間違っている。専門家ならすぐに意図が分かる言葉を、音声モデルは普通の単語に置き換えます。改善するには、「どのモデルが最良か」より具体的な問いが必要です。
NVIDIAが2026年10月13日に公開したSpeech Agent Skillsのチュートリアルは、自動音声認識、ASRを特定の分野へ適応させる手順を示しています。上位スキルが問題を整理して作業を調整し、NeMoの専門スキルが対応する学習と評価を担当します。具体例は航空管制の音声です。NVIDIAチュートリアル
この記事では、スキルが何を加え、どんなときに学習を検討し、最初の実験をどう計画するかを説明します。大規模な学習から始める必要はありません。どの語が間違い、なぜ重要で、次にどの対策を試すべきかが明確になるだけでも有用です。
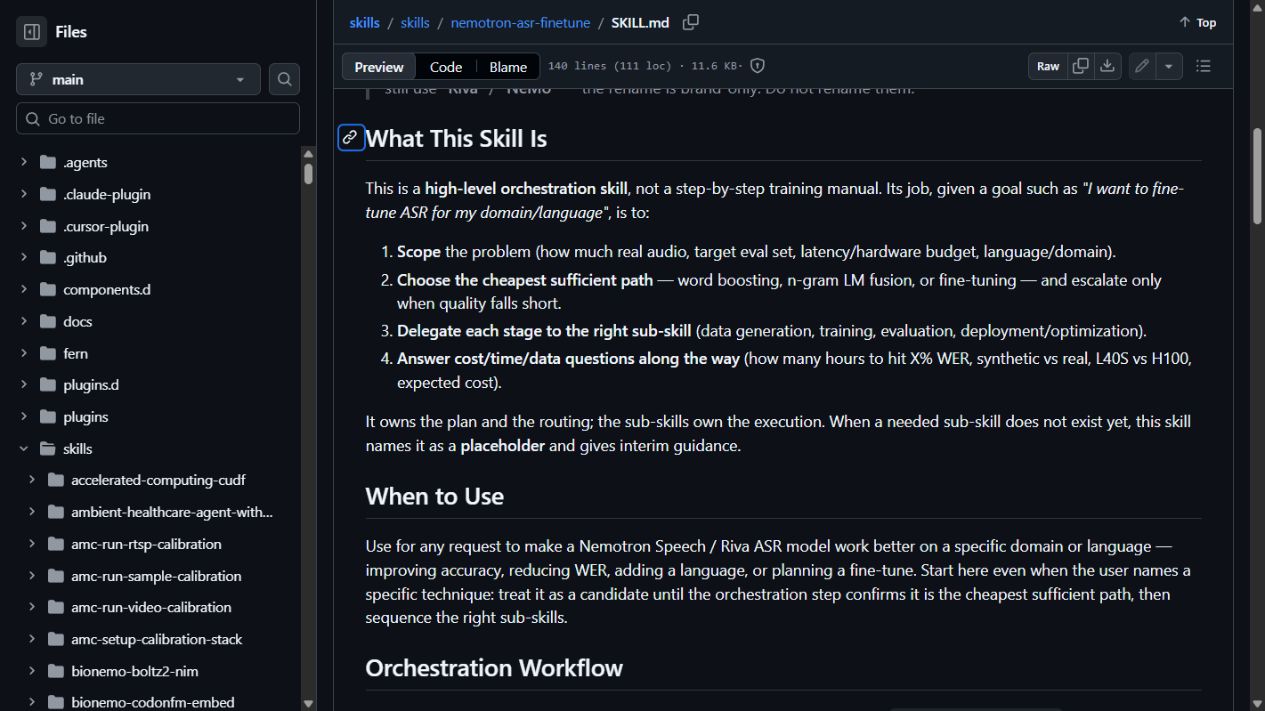 2026年10月20日に撮影したNVIDIAの公開スキル文書。文書© NVIDIA、CC BY 4.0に従って出典を表示しています。スキルの指示であり、学習実行の画面ではありません。
スキルは、モデルを使う作業を組み立てる
モデルは学習済みパラメータを持ちます。学習フレームワークはパラメータを更新する仕組みを提供します。エージェントスキルは、開発支援AIが作業手順を選び、実行するための指示です。指示を入れるだけで、全フレームワークやチェックポイントが導入されたり、GPUで実験可能だと分かったりするわけではありません。
チュートリアルは、調整用のnemotron-asr-finetuneと、専門用のnemo-speech-asr-finetuneを分けています。前者が目標を整理して作業を振り分け、後者が学習やオフライン評価に適した場合のNeMo固有の実行を担当します。作業手順の説明
「認識を改善する」には複数の仕事が含まれるため、この分担が役立ちます。語彙の問題にはデコード時の支援、話し方や音響条件のずれには適応が適しているかもしれません。前処理の設定ミスなら、どちらより先に修正が必要です。
スキルを実験の調整役と考えましょう。目標、入力、比較をそろえる支援はできますが、成功の意味は人が定義します。最終成果は、AIが「学習完了」と言うだけでなく、確認できる根拠であるべきです。
意味を変えてしまう誤りから始める
検査時に少数の製品コードを読み上げる企業を考えます。普通の会話は認識できても、似たコード2つを繰り返し取り違えます。最初に役立つデータは、その混同例、元音声、確認済みの参照書き起こしです。
別の例は、人名や専門用語を含むインタビュー資料です。難しさは話者、マイク、話題で変わります。表記規則と音響的な誤りを分け、同じ略語の2通りの表記を、自動的に別の認識失敗と数えないようにします。
3つ目は、雑音の多い回線で録音した機器サポート音声です。語彙リストで一部の用語は改善しても、欠けた音節は戻らないかもしれません。言語上の期待と、モデルへ実際に届く音を区別すると、分野適応の課題が明確になります。
これらは作業手順の応用案であり、導入報告ではありません。目標の一文だけでなく、例が必要な理由を示しています。よく理解した十数件の誤りでも、次がデータ整備、語彙支援、本格的な適応研究のどれかを見極められます。
誤りに届く、最も軽い対策を選ぶ
公開の調整スキルは、単語ブースト、言語モデル支援、微調整へと進み、十分な方法を選んでから次へ進む流れを説明します。これは計画の原則で、すべてのモデルや実行環境に同じ設定があるという保証ではありません。スキル文書
| 観測された問題 | 対策の候補 | 比較するもの |
|---|---|---|
| 既知の用語が一般語に負ける | 対応する語彙支援・単語ブースト | 対象用語の精度と不要な挿入 |
| 分野固有の言い回しが選ばれにくい | 対応する言語モデル・デコード支援 | 分野の精度と通常音声の精度 |
| 分野の話し方・回線に弱い | 音響モデルの適応 | 未使用の分野音声と一般音声 |
| 設定変更後に精度が急落した | 前処理の互換性を戻して検証 | 同じ重み・音声での両設定 |
表は判断の補助で、診断そのものではありません。似た一般語が頻出すると語彙追加が新たな誤りを生む場合があります。微調整は専門分野を改善しながら、別の音声を悪化させるかもしれません。欲しい効果と、避けたい副作用を測ります。
書き起こしと後段の修正も分けましょう。言語モデルが不自然な句をもっともらしく直しても、実際の発話を復元した証拠にはなりません。音響認識を独立して評価できるよう、元の認識結果を残します。
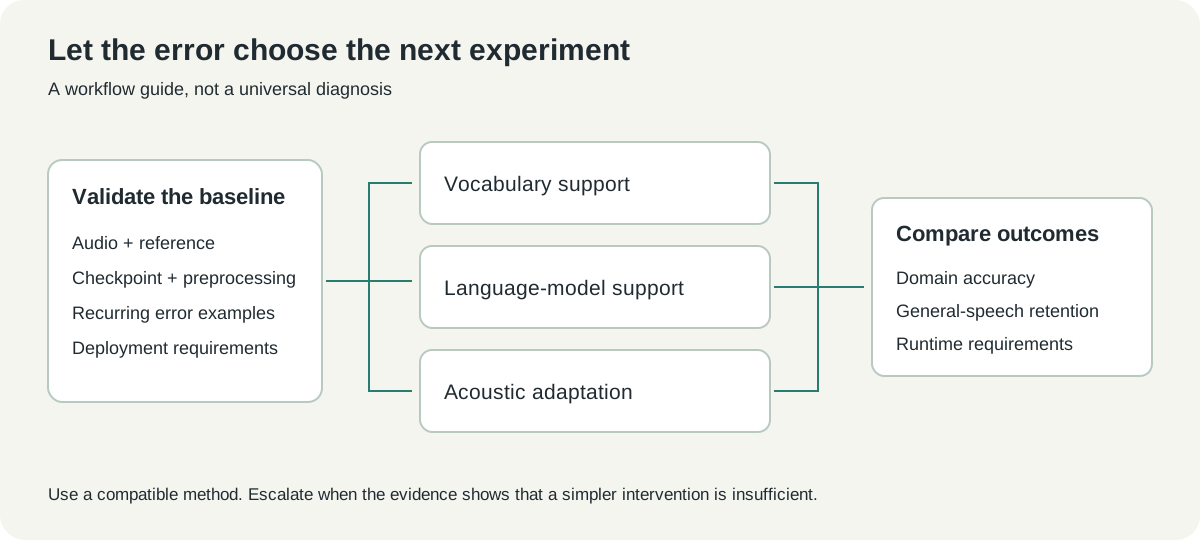 公開手順に基づく独自の判断図。候補の紹介であり、どれか1つが全認識器に合うという主張ではありません。
報告された改善には、明確な分母がある
NVIDIAの事例では、人手注釈付き2時間のATCO2テストセットでNemotronの単語誤り率が77.00%から22.46%へ下がり、相対70.8%の削減と報告されています。一般英語のWERは3.50%から3.63%になりました。これらは、その実験条件における公開元の結果です。10月13日のチュートリアル
単語誤り率は、参照語数に対する置換、脱落、挿入を数えます。1つ以上誤りのある文の割合ではなく、相対削減率もパーセントポイント差ではありません。区別すると、結果を公平に比べやすくなります。
この例は、対象分野と別の分野を両方示す点が有用です。専門分野の結果だけでは、必要な通常音声の能力を保ったか分かりません。一般分野の小さな変化も、話から消さず、改善と並べて読むべきです。
マイク、言語、書き起こし規則が変われば結果も大きく変わります。見出しの数値は、基準を測り、条件を管理して適応し、未使用データを採点する方法の動機にしましょう。自社の通話でも同じ割合の誤りが消えるという約束にはできません。
教えるデータと、判定するデータを分ける
適応データには別々の役割が必要です。学習例はモデルを変え、開発例はチェックポイントやデコード設定を選ぶために使います。テスト例は、その選択後にシステムを評価します。
短い断片をランダムに分けると、独立性を誤認することがあります。同じ録音の2断片は、話者、回線、文言、背景音が共通かもしれません。可能なら、録音、話者、収集セッションなど、運用で重要な単位を基に分けます。
参照表記の規則も明示します。数値、略語、句読点、ためらい音の表記を採点前に決めてください。出力が「twenty one」、参照が「21」なら、聞き手の理解が同じでも正規化次第でスコアが変わります。
入門では大規模収集を急がず、小さな一覧を作ります。音声の出所、許可される用途、書き起こしの確認者、データの役割を記録しましょう。ファイル名だけが来歴を示すフォルダーより、明確な一覧の方が確認しやすくなります。
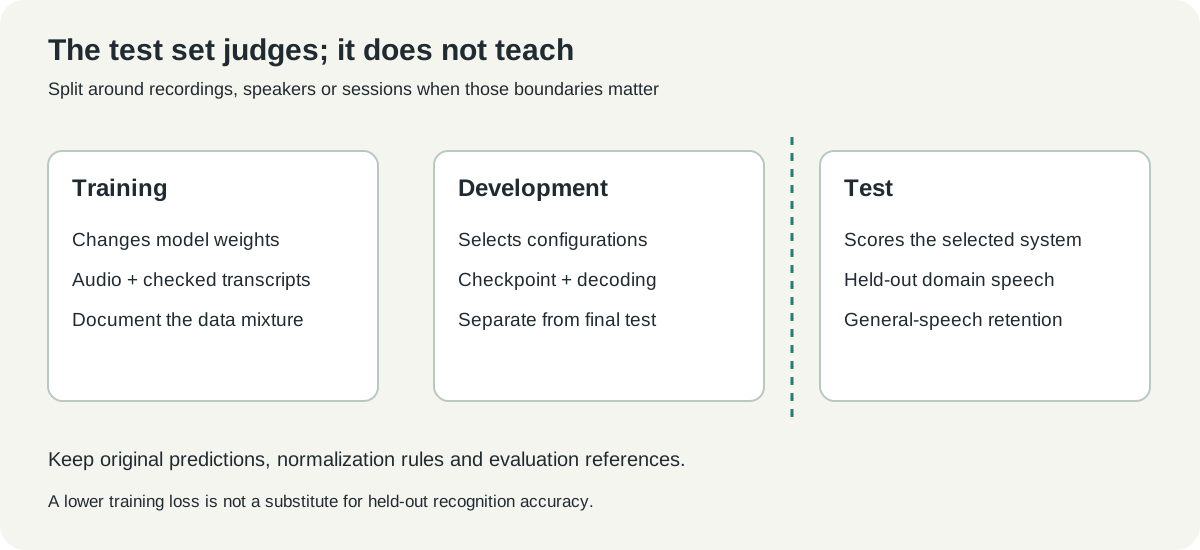 独自の解説図。テスト経路は学習とチェックポイント選択の外に保ち、一般音声の維持も分野の評価と併せて測ります。
最初は、計画と基準測定を依頼する
観測可能な目標を含めると、スキルを有効に使えます。「検査の書き起こしを改善して」だけでは、認識器、言語、運用方法、誤りの費用が曖昧です。詳細を加え、範囲を区切った最初の段階を依頼しましょう。
たとえば、次のような依頼が考えられます。
利用許諾のある少数の検査録音と参照書き起こしを調べてください。繰り返す用語の混同を特定し、現在の認識器と前処理を検証し、基準性能を測定してください。語彙支援と学習案を比較し、テストセットは未使用で保ってください。長い実行の前に、分野の精度、一般音声の維持、必要なリソースを報告してください。
この例は、エージェントが返すべき根拠を定義しています。データが選択を支えるまで手法も開いたままです。特定のチェックポイントを任意のステップ数だけ微調整する命令から始めるより、通常は生産的です。
最初の報告には、正確なチェックポイント、実行設定、評価セット、繰り返す誤りが必要です。現在どこが進展を妨げているかも説明します。サンプリング設定の誤りによる悪い書き起こしと、未知の話し方による誤りでは修正が異なります。
指示と実行環境の依存関係を、別々に導入する
チュートリアルは調整スキルと専門スキルに別のインストールコマンドを示しています。前者が後者を参照していても、自動では入りません。以下はその選択手順です。リポジトリを確認し、聞かれたら意図した導入範囲を選んでください。
npx skills@latest add NVIDIA/skills --skill nemotron-asr-finetune
npx skills@latest add NVIDIA-NeMo/Speech --skill nemo-speech-asr-finetune
npx skills@latest list
導入後は新しい開発エージェントのセッションを開き、想定するスキルが利用可能か確認します。これは指示を発見できるという確認です。マシンがチェックポイントを読み込めるか、学習できるかはまだ分かりません。
文書の構成ではLinux GPUホストと、版を固定したNeMo Speechコンテナー26.07.00を使用しています。ホスト準備の前に、現在のイメージのドライバー、GPU、フレームワーク要件を確認します。ノートPCに入れたスキルは、実行環境の代わりにはなりません。環境準備
最初の環境確認は小さく絞ります。学習予算を割く前に、インポート、GPU認識、チェックポイント読込、短い推論を確認します。後の結果を生成元のソフトウェアと結び付けられるよう、版とコンテナーを記録してください。
ストリーミングとオフラインは別に比較する
ストリーミング認識器は音声の到着中に出力します。オフライン認識器は録音後に別の実行方式を使えます。どちらも書き起こしますが、レイテンシ、文脈、デコードが異なるため、1つのスコアで完全には比較できません。
ライブ用途では、部分結果がいつ出て、いつ安定し、確定文がどう届くかを記録します。遅すぎる高精度の書き起こしは、ライブ字幕に向かない場合があります。アーカイブなら、最終記録がよくなる遅めのオフライン処理を許容できます。
中心となる比較では、適応前後を同じモードにします。分割、デコード、重み、テキスト正規化まで変えると、改善の原因が分かりません。別の処理全体を比較したいなら、別の実験を加えてください。
後段評価にも同じ規律が役立ちます。話者ラベル、時刻、認識語は別の出力です。WERがよくても重要発言の話者が違うことはあるため、用途に必要な能力を別々に評価します。
評価済みのモデルは、成功した学習ログ以上のもの
学習損失の低下は、最適化が目的に適合していることを示します。新しい話者を正確に認識する証拠ではありません。有用な成果物は、選んだチェックポイントと、その設定、予測、評価結果です。
元のモデルを残し、同じ手順で採点します。専門家が残る課題を理解できるよう、代表的な失敗も数件入れましょう。平均値の表は、例を隠すのではなく、例へつなぐべきです。
運用には追加の確認があります。対象マシンは成果物を読めるか、実行環境は構造とトークナイザーに対応するか、後段ソフトが期待する表記は保たれるか。「音声認識」に対応していても、学習環境とアプリ環境は一致しない場合があります。
NVIDIAのチュートリアルは、公開済みのツールと、今後公開予定とするGold-refinedチェックポイントを区別しています。コード、実験結果、ダウンロード可能な適応済み重みを別々の公開状態として扱いましょう。公開解説は計画を始めるには十分でも、すべての実演成果物が運用向けに配布済みとは限りません。
よい適応は、小さく明確な問いから始まる
私たちは、Speech Skillsの価値は専門分野のASR作業を確認可能にすることだと考えます。漠然とした精度改善を、誤り、データ、対応手法、評価についての判断へ分けます。終点の合意がない長期学習になるのを防げます。
重要な語と、問題を示す録音から始めましょう。より単純な対策が効くか確認し、根拠を持って次へ進みます。読者や聞き手が実際に直面する条件で書き起こしが改善してこそ、モデルに価値があります。
出典と画像
2026年10月20日確認。数値はNVIDIAの研究によるもので、この記事で学習、推論、デモ結果を再現していません。著者撮影の画面はNVIDIAの公開文書で、CC BY 4.0に基づき出典を表示しています。図は独自制作です。メディア記録をご覧ください。
音声の根拠を、確認記録と一緒に残す
次の実験を明確な記録から始められるよう、出典、用語の判断、評価メモをまとめましょう。Telli.shは調査の整理に役立ちます。Telli.shアカウントを作成