24GBのモデルは24GBのコンピューターではない:Nemotron Boltのメモリ予算
Nemotron Boltの総74B・アクティブ9Bパラメーター、ネイティブ2ビットの重み、ローカル実行手順で必要になるコンテキスト、ビジョン、ドラフトモデル、ランタイムのメモリを解説します。
GPUのメモリは24GB。新しいモデルの名前にも「24GB」とある。この2つの数字だけで、購入を決めてよいのでしょうか。
ローカルAIのワークロード全体を考えると、そうはいきません。NVIDIAは10月15日、ネイティブ2ビット量子化を採用したローカル展開可能なビジョン言語モデル、Nemotron 3.5 Bolt 74B-A9B 24GBを発表しました。名前が示すのは最適化の目標であり、どのコンテキスト長、画像リクエスト、エージェント構成も24GBのグラフィックスカードに収まるという保証ではありません。NVIDIA発表、2026年10月15日。
考えるべきなのは、モデルを読み込んだ後に何が必要かです。この記事では、保存されるパラメーターとアクティブな計算を区別し、ほかのメモリ消費要因を説明して、実際のモデルカードの手順に基づくループバック限定のセットアップを紹介します。まず必要なワークロードを決め、そのマシンで継続して実行できるかを判断しましょう。
ヒーロー画像:ワークロード全体の予算を説明するオリジナル図です。公式スクリーンショットでも、測定された割り当て量でもありません。構成要素の大きさは示していません。
アクティブ数が小さくても、9Bのダウンロードにはならない
Boltは総計74 billionパラメーターで、トークン当たり約9 billionがアクティブです。Mixture-of-Expertsのルーターが、保存されたネットワークの一部を選択します。これは120B-A12B Super VLを圧縮した派生モデルであり、密な9Bモデルではありません。NVIDIA Bolt研究概要、2026年10月15日。
押さえておきたい違いは、アクティブパラメーターがトークンの処理に使われる計算を示すのに対し、総パラメーターは保存すべきものを示すことです。どちらの数字も、単独でアプリケーションの速度を決めません。配置、メモリ帯域、カーネル、入力長、周辺アプリケーションのすべてが結果に影響します。
コードを確認するエージェントにも、直前のトークンで選ばれなかった専門家へのアクセスが必要です。ストレージ、システムメモリ、GPUメモリ間でデータを移動することは、すべてをアクセラレーター上ですぐ使える状態にすることとは異なります。したがって、アクティブ数が小さいからといって、残りのパラメーターが存在しないかのようにハードウェア要件を計算してよいわけではありません。
モデルファミリーの名前も正確に比較しておきましょう。
| モデル | 名前が指すもの | 10月16日時点の状態 |
|---|---|---|
| Nemotron 3.5 Super VL | 別モデルの120B | リリース済み |
| Nemotron 3.5 Bolt 74B-A9B 24GB | ここで扱う圧縮型のローカルモデル | リリース済み |
| Nemotron 3.5 Bolt E4B 4GB | 別の小型エッジ/会話向け製品 | 10月23日公開予定 |
リリース状況は10月15日の発表に基づきます。この記事の日付ではE4Bは将来の公開予定であり、以下のコマンドで実証した代替モデルではありません。また、Super VLのエンタープライズ導入結果を、デスクトップでのBoltの結果として読むべきではありません。
ネイティブ2ビットの重みで解決するのは、予算の一部
「ネイティブ2ビット」に意味があるのは、後からユーザーが小さなエクスポートを選んだだけではなく、モデル開発の段階から強い圧縮を取り入れているためです。NVIDIAは量子化対応蒸留を使い、精度を落とした後の能力を補います。専門家の重みには1要素当たり2.0625ビットのIQ2_XXSを使い、ほかの部分には別の形式を残します。ネットワークは混合精度であり、すべてが一律2ビットではありません。NVIDIAの圧縮・量子化の説明、2026年10月15日。
意図的に現実離れした算術チェックをしてみましょう。740億個の値を正確に2ビットずつ保存すると、185億バイトになります。これは説明用の例であり、Boltのファイルサイズでも起動要件でもありません。実際の精度構成、メタデータ、実行状態を考慮していないためです。見出しにあるパラメーター数に見出しのビット数を掛けても、特定のチェックポイントの実態は分かりません。
GGUFが答えるのは別の問いです。これはllama.cppエコシステムで使われるモデルファイル形式で、テンソルと関連情報を格納します。「2ビット」に加えて別の圧縮を約束するものではなく、GGUFをダウンロードしても特定のランタイムがモデルを扱えるとは限りません。llama.cpp GGUFツール文書、2026年10月16日確認。
NVIDIAが推定したメモリ内訳を見ると、この違いが具体的に分かります。表2では、重みに22.01GB、ビジョンを除く合計に23.83GB、さらにビジョンエンコーダーとプロジェクターに1.68GBを示しています。これはレポートの構成に対するベンダーの推定であり、この記事で計測したメモリではありません。同レポートでは、バッチサイズ1、コンテキスト128Kで24GB未満を目指す設計についても説明しています。10月15日にリンクされたBolt技術レポートの表2と第2.3節。
ポイントは、ブランド名が実は重みだけの容量を指しているということではありません。デプロイ目標には前提条件があり、その前提を変えると必要メモリも変わるということです。
重みだけでなく、ワーキングセット全体を見積もる
保存済みモデルに加わるコンテキストの税金としてデプロイを考えてみましょう。システムに保持・処理させる内容にも領域が必要です。計画時には、重み、シーケンス状態、ビジョン処理、投機的デコーディング、ランタイムのワークスペースを分けて考えます。デスクトップや実際に開いておきたいアプリケーションのための余裕も確保してください。
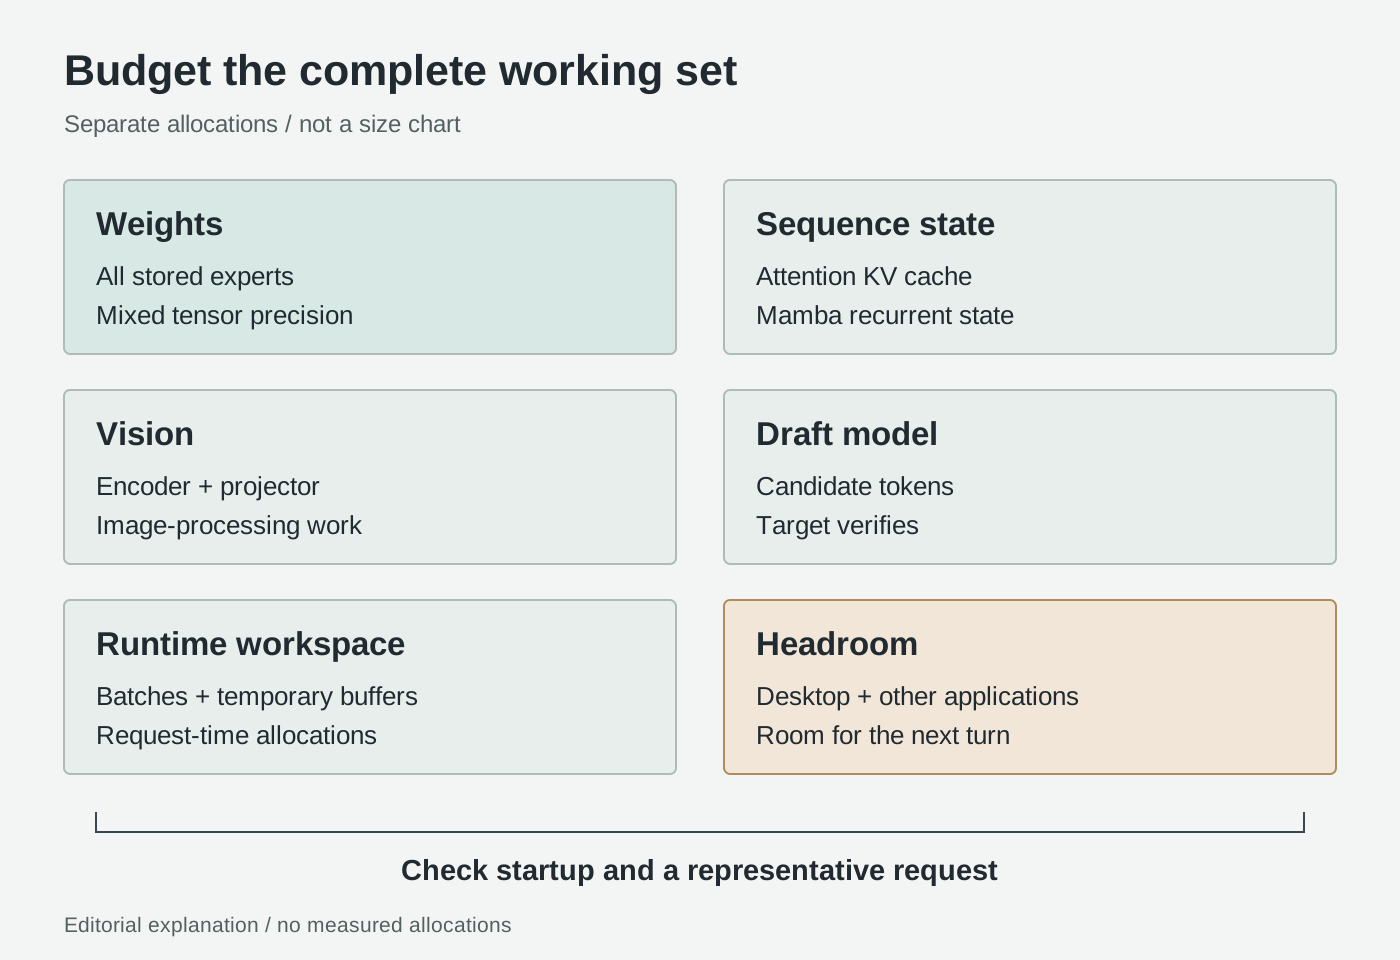
実測比率ではなく、説明のために作成したオリジナル図です。仕組みの出典:Hugging Faceのキャッシュ文書、llama.cppのマルチモーダルガイド、NVIDIA Boltレポート、いずれも2026年10月16日確認。
シーケンス状態は、重みのコピーではありません。 自己回帰型アテンションモデルは、生成時に以前のトークンを再利用できるよう、キーと値をキャッシュします。保持するシーケンスが長いほどアテンションキャッシュの容量が増えますが、詳細はアーキテクチャとキャッシュ表現によって異なります。Hugging Face「キャッシュの仕組み」、2026年10月16日確認。
BoltはMamba層とアテンション層を組み合わせたハイブリッドなので、一般的な全Transformer向けキャッシュ計算だけでは十分ではありません。再帰状態とアテンションキャッシュは別々の割り当てです。ランタイムが実際に確保するものを確認してください。このアーキテクチャの違いは、2026年10月16日確認の同レポート表1に記載されています。
エージェントが保持するコンテキストは、入力した質問だけではありません。システム指示、ツールのスキーマ、会話履歴、検索された文章、ツールの応答も回答用の容量を取り合います。リポジトリの一覧が何度も繰り返される履歴は、役立つ証拠を増やさずに実用的な予算を使い切ることがあります。タスク状態を簡潔に保つのは、ハードウェア上の工夫にとどまらないワークフローの判断です。
ビジョンには別の処理経路があります。 llama.cppでは--mmprojで言語モデルとマルチモーダルプロジェクターファイルを組み合わせ、文書によるとこのコンポーネントはデフォルトでGPUオフロードされます。llama.cppマルチモーダルガイド、2026年10月16日確認。そのため、言語モデルのファイルだけを読み込むのは、画像対応構成を一式用意することとは異なります。
文書の作業では、抽出したテキストを読むことと、レンダリング済みのページを解釈することを区別してください。通常のテキスト段落には、列見出しとセルとの視覚的な関係は含まれません。反対に、レイアウトが重要でないページを画像で送ると、回答を改善せずに処理だけが増える場合があります。質問に必要な証拠をどの表現で保てるかを考えましょう。
投機的デコーディングのドラフターは追加モデルです。 BoltのLiLiCorrドラフターは候補トークンを提案し、ターゲットモデルが検証します。デコードを速めることを意図していますが、追加チェックポイントと実行状態にはメモリが必要です。NVIDIAによるLiLiCorrの説明、2026年10月15日。ドラフターを含めても、あらゆるタスクが速く完了する保証にはなりません。
ランタイムのワークスペースも別途必要です。 プロンプト処理のバッチや一時計算バッファーも、常駐状態と一緒に見積もります。サーバーでは論理バッチサイズと物理マイクロバッチサイズが別々に公開されており、どちらも同時会話数とは異なります。llama.cppサーバーオプションのリファレンス、2026年10月16日確認。設定が起動しただけで終わらせず、代表的なリクエストで試してください。
公式ハードウェア表は製品名の接尾辞より参考になる
NVIDIAが公開している構成は次のとおりです。
| レシピ | ハードウェア | コンテキスト | シーケンス |
|---|---|---|---|
| 28GB | RTX Spark 64GBまたはディスクリートRTX 32GB以上 | 65,536 | 1 |
| 32GB | RTX Spark 128GBまたはディスクリートRTX 48GB以上 | 262,144 | 1 |
出典:NVIDIA Quick Start、2026年10月16日確認。
この表はディスクリートGPU 24GBを対象にしておらず、Mac対応を示すものでもありません。ホストRAMはディスクリートVRAMへの追加分ではありません。
私たちの見方は、読み込み成功のスクリーンショットではなく、再現できる構成を選ぶことです。このモデルを買うかどうかに関わるなら、予定している入力と普段使っているバックグラウンドアプリを含むデモを求めてください。最初の依頼より後の依頼の方が大きくなりやすい文書画像や長時間のエージェントでは、特に重要です。
最大値ではなく、作業に合わせてコンテキストを選ぶ
以下は報告済みの試験結果ではなく、最初に試すための例です。
開発者が、エラー、関連する関数、近くの依存箇所1つを示して失敗したテストの説明を求めます。役立つ回答は、具体的な行に結び付いた診断と修正案です。リポジトリ全体を追加する前に、足りない情報が特定のインターフェースなのか、別のスタックフレームなのかを確かめます。質問を検証可能な範囲に保てば、誤った前提も見つけやすくなります。
研究者が文書の2ページにまたがる表を比較します。ここでは、見出し、単位、脚注、値を正しく対応付けられるかが試されます。関係性が重要なら実際のページ画像を使い、ページごとの根拠を求め、いくつかのセルを原本と照合してください。2つの列を入れ替えた流ちょうな要約は、素早く返ってきても失敗です。
ローカルアシスタントが、許可されたフォルダーを検索して報告書の草案を作ります。検索資料と繰り返されるツール応答により、メモリ負荷が増えることがあります。まず読み取り専用のタスクを渡し、検索範囲を限定し、各結論の根拠となるファイル名を示させましょう。役立つ計画を立てられるか確かめるだけのために、書き込みやシェルの権限を与えないでください。
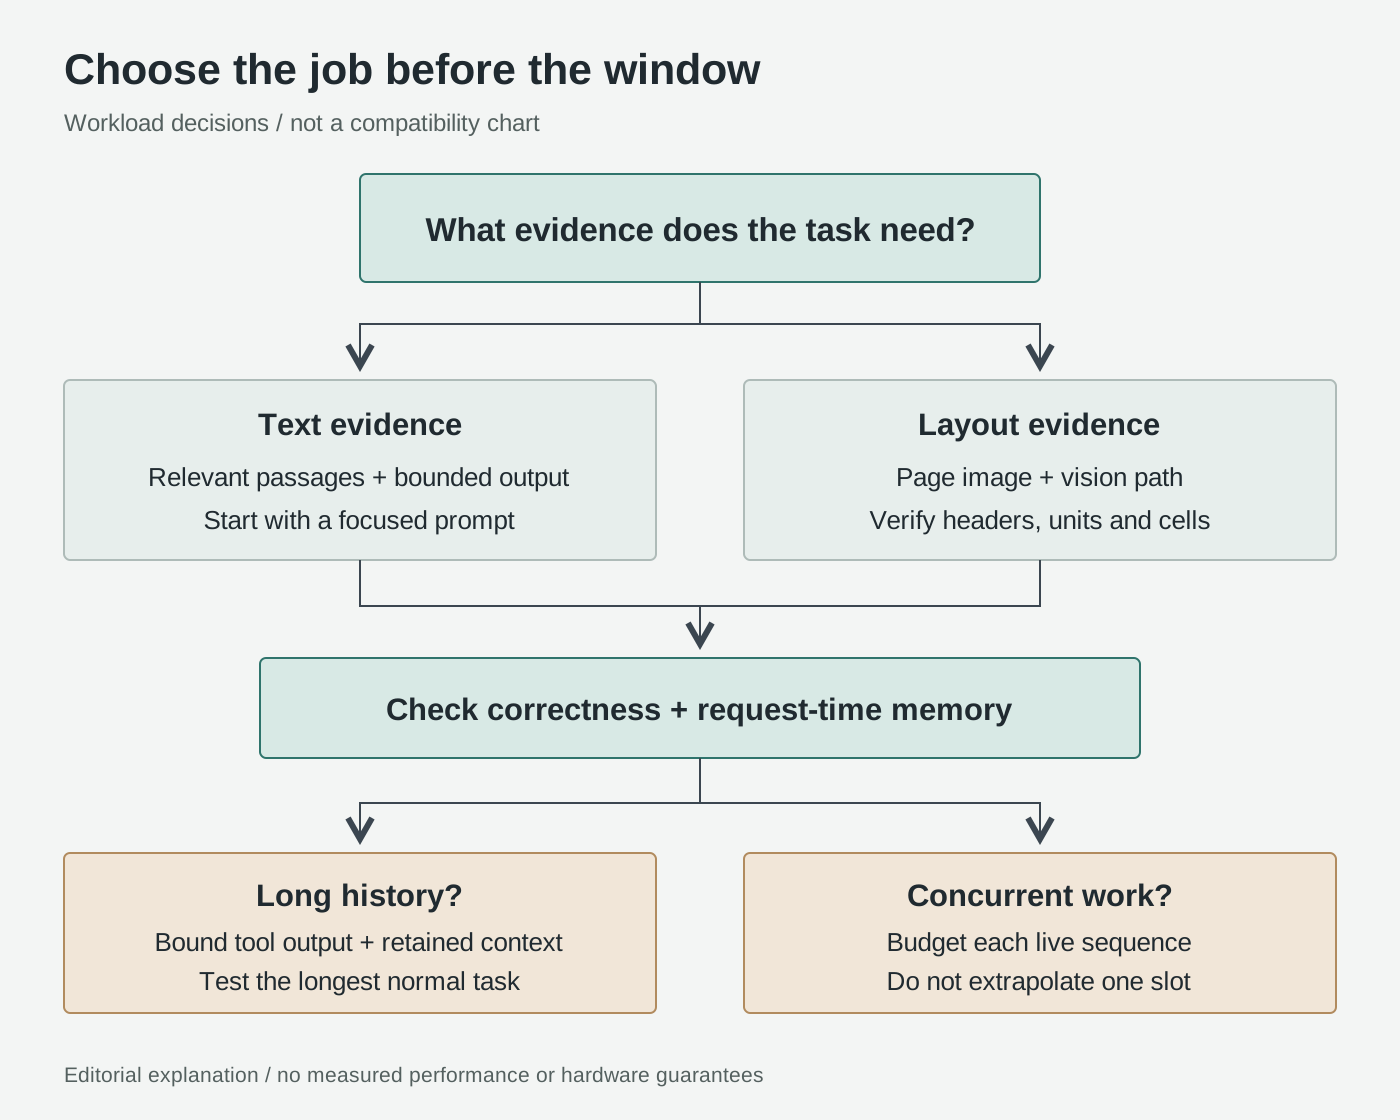
ワークロード選択の説明用に作成したオリジナル図です。ベンチマークでも互換性表でもありません。Hugging Faceのキャッシュ戦略とllama.cppのマルチモーダル処理を参照。2026年10月16日確認。
量子化キャッシュは高精度のキャッシュより容量を減らせます。また、オフロードは負荷を別のメモリ階層へ移すことで、容量とスループットをトレードオフにできます。これらは一般的なトレードオフであり、Transformersのすべてのキャッシュ方法をこのGGUFデプロイで使えるという証拠ではありません。Hugging Faceのキャッシュ戦略、2026年10月16日確認。
実務では、証拠密度を優先しましょう。質問に答えるための資料を残し、原本を別に保管し、重複する枠組みは取り除きます。回答の分の余裕も必要です。設定したウィンドウを大きくしても、無関係な履歴が役立つようにはなりません。
ローカルで始め、実際に必要なワークロードを試す
以下のLinux Bash例は、対応するNVIDIAディスクリートGPU構成を対象としています。Git、Python、CMake、C++ツールチェーン、互換性のあるNVIDIAドライバーとCUDA Toolkitがすでにインストールされていることが前提です。実際にインストールを完了した報告ではなく、手元のマシンで実行する手順です。
- 関連ランタイムをビルドし、オプションを確認します。 モデルページにある汎用のワンライナーではなく、ソースからビルドする手順を使います。llama.cpp CUDAビルドガイド、2026年10月16日確認に従い、報告されたコミットとバイナリのバージョンを構成と一緒に記録してください。
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
ヘルプにdraft-dflash、--spec-draft-model、--spec-draft-n-max、--cache-type-k、--cache-type-v、--flash-attn、--jinjaが含まれるか確認します。パッケージのバージョン表示だけでは対応状況を証明できません。バイナリがオプションを認識しない場合、大きなチェックポイントをダウンロードする前にビルドの不一致を解決してください。古い投機的デコーディングのフラグで手順を黙って置き換えてはいけません。オプション名は現行サーバーリファレンス、2026年10月16日確認に記載されています。
- NVIDIA Quick Start、2026年10月16日確認にある3つのファイルをダウンロードします。 コマンドはHugging Face CLIガイド、2026年10月16日確認に沿っています。先にディスク容量を確認してください。
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
この構成を比較の基準にする前に、リポジトリのリビジョンとローカルファイルのハッシュを記録します。後からファイルやランタイムを更新する場合は、2回の実行間で原因不明の差が生じないよう、意図した変更として扱ってください。
- 明示的なループバックバインドでNVIDIAの28GBレシピを使います。
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
必要なら未使用のポートを選び、下の確認コマンドも合わせて変更します。初回起動のために、ルーターのポート転送ルール、公開トンネル、外部向けバインドのリスナーを作らないでください。ループバックはネットワークからの到達範囲を制限しますが、接続したエージェントのツールまで無害にするものではありません。
- ほかのものを接続する前に、準備完了を確認します。 別のターミナルで実行してください。
curl --fail http://127.0.0.1:8080/health
サーバー文書では、読み込み中の応答と準備完了の応答を区別しています。準備ができたらローカルでhttp://127.0.0.1:8080を開き、画像リクエストより先に短いテキスト質問を試します。llama.cppサーバーのヘルスチェックとWebインターフェースの文書、2026年10月16日確認。基本応答が動くまで外部ツールは接続しないでください。
- 拡張前にワークロード全体を測定します。 ディスクリートGPUシステムでは、起動前と代表的なプロンプトの実行中にメモリを確認します。
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
これはデバイスの観測値であり、プロセスのピーク使用量全体やユニファイドメモリの計測方法を示すものではありません。NVIDIAはSystem Management Interfaceリファレンス、2026年10月16日確認で、プラットフォームによりメモリ報告が異なると説明しています。ランタイムの割り当てログも保存し、ホストメモリは別に確認します。
短いプロンプト、普段使う最長のプロンプト、代表的な文書画像を比較してください。正確さ、完了までの時間、メモリの観測値、割り当てエラーを記録します。普段使うエディターとブラウザーを開いた状態でも繰り返します。それらを閉じたときしか動かない構成では、当初の要件を満たしていません。
失敗したら一度に1つの要素を変え、新しい構成を明記します。コンテキスト、マイクロバッチサイズ、ツール履歴の量を減らすのは、それぞれ別の問いへの回答です。ドラフターを取り除くのも別の実験であり、公開されたレシピそのものではありません。失敗と原因となった入力を残し、後で短いプロンプトが成功しても未解決のワークロードをなかったことにしないでください。
結論:ワーキングセットに合わせて買う
Boltの興味深い点は、ローカル作業向けに圧縮された、大規模で疎にアクティブ化されるモデルという提案です。実用性は、作業を終えるために必要な証拠、視覚入力、シーケンス状態、アプリケーションが一緒に収まるかどうかで決まります。
適切な合格条件は「24GBモデルを読み込めたか」ではありません。「このマシンで普段のワークロードを確実に完了でき、回答も信頼でき、次のターンに必要な余裕があるか」です。購入の判断で見るべきメモリ予算はそれです。
出典
リリース情報の日付は2026年10月15日です。リンク先のモデルカードと更新される可能性のある文書は、2026年10月16日に確認しました。手順は公開された説明を適用したもので、実地インストールの結果ではありません。オリジナル図は説明用であり、公式素材や性能グラフではありません。
- 3つのモデル名と公開時期:NVIDIAリリース発表。
- 圧縮、精度、推定メモリ内訳:NVIDIA Bolt研究概要と技術レポート。
- 実際のハードウェア表、チェックポイントのファイル名、起動手順:NVIDIA GGUFモデルカード。
- ランタイムの動作:llama.cppのビルド、サーバー、マルチモーダル、GGUFツールの文書。
- 各仕組みと確認コマンド:Hugging Faceのキャッシュ解説、キャッシュ戦略、CLIガイド、NVIDIA SMIリファレンス。
任意のTelli.sh案内:判断の根拠となる出典を残す
エージェントを比較する際、原資料、メモ、自分で試した結果を一緒に保管しておくと便利です。Telli.shアカウントを作成し、製品が変わっても参照できる資料にまとめましょう。