Macのデスクに816B:Muse Spark Openで本当にできること
Metaのオープンウェイトモデルが大容量メモリ搭載Macに登場。Studio 2台の構成と、より小さな量子化チェックポイントを比較し、実際のデモを見ながら無理のない最初の設定を選びます。
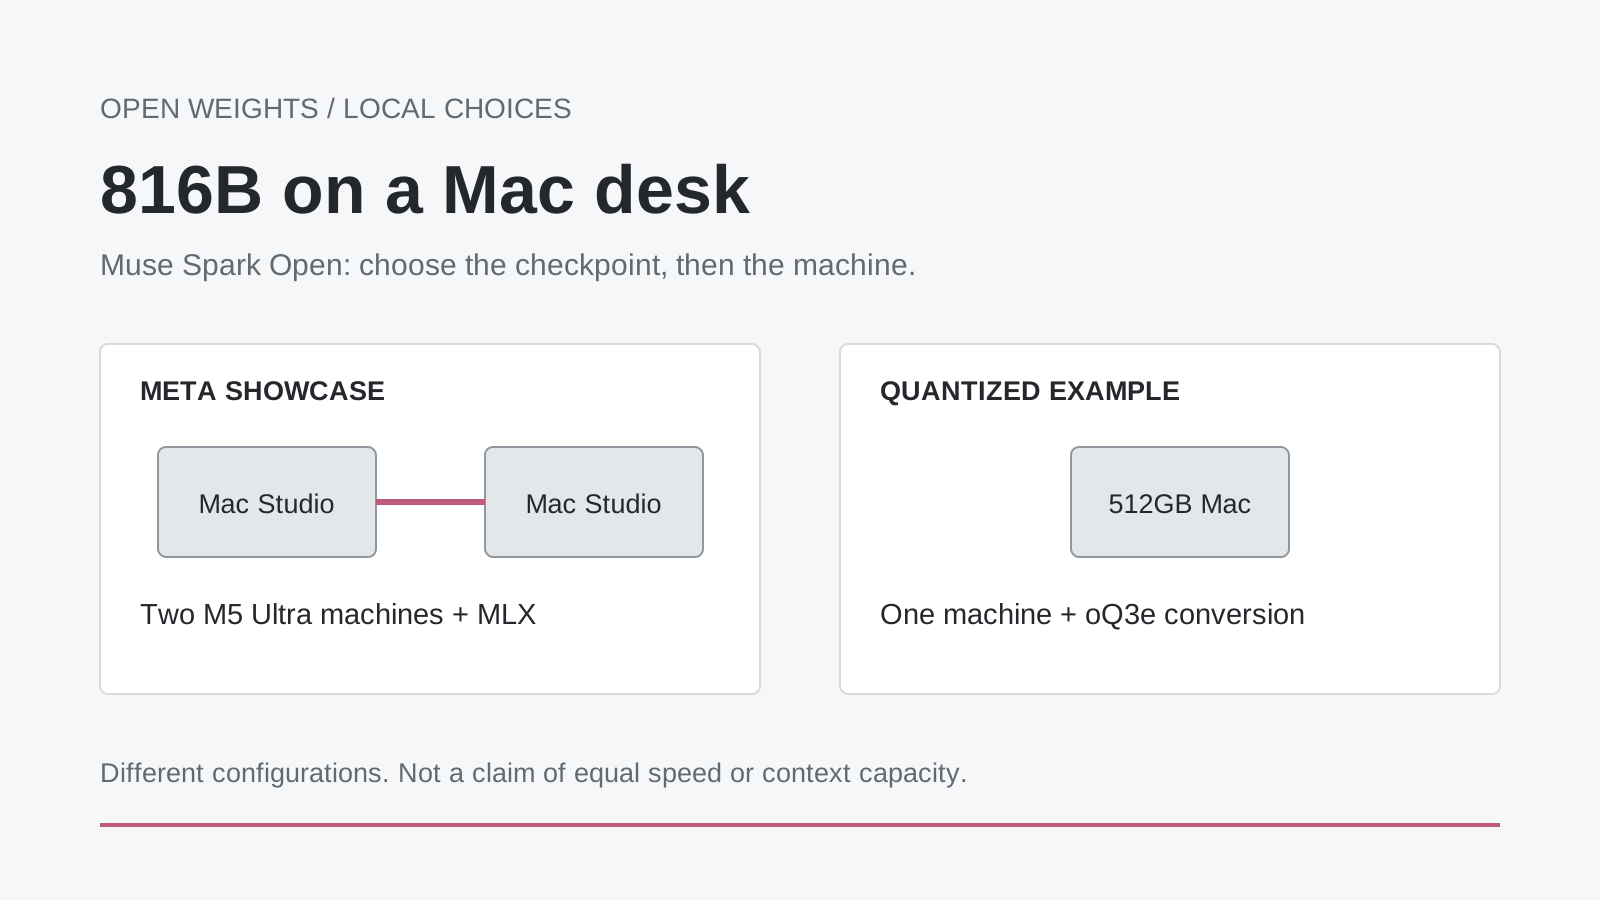
説明用に作成したオリジナルイラストです。2台構成のデモと1台で量子化モデルを動かす例は別々の構成であり、同じ性能結果を示すものではありません。
デスクの上で8160億パラメーターのモデルを動かすと聞くと、矛盾しているように感じます。しかしMetaが10月15日の発表で示したデスクには、それぞれ非常に大きなメモリを備えたMac Studioが2台あります。手持ちのノートPCで同じモデルを動かす話とは別です。
より興味深いのは、その見出しの少し下にある変化です。Muse Spark Openでは開発者がモデルの重みにアクセスでき、周辺ツールにも複数の実行方法があります。Metaは2台構成を示し、Hugging Faceは512GBのMac 1台で、さらに強く量子化したバージョンを動かす例も紹介しています。ローカルAIの論点は、モデルを理論上ダウンロードできるかどうかから、適切な表現形式と運用範囲を選ぶことへ移りつつあります。
この記事では、モデルでできること、メモリ容量の数字が異なる理由、参考になる公開デモ、そして数百GBのダウンロードをうっかり始めずに有意義な第一歩を踏み出す方法を説明します。すべての読者にワークステーションの購入を勧めることが目的ではありません。ローカルマシン、小さなモデル、ホスティングサービスのどれを選ぶべきか、少し判断しやすくするための記事です。
ブレークスルーはモデルへのアクセスであり、ノートPCの一律アップグレードではない
Metaは2026年10月15日にMuse Spark Openを公開しました。発表によると、これは総計816Bパラメーター、トークン当たり約42Bのアクティブパラメーターを持つMixture-of-Expertsモデルで、最大100万トークンのコンテキストウィンドウに対応します。コーディングや長時間のツール利用を目的としており、特定のチャットアプリだけでなく、複数の推論エンジンを通じて重みをデプロイできます。
これにより、誰がデプロイ方法を決めるかが変わります。開発者はチェックポイントを選び、適切なサービングスタックを動かし、ツールを統合し、アプリケーションが情報を送る先を決められます。再現可能なモデルのバージョンや、特定のデータ取り扱いが必要なプロジェクトでは、こうした選択が重要です。一方、ストレージ、アップグレード、互換性、監視、復旧など、通常のマネージドチャットサービスでは表に出にくい責任も生じます。
これはインフラが不要になったということではなく、選択肢が大きく広がったということです。重みを所有するのは、エンジンを所有するようなものです。別の車を作る余地は生まれますが、ブレーキや整備工場、道路まで付いてくるわけではありません。その車のどの部分を自分で維持したいのかを考えることが大切です。
趣味のプロジェクトなら、それらを維持すること自体が目的かもしれません。会議前に答えが必要な小規模事業者にとっては、余計な気を取られる原因になることもあります。同じ公開に対するどちらの反応も妥当です。オープンウェイトモデルは選択を可能にしますが、代わりに決めてはくれません。
アクティブパラメーター42Bでも、816Bのダウンロードは小さくならない
Mixture-of-Expertsモデルは、トークンごとに専門家の能力の一部を選択します。そのため、アクティブパラメーター数が総数より大幅に小さくなります。しかし通常のフルモデルデプロイで、使われていない専門家を省いてよいという意味ではありません。次のトークンでは別の経路が選ばれる可能性があります。
3つの容量を分けて考えるとよいでしょう。1つ目はチェックポイントの保存容量です。2つ目は重みとランタイム用の作業メモリです。3つ目は、注意キャッシュやマルチモーダル入力など、ワークロードに応じて増える追加状態です。最初の条件を満たしても、残り2つまで収まるとは限りません。
公式モデルカードには、テキスト、画像、動画、音声の入力とテキスト出力が記載されています。異なるチェックポイント形式と、大きなメモリ要件も掲載されています。これはモデルファミリー全体の仕様であり、変換済みのすべてのチェックポイントに全エンコーダーが含まれることや、どのマシンでも最大コンテキスト長に達することを保証するものではありません。
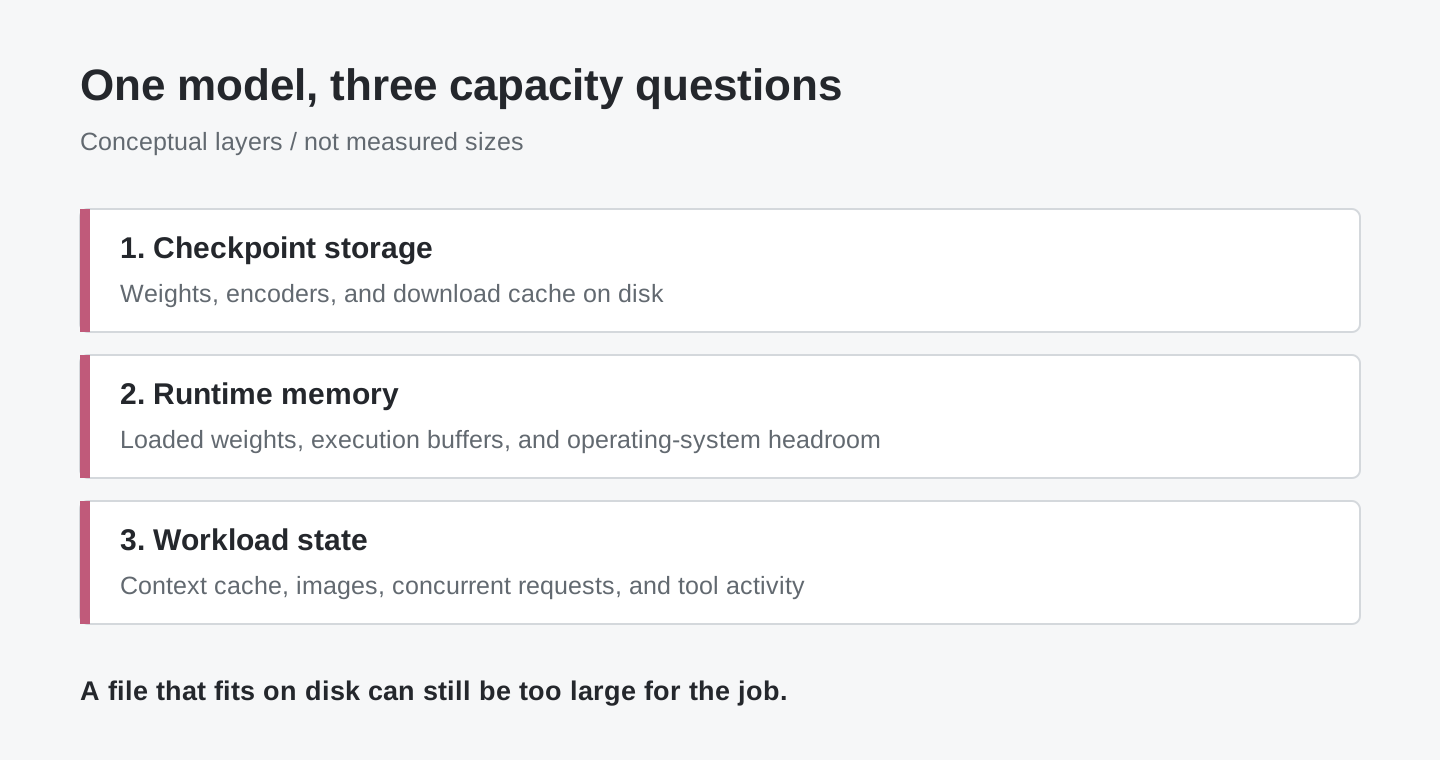
概念を説明するためのオリジナル図です。帯はメモリの使用区分を示しており、実測比率ではありません。チェックポイントのサイズだけではマシン全体の必要容量を判断できません。
動画ではこの区別が特に重要になります。画像1枚についての短い質問と、多数のフレームを分析する長い依頼は、どちらもビジョン対応モデルを使うからといって同じではありません。最初の実験では入力を小さく保ち、応答を短く制限して、より大きなアーカイブや長時間のエージェントループを追加する前に基準となる動作を確認しましょう。
Mac Studio 2台と512GBのMac 1台は、別のストーリーを示す
Metaのデモでは、M5 Ultra Mac Studio 2台とMLXを使っています。発表では1台当たり最大512GBのユニファイドメモリに触れ、Ice Cubes iOSアプリの変更やDaVinci Resolveでの編集など、ローカルでのワークフローを紹介しています。これはMetaによるデモであり、私たちの環境で測定した結果ではありません。Metaのローンチ記事で構成と例をご覧ください。
Hugging Faceのローンチ記事では別の方法が紹介されています。メモリ512GBのM3 Ultraで、oQ3e量子化チェックポイントを試した内容です。1,024トークンのプロンプトと128トークンの生成という条件で、執筆者はプリフィル時に約225トークン/秒、生成時に21トークン/秒と報告しています。これはそのチェックポイントを使った短いテストの数値であり、あらゆるMacや2台構成のデモに当てはまるわけではありません。エンジニアリング記事のMLXセクションをお読みください。
oQ3eチェックポイントカードでは、単位について重要な補足があります。テンソルの保存容量は約344.152 GiB、つまり369.531 GBです。カードではoMLXで約370GBと説明しています。単に「344GBのモデル」と呼ぶと、残りのメモリが重要になる場面で2進単位と10進単位が曖昧になります。
| 公開された構成 | 示していること | 読者が推測すべきでないこと |
|---|---|---|
| MetaのM5 Ultra Mac Studio 2台 | 大容量メモリでのローカルデプロイとエージェントのデモ | Museの構成にはすべてMacが必ず2台必要だということ |
| oQ3eを使うHugging Faceの512GB M3 Ultra | 1台でさらに強く量子化した例 | 一般的なMacBookにも十分なメモリがあるということ |
| ホスティング推論 | フルチェックポイントをローカルで維持せずに使う方法 | 処理が必ず自分のコンピューター内で完結するということ |
もう1つ重要な境界があります。oQ3e変換には言語モデルとビジョンエンコーダーが含まれますが、音声エンコーダーは含まれません。したがって、フルモデルを使った音声とブラウザーのデモだけでは、この特定のダウンロードでも同じ音声ワークフローが動くとは言えません。モデル名だけで各バリアントのカードを読む作業を省くことはできません。
oQ4eカードでは、容量とのトレードオフがさらに明確です。テンソルの保存容量を約475.886GBとし、512GBのMac 1台で安定して使うには大きすぎると警告しています。ビット数を増やすことで重みの表現を変えて保持できる一方、実際の作業に使える空き容量は減ります。メモリを埋めることと、作業を終えることは同じではありません。
最終回答だけでなく、ツールのループを見る
魅力的な用途の1つは、変更した結果を確認できるコーディングアシスタントです。Hugging Faceの3Dアセットの例では、量子化モデル、コーディングエージェント、Three.js、ブラウザーでのレンダリング、視覚的なフィードバックを組み合わせています。重要なのは、成果物を作り、見て、欠陥を見つけ、修正するループです。
このパターンを使って製品コンフィギュレーターの試作品を作る場面を想像してください。エージェントに期待するのは、構文上正しいコードを出すだけではなく、操作部が隠れていたり、オブジェクトがカメラの画面外に出ていたりすることにも気付くことです。これはパターンを応用した例であり、デモがすでに本番用コンフィギュレーターを提供しているという話ではありません。合格条件はプロジェクト側で決めます。適切な操作部、正しい寸法、小さな画面での正しい動作が必要です。
2つ目の例は、Hugging Faceの記事からリンクされている「Call your Browser」のデモです。音声入力と視覚的なブラウザー操作を組み合わせ、説明に合う商品を検索します。エンジニアリング記事内のホストされたデモでは、重みをインストールしただけでブラウザーエージェントが完成するわけではないことを踏まえた操作を見られます。リンク先のSpaceはアクセス権が必要な場合があります。公開ページからリンクされているからといって、一般公開のサービスとして動くとは限りません。ホスト版を試す前にセットアップとデータの取り扱いを確認し、機密でない例を使いましょう。
3つ目は、自分の書類やスクリーンショットを確認するアシスタントです。たとえば、文章の要件とインターフェース画像を比較し、違いを挙げるよう依頼できます。ファイルの変更、メッセージの送信、購入などの権限をすぐに与えず、画像理解を活用できる作業です。入力と提案された回答を人が確認できる仕事から始めましょう。
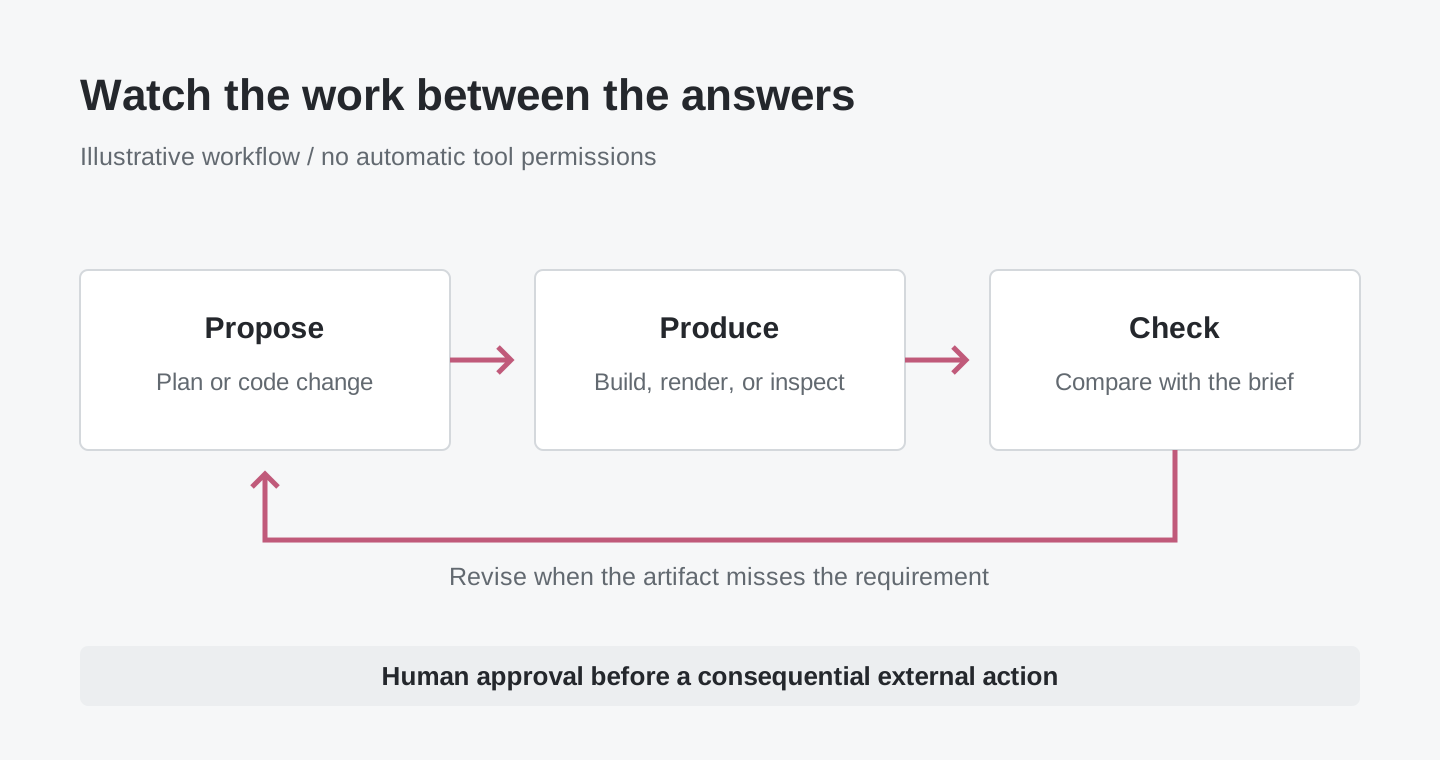
オリジナルのワークフロー図です。操作ループを提供するのはエージェントフレームワークとツールです。モデルの重みをダウンロードしても、ブラウザーやファイルシステムへのアクセス権が生じるわけではありません。
どのパターンでも途中経過を確認してください。コードはコンパイルできましたか。描画されたページは要件と合っていますか。商品候補は条件を満たしていますか。整った最終文だけでは、作るべき成果物の代わりになりません。
「ダウンロード」を最初の手順にせず、Macで始める
最も簡単な失敗は、最初に最大モデルを選び、ダウンロードの途中で容量要件に気付くことです。順序を逆にしましょう。小さな作業を決め、対応するチェックポイントを選び、ストレージや時間を使う前にマシンを確認します。
- Macのメモリと空きストレージを確認します。 以下のTerminalコマンドはmacOSのバージョン、搭載メモリ(バイト単位)、ホームボリュームの空き容量を表示します。ソフトウェアのインストールや重みのダウンロードは行いません。
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
対応アプリケーションとチェックポイントを一緒に選びます。 oMLXプロジェクトはmacOSアプリケーションとインストール手順を提供しています。記載された前提条件はApple SiliconとmacOS 15以降です。執筆時点の最新リリースはv0.7.1rc1で、リリース候補です。締め切りのある仕事で頼るワークステーションとは実験環境を分けてください。
-
モデルのダウンロード画面で選択する前に、対象の変換モデルのカードを読みます。 上記の1台構成の識別子は
mlx-community/Muse-Spark-Open-816B-A42B-oQ3eです。チェックポイント、ダウンロードキャッシュ、ランタイム、実行したい作業に必要な容量を見積もりましょう。256GBのMacは、このバリアントについて公開されている必要容量を下回ります。回答を1文にしても、重みの保存容量は減りません。 -
短く、失敗しても支障のない作業から始めます。 短い回答を求める簡単なテキスト質問や、機密でないスクリーンショットを試します。コンテキストを広げたりツールを加えたりする前に、モデルが読み込めて結果が役立つか確認してください。読み込みに成功したことが示すのは互換性であり、事実の正確さではありません。
-
読み取り専用のワークフローが安定してから操作権限を加えます。 プロジェクトのコピーで作業してください。エージェントがアクセスできるファイルとツールを制限し、外部操作の前に確認を求めます。最初の実験で唯一の作業用コピーを変更しないよう、変更内容をレビューできる状態にします。
別モデルのページからコピーした汎用コマンドより、アプリケーションがサポートするダウンロードとモデル選択方法を優先してください。MLX LMにもコマンドラインの方法がありますが、モデル対応とパッケージのリリース速度は異なる場合があります。Muse対応のプルリクエストは、バージョン選択時に参考になる互換性情報です。開発ブランチを任意にインストールする根拠ではありません。
モデルの有用性を知るためだけにハードウェアを買う必要はありません。ローカルデプロイを調べる前に、ホスティングエンドポイントで代表的な作業を処理できるか確認できます。まず提供元の料金、データの取り扱い、支出制御を確認してください。公開デモは学習用の手段であり、無料の本番バックエンドではありません。
トークン数ではなく、完了した作業を測る
トークン/秒は推論構成の説明には役立ちます。しかし、アシスタントが午後の作業を節約したのか、気付きにくい間違いを生んだのかは分かりません。特に長時間動くエージェントが誤った前提を繰り返すと、速い間違いは遅い正解より高くつくことがあります。
実用的な比較では、候補となる設定ごとに同じ小規模なタスクを使います。既存テストのあるコード変更、既知の問題があるスクリーンショット、答えを原文の箇所までたどれる文書の質問を含めます。プロンプトと合格条件をそろえましょう。その上で、正確さ、レビュー可能な結果までの時間、必要な介入、ツールで確認できる場合はピーク時のリソース使用量を記録します。
プリフィルと生成を別々の待ち時間として扱ってください。入力が長いと、その後のトークンが速く出ても最初の回答が遅れることがあります。エージェントがコンパイルやブラウジングをしたり、別のツールの応答を待ったりする時間も発生します。ローカル構成とホスティングサービスを比較する際は、その時間も含めてください。モデルの外で発生しても、ユーザーの体験の一部です。
意味のあるチェックポイントやランタイムの更新後には比較を繰り返します。普段のワークフローを壊す変更を見つけるのに、大掛かりなベンチマークは必要ありません。一貫した方法で確認した代表的な作業がいくつかあれば、印象的な回答1件のスクリーンショットより役立ちます。
オープンウェイトだけでプライバシーや無制限の権利が得られるわけではない
ローカルモデルなら推論を自分のマシン上に保てます。しかしアプリケーション全体では、ウェブ検索、テレメトリー、外部ツール、リモートストレージ、ホストされた代替モデルを使う可能性があります。実際のワークフローのデータ経路を把握するまでは、プライベートだと説明しないでください。オフラインのテキスト実験とブラウザーで買い物をするエージェントでは、同じチェックポイントから始めても境界が異なります。
Muse Model Licenseにも条件があります。帰属表示と使用ポリシーの添付が必要で、特定のモデル・アズ・ア・サービス事業には別の条件もあります。あらゆる利用に制限がないと宣言するものではなく、独自条件のオープンウェイト公開です。予定している配布やサービスの形態に合わせて、最新のライセンスを確認してください。
チームでの所有には、法的な回答だけでなく運用上の答えも必要です。新しいモデルバージョンは誰が承認しますか。以前の設定は誰が復元できますか。プロンプトやツールの結果はどこへ送られますか。変更を顧客に届ける前に誰がレビューしますか。こうした問いはローカル推論への反論ではありません。一日限りのデモではなく、頼れるサービスとして動かすための条件です。
結論:ローカルAIは構成の選択肢になりつつある
本当の節目は、すべてのコンピューターで巨大なモデルが動くようになったことではありません。どの重み、変換、マシン、ランタイム、ツールを選ぶかというデプロイ判断が、より多くユーザーに委ねられるようになったことです。
Muse Spark Openはその選択を具体的に示しています。大容量メモリを備えたMac 2台は1つの方法を、より小さな変換モデルは別の方法を示し、ホスティング推論にはまた違うトレードオフがあります。関心のある仕事を確実に完了できる、最小の構成を選びましょう。次に考えるべき問いは「読み込めるか」ではなく、「返ってくる仕事の結果を信頼できるか」です。
出典とデモ
- Meta:Muse Spark Openの公開、2026年10月15日。
- Metaのモデルカードとチェックポイント仕様。
- Hugging Face:ランタイムガイド、MLXのテスト条件、エージェントのデモ、2026年10月15日。
- oQ3e変換版:保存容量の単位、含まれるエンコーダー、使用方法。
- oQ4e変換版:保存容量と1台構成に関する警告。
- oMLXのインストール文書とv0.7.1rc1リリース。
- MLX LMのMuse対応。
- Muse Model License。
製品情報と互換性は2026年10月16日に確認しました。上記の性能値は、条件を明記した提供元による測定値です。
モデル名だけでなく、判断の根拠を残す
出典リンク、構成メモ、レビュー結果を集めたい読者には、Telli.shも選択肢の1つです。リサーチノートを作成。