40개가 넘는 언어를 실시간으로 번역하고, 통화가 끝나면 지웁니다: 회의를 남기는 층은 다국어 전사입니다
DeepL은 2026년 4월 16일 40개가 넘는 언어를 지원하는 Voice-to-Voice를 출시했고, 같은 제품의 FAQ에는 회의 데이터가 '메모리에서 일시적으로 처리되고 통화가 끝나면 삭제된다'고 적혀 있습니다. 8월 28일에는 Open ASR 리더보드가 첫 글로벌 사우스 언어를 추가하면서, WER 4.9로 사실상 동률인 두 모델이 화자의 출신 지역에 따라 정확도가 흔들리는 폭에서는 거의 네 배 차이가 난다는 것을 보여 줬습니다. 실시간 회의 번역은 이제 흔한 기능이 되어 갑니다. 기록은 아직 아닙니다.
2026년 4월 16일, DeepL이 쾰른에서 Voice-to-Voice를 출시했습니다. 화상 회의, 모바일과 웹에서의 대화, 현장 직원을 위한 그룹 모드, 그리고 기업용 API까지 네 가지 표면을 덮는 실시간 음성 번역 제품군입니다. 지원 언어는 40개가 넘고, EU 공식 언어 24개 전부에 베트남어, 태국어, 아랍어, 노르웨이어, 히브리어, 벵골어, 타갈로그어가 더해집니다. DeepL이 의뢰하고 Slator가 진행한 블라인드 평가에서는 언어 전문가의 96%가 구글, 마이크로소프트, 줌에 기본 탑재된 번역보다 이 제품을 골랐고, Zoom용 DeepL Voice는 100점 만점에 96.4점을 받았습니다. 경쟁 플랫폼은 87~89점이었습니다.
진지하게 잘 만든 제품입니다. 그런데 흥미로운 대목은 출시 자체가 아닙니다. 같은 제품 페이지의 FAQ에 적힌 한 문장입니다. 저희가 2026년 8월 31일에 다시 확인한 문장입니다.
"DeepL은 전사 데이터나 번역 데이터를 영구적으로 저장하지 않습니다. 회의 데이터는 메모리에서 일시적으로 처리되며 통화가 끝나면 삭제됩니다."
두 사실을 나란히 놓고 읽어 보세요. 번역은 훌륭하고, 그 번역은 저녁 무렵이면 사라집니다.
요약
- 실시간 회의 번역은 2026년에 어려운 문제에서 흔한 기능으로 넘어갔습니다. DeepL의 40개 이상 언어, Deepgram Nova-3의 단일 언어 58개, 구글 Meet 안에 들어간 실시간 번역이 그 증거입니다.
- 데이터가 남지 않는 건 대개 의도된 프라이버시 설계이지 결함이 아닙니다. 다만 그 결과로 회의 자체는 다시 볼 수 있는 산출물을 하나도 남기지 않습니다.
- 다국어 전사는 그 아래에 있는 별개의 층입니다. 원문 언어 전사, 번역, 화자 라벨, 요약을 하나의 검토 가능한 기록으로 붙들어 둡니다. 이 글은 왜 하필 원문 언어가 살아남아야 하는지, 그리고 그렇게 되도록 회의를 어떻게 운영하는지를 다룹니다.
저희는 6월에 구글 버전으로 같은 이야기를 한 번 했습니다. Meet과 Translate가 실시간 음성 번역을 소비자에게 밀어 넣던 시점이었죠. 다국어 회의에 여전히 검토 가능한 노트가 필요한 이유에서 다뤘습니다. 그 사이 시장은 저희가 질문만 던져 두었던 부분에 답을 내놨습니다. 실시간 번역은 이제 됩니다. 그래서 흥미로운 질문이 옮겨 갔습니다. 월요일 아침에 당신 손에 남아 있는 건 무엇입니까?
실시간 회의 번역은 더 이상 어려운 부분이 아니다
10년쯤 동안, 실시간 다국어 음성은 실제 회의에 부딪히는 순간 무너지는 데모였습니다. 지연이 말차례를 잡아먹었고, 억양이 인식기를 깨뜨렸고, 조금이라도 전문적인 내용은 뭉개져 나왔습니다. 그 시대가 대략 열 달 만에 끝났습니다.
Deepgram의 Nova-3는 2025년 12월 10일 자 릴리스 노트에서 31개 언어를 적었고, 2026년 8월 문서에서는 58개를 적고 있습니다. 9개월이 채 안 되는 기간에 문서로 확인되는 추가분만 39개, 대략 이레에 하나꼴입니다. 그 확장과 그 밑에 깔린 단서 조항은 음성 인식 언어 커버리지에서 「지원」이 실제로 감추는 것에서 짚었습니다. 구글은 Meet에 실시간 음성 번역을 넣었습니다. DeepL은 4월에 네 표면짜리 음성 제품군을 내놨습니다.
품질 주장도 이제는 반박이 가능할 만큼 구체적입니다. 그 자체가 성숙의 신호죠. DeepL이 의뢰한 Slator 평가는 DeepL Voice의 오류율을 4%로, 경쟁 회의 플랫폼 평균을 17%로 보고합니다. Zoom은 96.4점, Teams는 96.3점입니다. 업체가 의뢰한 숫자는 업체가 의뢰한 숫자로 취급하는 게 맞습니다. 다만 방향 자체는 논쟁거리가 아니고, 출시를 정직하게 다룬 보도도 같은 방향을 가리킵니다. The Next Web은 2026년 4월 17일 자 기사에서 서울 시연이 한두 문장 정도의 지연으로 돌아갔다고 전했고, DeepL의 최고제품책임자가 언어 간 어순 차이는 음성 대 음성 번역의 속도를 근본적으로 제약하는 요소로 남는다고 인정했다고 덧붙였습니다.
한두 문장 지연이면 충분히 쓸 만합니다. 조약 협상에서 전문 통역사를 대체할 정도는 아니고, 그렇게 주장하는 사람도 없습니다. 하지만 바르샤바와 서울과 상파울루가 함께하는 화요일 제품 싱크에는 넉넉합니다. 우리 대부분이 실제로 하는 회의는 그쪽이죠.
여기서 핵심입니다. 어떤 역량이 이 속도로 이만큼 좋아지면 병목이 옮겨 갑니다. 이미 옮겨 갔습니다. 병목은 이제 한 층 아래, 회의가 남기고 가는 것에 있습니다.
번역은 설계상 통화보다 오래 남지 않는다
아까 그 FAQ 문장으로 돌아가 보죠. 그건 부주의가 아닙니다. 보안 설계이고, 꽤 좋은 설계입니다. DeepL의 문장은 이렇게 이어집니다. 모든 데이터는 전송 중 암호화되고, 모델 학습에 쓰이지 않으며, "회의 참가자의 로컬 기기에만 남습니다." 은행이나 병원이 회의 도구를 도입할 때 법무 검토를 가장 빨리 통과시키는 답변이 바로 "아무것도 보관하지 않습니다"입니다.
같은 태도는 실시간 자막 분야 전반에 퍼져 있습니다. 다국어 회의 오디오를 저장한다는 건 누구도 떠안고 싶지 않은 종류의 책임이니까요. 그래서 업계의 기본값은 이렇게 굳었습니다. 그 순간의 이해는 탁월하고, 그 뒤에 남는 산출물은 없습니다.
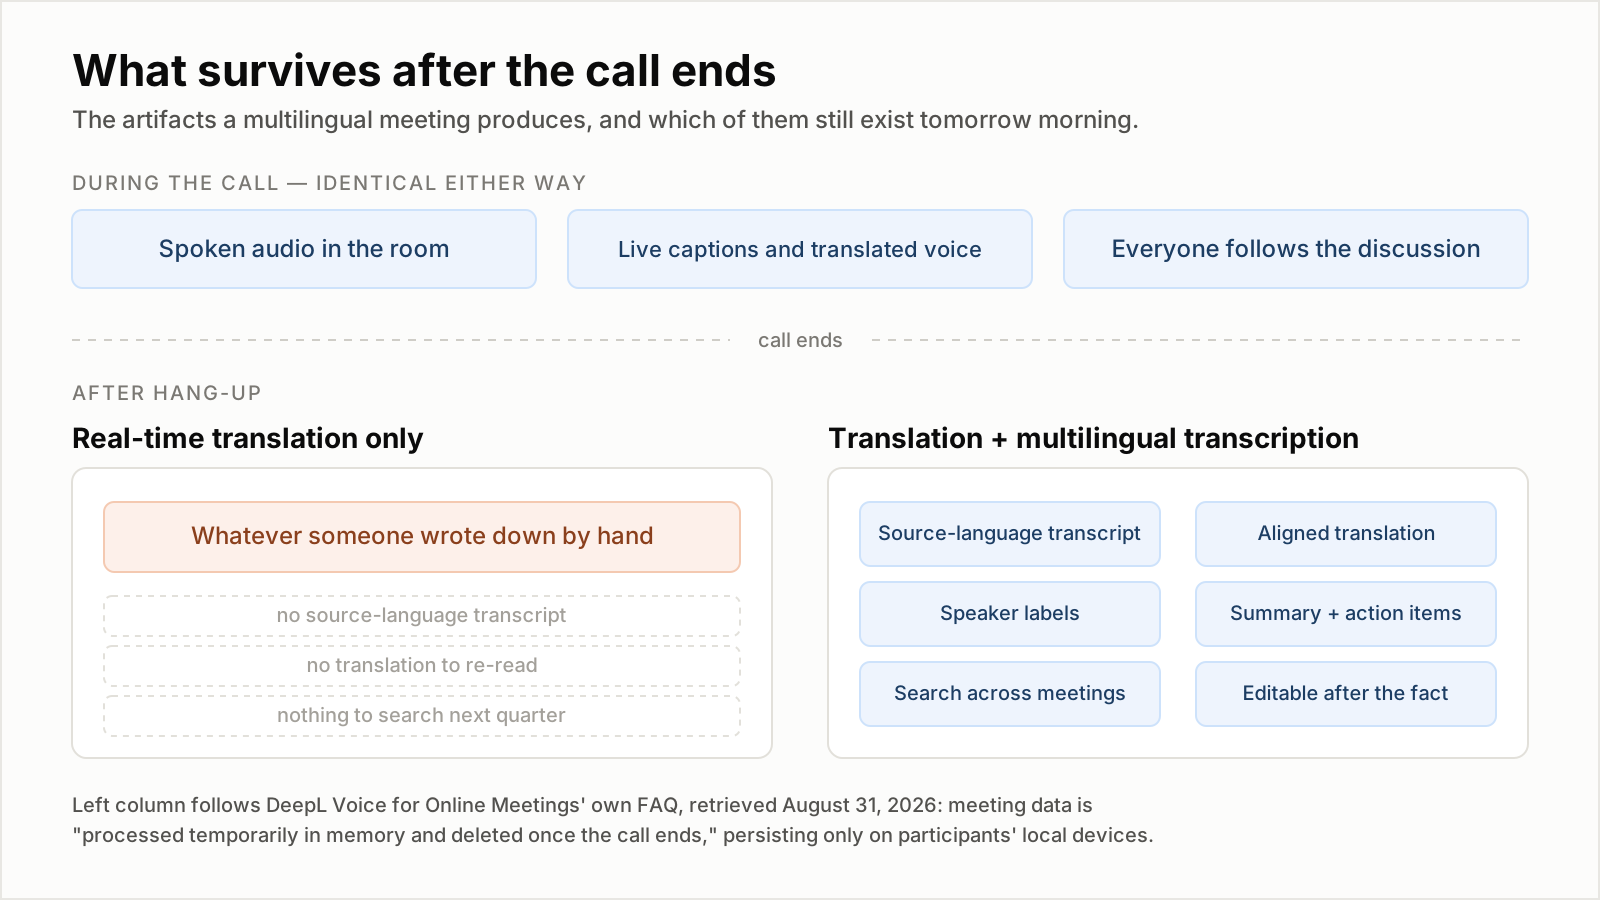
통화가 진행되는 동안 두 방식은 구별되지 않습니다. 차이는 전부 통화 종료 이후에 있습니다. 왼쪽 열은 2026년 8월 31일에 확인한 DeepL Voice for Online Meetings의 자체 FAQ를 따릅니다.
이 구조가 만들어 내는 실패에는 형태가 있고, 이름이 필요합니다. 결정 표류라고 부르겠습니다. 모두가 회의를 완벽하게 이해했는데, 3주 뒤에는 무엇이 합의됐는지 아무도 증명하지 못하는 상태입니다. 오해가 아닙니다. 실시간 번역은 제 일을 했습니다. 문제는 두 언어로 내려진 결정의 유일한 사본이 다섯 사람의 기억 속에, 다섯 가지 표현으로, 최소 두 개 언어로 흩어져 있다는 것이고, 기억은 재생하지 않고 재구성한다는 것입니다.
결정 표류는 도구 청구서에는 절대 찍히지 않는 방식으로 비쌉니다. 다시 만든 기능으로, 다시 협상한 마감일로, 아무도 답하지 못하는 컴플라이언스 질문으로, 지난 분기에 팀이 무엇을 정했는지 배울 길이 없는 신입의 온보딩으로 나타납니다.
8월 28일, 원문 언어가 왜 필요한지 설명해 준 벤치마크
전사가 이미 해결된 균일한 상품이라면 기록을 남기는 일은 저장 공간 문제였을 테고 이 글은 짧았을 겁니다. 그렇지 않습니다. 가장 선명한 최근 증거가 사흘 전에 나왔습니다.
2026년 8월 28일, Hugging Face와 Voice Arena는 Open ASR 리더보드에 첫 글로벌 사우스 언어를 추가했습니다. 5억 명 넘게 쓰는 힌디어가, 그때까지 유럽 언어만 다루던 다국어 탭에 들어갔습니다. 함께 공개된 평가 세트는 Monsoon en-IN과 hi-IN의 공개·비공개 스플릿 네 개입니다. 화자가 겹치지 않는 4,888명, 화자당 12개 속성, 428개 디스트릭트와 수백 종의 실제 단말에서 모은 음성입니다. 스튜디오가 아니라요.
그러고 나서 리더보드에 올라 있던 모델들을 이 세트에 돌렸습니다. 그 결과가 이번 달 음성 인식에 관해 나온 가장 쓸모 있는 자료입니다.
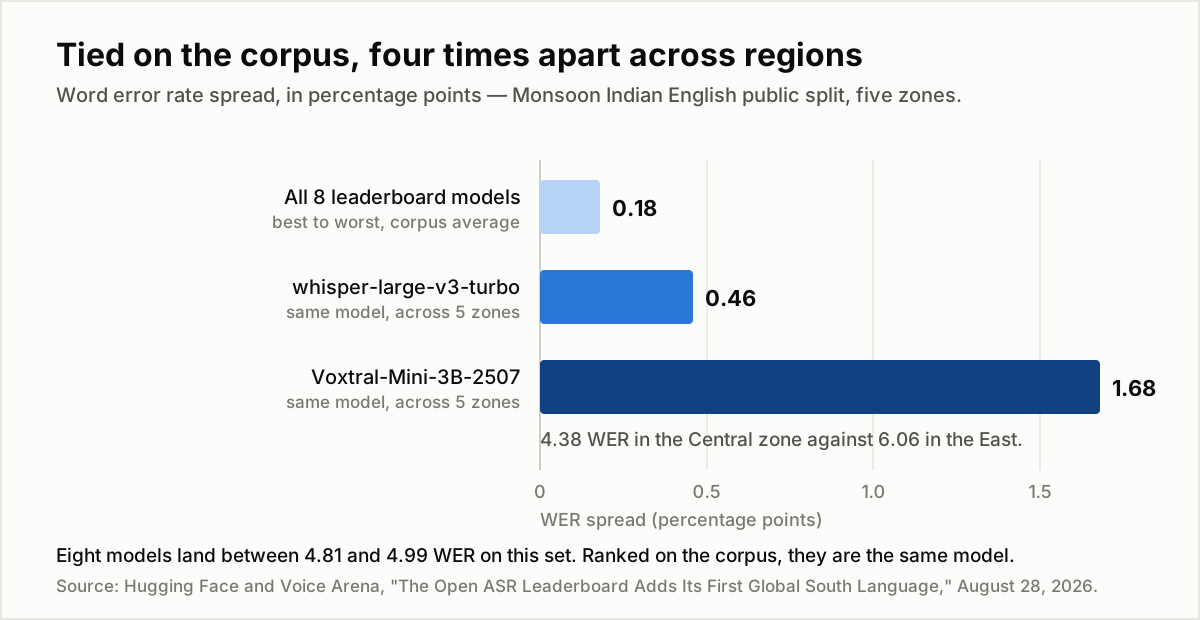
하나의 축에 같은 단위를 씁니다. 비교 대상들이 WER 몇 포인트만큼 떨어져 있는가입니다. 출처: Hugging Face와 Voice Arena, 2026년 8월 28일.
리더보드의 여덟 개 모델은 인도 영어 공개 스플릿에서 WER 4.81에서 4.99 사이에 몰려 있습니다. 최고와 최저의 차이가 0.18포인트, 5시간짜리 음성으로는 분해조차 되지 않는 폭입니다. 원문 표현대로, 코퍼스 기준으로 줄을 세우면 이들은 같은 모델입니다.
그런데 화자를 지역별로 묶으면 같은 모델이 아니게 됩니다. 각 화자의 고향 디스트릭트를 존 협의회 단위로 올려 묶었더니, openai/whisper-large-v3-turbo는 다섯 개 존에 걸쳐 0.46포인트만 흔들렸습니다. 코퍼스 평균으로는 그보다 고작 0.14포인트 뒤에 있는 mistralai/Voxtral-Mini-3B-2507은 1.68포인트 흔들렸습니다. 중부 존에서 WER 4.38, 동부 존에서 6.06입니다. 리더보드에서 구별되지 않던 두 시스템이, 화자가 어디서 자랐는지에 정확도가 얼마나 좌우되는지에서는 거의 네 배 차이가 납니다.
어느 한 지역이 그냥 더 어려운 것도 아닙니다. ibm-granite/granite-speech-3.3-2b는 북부에서, microsoft/VibeVoice-ASR-HF는 남부에서, Voxtral은 동부에서 가장 나쁩니다. 특정 존이 본질적으로 어려웠다면 모든 모델이 존 순위를 같게 매겼을 겁니다. 그러지 않았다는 건 음성이 아니라 모델을 가리킵니다.
다국어 회의를 운영하는 입장에서 읽어야 할 대목은 이겁니다. 당신의 전사 품질은 찾아보면 나오는 하나의 숫자가 아닙니다. 그 방에 누가 있는지에 따라 달라지는 함수입니다. 당신 업체가 가장 적게 학습한 억양을 가진 동료가, 문장이 틀려 나올 동료입니다. 리더보드도 업체 소개 페이지도 그 사실을 경고해 주지 않습니다. 유일한 방어는 사람이 읽고 고칠 수 있는 전사이고, 그러려면 전사가 존재해야 합니다.
힌디어는 같은 구절을 열 가지로 적는다. 번역은 그중 하나를 고른다
같은 발표의 두 번째 발견은 더 미묘하고, 이 글의 논지에 더 가깝게 파고듭니다.
영어의 철자 변이는 경계가 있습니다. 영국식과 미국식, 문장 부호, 숫자를 숫자로 쓸지 말로 쓸지 정도죠. 정규화기가 대부분을 한 형태로 매핑합니다. 힌디어는 그렇게 경계 지어지지 않습니다. 일상 발화가 코드 혼용으로 가득하고, 영어에서 온 단어에는 정착된 데바나가리 표기가 없으며, 복합어는 취향에 따라 붙여 쓰거나 띄어 씁니다. 한 구절에 유효한 표기가 열 가지 넘게 존재할 수 있고, 그것들을 끌어다 붙일 정본이 아예 없습니다.
그래서 힌디어 스플릿은 래티스를 함께 배포합니다. 전사의 각 구간마다 정답으로 인정되는 표기의 집합을 붙여 두는 방식입니다. 채점도 일반 WER이 아니라 AI4Bharat이 제안한 OIWER, 즉 철자를 감안한 단어 오류율로 합니다. 같은 가설 전사를 래티스를 하나로 눌러 편 단일 정답 기준으로 다시 채점했더니, 모든 시스템의 오류율이 올라갔고, 균일하게 오르지 않았으며, 시스템 쌍의 순위가 뒤집혔습니다. 단일 정답 아래에서 모델은 주석자가 고른 철자를 재현한 것에 부분적으로 보상받습니다. 래티스 아래에서는 인식 자체로만 채점됩니다.
이게 무슨 뜻인지 잠깐 머물러 보세요. "무엇이라고 적혔는가" 수준에서도 정답 문자열이 하나로 정해지지 않는 경우가 흔합니다. 허용되는 집합이 있을 뿐이고, 그중 하나를 고르는 순간 정보가 버려집니다.
번역은 바로 그 압축을 한 층 위에서, 훨씬 크게 하는 일입니다. 번역된 모든 문장은 원문이 굳이 내리지 않아도 됐던 선택을 대신 내린 결과입니다.
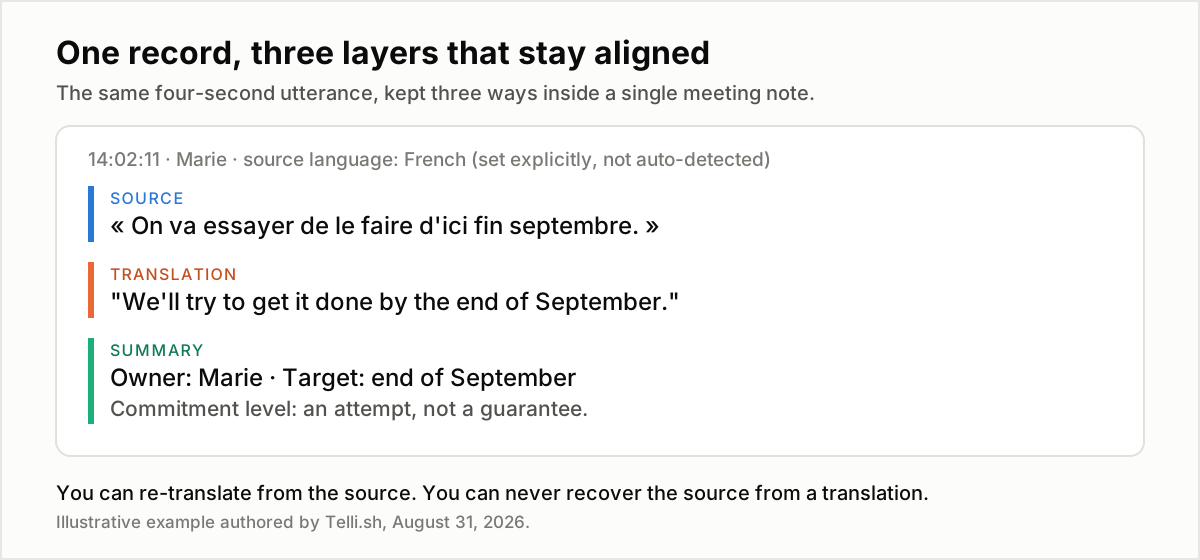
세 층 가운데 나머지로부터 다시 만들어 낼 수 없는 건 원문 줄 하나뿐입니다.
"On va essayer de le faire d'ici fin septembre"가 "9월 말까지 해 보겠습니다"가 되는 순간, 실제로 무언가 달라집니다. 프랑스어 essayer가 지닌 특유의 완곡한 결이 "해 보겠다"로 눌리면서요. 그건 약속이었을까요, 의향이었을까요? 번역된 줄은 답해 주지 못합니다. 원문 줄은 답해 줍니다. 6주 뒤 일정이 밀리고 두 팀이 그 문장을 다르게 기억할 때, 원문 줄이 논쟁의 전부입니다.
이 주제 전체의 중심에 있는 비대칭이 이겁니다. 번역은 한 방향입니다. 원문에서 번역은 몇 번이든 다시 할 수 있습니다. 내년에 더 좋은 모델로 다시 하면 됩니다. 하지만 번역에서 원문은 결코 복원되지 않습니다.
통화가 끝난 뒤 남는 것: 실시간 번역기 vs 기록이 남는 회의 번역기
지금 팀들이 다국어 회의를 처리하는 세 가지 방식을 나란히 놓고 그대로 적어 보겠습니다.
| 다음 날 아침에 남아 있는 것 | 실시간 번역 레이어 | 사람 통역사 | 노트가 남는 회의 번역기 |
|---|---|---|---|
| 그 자리에서의 이해 | 있음 | 있음, 품질 최상 | 있음 |
| 회의 오디오 | 따로 녹음한 경우만 | 따로 녹음한 경우만 | 있음 |
| 원문 언어 전사 | 없음 | 따로 전사하지 않는 한 없음 | 있음 |
| 원문에 정렬된 번역 | 없음 | 없음 | 있음 |
| 어느 줄을 누가 말했는지 | 없음 | 없음 | 있음, 화자 라벨 |
| 요약과 실행 항목 | 없음 | 통역사 메모가 있다면 그것뿐 | 있음, 전사에서 생성 |
| 3개월 뒤 검색 | 안 됨 | 안 됨 | 됨 |
| 틀린 줄을 고치기 | 안 됨 | 사후에는 불가 | 됨, 기록을 편집 |
| 시간당 대략 비용 | 소프트웨어 구독 | 미화 100~200달러 이상, 긴 세션은 통역사 2인 | 소프트웨어 구독 |
사라지는 쪽 열의 동작은 2026년 8월 31일에 확인한 DeepL Voice for Online Meetings의 공개 FAQ를 따릅니다. 통역 요율은 전문 회의 통역의 공개된 시세 범위이며 언어 쌍과 시장에 따라 달라집니다. 세 번째 열은 특정 업체가 아니라 「노트가 남는 회의 번역기」 범주 전반을 설명합니다.
이 표의 모양 자체가 논지입니다. 첫 번째 열과 세 번째 열은 구매자가 보통 평가하는 유일한 행, 즉 그 자리에서의 이해에서 동일하고, 회의가 끝난 뒤에 의미가 생기는 모든 행에서 갈립니다. 그리고 업체 비교는 거의 언제나 첫 번째 행에서만 이뤄집니다.
실시간 번역기는 창문입니다. 노트가 남는 회의 번역기는 창문이면서 장부입니다. 팀은 자기가 체험하는 부분이라서 창문을 사고, 그런 다음 한 번도 산 적 없는 장부로 분기를 굴립니다.
기록이 쓸모 있게 남는 다국어 회의 운영법
회의에서 벌어지는 순서대로 여섯 단계입니다. 특별한 건 하나도 없습니다. 실패는 거의 언제나 아무도 결정하지 않았기 때문에 일어납니다.
- 원문 언어를 명시적으로 지정하세요. 자동 감지에 기대지 마세요. 자동 감지는 세션 전체에서 맥락이 가장 빈약한 첫 몇 초의 음성만 듣고 하나를 골라야 하고, 잘못 고르면 뒤따르는 모든 단계가 한꺼번에 나빠집니다. 명시적으로 고르면 전용 단일 언어 모델로 붙여 주기도 합니다. 일반적으로 다국어 모델보다 단일 언어 모델이 더 강합니다. Nova-3만 해도 단일 언어로는 58개를 문서화하지만 코드 스위칭은 정확히 10개입니다.
- 사람들이 말할 언어와 사람들이 읽을 언어를 분리하세요. 이건 서로 다른 목록이고, 하나로 취급하는 것이 이 분야에서 가장 흔한 설정 실수입니다. DeepL 헬프센터도 정확히 이렇게 나눕니다. 「말하는 언어」는 인식기가 받아들이는 목록, 「번역 언어」는 자막으로 표시될 수 있는 목록이고, 뒤쪽이 훨씬 깁니다.
- 기록이 어디에 남을지를 통화 전에 정하고, 그게 회의 플랫폼이 아님을 확인하세요. 번역 업체가 통화 종료 시점에 회의 데이터를 지운다면, 그건 기본값이고 나름 타당한 기본값인데, 그 도구 안의 어떤 설정으로도 기록은 만들어지지 않습니다. 캡처는 의도적으로 따로 선택해야 하는 일입니다.
- 화자 라벨을 켜 두세요. 귀속되지 않은 번역 문장은 나중에 어떤 결정을 뒷받침하기에도 쓸모가 없습니다. "9월까지 하겠다"는 누가 말했는지 알아야 비로소 사실이 됩니다.
- 고유명사와 도메인 용어는 첫 5분 안에 실시간으로 고치세요. 사람 이름, 제품 코드명, 약어는 전사가 안정적으로 실패하는 지점이고, 나중에 생성될 요약에 가장 큰 피해를 주는 지점이기도 합니다. 회의가 도는 중에 고치면 몇 초면 됩니다. 아무도 다시 읽지 않는 문서에서 고치는 비용은 0인데, 아무도 다시 읽지 않기 때문입니다.
- 요약은 가능하면 번역이 아니라 원문 언어 전사에서 만드세요. 번역을 요약하면 손실 단계가 두 번 겹칩니다. 이건 벤치마크로 확인된 결과가 아니라 저희의 권장이지만, 원리는 단순합니다. 각 단계가 정보를 버리고, 겹치면 더 버립니다.
그리고 세 산출물을 하나의 기록 안에 두세요. 전사는 이 도구에, 번역은 채팅 로그에, 요약은 문서에 흩어져 있으면 한 달 안에 서로 어긋나기 시작합니다. 그 어긋남이 애초에 막으려던 바로 그것입니다.
결론: 이해는 대역폭 문제였고, 기록은 기억 문제다
실시간 회의 번역은 대역폭 문제를 풉니다. 대화가 여전히 대화처럼 느껴질 만큼 빠르게 의미를 테이블 건너로 옮기는 문제죠. 2026년 현재 40개가 넘는 언어를 한두 문장 지연으로, 블라인드 테스트에서 96% 선호도로 처리하고 있으니 이 문제는 상당히 풀렸고 분기마다 더 싸지고 있습니다.
다국어 전사는 기억 문제를 풉니다. 그리고 대역폭 쪽 해법은 이 문제를 조금도 건드리지 않습니다. 산출물이 다르고, 보존 정책이 다르고, 실패 방식이 다릅니다. 앞쪽만 사 놓고 뒤쪽까지 샀다고 여기는 팀은, 설명할 수 없는 훌륭한 회의를 계속 하게 됩니다.
그러니 다음 업체 미팅에 들고 갈 질문은 "몇 개 언어를 번역합니까"가 아닙니다. 이제 진지한 업체는 전부 40 이상의 숫자로 답합니다. 물어야 할 것은 이겁니다. 통화가 끝났을 때 무엇이 남아 있고, 그건 누구의 언어입니까?
Telli.sh는 여기에 있습니다. 위의 이야기는 전부 실시간 번역 아래에 깔린 층에 관한 것이고, 저희가 만드는 게 바로 그 층입니다. Telli.sh는 실시간 전사에 44개 대상 언어로의 번역을 얹고, 인터페이스 자체도 15개 언어로 제공합니다. 바르샤바에 있는 참가자가 한국어 스탠드업을 폴란드어로 읽으면서 회의를 따라갈 수 있다는 뜻입니다. 다음 날 아침에 중요한 건, 세 산출물이 하나의 노트 안에 함께 남는다는 점입니다. 실제로 말해진 내용의 원문 언어 텍스트, 거기에 정렬된 번역, 그 위에서 생성된 요약이 통화가 끝난 한참 뒤에도 검토 가능하고, 고칠 수 있고, 검색됩니다.
출처
- Hugging Face·Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 2026년 8월 28일 — Monsoon en-IN·hi-IN 스플릿, 화자 4,888명, 존별 WER 편차, OIWER와 힌디어 래티스.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, 쾰른, 2026년 4월 16일 — 40개 이상 언어, 네 개 제품 표면, DeepL이 의뢰한 Slator 블라인드 평가.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 2026년 4월 17일 — 서울 시연 지연과 어순 제약.
- DeepL, DeepL Voice for Online Meetings 제품 페이지와 FAQ, 2026년 8월 31일 확인 — 데이터 보존 문구, Slator 점수, 온라인 회의용 음성 대 음성 기능이 아직 순차 출시 중이라는 표기.
- DeepL 헬프센터, DeepL Voice languages, 2026년 8월 31일 확인 — 말하는 언어와 번역 언어의 구분.
- AI4Bharat, Orthographically-Informed Word Error Rate — 힌디어 스플릿에 쓰인 지표.
- Deepgram Nova-3 언어 커버리지는 저희 글 음성 인식 언어 확장 분석, 2026년 8월 31일에 정리한 내용입니다.