40+ idiomas traducidos en vivo y borrados al colgar: la transcripción multilingüe es la capa que conserva la reunión
DeepL lanzó Voice-to-Voice el 16 de abril de 2026 en más de 40 idiomas, y las preguntas frecuentes del mismo producto dicen que los datos de la reunión se «procesan temporalmente en memoria y se eliminan cuando termina la llamada». El 28 de agosto, el Open ASR Leaderboard incorporó su primer idioma del Sur Global y mostró que dos modelos empatados en 4,9 de WER se diferencian casi cuatro veces en cuánto depende su precisión de la procedencia de quien habla. La traducción de reuniones en tiempo real se está volviendo un producto básico. El registro no.
El 16 de abril de 2026, DeepL lanzó desde Colonia Voice-to-Voice: una suite de traducción de voz en tiempo real que cubre cuatro superficies — reuniones virtuales, conversaciones en móvil y web, situaciones de grupo para personal de primera línea y una API empresarial. Maneja más de 40 idiomas, incluidos los 24 oficiales de la UE junto con vietnamita, tailandés, árabe, noruego, hebreo, bengalí y tagalo. En evaluaciones a ciegas realizadas por Slator y encargadas por DeepL, el 96 % de los lingüistas la prefirió a la traducción nativa integrada en Google, Microsoft y Zoom; DeepL Voice para Zoom obtuvo 96,4 sobre 100 frente a 87–89 de las plataformas competidoras.
Es un producto serio, y lo interesante no es el lanzamiento. Lo interesante es una frase en las preguntas frecuentes de esa misma página de producto, que volvimos a leer el 31 de agosto de 2026:
«DeepL no almacena de forma permanente datos de transcripción ni de traducción. Los datos de la reunión se procesan temporalmente en memoria y se eliminan cuando termina la llamada.»
Lea los dos hechos uno junto al otro. La traducción es excelente, y esa traducción ha desaparecido para la hora de cenar.
En resumen
- La traducción de reuniones en tiempo real pasó en 2026 de problema difícil a producto básico ya entregado: más de 40 idiomas en DeepL, 58 idiomas monolingües en Nova-3 de Deepgram, traducción en vivo dentro de Google Meet.
- Que no quede nada suele ser una decisión deliberada de privacidad, no un defecto — pero significa que la reunión en sí no deja ningún artefacto revisable.
- La transcripción multilingüe es la capa aparte que hay debajo. Mantiene juntos, en un mismo registro revisable, la transcripción en el idioma original, la traducción, la atribución de hablantes y el resumen. Este artículo explica por qué debe sobrevivir precisamente el idioma original y cómo conducir la reunión para que sobreviva.
La versión de este argumento centrada en Google la escribimos en junio, cuando Meet y Translate empujaban la traducción de voz en vivo al gran público: por qué las reuniones multilingües siguen necesitando notas revisables. Desde entonces el mercado ha respondido una pregunta que nosotros solo planteábamos. La traducción en vivo ya funciona. Así que la pregunta interesante se ha desplazado: ¿qué tiene usted el lunes?
La traducción de reuniones en tiempo real ya no es la parte difícil
Durante una década, el habla multilingüe en vivo fue la demo que nunca sobrevivía al contacto con una reunión real. La latencia se comía los turnos de palabra, los acentos rompían el reconocedor y cualquier cosa mínimamente técnica salía destrozada. Esa era terminó en unos diez meses.
Nova-3 de Deepgram enumeraba 31 idiomas en una nota de versión del 10 de diciembre de 2025 y 58 en su documentación de agosto de 2026: 39 incorporaciones documentadas en menos de nueve meses, aproximadamente un idioma nuevo cada siete días. Recorrimos esa expansión, y la letra pequeña que la sostiene, en qué esconde en realidad la palabra «compatible» en la cobertura de idiomas del reconocimiento de voz. Google metió traducción de voz en vivo en Meet. DeepL entregó en abril una suite de voz con cuatro superficies.
Las afirmaciones de calidad ya son lo bastante concretas como para discutirlas, lo cual es en sí una señal de madurez. La evaluación de Slator encargada por DeepL informa de una tasa de error del 4 % para DeepL Voice frente a un 17 % de media en plataformas de reuniones competidoras, y de 96,4/100 en Zoom y 96,3/100 en Teams. Los números encargados por el proveedor se tratan como números encargados por el proveedor. Pero la dirección no está en disputa, y la cobertura honesta del lanzamiento apunta al mismo sitio: The Next Web, en su artículo del 17 de abril de 2026, describió una demo en vivo en Seúl funcionando con un desfase de una a dos frases, y recogió que el director de producto de DeepL admitía que las diferencias de orden de palabras entre idiomas siguen siendo una restricción fundamental sobre la velocidad que puede alcanzar la traducción voz a voz.
Un desfase de una a dos frases es suficiente. No es suficiente para sustituir a un intérprete profesional en la negociación de un tratado, y nadie lo afirma. Sí es de sobra suficiente para la reunión de producto del martes entre Varsovia, Seúl y São Paulo, que es la reunión que la mayoría tenemos de verdad.
Aquí está el punto: cuando una capacidad mejora tanto y tan rápido, el cuello de botella se mueve. Ya se ha movido. Ahora está una capa más abajo, en lo que la reunión deja detrás.
Por diseño, la traducción no sobrevive a la llamada
Volvamos a esa frase de las preguntas frecuentes, porque no es un descuido. Es una postura de seguridad, y buena. La propia redacción de DeepL continúa: todos los datos van cifrados en tránsito, nunca se usan para entrenar modelos y «solo persisten en el dispositivo local de los participantes de la reunión». Cuando un banco o un hospital compra una herramienta de reuniones, «no guardamos nada» es la respuesta que pasa el filtro legal más rápido.
La misma postura es común en toda la categoría de subtítulos en vivo, porque almacenar audio de reuniones multilingües es exactamente el tipo de responsabilidad que nadie quiere heredar. Así que el valor por defecto del sector es ahora: comprensión magnífica en el momento y ningún artefacto después.
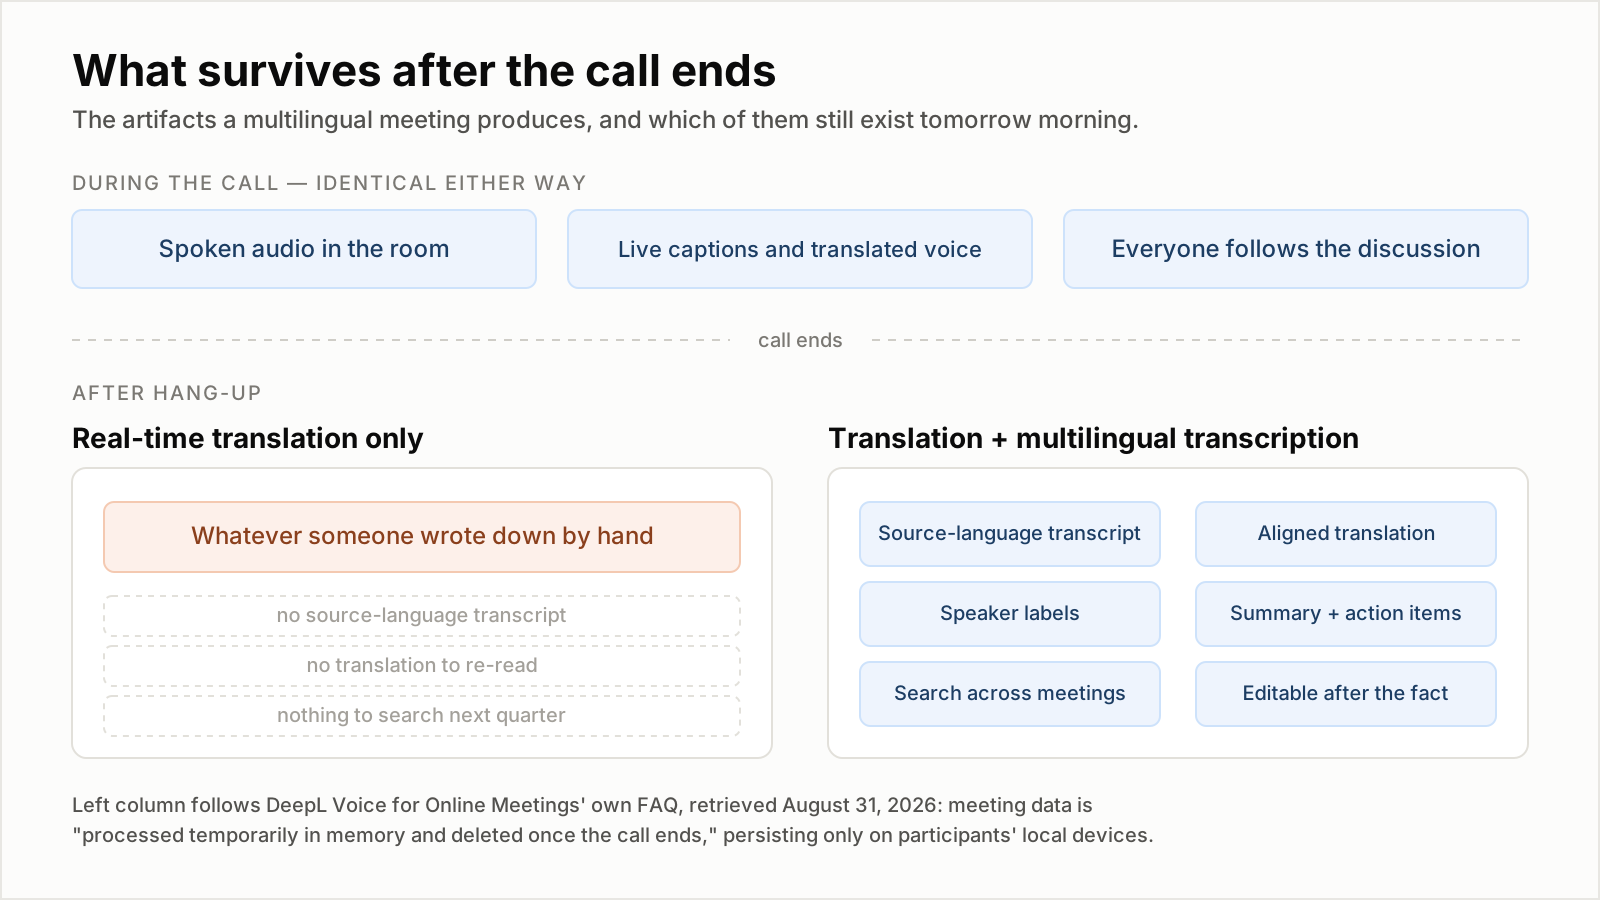
Durante la llamada, los dos enfoques son indistinguibles. La diferencia está toda al otro lado del colgado. La columna izquierda sigue las preguntas frecuentes de DeepL Voice for Online Meetings, consultadas el 31 de agosto de 2026.
El modo de fallo que esto produce tiene una forma, y necesita un nombre. Llamémoslo deriva de decisiones: todo el mundo entendió la reunión a la perfección y, tres semanas después, nadie puede demostrar qué se acordó. No es un malentendido: la traducción en vivo hizo su trabajo. Es que la única copia superviviente de una decisión tomada en dos idiomas vive en cinco memorias, con cinco formulaciones distintas, en al menos dos idiomas, y la memoria reconstruye en lugar de reproducir.
La deriva de decisiones sale cara de un modo que nunca aparece en la factura de la herramienta. Aparece como una funcionalidad rehecha, un plazo renegociado, una pregunta de cumplimiento que nadie sabe contestar, una incorporación nueva que no tiene manera de aprender qué decidió el equipo el trimestre pasado.
28 de agosto: el benchmark que explica por qué necesita el idioma original
Si la transcripción fuera un producto básico ya resuelto y uniforme, conservar el registro sería un problema de almacenamiento y este artículo sería corto. No lo es, y la evidencia reciente más clara aterrizó hace tres días.
El 28 de agosto de 2026, Hugging Face y Voice Arena añadieron el primer idioma del Sur Global al Open ASR Leaderboard: el hindi, hablado por más de quinientos millones de personas, entró en una pestaña multilingüe que hasta entonces solo cubría idiomas europeos. Aportaron cuatro conjuntos de evaluación — Monsoon en-IN y hi-IN, en versión pública y privada — con 4.888 hablantes sin solapamiento, 12 atributos registrados por hablante, recogidos en 428 distritos y en cientos de modelos de teléfono reales en lugar de un estudio.
Después pusieron a correr sobre ellos los modelos del propio ranking. El resultado es lo más útil que se ha publicado este mes sobre reconocimiento de voz.
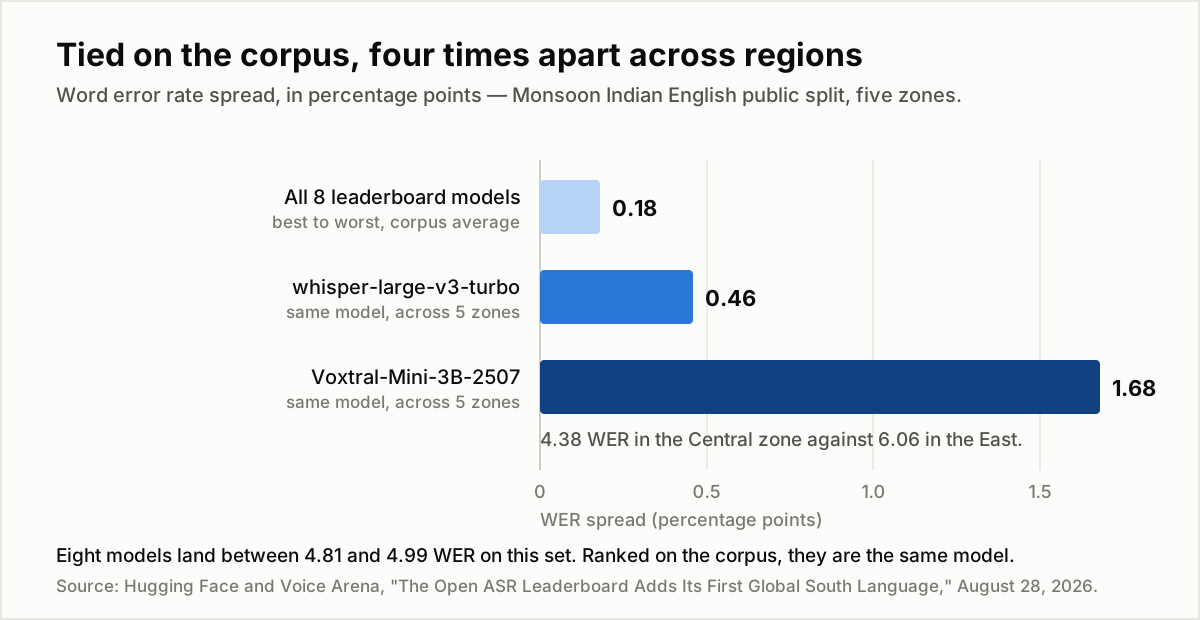
Un solo eje, una sola unidad: cuántos puntos de WER separan a los elementos comparados. Fuente: Hugging Face y Voice Arena, 28 de agosto de 2026.
Ocho modelos del ranking se sitúan entre 4,81 y 4,99 de WER en el conjunto público de inglés indio. Eso son 0,18 puntos del mejor al peor, dentro de lo que cinco horas de audio siquiera pueden resolver. Ordenados por corpus, como dice la publicación, son el mismo modelo.
Agrupe a los hablantes por región y dejan de serlo. Al elevar el distrito natal de cada hablante a su consejo zonal, openai/whisper-large-v3-turbo varía 0,46 puntos entre las cinco zonas. mistralai/Voxtral-Mini-3B-2507, apenas 0,14 puntos por detrás en la media del corpus, varía 1,68: 4,38 de WER en la zona central frente a 6,06 en el Este. Dos sistemas indistinguibles en el ranking difieren casi cuatro veces en cuánto depende su precisión de dónde creció quien habla.
Y no es que una región sea sencillamente más difícil. ibm-granite/granite-speech-3.3-2b es el peor en el Norte, microsoft/VibeVoice-ASR-HF en el Sur y Voxtral en el Este. Si alguna zona fuera intrínsecamente difícil, todos los modelos ordenarían las zonas igual. No lo hacen, y eso señala a los modelos, no al audio.
La lectura operativa para quien dirige reuniones multilingües: su calidad de transcripción no es un número que se consulta. Es una función de quién está en la sala. El compañero cuyo acento su proveedor menos muestreó es el compañero cuyas frases saldrán mal, y ni el ranking ni la página del proveedor se lo advertirán. La única defensa es una transcripción que una persona pueda leer y corregir, lo cual exige que exista una transcripción.
El hindi escribe la misma expresión de diez formas válidas. Una traducción elige una.
El segundo hallazgo de esa misma publicación es más sutil y toca más de cerca el argumento.
La variación ortográfica del inglés está acotada: británico frente a americano, puntuación, cifras frente a palabras. Un normalizador reduce casi todo a una forma. El hindi no está acotado así. El habla cotidiana está muy mezclada con inglés, las palabras de origen inglés no tienen grafía devanagari asentada y los compuestos se escriben unidos o separados según la preferencia de cada cual. Una sola expresión puede tener diez o más formas escritas válidas, y no existe un lado canónico al que reducirlas.
Por eso los conjuntos de hindi incluyen una retícula: para cada tramo de la transcripción, el conjunto de grafías aceptadas como correctas. Y se puntúan con OIWER — tasa de error de palabra informada por la ortografía, propuesta por AI4Bharat — en lugar de WER simple. Cuando se volvieron a puntuar las mismas hipótesis contra una versión aplanada a una referencia única, las tasas de error subieron en todos los sistemas, subieron de forma desigual y hubo pares de sistemas que invirtieron su orden. Con referencia única, un modelo recibe parte de su premio por reproducir la ortografía que eligió quien anotó; con la retícula solo se puntúa el reconocimiento.
Deténgase un momento en lo que implica. Incluso en el plano de «qué se escribió» a menudo no hay una única cadena correcta: hay un conjunto de cadenas admisibles, y elegir una tira información.
La traducción es exactamente ese colapso, un nivel más arriba y mucho más destructivo. Cada línea traducida decide entre lecturas que el original no tenía que decidir.
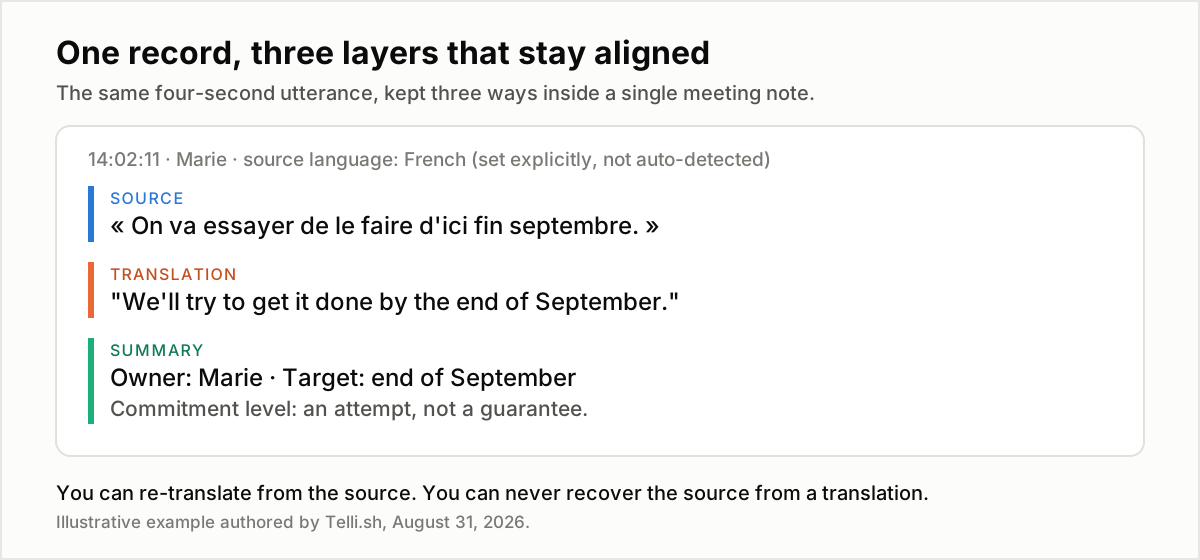
La línea en el idioma original es la única de las tres que no se puede regenerar a partir de las otras.
Cuando «On va essayer de le faire d'ici fin septembre» se convierte en «Intentaremos tenerlo para finales de septiembre», algo real ha cambiado: el essayer francés lleva un registro de atenuación propio que «intentar» aplana. ¿Era un compromiso o una intención? La línea traducida no puede decirlo. La línea original sí. Seis semanas después, cuando la fecha se retrasa y dos equipos recuerdan la frase de forma distinta, la línea original es el argumento entero.
Esta es la asimetría en el centro de todo el tema. La traducción va en un solo sentido. Puede retraducir desde el original tantas veces como quiera, el año que viene con un modelo mejor. Nunca podrá recuperar el original desde la traducción.
Qué queda al terminar la llamada: traductor en tiempo real frente a traductor de reuniones con notas
Aquí está la comparación dicha sin rodeos, entre las tres maneras en que los equipos manejan hoy una reunión multilingüe.
| Lo que tiene a la mañana siguiente | Capa de traducción en tiempo real | Intérprete humano | Traductor de reuniones con notas |
|---|---|---|---|
| Comprensión en la sala | Sí | Sí, máxima calidad | Sí |
| Audio de la reunión | Solo si se grabó aparte | Solo si se grabó aparte | Sí |
| Transcripción en el idioma original | No | No, salvo transcripción aparte | Sí |
| Traducción alineada con el original | No | No | Sí |
| Quién dijo cada línea | No | No | Sí, con atribución |
| Resumen y tareas pendientes | No | Las notas del intérprete, si las hay | Sí, generado desde la transcripción |
| Buscable tres meses después | No | No | Sí |
| Línea errónea corregible | No | No a posteriori | Sí, editando el registro |
| Coste típico por hora | Suscripción de software | 100–200 USD o más, dos intérpretes en sesiones largas | Suscripción de software |
El comportamiento de la columna efímera sigue las preguntas frecuentes publicadas de DeepL Voice for Online Meetings, consultadas el 31 de agosto de 2026; las tarifas de interpretación son el rango de mercado ampliamente publicado para interpretación de conferencias profesional y varían según el par de idiomas y el mercado. La tercera columna describe la categoría «traductor de reuniones con notas» en general, no a un proveedor concreto.
La forma de la tabla es el argumento. La columna uno y la tres son idénticas en la única fila que un comprador suele evaluar — la comprensión en directo — y difieren en todas las filas que importan después de la reunión. Las comparativas de proveedores casi siempre se juegan en la primera fila.
Un traductor en vivo es una ventana. Un traductor de reuniones con notas es una ventana y un libro de cuentas. Los equipos compran ventanas porque es la parte que experimentan, y luego gobiernan su trimestre con un libro que nunca compraron.
Cómo conducir una reunión multilingüe para que el registro siga siendo útil
Seis pasos, en el orden en que ocurren. Ninguno es exótico; el fallo casi siempre es que nadie decidió.
- Fije el idioma original de forma explícita. No se apoye en la detección automática. La detección tiene que comprometerse en los primeros segundos, con el audio menos contextual de toda la sesión, y un fallo degrada de golpe todas las etapas posteriores. Elegirlo explícitamente además permite al motor encaminarle a un modelo monolingüe dedicado, que suele ser más fuerte que uno multilingüe: Nova-3, por ejemplo, documenta 58 idiomas uno a uno, pero alternancia de código en exactamente 10.
- Separe los idiomas que la gente va a hablar de los que va a leer. Son dos listas distintas, y tratarlas como una es el error de configuración más habitual de la categoría. El centro de ayuda de DeepL lo separa exactamente así: los «idiomas hablados» son los que acepta el reconocedor y los «idiomas de traducción» aquellos en los que pueden mostrarse los subtítulos, y la segunda lista es mucho más larga.
- Decida antes de la llamada dónde vivirá el registro y confirme que no es la plataforma de reuniones. Si su proveedor de traducción borra los datos al colgar — que es el comportamiento por defecto, y defendible — entonces ninguna configuración dentro de esa herramienta producirá un registro. La captura tiene que ser una elección deliberada y aparte.
- Mantenga activada la atribución de hablantes. Una línea traducida sin atribución no sirve para ninguna decisión que después pretenda sostener. «Lo tendremos para septiembre» solo se convierte en un hecho cuando se sabe quién lo dijo.
- Corrija nombres y términos de dominio en los primeros cinco minutos, en directo. Nombres propios, nombres en clave de producto y siglas son el punto donde la transcripción falla de forma fiable, y también donde una línea equivocada más daña el resumen que se genere después. Arreglarlo mientras la reunión avanza cuesta segundos; arreglarlo en un documento que nadie relee no cuesta nada, porque nadie lo relee.
- Genere el resumen desde la transcripción en el idioma original cuando pueda, no desde la traducción. Resumir una traducción apila dos pasos con pérdida. Esto es una recomendación nuestra, no un resultado medido, pero el mecanismo es directo: cada etapa descarta información y apilarlas descarta más.
Y guarde los tres artefactos en un mismo registro. Una transcripción en una herramienta, una traducción en un chat y un resumen en un documento son tres archivos que se contradirán en menos de un mes, y esa contradicción es justo lo que quería evitar.
En el fondo: la comprensión era el problema de ancho de banda, el registro es el problema de memoria
La traducción de reuniones en tiempo real resuelve un problema de ancho de banda: llevar el significado al otro lado de la mesa lo bastante rápido como para que la conversación siga pareciendo una conversación. En 2026, con más de 40 idiomas a una o dos frases de desfase y un 96 % de preferencia en pruebas a ciegas, ese problema está resuelto en lo esencial y se abarata cada trimestre.
La transcripción multilingüe resuelve un problema de memoria, y nada de la solución de ancho de banda lo toca. Otro artefacto, otra política de conservación, otro modo de fallo. Un equipo que compra solo lo primero y da por hecho que se llevó lo segundo seguirá teniendo reuniones excelentes de las que no puede rendir cuentas.
Así que la pregunta para su próxima llamada con un proveedor no es «a cuántos idiomas traduce». Cualquier proveedor serio responde ya con un número superior a 40. La pregunta es: cuando la llamada termina, ¿qué sigue existiendo, y en el idioma de quién?
Dónde encaja Telli.sh: todo lo anterior trata de la capa que hay bajo la traducción en vivo, y esa capa es justamente la que construimos. Telli.sh ofrece transcripción en directo con traducción a 44 idiomas de destino, con una interfaz disponible en 15, de modo que quien participa desde Varsovia lee en polaco una reunión diaria en coreano mientras ocurre. Lo que importa a la mañana siguiente es que los tres artefactos permanecen en una misma nota: el texto en el idioma original de lo que se dijo realmente, la traducción alineada con él y el resumen generado encima. Revisable, corregible y buscable mucho después de que la llamada termine.
Empezar una nota de reunión traducida en directo
Fuentes
- Hugging Face y Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 de agosto de 2026 — conjuntos Monsoon en-IN y hi-IN, 4.888 hablantes, varianza del WER por zona, OIWER y la retícula del hindi.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Colonia, 16 de abril de 2026 — más de 40 idiomas, las cuatro superficies de producto y la evaluación a ciegas de Slator encargada por DeepL.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 de abril de 2026 — latencia de la demo de Seúl y la restricción del orden de palabras.
- DeepL, página de producto y preguntas frecuentes de DeepL Voice for Online Meetings, consultadas el 31 de agosto de 2026 — redacción sobre conservación de datos, puntuaciones de Slator y la nota de que voz a voz para reuniones en línea sigue en despliegue.
- Centro de ayuda de DeepL, DeepL Voice languages, consultado el 31 de agosto de 2026 — la separación entre idiomas hablados e idiomas de traducción.
- AI4Bharat, Orthographically-Informed Word Error Rate — la métrica usada en los conjuntos de hindi.
- La cobertura de idiomas de Nova-3 de Deepgram, recopilada en nuestro análisis de la expansión de idiomas en reconocimiento de voz, 31 de agosto de 2026.