40+ Sprachen live übersetzt, beim Auflegen gelöscht: Mehrsprachige Transkription ist die Schicht, die das Meeting behält
DeepL hat am 16. April 2026 Voice-to-Voice für über 40 Sprachen gestartet, und die FAQ desselben Produkts sagt, Meeting-Daten würden 'temporär im Arbeitsspeicher verarbeitet und nach Ende des Anrufs gelöscht'. Am 28. August nahm das Open ASR Leaderboard seine erste Sprache des Globalen Südens auf und zeigte, dass zwei bei 4,9 WER gleichauf liegende Modelle sich um fast das Vierfache darin unterscheiden, wie stark ihre Genauigkeit von der Herkunft der Sprechenden abhängt. Echtzeit-Meetingübersetzung wird zur Massenware. Das Protokoll nicht.
Am 16. April 2026 hat DeepL aus Köln Voice-to-Voice gestartet: eine Produktsuite für Echtzeit-Sprachübersetzung, die vier Oberflächen abdeckt — virtuelle Meetings, Gespräche über Mobilgerät und Web, Gruppensituationen für Mitarbeitende im Kundenkontakt sowie eine Unternehmens-API. Sie beherrscht mehr als 40 Sprachen, darunter alle 24 EU-Amtssprachen sowie Vietnamesisch, Thailändisch, Arabisch, Norwegisch, Hebräisch, Bengalisch und Tagalog. In Blindtests, die Slator im Auftrag von DeepL durchgeführt hat, bevorzugten 96 % der Sprachprofis das Produkt gegenüber der in Google, Microsoft und Zoom eingebauten Übersetzung; DeepL Voice für Zoom erreichte 96,4 von 100 Punkten gegenüber 87 bis 89 bei den Wettbewerbsplattformen.
Das ist ein ernsthaftes Produkt, und der eigentlich interessante Teil ist nicht der Start. Interessant ist ein Satz in der FAQ derselben Produktseite, den wir am 31. August 2026 noch einmal nachgelesen haben:
„DeepL speichert Transkriptions- und Übersetzungsdaten nicht dauerhaft. Meeting-Daten werden temporär im Arbeitsspeicher verarbeitet und nach Ende des Anrufs gelöscht."
Lesen Sie diese beiden Tatsachen nebeneinander. Die Übersetzung ist exzellent, und die Übersetzung ist zum Abendessen verschwunden.
Kurzfassung
- Echtzeit-Meetingübersetzung ist 2026 vom schwierigen Problem zur ausgelieferten Massenware geworden: über 40 Sprachen bei DeepL, 58 einzelne Sprachen bei Deepgrams Nova-3, Live-Übersetzung direkt in Google Meet.
- Dass nichts bleibt, ist meist eine bewusste Datenschutzentscheidung und kein Fehler — es bedeutet aber, dass das Meeting selbst kein überprüfbares Artefakt hinterlässt.
- Mehrsprachige Transkription ist die eigene Schicht darunter. Sie hält das Transkript in der Ausgangssprache, die Übersetzung, die Sprecherzuordnung und die Zusammenfassung in einem überprüfbaren Datensatz zusammen. Dieser Text erklärt, warum ausgerechnet die Ausgangssprache überleben muss — und wie Sie das Meeting so führen, dass sie es tut.
Die Google-Variante dieses Arguments haben wir im Juni geschrieben, als Meet und Translate Live-Sprachübersetzung in den Massenmarkt drückten: warum mehrsprachige Meetings weiterhin überprüfbare Notizen brauchen. Seitdem hat der Markt eine Frage beantwortet, die wir damals nur gestellt hatten. Live-Übersetzung funktioniert jetzt. Also ist die interessante Frage weitergewandert: Was haben Sie am Montag?
Echtzeit-Meetingübersetzung ist nicht mehr der schwierige Teil
Etwa ein Jahrzehnt lang war live gesprochene Mehrsprachigkeit die Demo, die den Kontakt mit einem echten Meeting nie überlebte. Latenz fraß den Sprecherwechsel, Akzente zerlegten die Erkennung, und alles halbwegs Fachliche kam zerhackt heraus. Diese Ära endete innerhalb von etwa zehn Monaten.
Deepgrams Nova-3 nannte in einer Release Note vom 10. Dezember 2025 noch 31 Sprachen und in der Dokumentation vom August 2026 bereits 58 — 39 dokumentierte Ergänzungen in weniger als neun Monaten, ungefähr eine neue Sprache alle sieben Tage. Diese Expansion und das Kleingedruckte darunter haben wir in was „unterstützt" bei Sprachabdeckung in der Spracherkennung tatsächlich verbirgt auseinandergenommen. Google hat Live-Sprachübersetzung in Meet gebracht. DeepL hat im April eine Sprachsuite mit vier Oberflächen ausgeliefert.
Auch die Qualitätsaussagen sind inzwischen konkret genug, um ihnen zu widersprechen — was für sich genommen ein Reifezeichen ist. Die von DeepL beauftragte Slator-Untersuchung berichtet eine Fehlerrate von 4 % für DeepL Voice gegenüber durchschnittlich 17 % bei konkurrierenden Meeting-Plattformen sowie 96,4/100 für Zoom und 96,3/100 für Teams. Vom Anbieter beauftragte Zahlen behandelt man als vom Anbieter beauftragte Zahlen. Die Richtung steht aber nicht zur Debatte, und die seriöse Berichterstattung zeigt in dieselbe Richtung: The Next Web beschrieb in der Meldung vom 17. April 2026 eine Live-Demo in Seoul mit einer Verzögerung von ein bis zwei Sätzen und zitierte DeepLs Chief Product Officer mit dem Eingeständnis, dass unterschiedliche Wortstellungen zwischen Sprachen eine grundsätzliche Grenze dafür bleiben, wie schnell Sprache-zu-Sprache je werden kann.
Ein bis zwei Sätze Verzögerung reichen aus. Sie reichen nicht, um in einer Vertragsverhandlung eine professionelle Dolmetscherin zu ersetzen, und das behauptet auch niemand. Für den dienstäglichen Produkt-Sync zwischen Warschau, Seoul und São Paulo reichen sie bequem — und das ist das Meeting, das die meisten von uns tatsächlich haben.
Der Punkt ist: Wenn eine Fähigkeit so schnell so gut wird, verschiebt sich der Engpass. Er hat sich verschoben. Er sitzt jetzt eine Schicht tiefer, in dem, was das Meeting hinterlässt.
Die Übersetzung überlebt den Anruf konstruktionsbedingt nicht
Zurück zu diesem FAQ-Satz, denn er ist keine Schlamperei. Er ist eine Sicherheitshaltung, und eine gute. DeepLs eigene Formulierung geht weiter: Alle Daten seien während der Übertragung verschlüsselt, würden nie zum Modelltraining verwendet und blieben „nur auf dem lokalen Gerät der Meeting-Teilnehmer" bestehen. Wenn eine Bank oder ein Krankenhaus ein Meeting-Tool beschafft, ist „wir behalten nichts" die Antwort, die die Rechtsabteilung am schnellsten passiert.
Dieselbe Haltung ist in der gesamten Live-Untertitel-Kategorie üblich, weil das Speichern mehrsprachiger Meeting-Audios genau die Art von Haftung ist, die niemand erben möchte. Der Branchenstandard lautet damit: hervorragendes Verstehen im Moment, danach kein Artefakt.
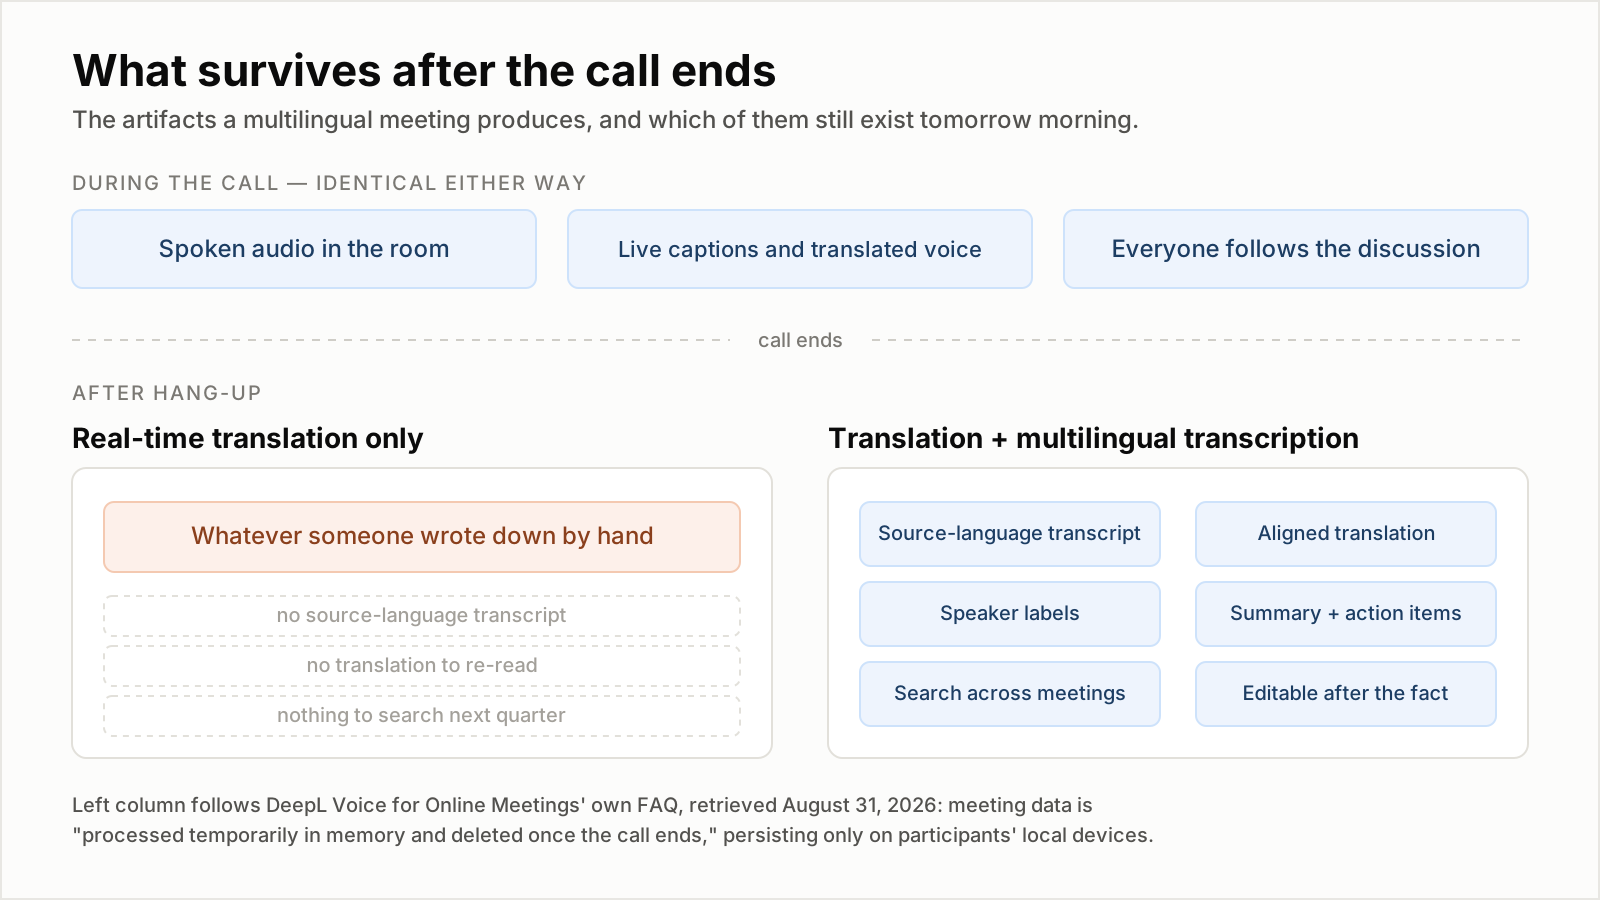
Während des Anrufs sind beide Ansätze nicht unterscheidbar. Der Unterschied liegt vollständig auf der anderen Seite des Auflegens. Die linke Spalte folgt der FAQ von DeepL Voice for Online Meetings, abgerufen am 31. August 2026.
Der Fehlermodus, den das erzeugt, hat eine Form und braucht einen Namen. Nennen wir ihn Entscheidungsdrift: Alle haben das Meeting perfekt verstanden, und drei Wochen später kann niemand mehr belegen, was vereinbart wurde. Es ist kein Missverständnis — die Live-Übersetzung hat ihre Arbeit getan. Es ist, dass die einzige erhaltene Kopie einer in zwei Sprachen getroffenen Entscheidung in fünf Erinnerungen liegt, in fünf verschiedenen Formulierungen, in mindestens zwei Sprachen, und Erinnerung rekonstruiert, statt abzuspielen.
Entscheidungsdrift ist auf eine Weise teuer, die nie auf der Rechnung des Tools erscheint. Sie erscheint als noch einmal gebautes Feature, als neu verhandelter Termin, als Compliance-Frage, die niemand beantworten kann, als neue Kollegin, die keine Möglichkeit hat zu lernen, was das Team im letzten Quartal entschieden hat.
28. August: der Benchmark, der erklärt, warum Sie die Ausgangssprache brauchen
Wäre Transkription eine gelöste, überall gleich gute Massenware, dann wäre das Aufbewahren ein Speicherproblem und dieser Text kurz. Ist sie nicht, und der klarste aktuelle Beleg dafür ist vor drei Tagen erschienen.
Am 28. August 2026 haben Hugging Face und Voice Arena die erste Sprache des Globalen Südens ins Open ASR Leaderboard aufgenommen: Hindi, gesprochen von mehr als einer halben Milliarde Menschen, kam in einen mehrsprachigen Tab, der bis dahin nur europäische Sprachen enthielt. Beigesteuert wurden vier Evaluationssplits — Monsoon en-IN und hi-IN, jeweils öffentlich und privat — mit 4.888 sprecherdisjunkten Personen, 12 erfassten Attributen pro Person, aufgenommen in 428 Distrikten auf Hunderten verschiedener Handy-Modelle statt im Studio.
Dann ließen sie die Modelle des Leaderboards darauf laufen. Das Ergebnis ist das Nützlichste, was diesen Monat über Spracherkennung veröffentlicht wurde.
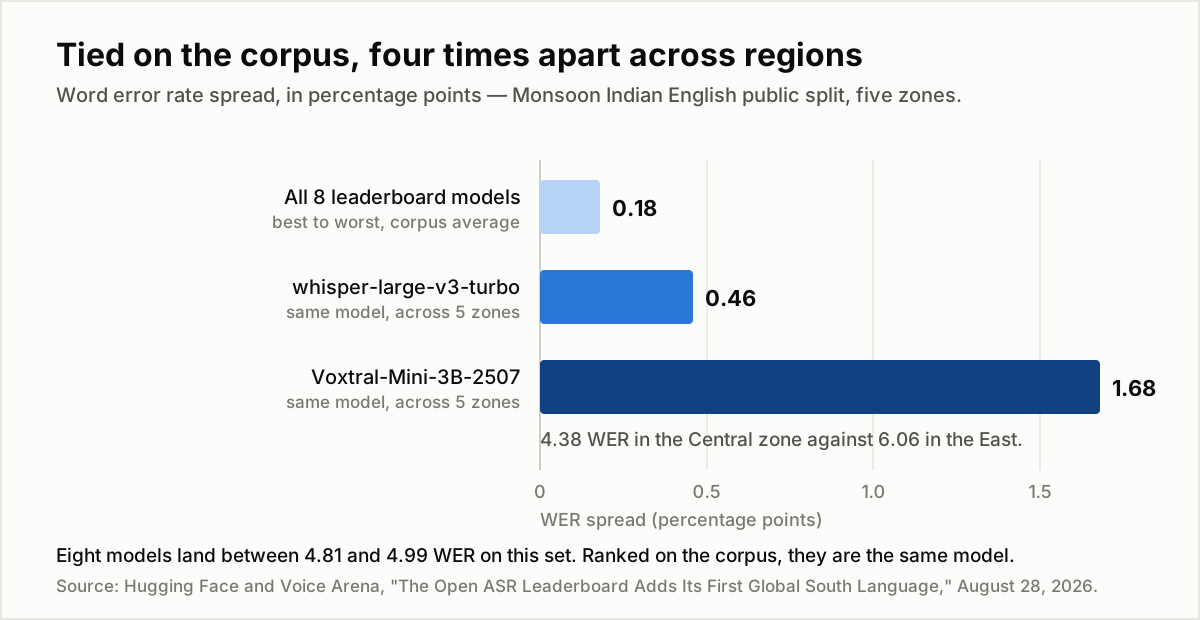
Eine Achse, eine Einheit: wie viele WER-Punkte die verglichenen Größen trennen. Quelle: Hugging Face und Voice Arena, 28. August 2026.
Acht Modelle des Leaderboards landen auf dem öffentlichen Split für indisches Englisch zwischen 4,81 und 4,99 WER. Das sind 0,18 Punkte zwischen bestem und schlechtestem Modell — innerhalb dessen, was fünf Stunden Audio überhaupt auflösen können. Nach Korpus gerankt, wie es die Veröffentlichung formuliert, sind sie dasselbe Modell.
Gruppiert man die Sprechenden nach Region, sind sie es nicht mehr. Rollt man den Heimatdistrikt jeder Person auf ihren Zonal Council hoch, variiert openai/whisper-large-v3-turbo über die fünf Zonen um 0,46 Punkte. mistralai/Voxtral-Mini-3B-2507, im Korpusmittel nur 0,14 Punkte dahinter, variiert um 1,68 — 4,38 WER in der zentralen Zone gegenüber 6,06 im Osten. Zwei auf dem Leaderboard ununterscheidbare Systeme unterscheiden sich um fast das Vierfache darin, wie stark ihre Genauigkeit davon abhängt, wo die sprechende Person aufgewachsen ist.
Und es ist nicht so, dass eine Region einfach schwerer wäre. ibm-granite/granite-speech-3.3-2b ist im Norden am schlechtesten, microsoft/VibeVoice-ASR-HF im Süden, Voxtral im Osten. Wäre eine Zone von sich aus schwierig, würden alle Modelle die Zonen gleich ordnen. Sie tun es nicht, und das deutet auf die Modelle statt auf das Audio.
Die operative Lesart für alle, die mehrsprachige Meetings führen: Ihre Transkriptionsqualität ist keine nachschlagbare Zahl. Sie ist eine Funktion davon, wer im Raum sitzt. Die Kollegin, deren Akzent Ihr Anbieter am wenigsten erfasst hat, ist die Kollegin, deren Sätze falsch herauskommen — und weder Leaderboard noch Anbieterseite warnen Sie davor. Die einzige Verteidigung ist ein Transkript, das ein Mensch lesen und korrigieren kann, und das setzt voraus, dass es ein Transkript gibt.
Hindi kennt zehn gültige Schreibweisen derselben Wendung. Eine Übersetzung wählt eine davon.
Der zweite Befund derselben Veröffentlichung ist subtiler und trifft das Argument dieses Textes genauer.
Orthografische Varianz im Englischen ist begrenzt: britisch gegen amerikanisch, Zeichensetzung, Ziffern gegen Wörter. Ein Normalisierer bildet das meiste auf eine Form ab. Hindi ist nicht so begrenzt. Alltagssprache ist stark codegemischt, Wörter englischen Ursprungs haben keine feste Devanagari-Schreibung, und Komposita werden je nach Vorliebe zusammen- oder getrenntgeschrieben. Eine einzelne Wendung kann zehn oder mehr gültige Schriftformen haben, und es gibt keine kanonische Seite, auf die man sie abbilden könnte.
Deshalb liefern die Hindi-Splits ein Lattice mit: für jeden Abschnitt des Transkripts die Menge der als korrekt akzeptierten Schreibweisen. Bewertet wird nicht mit gewöhnlichem WER, sondern mit OIWER, der orthografisch informierten Wortfehlerrate von AI4Bharat. Als dieselben Hypothesen gegen eine zu einer einzigen Referenz plattgedrückte Version neu bewertet wurden, stiegen die Fehlerraten für jedes System, sie stiegen ungleichmäßig, und Systempaare tauschten die Plätze. Unter einer Einzelreferenz wird ein Modell teilweise dafür belohnt, die Schreibentscheidungen der annotierenden Person zu reproduzieren; unter dem Lattice zählt nur die Erkennung.
Bleiben Sie kurz bei dieser Implikation. Selbst auf der Ebene „was wurde niedergeschrieben" gibt es oft keine einzige richtige Zeichenkette — es gibt eine Menge zulässiger, und eine davon auszuwählen wirft Information weg.
Übersetzung ist genau dieses Zusammenfallen, eine Ebene höher und weit verlustreicher. Jede übersetzte Zeile ist eine Entscheidung zwischen Lesarten, die das Original gar nicht treffen musste.
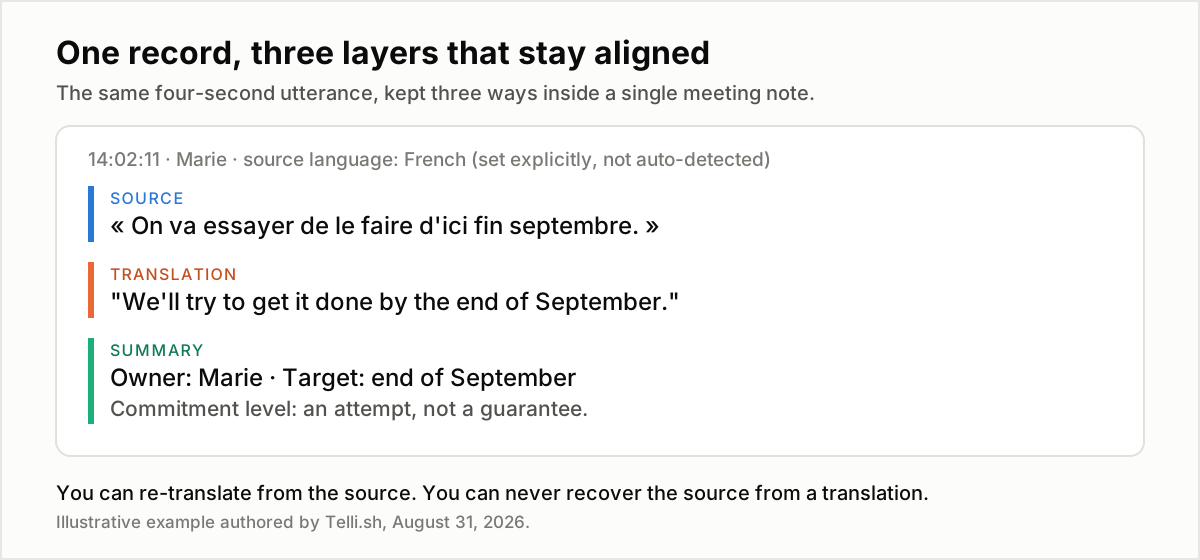
Die Zeile in der Ausgangssprache ist die einzige der drei, die sich nicht aus den anderen rekonstruieren lässt.
Aus „On va essayer de le faire d'ici fin septembre" wird „Wir versuchen, es bis Ende September fertigzubekommen" — und etwas Reales hat sich verändert: Das französische essayer trägt ein spezifisches Register der Abschwächung, das „versuchen" einebnet. War das eine Zusage oder eine Absicht? Die übersetzte Zeile kann es nicht sagen. Die Ausgangszeile kann es. Sechs Wochen später, wenn der Termin rutscht und zwei Teams den Satz unterschiedlich erinnern, ist die Ausgangszeile das gesamte Argument.
Das ist die Asymmetrie im Zentrum des Themas. Übersetzung ist eine Einbahnstraße. Aus dem Original können Sie beliebig oft neu übersetzen, nächstes Jahr mit einem besseren Modell. Aus der Übersetzung bekommen Sie das Original nie zurück.
Was nach dem Auflegen übrig bleibt: Echtzeitübersetzer vs. Meeting-Übersetzer mit Notizen
Hier der Vergleich, offen ausgesprochen, über die drei Wege, wie Teams mehrsprachige Meetings heute handhaben.
| Was Sie am nächsten Morgen haben | Echtzeit-Übersetzungsschicht | Dolmetscher:in | Meeting-Übersetzer mit Notizen |
|---|---|---|---|
| Verstehen im Raum | Ja | Ja, höchste Qualität | Ja |
| Audio des Meetings | Nur bei separater Aufzeichnung | Nur bei separater Aufzeichnung | Ja |
| Transkript in der Ausgangssprache | Nein | Nein, außer separat transkribiert | Ja |
| Am Original ausgerichtete Übersetzung | Nein | Nein | Ja |
| Wer welche Zeile gesagt hat | Nein | Nein | Ja, mit Sprecherzuordnung |
| Zusammenfassung und Aufgaben | Nein | Notizen der dolmetschenden Person, falls vorhanden | Ja, aus dem Transkript erzeugt |
| In drei Monaten durchsuchbar | Nein | Nein | Ja |
| Falsche Zeile korrigierbar | Nein | Nachträglich nicht | Ja, Datensatz bearbeiten |
| Typische Kosten pro Stunde | Software-Abo | 100–200 USD und mehr, bei langen Sitzungen zwei Dolmetschende | Software-Abo |
Das Verhalten der flüchtigen Spalte folgt der veröffentlichten FAQ von DeepL Voice for Online Meetings, abgerufen am 31. August 2026; die Dolmetschhonorare sind die weithin publizierte Marktspanne für professionelles Konferenzdolmetschen und variieren je nach Sprachpaar und Markt. Die dritte Spalte beschreibt die Kategorie „Meeting-Übersetzer mit Notizen" allgemein, keinen einzelnen Anbieter.
Die Form der Tabelle ist das Argument. Spalte eins und Spalte drei sind identisch in der einzigen Zeile, die Einkäufer üblicherweise prüfen — Verstehen im Moment — und unterscheiden sich in jeder Zeile, die nach dem Meeting zählt. Anbietervergleiche laufen fast immer über Zeile eins.
Ein Live-Übersetzer ist ein Fenster. Ein Meeting-Übersetzer mit Notizen ist ein Fenster und ein Hauptbuch. Teams kaufen Fenster, weil das der Teil ist, den sie erleben, und führen ihr Quartal dann mit einem Hauptbuch, das sie nie gekauft haben.
So führen Sie ein mehrsprachiges Meeting, dass das Protokoll brauchbar bleibt
Sechs Schritte, in der Reihenfolge, in der sie im Meeting vorkommen. Nichts davon ist exotisch; das Scheitern besteht fast immer darin, dass niemand entschieden hat.
- Legen Sie die Ausgangssprache explizit fest. Verlassen Sie sich nicht auf die automatische Erkennung. Die Automatik muss sich in den ersten Sekunden festlegen, auf dem kontextärmsten Audio der gesamten Sitzung, und ein Fehlgriff verschlechtert alle nachgelagerten Stufen auf einmal. Eine explizite Wahl erlaubt der Engine außerdem, Sie auf ein dediziertes einsprachiges Modell zu leiten, das in der Regel stärker ist als ein mehrsprachiges — Nova-3 etwa dokumentiert 58 Sprachen einzeln, aber Code-Switching in genau 10.
- Trennen Sie die Sprachen, die gesprochen werden, von denen, die gelesen werden. Das sind zwei verschiedene Listen, und sie als eine zu behandeln ist der häufigste Konfigurationsfehler der Kategorie. DeepLs eigenes Hilfecenter trennt genau so: „gesprochene Sprachen" sind das, was die Erkennung annimmt, „Übersetzungssprachen" das, worin Untertitel angezeigt werden können — und die zweite Liste ist weit länger.
- Entscheiden Sie vor dem Anruf, wo das Protokoll liegt, und vergewissern Sie sich, dass es nicht die Meeting-Plattform ist. Wenn Ihr Übersetzungsanbieter Meeting-Daten beim Auflegen löscht — was die Voreinstellung ist und eine vertretbare — dann erzeugt keine Einstellung innerhalb dieses Tools ein Protokoll. Die Aufzeichnung muss eine bewusste, separate Entscheidung sein.
- Lassen Sie die Sprecherzuordnung eingeschaltet. Eine übersetzte Zeile ohne Zuschreibung taugt für keine Entscheidung, die sie später stützen soll. „Wir schaffen das bis September" wird erst zur Tatsache, wenn man weiß, wer es gesagt hat.
- Korrigieren Sie Namen und Fachbegriffe in den ersten fünf Minuten, live. Eigennamen, Produkt-Codenamen und Abkürzungen sind die Stellen, an denen Transkription verlässlich scheitert, und zugleich die Stellen, an denen eine falsche Zeile der später erzeugten Zusammenfassung am meisten schadet. Während des Meetings kostet die Korrektur Sekunden; in einem Dokument, das niemand noch einmal liest, kostet sie nichts, weil es niemand tut.
- Erzeugen Sie die Zusammenfassung nach Möglichkeit aus dem Transkript in der Ausgangssprache, nicht aus der Übersetzung. Eine Übersetzung zusammenzufassen stapelt zwei verlustbehaftete Schritte übereinander. Das ist unsere Empfehlung und kein gemessenes Ergebnis, aber der Mechanismus ist geradlinig: Jede Stufe verwirft Information, gestapelt verwerfen sie mehr.
Und halten Sie die drei Artefakte in einem Datensatz. Ein Transkript in einem Tool, eine Übersetzung in einem Chatverlauf und eine Zusammenfassung in einem Dokument sind drei Dateien, die sich binnen eines Monats widersprechen — und genau diesen Widerspruch wollten Sie verhindern.
Fazit: Verstehen war das Bandbreitenproblem, das Protokoll ist das Gedächtnisproblem
Echtzeit-Meetingübersetzung löst ein Bandbreitenproblem: Bedeutung schnell genug über den Tisch zu bringen, dass ein Gespräch noch wie ein Gespräch wirkt. 2026, mit über 40 Sprachen bei ein bis zwei Sätzen Verzögerung und 96 % Präferenz im Blindtest, ist dieses Problem im Wesentlichen gelöst und wird jedes Quartal billiger.
Mehrsprachige Transkription löst ein Gedächtnisproblem, und nichts an der Bandbreitenlösung berührt es. Anderes Artefakt, andere Aufbewahrungsregel, anderer Fehlermodus. Ein Team, das nur das Erste kauft und annimmt, das Zweite bekommen zu haben, wird weiterhin exzellente Meetings haben, über die es keine Rechenschaft ablegen kann.
Die Frage für Ihr nächstes Anbietergespräch lautet deshalb nicht „in wie viele Sprachen übersetzt es". Darauf antwortet inzwischen jeder ernsthafte Anbieter mit einer Zahl über 40. Die Frage lautet: Was existiert noch, wenn der Anruf endet — und in wessen Sprache?
Wo Telli.sh hineinpasst: Alles oben handelt von der Schicht unter der Live-Übersetzung, und genau die bauen wir. Telli.sh liefert Live-Transkription mit Übersetzung in 44 Zielsprachen, bei einer Oberfläche, die selbst in 15 Sprachen verfügbar ist — jemand in Warschau liest ein koreanisches Standup auf Polnisch, während es läuft. Was am nächsten Morgen zählt: Alle drei Artefakte bleiben in einer Notiz — der Text in der Ausgangssprache dessen, was tatsächlich gesagt wurde, die daran ausgerichtete Übersetzung und die darauf erzeugte Zusammenfassung. Überprüfbar, korrigierbar und durchsuchbar, lange nachdem der Anruf beendet ist.
Jetzt eine live übersetzte Meeting-Notiz starten
Quellen
- Hugging Face und Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28. August 2026 — Monsoon-Splits en-IN und hi-IN, 4.888 Sprechende, WER-Varianz nach Zone, OIWER und das Hindi-Lattice.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Köln, 16. April 2026 — über 40 Sprachen, die vier Produktoberflächen und die von DeepL beauftragte Slator-Blindstudie.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17. April 2026 — Latenz der Seoul-Demo und die Wortstellungsgrenze.
- DeepL, DeepL Voice for Online Meetings, Produktseite und FAQ, abgerufen am 31. August 2026 — Formulierung zur Datenspeicherung, Slator-Werte und der Hinweis, dass Voice-to-Voice für Online-Meetings noch ausgerollt wird.
- DeepL Help Center, DeepL Voice languages, abgerufen am 31. August 2026 — die Trennung zwischen gesprochenen Sprachen und Übersetzungssprachen.
- AI4Bharat, Orthographically-Informed Word Error Rate — die für die Hindi-Splits verwendete Metrik.
- Deepgrams Nova-3-Sprachabdeckung, zusammengetragen in unserer eigenen Analyse zur Sprachexpansion in der Spracherkennung, 31. August 2026.