사흘 동안 프런티어 모델이 넷, 그런데 어느 게 필요했는지는 아무도 말해주지 않는다
2026년 9월 1일부터 3일 사이에 Anthropic, Meta, Google, OpenAI가 모두 프런티어 모델을 냈고, CNBC는 여기서 생긴 탈진에 이름을 붙였습니다. 모델 피로감입니다. 출시 횟수는 지루한 쪽입니다. 흥미로운 쪽은 출시 하나하나가 아래쪽 누군가는 반드시 돌려야 할 평가를 만들어낸다는 것, 그리고 모델을 내놓는 회사들에게는 그 평가를 건너뛰게 도와줄 이유가 전혀 없다는 것입니다. 모델 교체가 실제로 얼마를 요구하는지, 토큰당 싼 것이 왜 작업당 싼 것이 아닌지, 좁은 일 하나만을 위해 만들어진 완전 관리형 소프트웨어가 왜 남이 대신 결정해 줄 수 있는 유일한 형태인지를 짚습니다.
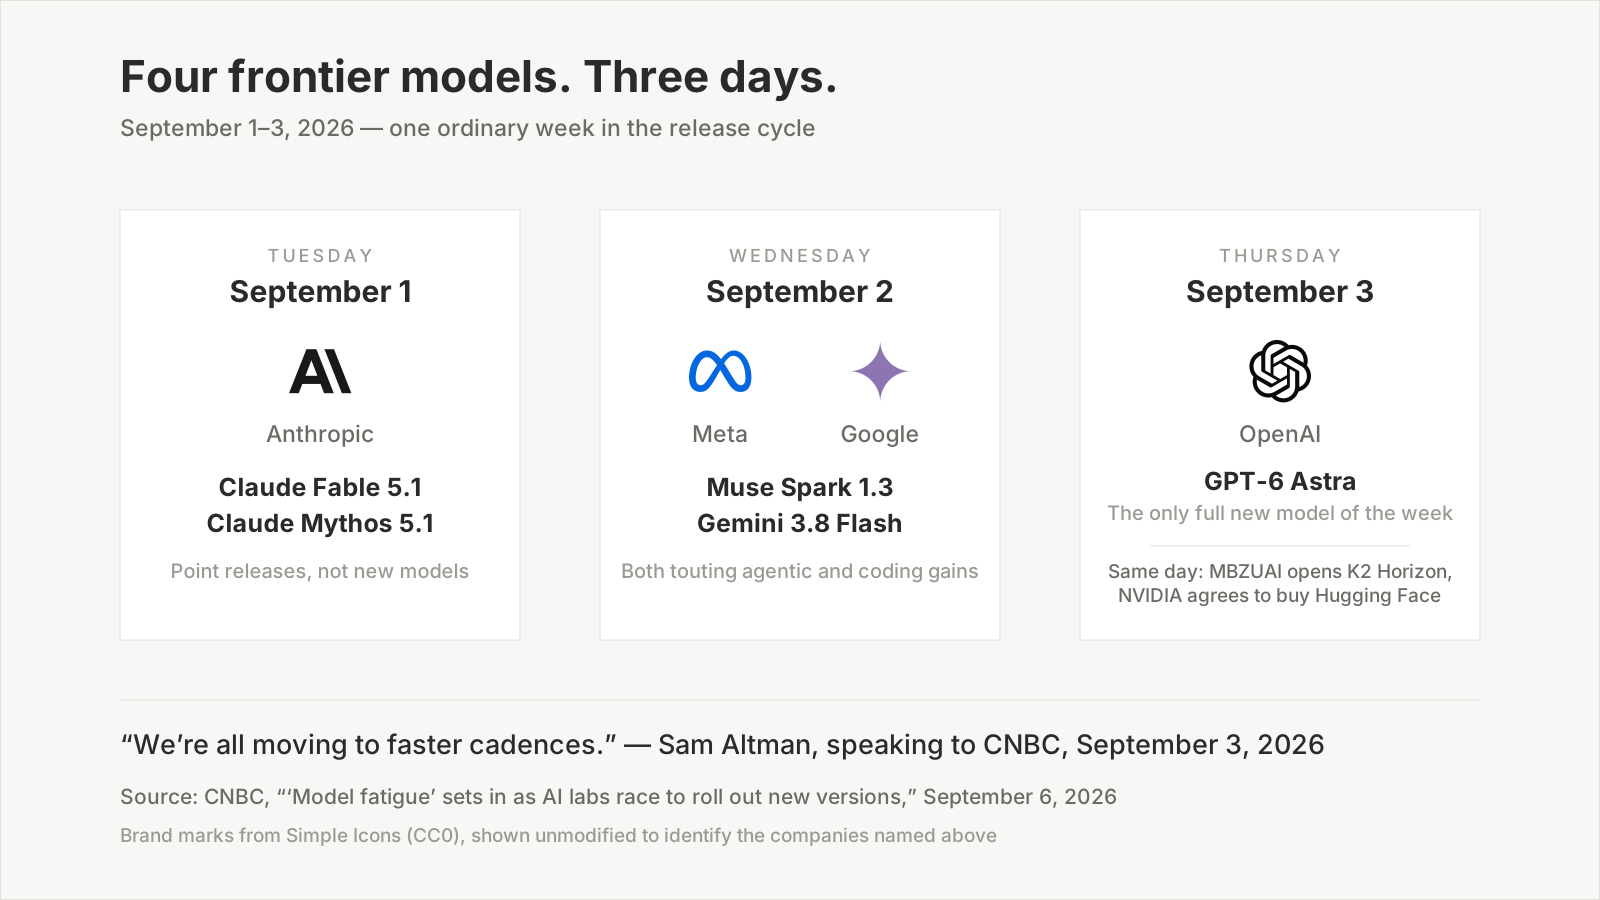
브랜드 마크는 Simple Icons(CC0), 언급된 회사를 식별하기 위해 변형 없이 사용했습니다. 출시 날짜와 Altman 발언은 2026년 9월 6일 CNBC 보도 기준.
2026년 9월 첫째 주 화요일부터 목요일까지, Anthropic은 Claude Fable 5.1과 Claude Mythos 5.1을, Meta는 Muse Spark 1.3을, Google은 Gemini 3.8 Flash를, OpenAI는 GPT-6 Astra를 내놨습니다. 같은 목요일에 아부다비의 모하메드 빈 자이드 인공지능대학교(MBZUAI)가 K2 Horizon 계열을 전 세계에 공개했고, NVIDIA는 Hugging Face 인수에 12,930,300,000달러를 쓰기로 합의했습니다.
발표 여섯 건. 사흘. CNBC는 9월 6일 일요일, 몇 주 전부터 현업에서 돌던 표현 하나를 제목에 걸고 이 이야기를 실었습니다. 모델 피로감.
뻔한 해석은 업계가 따라갈 수 없는 속도로 움직이고 있다는 것입니다. 맞는 말이고, 대체로 재미없는 말입니다. 주목할 만한 대목은 따로 있습니다. 출시 하나하나가 비용을 옮기는데, 그 이동 방향이 정확히 한쪽이라는 점입니다. 연구소가 내놓는 모델은 전부 아래쪽 누군가가 돌려야 할 평가가 되고, 위쪽 누구에게도 그 평가를 건너뛰게 도와줄 이유는 조금도 없습니다.
TL;DR
- 사흘 사이에 프런티어 출시가 네 건 있었고(2026년 9월 1~3일), CNBC는 9월 6일 그 탈진에 "모델 피로감"이라는 이름을 붙였습니다.
- 진짜 비용은 관심이 아니라 평가 노동입니다. 한 엔터프라이즈 CEO는 CNBC에 어떤 작업을 위해 10개 모델을 평가하고 싶어도 실제로는 5개쯤 테스트한다고 말했습니다.
- 토큰당 가격은 작업당 비용의 나쁜 대리 지표입니다. 더 강하고 더 비싼 모델이 단계를 덜 밟아 더 어려운 일을 더 싸게 끝내기도 합니다.
- 모델 벤더는 더 싼 모델로 충분한 순간을 알려줄 구조적 이유가 없습니다. 그 빈틈이 관리형·목적형 소프트웨어가 존재하는 이유 전부입니다.
모델 피로감은 9월 6일에 이름을 얻었다
"모델 피로감은 실재한다고 생각합니다." AI 인프라 스타트업 Runpod의 CEO Zhen Lu가 CNBC에 한 말입니다. "오해는 마세요. 지금 벌어지는 혁신 전부에 저는 대단히 들떠 있습니다. 다만 지금은 거품이 너무 많아서 소음을 내야만 하는 환경이라고 정말로 생각합니다."
Sam Altman은 같은 주 CNBC에 좀 더 부드러운 틀을 제시했습니다. "우리 모두 더 빠른 주기로 옮겨 가고 있다"면서, 가속의 일부를 다들 "여름휴가를 마치고 돌아온" 탓으로 돌렸습니다.
둘 다 사실일 수 있습니다. 주기는 실제로 빨라지고 있고, 그 가속에는 실제로 연출이 섞여 있습니다. AI 분야에서 25년을 보낸 노터데임대 멘도자 경영대학원 교수 Ahmed Abbasi는 상업적 논리를 대놓고 정리했습니다. 연구소들은 "다 같이 지갑 점유율 게임을 하는 중"이라는 것입니다. 공개 시장을 향해 가는 Anthropic과 OpenAI가 가장 세게 밀어붙이고 있고, 두 곳 모두 이미 사적 투자자들로부터 1조 달러에 가까운 가치를 인정받고 있습니다.
문제의 지갑은 어마어마합니다. Gartner는 2026년 5월, 전 세계 AI 지출이 올해 2조 5,900억 달러에 이르러 2025년보다 47% 늘어난다고 전망했습니다. 인프라가 가장 큰 몫을 가져가지만, 그중 1조 달러를 훌쩍 넘는 금액이 서비스, 소프트웨어, 보안, 모델, 도구로 갑니다. 다시 말해 누군가는 내려야 하는 결정으로 갑니다.
여기서부터가 핵심입니다. 그만큼 크고 그만큼 빠르게 자라는 시장은 시끄러운 쪽에 보상합니다. 고객에게 더 적은 걸로도 충분하다고 알려주는 쪽에는 보상하지 않습니다.
비용은 관심이 아니다. 끝내지 못하는 평가다
현업에 있는 사람에게 모델 피로감이 실제로 어떤 느낌이냐고 물으면 "출시 글을 너무 많이 읽는다"는 답이 나오지 않습니다. 산수가 나옵니다.
엔터프라이즈 AI 스타트업 Clockwork Systems의 CEO Suresh Vasudevan은 이 기사 전체에서 가장 쓸모 있는 숫자를 CNBC에 건넸습니다. 특정 작업을 위해 AI 모델 10개를 평가하고 싶어도, 실제로는 그냥 다섯 개만 고르게 될 수 있다는 것입니다. "지금 쏟아지는 것들을 하나하나 다 평가하러 가기란 정말 어렵습니다."
이 비율 앞에서 잠깐 멈춰 보시기 바랍니다. 이 주제 전체를 떠받치는 사실이기 때문입니다. 사업 자체가 엔터프라이즈 AI이고, 이 일을 직업으로 하는 사람들이 있고, 정확히 이 목적으로 배정된 컴퓨트 예산까지 있는 회사가, 평가할 가치가 있다고 스스로 판단한 후보의 절반만 평가합니다.
나머지 절반을 시험대에 오르지 못한 다섯이라고 부르겠습니다. 탈락한 게 아닙니다. 누구도 부족하다고 판정하지 않았습니다. 그냥 한 번도 돌려보지 않았을 뿐이고, 그래서 그중 하나가 당신의 워크로드에서 더 빨랐을지 더 쌌을지 더 정확했을지는 영영 열린 질문으로 남습니다. 출시가 있는 주마다 그 더미가 커집니다.
그리고 그 더미를 헤쳐 나가는 일은 비쌉니다. 모델 교체는 버전 올리기가 아니라 재검증이기 때문입니다. 새 모델이 프로덕션에 닿기 전에 실제로 벌어져야 하는 일은 이렇습니다.
| 다시 확인해야 하는 것 | 새 모델이 왜 그걸 깨뜨리나 |
|---|---|
| 프롬프트와 시스템 지시문 | 옛 모델의 버릇에 맞춰 다듬은 것. 한 모델을 안정적으로 몰던 표현이 다른 모델은 엉뚱한 데로 몹니다 |
| 출력 형식의 안정성 | 하위 파서는 JSON, 헤딩, 구분자 같은 모양에 의존하는데, 서식 습관은 모델마다 달라집니다 |
| 실제 데이터에서의 정확도 | 벤치마크 차이는 공개 데이터셋에서 잰 것이지 당신의 회의, 당신의 티켓, 당신의 코드베이스에서 잰 게 아닙니다 |
| 도구와 API 동작 | 에이전트형 모델은 언제 호출하는지, 얼마나 자주 재시도하는지, 호출이 실패하면 무엇을 하는지가 서로 다릅니다 |
| 부하 상태의 지연 시간과 처리량 | 단건 요청에서 빠른 모델이 당신의 레이트 리밋 뒤에서는 더 느릴 수 있습니다 |
| 당신의 볼륨에서의 총비용 | 토큰당 가격 × 소비 토큰 × 시도 횟수 — 아래에서 다룹니다 |
| 안전성과 거부 동작 | 경계선은 버전이 바뀔 때마다 양쪽 방향으로 움직입니다 |
| 회귀 케이스 | 이미 고쳐 놓은 바로 그 실패들, 남의 벤치마크는 알 리 없는 것들 |
여덟 개 항목, 각각에 실제 예시와 비교 실행과 누군가의 판단이 필요합니다. 설정 변경이 아니라 프로젝트입니다. 여기에 어느 달이든 그달의 프런티어 출시 횟수를 곱하면, 10 대 5라는 비율의 이유가 분명해집니다.
리더보드를 믿는 대신 자기 워크로드에서 직접 재는 방법에 대해서는 따로 한 편을 썼는데, 정직한 요약은 제대로 하려면 몇 시간이 아니라 며칠이 든다는 것입니다.
토큰당 싸다고 작업당 싼 게 아니다
이 이야기 전체에서 가장 직관에 어긋나는 발견은 연구소가 아니라 그 선택을 자동화하려던 엔지니어에게서 나왔습니다.
오픈소스 AI 게이트웨이 LiteLLM의 프로덕트 엔지니어 Moe Khalil은 9월 4일 "Model Fatigue is Real"이라는 글을 올렸습니다. 그는 LiteLLM의 자동 라우터, 그러니까 대신 모델을 골라 주는 것이 존재 이유인 소프트웨어를 만들고 있고, 이 소속을 글 앞머리에 밝혔습니다. 이 주제로 글을 쓰는 대부분보다 나은 태도입니다.
팀의 출발 가정은 직관적인 쪽이었습니다. 같은 작업을 풀 수 있는 모델 두 개가 있을 때, 모델 카드상 토큰당 가격이 절반인 쪽이 대략 절반 값에 그 일을 풀어야 한다는 것이었습니다.
테스트 결과는 그렇지 않았습니다. 더 강하고 더 비싼 모델이 더 어려운 작업을 싼 모델 비용의 일부만으로 풀고 있었습니다. Khalil의 설명은 이렇습니다. "더 똑똑하다 보니 더 똑똑한 접근을 택했고, 완성품까지 훨씬 빨리 갔습니다."
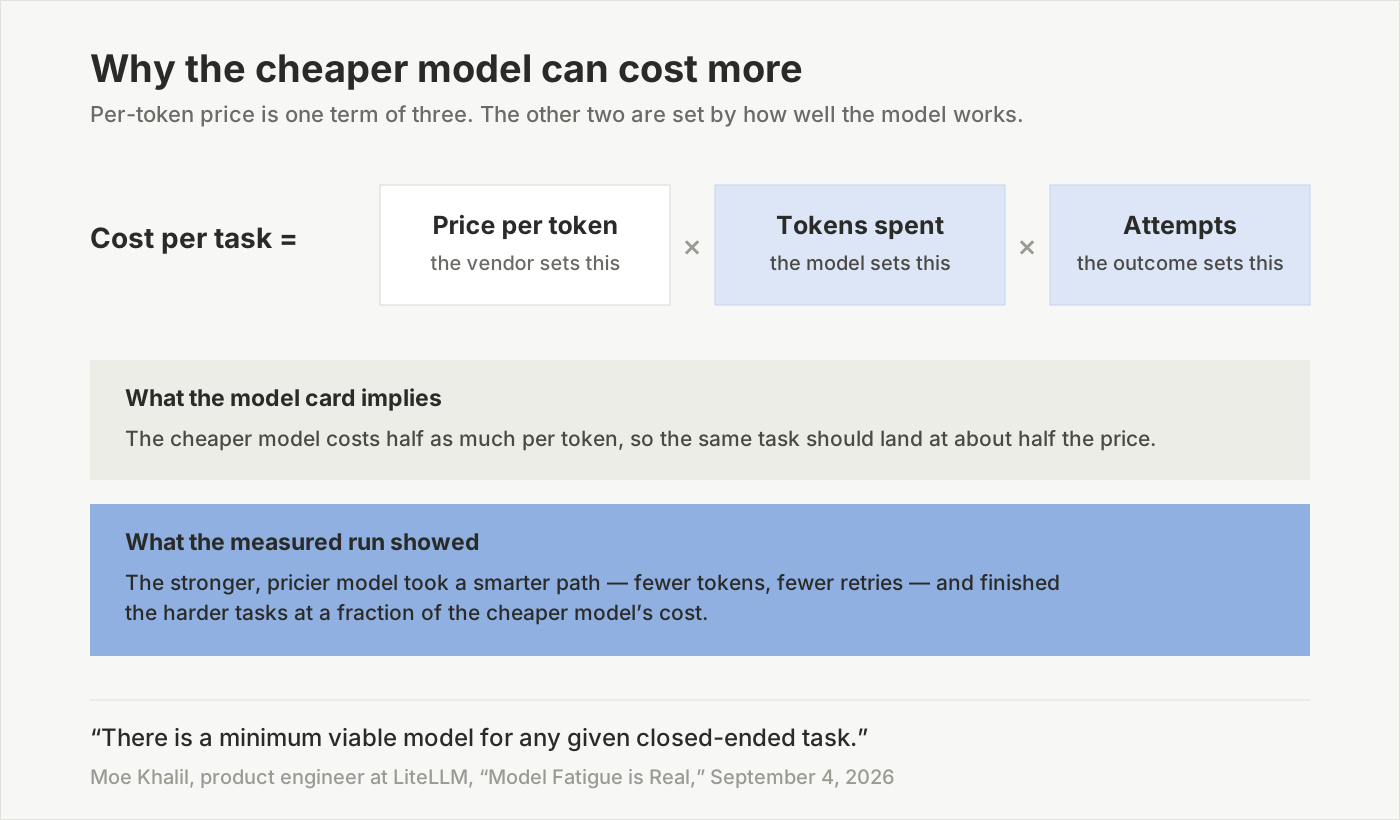
세 항 중 가격표에 적히는 것은 토큰당 가격뿐입니다. 나머지 둘은 모델 실력의 속성이고, 일을 실제로 돌려 봐야만 드러납니다.
이건 가격표의 의미를 통째로 바꿉니다. 벤더가 광고하는 숫자는 세 항의 곱 중 하나일 뿐입니다. 토큰당 가격, 소비한 토큰, 그리고 작업이 실제로 성공할 때까지의 시도 횟수. 첫 번째는 벤더가 정합니다. 두 번째와 세 번째는 모델 자신이 정하고, 둘 다 당신의 일을 직접 통과시키기 전에는 알 수 없습니다.
그러니까 하라고 배운 그 비교, 가격 열을 훑고 싼 걸 고르는 그 비교는 단지 불완전한 게 아닙니다. 실제 작업에서는 반대 방향을 가리킬 수 있습니다.
위쪽에는 알려줄 이유가 없다
이어서 Khalil은 다들 삼키는 말을 합니다. 올해 이 주제에 대해 쓰인 가장 날카로운 문장입니다.
"모델 회사들에게 이 게으름은 버그가 아니라 기능입니다. 그들은 제가 이메일을 요약하는 데도 [최상위 모델]을 쓰기를 선호하고, 더 싼 모델로도 똑같이 될 때 그걸 알려줄 유인이 전혀 없습니다. 그들의 일은 프런티어를 계속 밀어 올리는 것입니다. 언제 프런티어를 쓰지 않을지를 알아내는 일은 제 몫으로 남습니다."
Gartner 숫자를 머리에 두고 한 번 더 읽어 보시기 바랍니다. 2조 5,900억 달러 규모에 연 47% 성장하는 시장, 그 안에서 공급자는 모든 고객이 위쪽을 기본값으로 삼을 때 이득을 보고 고객이 과지출을 해도 아무 대가를 치르지 않습니다.
음모가 아니고, 누가 나쁘게 굴어야 성립하는 것도 아닙니다. 그냥 유인의 기울기가 이렇게 생겼을 뿐입니다. 프런티어 연구소의 일은 프런티어를 옮기는 것입니다. 작년 중급 모델이 당신 워크로드의 80%를 처리한다고 알려 주는 건 다른 누군가의 일이고, 최근까지는 아무의 일도 아니었습니다.
Abbasi의 두 번째 관찰도 여기 놓입니다. 그는 모든 주요 개발사가 같은 주에 발표한 것이 "우연이 아니"라고 했고, AI 금융 스타트업 Farsight의 기술 총괄 Noah Faro도 여기에 동의하면서, 경쟁사들이 서로의 계획을 어느 정도는 클라우드 컴퓨트 가용량에서 읽어 낸다고 덧붙였습니다. 다들 같은 소수 벤더의 용량을 두고 경쟁하기 때문입니다. Faro는 김을 빼는 지적도 했습니다. GPT-6 Astra와 달리 그 주의 Anthropic, Meta, Google 발표는 포인트 릴리스, 즉 새 모델이 아니라 기존 모델의 업그레이드였다는 것입니다. 그의 판단으로 진짜 판을 움직인 마지막 두 건은 6월 Anthropic의 Fable 5와 7월 Moonshot AI의 Kimi K3였습니다.
정리하면 발표 여섯 건, 진짜 새 프런티어 모델 한 건, 그리고 아래쪽 모두에게 떨어진 평가 사이클 한 바퀴 분량의 일입니다.
업계가 이걸 흡수하는 두 가지 방식, 둘은 같지 않다
연구소가 결정을 내려 주지 않는다면 누군가는 내려야 합니다. 답은 두 가지가 나왔고, 둘은 구조적으로 다릅니다.
수평적 답은 라우팅입니다. LiteLLM 같은 게이트웨이는 모든 모델을 API 키 하나 뒤에 두고 요청마다 골라 보려 합니다. Khalil은 기술적 문제를 정확히 서술합니다. 닫힌 형태의 작업에는 최소 실행 가능 모델, 즉 그래도 성공하는 가장 싼 모델이 존재하고, 어려움은 작업을 돌리기 전에 그게 어느 것인지 예측하는 데 있습니다. 팀의 현재 최선은 공개 벤치마크 데이터에 프롬프트 안의 휴리스틱을 더해 추론하는 방식이고, LLM 분류와 하이브리드도 시도해 봤습니다. 그의 자평은 이렇습니다. "전부 아직 불완전하지만, 아무것도 없는 것보다는 한 단계 낫습니다."
라우팅은 진짜 엔지니어링이고 도움이 됩니다. 다만 그것이 무엇을 옮기고 무엇을 옮기지 않는지 보셔야 합니다. 라우팅은 배관을 흡수합니다. 키 하나, 인터페이스 하나, 새 모델에 대한 자동 접근. 그러나 책임은 흡수하지 못합니다. 라우터가 잘못 고르면 그 나쁜 출력은 여전히 당신 것이고, 당신 제품 안에 있고, 당신 사용자 앞에 있습니다. 답이 좋았는지에 대한 평가는 여전히 당신 몫입니다.
수직적 답은 하나의 일을 위해 만들어진 완전 관리형 소프트웨어입니다. 여기서 벤더는 당신을 대신해 모델 사이를 라우팅하지 않습니다. 작업 자체를 통째로 가져가서 완성된 결과를 내놓습니다. 당신은 모델 이름을 보지 않습니다. 전사본, 요약, 번역, 제출된 경비 보고서를 봅니다.
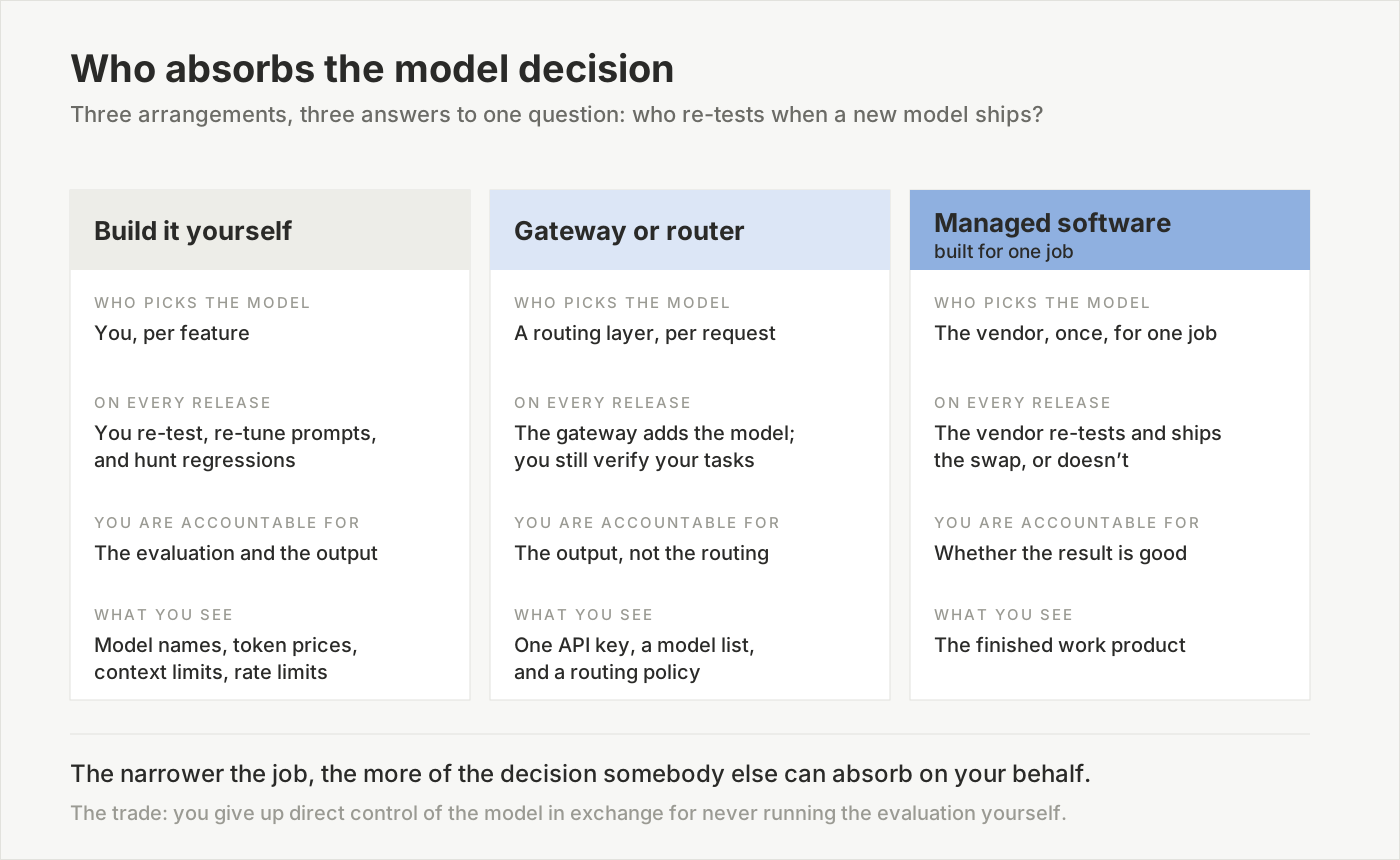
오른쪽으로 갈수록 당신에게 남는 결정은 줄어들고, 벤더가 평가를 정직하게 해냈는지에 더 의존하게 됩니다.
로컬 AI 커뮤니티는 정반대 방향에서 비슷한 결론에 닿았습니다. 올해 나온 한 분석은 소형 모델 씬을 러닝머신에 비유했습니다. 내려받고, 설정하고, 프롬프트 몇 개 돌려 보고, 대충 판단하고, 다음 출시로 넘어가는 것입니다. 권고는 그만두라는 것이었습니다. 검증된 데일리 드라이버 구성 하나로 표준화하고, 새 모델은 실제로 대표성 있는 작업에서 충분히 오래 시험해 당신의 워크로드에 정말 더 낫다는 게 확인된 뒤에만 채택하라는 것이었습니다. GPU 두 장을 가진 취미가와 컴퓨트 예산을 가진 CEO가 같은 결론에 닿았습니다. 한 번, 제대로 고르고, 매주 목요일마다 다시 따지지 마라.
좁은 일이라야 결정을 대신 떠안을 수 있다
여기서부터가 저희 견해이고, 이 카테고리가 아예 존재하는 이유입니다.
모델 결정은 그 작업을 아는 사람만 내릴 수 있습니다. 당연한 말처럼 들립니다. 아닙니다. 이 문장은 거의 모두를 배제하기 때문입니다.
범용 챗 인터페이스는 당신을 대신해 결정할 수 없습니다. 어느 아침이든 소네트를 써 달라거나, 경쟁 조건을 디버깅해 달라거나, 임대차 계약서를 요약해 달라는 요청을 받을 수 있기 때문입니다. "사용자가 다음에 입력하는 무엇이든"에는 최소 실행 가능 모델이 없습니다. 유일하게 안전한 기본값은 가용한 가장 강한 모델이고, 그것은 정확히 벤더의 이익에 부합하는 기본값이며, Khalil이 아무도 말려 줄 유인이 없다고 말한 바로 그 기본값입니다.
게이트웨이는 프롬프트를 보기 때문에 더 나은 추측을 할 수 있습니다. 다만 당신의 도메인에서 좋은 답이 어떤 모습인지에 대한 지식 없이 프롬프트를 보고, 틀려도 치를 대가가 없습니다.
목적형 관리형 소프트웨어는 완전히 다른 자리에 있습니다. 일이 고정돼 있을 때, 그러니까 한국어와 영어를 오가는 화자 네 명의 60분 회의를 전사하고 액션 아이템을 뽑는다처럼 고정돼 있을 때, 그 작업은 정확히 Khalil이 말한 의미에서 닫혀 있습니다. 최소 실행 가능 모델이 존재합니다. 그리고 결정적으로, 같은 일을 가진 모든 고객에게 그 최소 실행 가능 모델은 동일합니다. 평가를 한 번만 돌리면 되고 그 비용이 전원에게 분산된다는 뜻입니다.
이 카테고리의 경제적 논거는 그게 전부이고, 규칙으로 적어 둘 만합니다. 일이 좁을수록 모델 결정을 남이 대신 떠안을 수 있는 몫이 커진다. 워크로드 하나를 담당하는 벤더는 후보 10개를 전부 테스트할 여유가 있습니다. 수천 명의 고객을 위해, 좋은 결과에 대한 고정된 정의를 놓고, 딱 한 번 테스트하기 때문입니다. 당신이 혼자, 스스로 만들어 내야 하는 정의를 놓고 다섯 개를 테스트하는 것은 더 나쁜 답을 얻는 더 비싼 방법입니다.
거래 조건은 실재하고 정직하게 이름 붙일 가치가 있습니다. 당신은 어떤 모델이 당신의 일을 돌리는지에 대한 직접 통제를 내려놓습니다. 대신 평가를 그만 돌리고, 출시 캘린더 추적을 그만두고, 판단 대상은 출력물이 됩니다. 애초에 당신이 신경 쓴 유일한 것 말입니다.
지금 사려는 게 어느 쪽인지 가려내는 법
다음 AI 구매 전에, 순서대로 네 가지 질문입니다.
- 그 일은 닫혀 있는가? 올바른 출력이 어떤 모습인지 한 문장으로 말할 수 있습니까? 그렇다면 관리형 버티컬 도구가 결정을 떠안을 수 있습니다. 답이 "무엇을 시키느냐에 따라 다르다"면 당신이 사는 것은 범용 모델이고 평가는 당신에게 남습니다.
- 새 모델이 나오면 누가 다시 테스트하는가? 벤더에게 직접 물어보십시오. 관리형 벤더라면 자기 평가 세트와 교체 절차를 설명할 수 있어야 합니다. 답이 "최신 모델에 접근하실 수 있습니다"라면 당신이 산 것은 배관이지 판단이 아닙니다.
- 무엇이 보이는가, 모델인가 결과인가? 제품이 모델 이름, 컨텍스트 윈도, 토큰 가격을 노출한다면 결정을 당신에게 되돌려주고 있는 것입니다. 그것도 정당한 제품이지만, 값은 거기에 맞게 매기십시오.
- 당신의 볼륨에서 총비용은 얼마인가? 토큰당 가격 × 당신의 일에서 실제로 소비된 토큰 × 제대로 나올 때까지의 시도 횟수. 당신의 작업을 직접 돌려 보십시오. 가격표는 이 질문에 답하지 못합니다.
결론: 프런티어는 결정이 아니라 기본값이다
모델 피로감은 보통 관심의 문제로 설명됩니다. 뉴스가 너무 많고, 너무 빠르다는 식으로요. 아닙니다. 기술 산업에서 가장 빠르게 자라는 시장이 조용히 고객 쪽으로 옮겨 놓은 비용이고, 그 비용은 값이 매겨지지도 측정되지도 않은 채 그 자리에 있습니다.
연구소들은 계속 내놓을 것입니다. 내놓는 게 그들의 일이고 시장이 거기에 돈을 내니까요. 평가 부담은 계속 커질 것입니다. 출시가 하나 늘 때마다 기계적으로 늘어나니까요. 그리고 대부분의 팀은 바쁜 팀이 할 수 있는 유일한 방식으로 이걸 해결할 것입니다. 가장 새롭고 가장 크고 가장 비싼 모델에 손을 뻗는 것, 회의에서 아무도 변호할 필요가 없는 유일한 선택지 말입니다.
일을 통째로 가져가고 모델 이름을 끝내 보여주지 않는 모든 소프트웨어는, 그런 식으로 사업을 굴리는 게 나쁜 방법이라는 데 건 베팅입니다. 출시가 있는 주마다 그 베팅은 더 좋아 보입니다.
Telli.sh는 여기 있습니다: 저희가 만드는 게 바로 이 카테고리입니다. Telli.sh는 회의를 녹음하고, 화자를 분리하고, 15개 언어를 실시간으로 번역하고, 요약과 액션 아이템을 만듭니다. 그리고 어떤 모델을 쓸지 절대 묻지 않습니다. 그건 저희 일이지 당신 일이 아니기 때문입니다. 저희 브라우저 확장 프로그램은 완전 온디바이스 옵션을 포함해 아홉 개 번역 엔진을 제공합니다. 그 통제권을 정말로 원하는 분들이 있으니까요. 회의 제품은 의도적으로 그러지 않습니다. "이 회의를 잘 전사한다"는 닫힌 작업이고, 저희는 뒤에 있는 모델이 아니라 전사본으로 평가받는 편을 택하기 때문입니다.
출처
- CNBC, "'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace," 2026년 9월 6일 — 2026년 9월 1~3일 출시 연대기, Zhen Lu의 "모델 피로감은 실재한다" 발언, Sam Altman의 "더 빠른 주기" 언급, Ahmed Abbasi의 "지갑 점유율 게임"과 1조 달러에 가까운 비상장 기업가치, Noah Faro의 포인트 릴리스 지적 및 Fable 5와 Kimi K3가 마지막 두 건이라는 평가, 그리고 Suresh Vasudevan의 10개 중 5개 평가 수치. 취재 협력 Kate Rooney, MacKenzie Sigalos. 2026년 9월 8일 확인
- Moe Khalil, "Model Fatigue is Real," 2026년 9월 4일 — "더 싼 모델로 될 때 알려줄 유인이 없다"는 논지, 닫힌 작업에 대한 최소 실행 가능 모델 틀, 그리고 더 강하고 비싼 모델이 더 어려운 작업을 싼 모델 비용의 일부로 풀었다는 측정 결과. Khalil은 자신이 자동 라우터를 만드는 LiteLLM의 프로덕트 엔지니어임을 글에서 밝혔습니다. 2026년 9월 8일 확인
- Gartner, "Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026," 2026년 5월 19일 — 2026년 전 세계 AI 지출 2조 5,900억 달러, 전년 대비 47% 증가, AI 인프라가 최대 부문
- MindStudio, "Local AI Model Fatigue: Why One Setup Beats Chasing Every Release" — 로컬 소형 모델 출시 주기를 러닝머신으로 묘사한 대목과 검증된 데일리 드라이버 하나로 표준화하라는 논거
- AI타임스, "[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'," 2026년 9월 7일 — CNBC 보도와 주변 개발자 반응을 전한 한국어 기사
- NVIDIA의 Hugging Face 인수에 대한 저희 읽기 — 같은 주의 다른 발표이자 여기 언급된 모든 모델 아래에 깔린 유통 계층
- 자기 워크로드에서 전사 정확도를 재는 법 — 평가를 제대로 한 번 돌릴 때 실제로 드는 비용