Cuatro modelos de frontera en tres días, y nadie te va a decir cuál necesitabas
Entre el 1 y el 3 de septiembre de 2026, Anthropic, Meta, Google y OpenAI lanzaron modelos de frontera, y la CNBC le puso nombre al agotamiento resultante: fatiga de modelos. El número de lanzamientos es la parte aburrida. La parte interesante es que cada lanzamiento crea una evaluación que alguien, aguas abajo, tiene que ejecutar, y las empresas que los publican no tienen ningún motivo para ayudarte a saltártela. Un repaso a lo que cuesta de verdad cambiar de modelo, por qué más barato por token no significa más barato por tarea, y por qué el software totalmente gestionado y creado para un único trabajo concreto es la única disposición en la que otro puede decidir por ti.
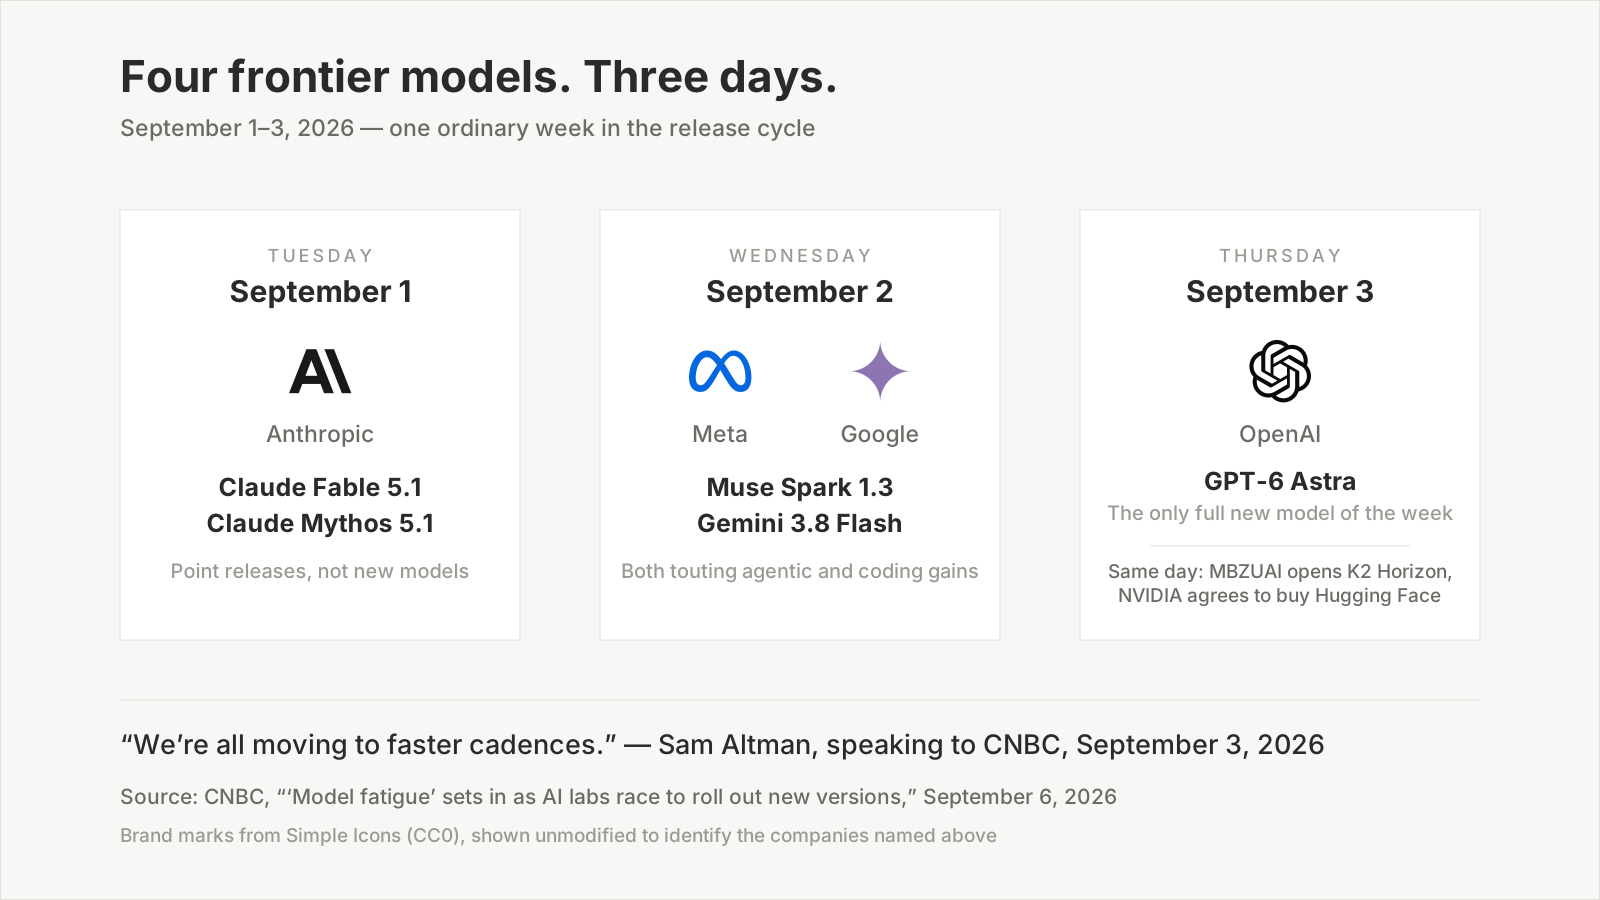
Marcas de Simple Icons (CC0), mostradas sin modificar para identificar a las empresas citadas. Fechas de lanzamiento y cita de Altman según la CNBC, 6 de septiembre de 2026.
Entre el martes y el jueves de la primera semana de septiembre de 2026, Anthropic lanzó Claude Fable 5.1 y Claude Mythos 5.1, Meta lanzó Muse Spark 1.3, Google lanzó Gemini 3.8 Flash y OpenAI lanzó GPT-6 Astra. Ese mismo jueves, la Mohamed bin Zayed University of Artificial Intelligence de Abu Dabi abrió al mundo su familia K2 Horizon, y NVIDIA acordó comprar Hugging Face por 12.930.300.000 dólares.
Seis anuncios. Tres días. La CNBC publicó el reportaje el domingo 6 de septiembre bajo una expresión que llevaba semanas circulando entre profesionales: fatiga de modelos.
La lectura obvia es que la industria avanza más rápido de lo que nadie puede seguir. Esa lectura es cierta y bastante poco interesante. Aquí está la parte que merece tu atención: cada lanzamiento transfiere un coste, y la transferencia va en una sola dirección. Cada modelo que publica un laboratorio se convierte en una evaluación que alguien, aguas abajo, tiene que ejecutar, y nadie aguas arriba tiene el menor motivo para ayudarte a saltártela.
TL;DR
- Cuatro lanzamientos de frontera en tres días (1–3 de septiembre de 2026); la CNBC bautizó el agotamiento resultante como «fatiga de modelos» el 6 de septiembre.
- El coste real no es la atención, es el trabajo de evaluación. Un consejero delegado del sector contó a la CNBC que, cuando su equipo quiere evaluar 10 modelos para una tarea, prueba unos 5.
- El precio por token es un mal indicador del coste por tarea: un modelo más potente y más caro puede terminar trabajos más difíciles por menos dinero porque da menos pasos.
- A los proveedores de modelos no les interesa estructuralmente decirte cuándo bastaría con un modelo más barato. Ese hueco es la razón entera por la que existe el software gestionado y creado a medida.
La fatiga de modelos recibió nombre el 6 de septiembre
«Tengo la sensación de que la fatiga de modelos es algo real», dijo a la CNBC Zhen Lu, consejero delegado de Runpod, una startup de infraestructura de IA. «No me malinterpretes: estoy enormemente entusiasmado con toda la innovación que está ocurriendo, pero de verdad creo que estamos en un entorno con tanta espuma que hay que hacer ruido.»
Sam Altman ofreció a la CNBC esa misma semana un encuadre más amable: «todos nos estamos moviendo hacia cadencias más rápidas», dijo, y atribuyó parte de la aceleración a que todo el mundo estaba «de vuelta de las vacaciones de verano».
Ambas cosas pueden ser ciertas. La cadencia se está acelerando de verdad, y la aceleración es de verdad, en parte, teatro. Ahmed Abbasi, profesor de la Mendoza School of Business de Notre Dame con 25 años en IA, expuso la lógica comercial sin rodeos: los laboratorios están «todos jugando al juego de la cuota de bolsillo». Anthropic y OpenAI son los que más empujan mientras se encaminan a los mercados públicos, y los inversores privados ya valoran a cada uno en cerca de 1 billón de dólares.
El bolsillo en cuestión es enorme. Gartner previó en mayo de 2026 que el gasto mundial en IA alcanzaría 2,59 billones de dólares este año, un 47 % más que en 2025. La infraestructura se lleva la mayor parte, pero bastante más de 1 billón de dólares recae en servicios, software, seguridad, modelos y herramientas; es decir, en decisiones que alguien tiene que tomar.
Aquí está el punto: un mercado tan grande, que crece tan rápido, premia hacer ruido. No premia decirle al cliente que le bastaría con menos.
El coste no es la atención. Es la evaluación que no consigues terminar
Pregunta a un profesional cómo se siente de verdad la fatiga de modelos y no obtienes «leo demasiados anuncios de lanzamiento». Obtienes aritmética.
Suresh Vasudevan, consejero delegado de Clockwork Systems, una startup de IA empresarial, dio a la CNBC el número más útil de todo el reportaje. Si su empresa quiere evaluar 10 modelos de IA para una tarea concreta, dijo, puede que simplemente elija cinco. «Es realmente difícil ir y evaluar cada uno de los que están saliendo ahora mismo.»
Detente un momento en esa proporción, porque es el hecho que sostiene todo este asunto. Una empresa cuyo negocio es la IA empresarial, con personas que se dedican profesionalmente a esto y con presupuesto de cómputo asignado exactamente para ello, evalúa la mitad de los candidatos que ella misma considera dignos de evaluación.
Llamemos a la otra mitad los cinco sin probar. No están rechazados. Nadie los encontró insuficientes. Sencillamente nunca se ejecutaron, y por eso la pregunta de si alguno de ellos habría sido más rápido, más barato o más preciso en tu carga de trabajo concreta queda abierta para siempre. Cada semana de lanzamientos añade a ese montón.
Y el montón es caro de despejar, porque cambiar de modelo no es subir una versión. Es una recualificación. Esto es lo que tiene que ocurrir de verdad antes de que un modelo nuevo llegue a producción:
| Qué hay que volver a comprobar | Por qué un modelo nuevo lo rompe |
|---|---|
| Prompts e instrucciones de sistema | Están ajustados a las manías del modelo viejo; una formulación que guiaba a uno con fiabilidad puede llevar a otro a otra parte |
| Estabilidad del formato de salida | Los analizadores posteriores dependen de la forma —JSON, encabezados, delimitadores— y los hábitos de formato cambian de un modelo a otro |
| Precisión sobre tus datos reales | Las diferencias de benchmark se miden en conjuntos públicos, no en tus reuniones, tus tickets, tu base de código |
| Comportamiento con herramientas y API | Los modelos agénticos difieren en cuándo llaman, con qué frecuencia reintentan y qué hacen cuando una llamada falla |
| Latencia y rendimiento bajo carga | Un modelo más rápido en una petición aislada puede ser más lento detrás de tus límites de tasa |
| Coste total a tu volumen | Precio por token por tokens consumidos por intentos; véase más abajo |
| Seguridad y comportamiento de rechazo | Los límites se mueven entre versiones en ambas direcciones |
| Casos de regresión | Los fallos concretos que ya arreglaste, y que ningún benchmark ajeno conoce |
Ocho categorías, cada una con ejemplos reales, una ejecución comparativa y el criterio de alguien. Eso es un proyecto, no un cambio de configuración. Multiplícalo por el número de lanzamientos de frontera de un mes cualquiera y la razón de la proporción de 10 a 5 se vuelve obvia.
Escribimos un artículo entero sobre cómo medir esto en tu propia carga de trabajo en lugar de fiarte de una clasificación, y el resumen honesto es que hacerlo bien lleva días, no horas.
Más barato por token no es más barato por tarea
El hallazgo más contraintuitivo de toda esta historia no vino de un laboratorio, sino de un ingeniero que intentaba automatizar la elección.
Moe Khalil, ingeniero de producto en LiteLLM, la pasarela de IA de código abierto, publicó el 4 de septiembre un artículo titulado «Model Fatigue is Real». Trabaja en el enrutador automático de LiteLLM —software cuyo trabajo entero consiste en elegir un modelo por ti— y declaró esa afiliación desde el principio, que es más de lo que hace la mayoría de quienes escriben sobre esto.
La suposición de partida de su equipo era la intuitiva. Coge dos modelos capaces de resolver una misma tarea; el que cuesta la mitad por token según la ficha del modelo debería resolverla por aproximadamente la mitad de precio.
No fue eso lo que mostraron las pruebas. El modelo más potente y más caro estaba resolviendo las tareas más difíciles por una fracción del coste del modelo barato. La explicación de Khalil: «Como era más inteligente, adoptaba un enfoque más inteligente y llegaba al producto terminado mucho más rápido.»
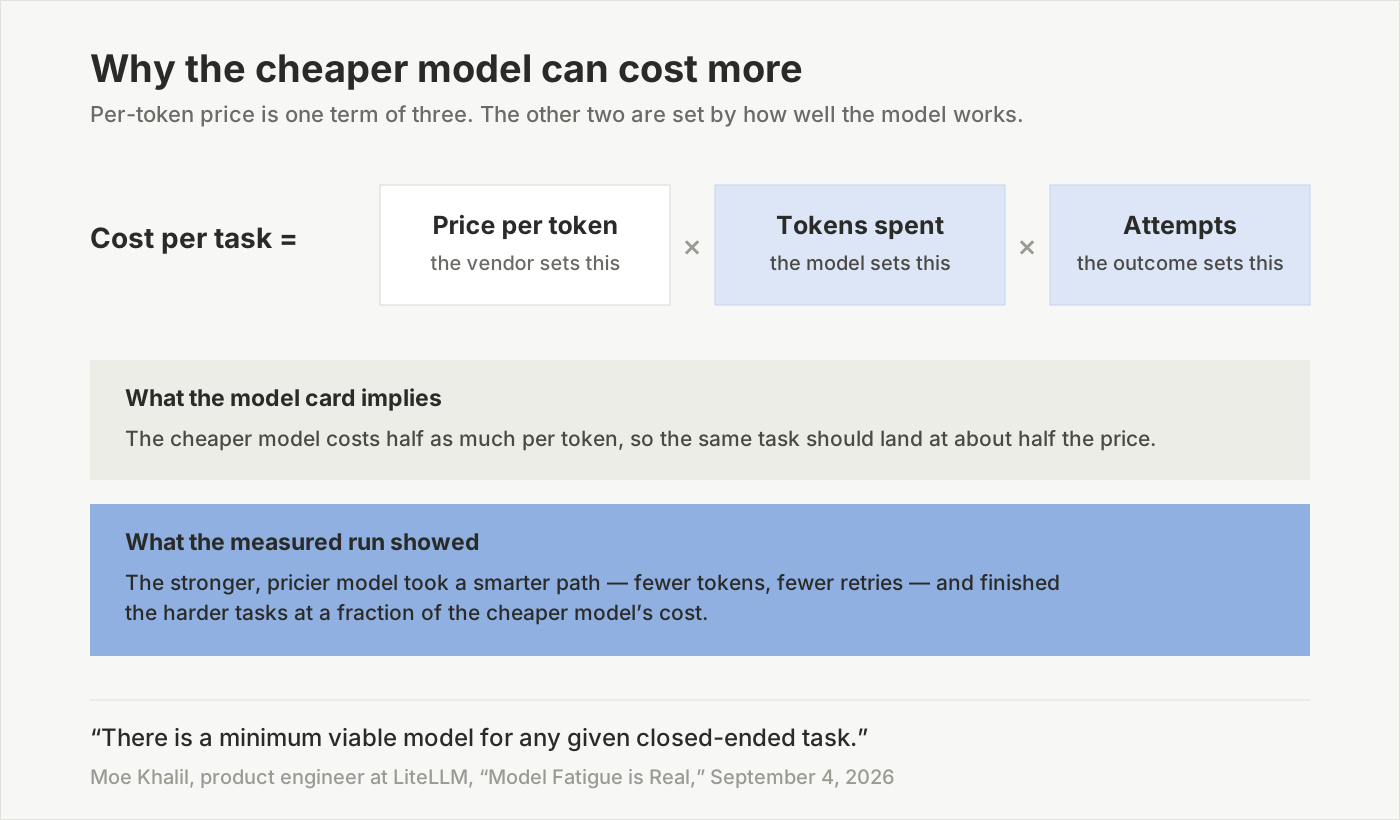
De los tres términos, el precio por token es el único que aparece en una página de tarifas. Los otros dos son propiedades de la competencia del modelo, y solo se manifiestan cuando pones el trabajo a correr.
Esto reformula por completo la página de tarifas. El número que anuncia un proveedor es un factor dentro de un producto de tres: precio por token, tokens gastados e intentos hasta que la tarea sale bien de verdad. El primero lo fija el proveedor. El segundo y el tercero los fija el propio modelo, y ninguno se puede conocer hasta que pasas tu propio trabajo por él.
Lo que significa que la comparación que te enseñaron a hacer —repasar la columna de precios y elegir el barato— no es meramente incompleta. En tareas reales puede apuntar en la dirección equivocada.
Aguas arriba nadie tiene incentivos para decírtelo
Khalil dice entonces lo que se calla, y es la frase más afilada que se ha escrito este año sobre este asunto:
«Para las empresas de modelos, esta pereza es una funcionalidad, no un fallo. Prefieren que use [el modelo de gama alta] para resumir mi correo, y no tienen ningún incentivo para decirme cuándo un modelo más barato funcionaría igual de bien. Su trabajo es seguir empujando la frontera. Averiguar cuándo no usar la frontera se me deja a mí.»
Léelo otra vez con el número de Gartner en la cabeza. Un mercado de 2,59 billones de dólares, que crece un 47 % anual, en el que los proveedores se benefician de que cada cliente suba de gama por defecto y no soportan coste alguno cuando el cliente gasta de más.
Esto no es una conspiración ni exige que nadie se porte mal. Es simplemente la forma que tiene el gradiente de incentivos. El trabajo de un laboratorio de frontera es mover la frontera. Decirte que el modelo de gama media del año pasado se ocupa del 80 % de tu carga de trabajo es trabajo de otro, y hasta hace poco no era trabajo de nadie.
La segunda observación de Abbasi también encaja aquí. Sugirió que «no es casualidad» que todos los grandes desarrolladores anunciaran la misma semana, y Noah Faro, jefe de tecnología de Farsight, una startup de finanzas con IA, coincidió, señalando que los rivales leen los planes de los demás en parte a partir de la disponibilidad de cómputo en la nube, ya que todos compiten por capacidad ante el mismo puñado de proveedores. Faro añadió el matiz desinflador: a diferencia de GPT-6 Astra, los lanzamientos de Anthropic, Meta y Google de aquella semana fueron versiones intermedias, mejoras de modelos existentes en lugar de modelos nuevos. En su valoración, los dos últimos lanzamientos que movieron de verdad la aguja fueron Fable 5 de Anthropic en junio y Kimi K3 de Moonshot AI en julio.
Así que: seis anuncios, un modelo de frontera genuinamente nuevo y todo un ciclo de evaluación de trabajo generado para todos los de aguas abajo.
Dos maneras en que la industria está absorbiendo esto, y no son iguales
Si los laboratorios no toman la decisión, alguien tiene que tomarla. Han surgido dos respuestas, y son estructuralmente distintas.
La respuesta horizontal es el enrutado. Pasarelas como LiteLLM ponen todos los modelos detrás de una sola clave de API e intentan elegir petición a petición. Khalil describe el problema técnico con precisión: para cualquier tarea cerrada existe un modelo mínimo viable —el más barato que todavía acierta— y el reto está en predecir cuál es antes de que la tarea se ejecute. El mejor enfoque actual de su equipo lo infiere a partir de datos de benchmarks públicos más heurísticas en el prompt; también han probado clasificación con LLM e híbridos. Su propio veredicto: «Todo sigue siendo imperfecto, pero es un escalón por encima de nada.»
El enrutado es ingeniería de verdad y ayuda. Pero fíjate en qué mueve y qué no. Absorbe la fontanería: una clave, una interfaz, acceso automático a modelos nuevos. No absorbe la responsabilidad. Cuando el enrutador se equivoca, la mala salida sigue siendo tuya, en tu producto, delante de tu usuario. Sigues siendo tú quien evalúa si la respuesta era buena.
La respuesta vertical es software totalmente gestionado y creado para un solo trabajo. Aquí el proveedor no enruta entre modelos en tu nombre; te quita la tarea entera de las manos y entrega un resultado terminado. No ves un nombre de modelo. Ves una transcripción, un resumen, una traducción, una nota de gastos presentada.
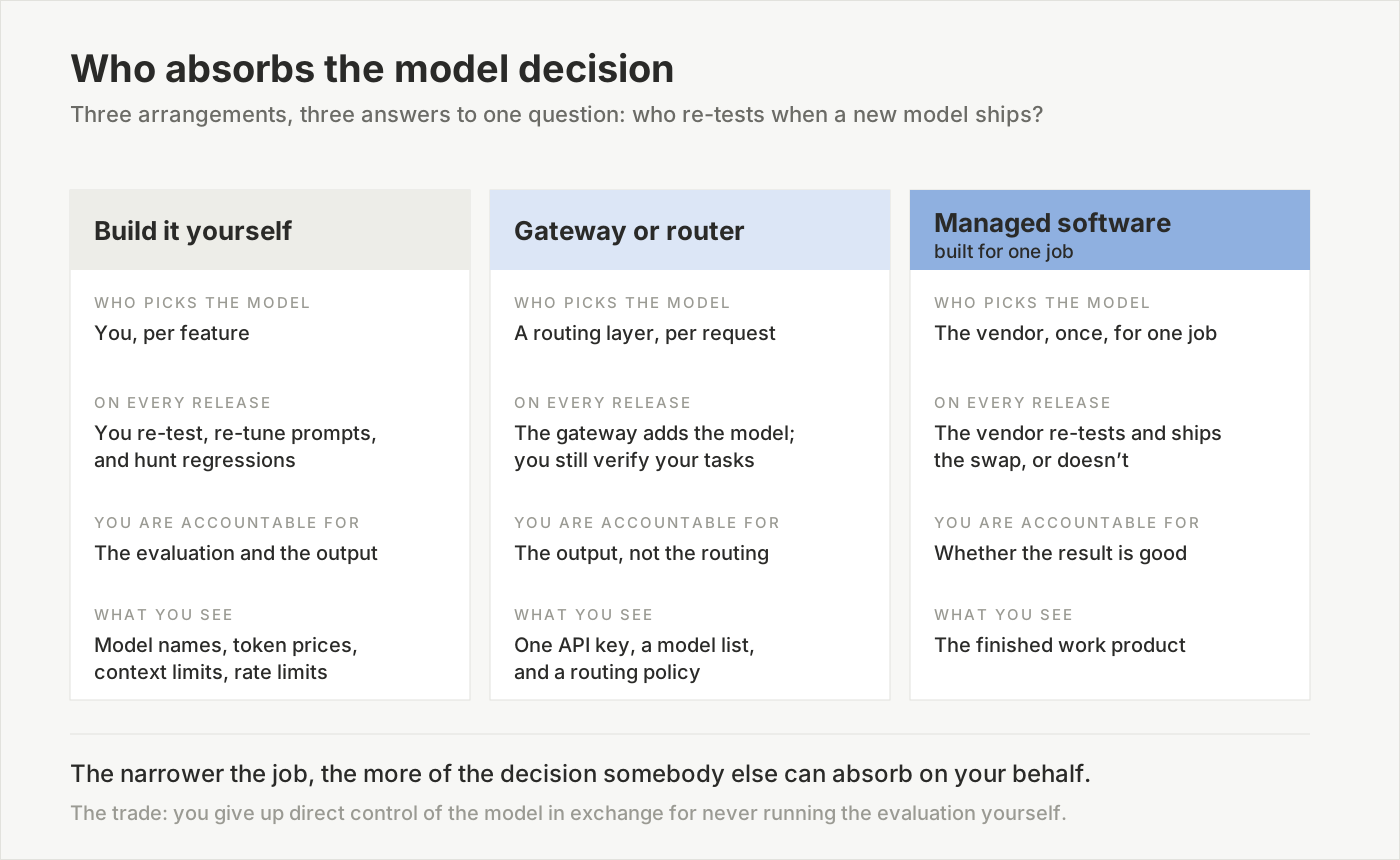
Cuanto más a la derecha, menos parte de la decisión sigue siendo tuya, y más dependes de que el proveedor haya hecho la evaluación con honestidad.
La comunidad de IA local llegó a una conclusión parecida desde la dirección opuesta. Un análisis publicado este año describía la escena de los modelos pequeños como una cinta de correr: descargar, configurar, lanzar unos cuantos prompts, juzgar a medias, pasar al siguiente lanzamiento. La recomendación era parar: estandarizarse en una configuración diaria contrastada y adoptar un modelo nuevo solo tras probarlo el tiempo suficiente en tareas reales y representativas para confirmar que es realmente mejor para tu carga de trabajo concreta. La misma conclusión, alcanzada por un aficionado con dos GPU y por un consejero delegado con presupuesto de cómputo: elige una vez, bien, y deja de reabrir el asunto cada jueves.
Por qué es la estrechez del trabajo lo que hace absorbible la decisión
Esta es nuestra posición, y es la razón de que esta categoría exista.
La decisión de modelo solo puede tomarla alguien que conozca la tarea. Suena trivial. No lo es, porque deja fuera a casi todo el mundo.
Una interfaz de chat de propósito general no puede decidir por ti, porque cualquier mañana puede pedírsele que escriba un soneto, que depure una condición de carrera o que resuma un contrato de alquiler. No existe un modelo mínimo viable para «lo que sea que el usuario escriba a continuación». El único valor por defecto seguro es el modelo más potente disponible, que es exactamente el valor por defecto que sirve a los intereses del proveedor, y exactamente aquel del que, según Khalil, nadie tiene incentivos para disuadirte.
Una pasarela puede acertar mejor, porque ve el prompt. Pero lo ve sin saber cómo es una buena respuesta en tu dominio, y sin consecuencia alguna si se equivoca.
El software gestionado creado a medida ocupa una posición completamente distinta. Cuando el trabajo está fijado —transcribir una reunión de 60 minutos con cuatro hablantes que alternan entre español e inglés y luego producir tareas pendientes—, la tarea es cerrada exactamente en el sentido de Khalil. Existe para ella un modelo mínimo viable. Y, decisivamente, es el mismo modelo mínimo viable para cada cliente con ese trabajo, lo que significa que la evaluación hay que ejecutarla una vez y su coste se reparte entre todos.
Ese es el argumento económico entero de la categoría, y merece enunciarse como regla: cuanto más estrecho es el trabajo, mayor parte de la decisión de modelo puede absorber otro en tu lugar. Un proveedor que atiende una sola carga de trabajo puede permitirse probar los 10 candidatos porque los prueba una vez, para miles de clientes, frente a una definición fija de buen resultado. Que tú pruebes cinco, para ti solo, frente a una definición que además tienes que inventarte, es la manera cara de llegar a una respuesta peor.
El intercambio es real y merece nombrarse con honestidad. Renuncias al control directo de qué modelo ejecuta tu trabajo. A cambio, dejas de correr la evaluación, dejas de seguir calendarios de lanzamientos y lo que juzgas es el resultado, que siempre fue lo único que de verdad te importaba.
Cómo saber qué disposición estás comprando
Antes de tu próxima compra de IA, cuatro preguntas en orden:
- ¿El trabajo es cerrado? ¿Puedes decir en una frase cómo es una salida correcta? Si es que sí, una herramienta vertical gestionada puede quedarse con la decisión. Si la respuesta es «depende de lo que le pidamos», estás comprando un modelo general y la evaluación sigue siendo tuya.
- ¿Quién vuelve a probar cuando sale un modelo nuevo? Pregúntaselo al proveedor directamente. Un proveedor gestionado debería poder describir su conjunto de evaluación y su proceso de cambio. Si la respuesta es que tendrás «acceso a los últimos modelos», has comprado fontanería, no criterio.
- ¿Qué te muestran, un modelo o un resultado? Si el producto expone nombres de modelos, ventanas de contexto y precios por token, te está devolviendo la decisión. Es un producto legítimo, pero ponle precio en consecuencia.
- ¿Cómo queda el coste total a tu volumen? Precio por token, por los tokens realmente consumidos en tu trabajo, por los intentos hasta que sale bien. Ejecuta tus propias tareas. La página de tarifas no puede responder a esto.
En resumen: la frontera es un valor por defecto, no una decisión
La fatiga de modelos suele describirse como un problema de atención: demasiadas noticias, demasiado rápido. No lo es. Es un coste que el mercado de mayor crecimiento de la tecnología trasladó discretamente a sus clientes, donde se queda sin precio y en gran medida sin medir.
Los laboratorios seguirán publicando, porque publicar es su trabajo y el mercado paga por ello. La carga de evaluación seguirá creciendo, porque crece mecánicamente con cada lanzamiento. Y la mayoría de los equipos seguirá resolviéndolo de la única manera en que puede hacerlo un equipo ocupado: echando mano del modelo más nuevo, más grande y más caro, que es la única opción que nadie tiene que defender en una reunión.
Cada pieza de software que te quita un trabajo por completo, y que nunca te enseña un nombre de modelo, es una apuesta a que esa es una mala forma de llevar un negocio. La apuesta pinta mejor con cada semana de lanzamientos.
Dónde encaja Telli.sh: esta es la categoría en la que construimos. Telli.sh graba reuniones, separa hablantes, traduce en tiempo real entre 15 idiomas y produce resúmenes y tareas pendientes, y nunca te pregunta qué modelo usar, porque ese es nuestro trabajo, no el tuyo. Nuestra extensión de navegador sí ofrece nueve motores de traducción, incluida una opción totalmente en el dispositivo, para quienes de verdad quieren ese control; el producto de reuniones deliberadamente no lo hace, porque «transcribir bien esta reunión» es una tarea cerrada y preferimos que nos juzguen por la transcripción antes que por el modelo que hay detrás.
Graba tu próxima reunión y deja que otro elija el modelo
Fuentes
- CNBC, «'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace», 6 de septiembre de 2026 — la cronología de lanzamientos del 1 al 3 de septiembre de 2026; la cita de Zhen Lu sobre que «la fatiga de modelos es algo real»; el comentario de Sam Altman sobre las «cadencias más rápidas»; Ahmed Abbasi sobre el «juego de la cuota de bolsillo» y las valoraciones privadas cercanas a 1 billón de dólares; Noah Faro sobre las versiones intermedias y sobre Fable 5 y Kimi K3 como los dos últimos que movieron la aguja; y la cifra de Suresh Vasudevan de evaluar cinco de diez modelos. Con la colaboración de Kate Rooney y MacKenzie Sigalos; consultado el 8 de septiembre de 2026
- Moe Khalil, «Model Fatigue is Real», 4 de septiembre de 2026 — el argumento de «ningún incentivo para decirme cuándo funcionaría un modelo más barato»; el marco del modelo mínimo viable para tareas cerradas; y el hallazgo medido de que el modelo más potente y más caro resolvía tareas más difíciles por una fracción del coste del más barato. Khalil declaró en el artículo que es ingeniero de producto en LiteLLM, que desarrolla un enrutador automático; consultado el 8 de septiembre de 2026
- Gartner, «Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026», 19 de mayo de 2026 — gasto mundial en IA de 2,59 billones de dólares en 2026, un 47 % más interanual, con la infraestructura de IA como mayor segmento
- MindStudio, «Local AI Model Fatigue: Why One Setup Beats Chasing Every Release» — la descripción del ciclo de lanzamientos de modelos pequeños locales como una cinta de correr y el argumento a favor de estandarizarse en una configuración diaria contrastada
- AI타임스, «[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'», 7 de septiembre de 2026 — la cobertura en coreano que difundió el reportaje de la CNBC y los comentarios de desarrolladores a su alrededor
- Nuestra lectura de la compra de Hugging Face por NVIDIA — el otro anuncio de esa misma semana, y la capa de distribución que hay debajo de todos los modelos citados aquí
- Cómo medir la precisión de transcripción en tu propia carga de trabajo — lo que cuesta una evaluación real cuando se hace bien