Vier Frontier-Modelle in drei Tagen – und niemand sagt Ihnen, welches Sie gebraucht hätten
Zwischen dem 1. und 3. September 2026 haben Anthropic, Meta, Google und OpenAI allesamt Frontier-Modelle ausgeliefert, und CNBC hat der daraus folgenden Erschöpfung einen Namen gegeben: Modellmüdigkeit. Die Zahl der Releases ist der langweilige Teil. Interessant ist, dass jedes Release eine Evaluation erzeugt, die weiter unten jemand durchführen muss – und dass die Anbieter keinerlei Grund haben, Ihnen diese Arbeit zu ersparen. Ein Blick darauf, was ein Modellwechsel tatsächlich kostet, warum günstiger pro Token nicht günstiger pro Aufgabe bedeutet, und warum vollständig verwaltete Software für genau eine Aufgabe die einzige Konstellation ist, in der jemand anderes die Entscheidung für Sie treffen kann.
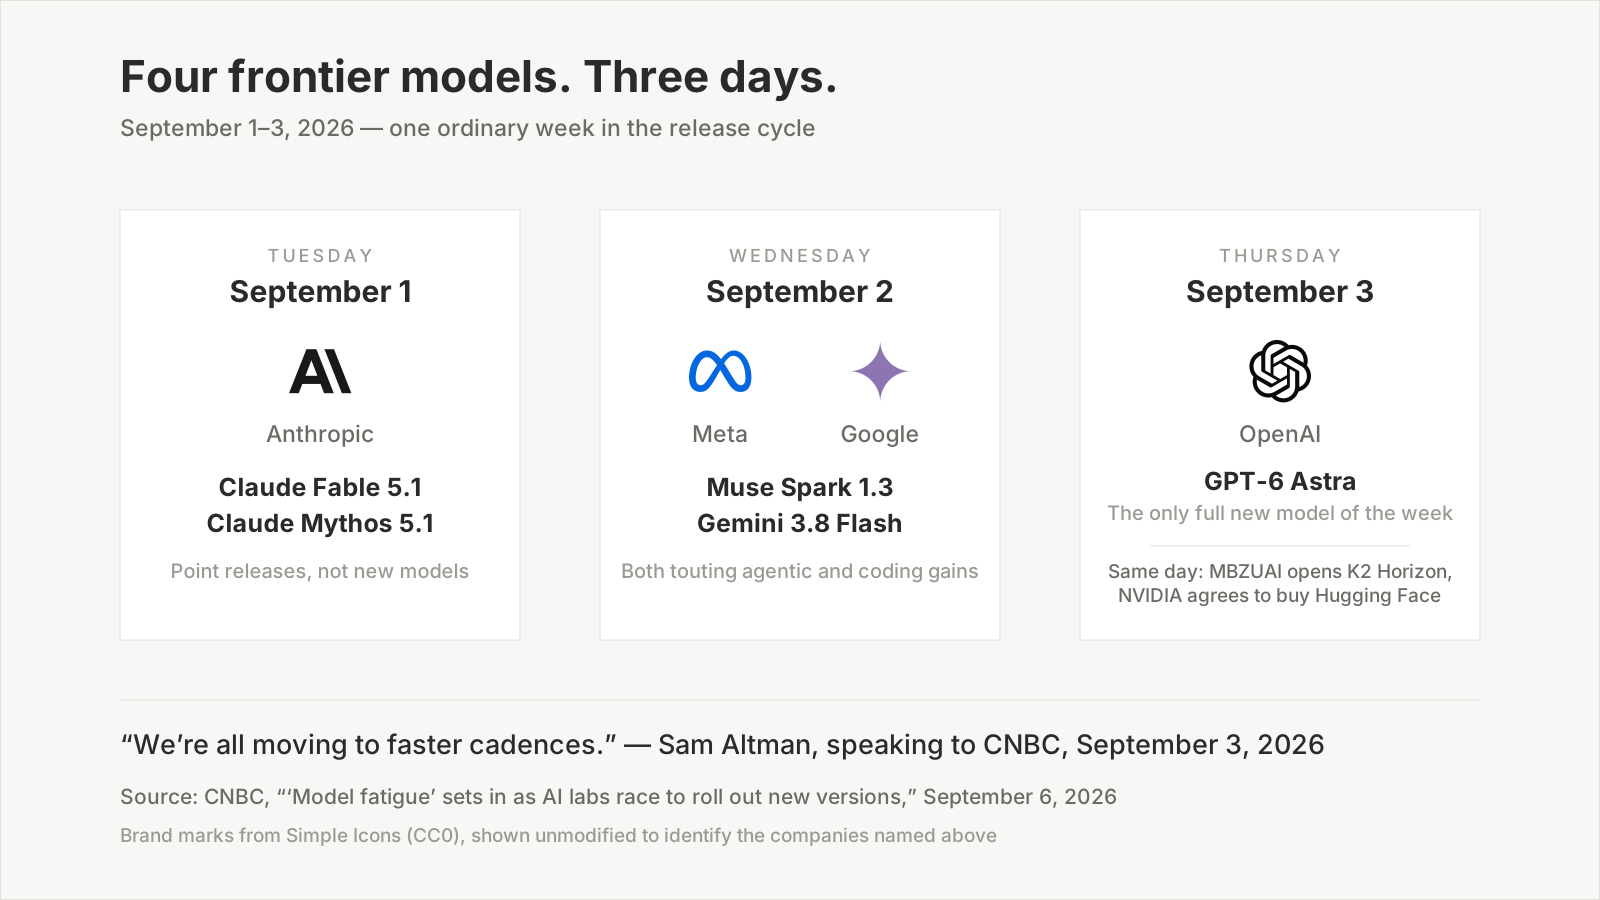
Markenzeichen von Simple Icons (CC0), unverändert gezeigt, um die genannten Unternehmen zu identifizieren. Release-Daten und das Altman-Zitat nach CNBC, 6. September 2026.
Zwischen Dienstag und Donnerstag der ersten Septemberwoche 2026 lieferte Anthropic Claude Fable 5.1 und Claude Mythos 5.1 aus, Meta Muse Spark 1.3, Google Gemini 3.8 Flash und OpenAI GPT-6 Astra. Am selben Donnerstag öffnete die Mohamed bin Zayed University of Artificial Intelligence in Abu Dhabi ihre Modellfamilie K2 Horizon für die Öffentlichkeit, und NVIDIA vereinbarte, Hugging Face zu kaufen – für 12.930.300.000 US-Dollar.
Sechs Ankündigungen. Drei Tage. CNBC brachte die Geschichte am Sonntag, dem 6. September, unter einem Begriff, der seit Wochen unter Praktikern kursierte: Modellmüdigkeit.
Die naheliegende Lesart lautet, die Branche bewege sich schneller, als irgendjemand folgen kann. Diese Lesart stimmt und ist weitgehend uninteressant. Der Teil, der Ihre Aufmerksamkeit verdient, ist ein anderer: Jedes Release verschiebt Kosten, und die Verschiebung läuft in exakt eine Richtung. Jedes Modell, das ein Labor ausliefert, wird zu einer Evaluation, die weiter unten jemand durchführen muss – und niemand weiter oben hat auch nur den geringsten Grund, Ihnen diese Arbeit zu ersparen.
TL;DR
- Vier Frontier-Releases in drei Tagen (1.–3. September 2026); CNBC gab der daraus folgenden Erschöpfung am 6. September den Namen „Modellmüdigkeit“.
- Die eigentlichen Kosten sind nicht Aufmerksamkeit, sondern Evaluationsarbeit. Ein Enterprise-CEO sagte CNBC, sein Team teste etwa 5 Modelle, wenn es 10 für eine Aufgabe bewerten wolle.
- Der Preis pro Token ist ein schlechter Näherungswert für die Kosten pro Aufgabe – ein stärkeres, teureres Modell kann schwierigere Arbeit günstiger erledigen, weil es weniger Schritte braucht.
- Modellanbieter haben strukturell kein Interesse daran, Ihnen zu sagen, wann ein günstigeres Modell genügt. Genau diese Lücke ist der ganze Existenzgrund verwalteter, zweckgebauter Software.
Am 6. September bekam die Modellmüdigkeit einen Namen
„Ich habe das Gefühl, dass Modellmüdigkeit real ist“, sagte Zhen Lu, CEO des KI-Infrastruktur-Start-ups Runpod, gegenüber CNBC. „Verstehen Sie mich nicht falsch, ich bin äußerst begeistert von all der Innovation, die gerade passiert, aber ich glaube wirklich, dass wir in einem Umfeld sind, in dem es so viel Schaum gibt, dass man Lärm machen muss.“
Sam Altman bot CNBC in derselben Woche eine mildere Einordnung an: „Wir alle gehen zu schnelleren Taktungen über“, sagte er und führte einen Teil der Beschleunigung darauf zurück, dass alle „aus dem Sommerurlaub zurück“ seien.
Beides kann zutreffen. Die Taktung beschleunigt sich tatsächlich, und die Beschleunigung ist tatsächlich zum Teil Inszenierung. Ahmed Abbasi, Professor an der Mendoza School of Business der University of Notre Dame mit 25 Jahren KI-Erfahrung, benannte die kommerzielle Logik nüchtern: Die Labore spielten „alle das Share-of-Wallet-Spiel“. Anthropic und OpenAI drücken am stärksten, während sie auf die Börse zusteuern; beide werden von privaten Investoren bereits mit knapp 1 Billion US-Dollar bewertet.
Die fragliche Geldbörse ist enorm. Gartner prognostizierte im Mai 2026, die weltweiten KI-Ausgaben würden in diesem Jahr 2,59 Billionen US-Dollar erreichen, ein Plus von 47 % gegenüber 2025. Den größten Anteil nimmt Infrastruktur, aber deutlich mehr als 1 Billion US-Dollar entfällt auf Dienstleistungen, Software, Sicherheit, Modelle und Werkzeuge – also auf Entscheidungen, die jemand treffen muss.
Der Punkt ist: Ein Markt dieser Größe, der so schnell wächst, belohnt Lautstärke. Er belohnt es nicht, Kunden zu sagen, dass sie mit weniger auskämen.
Die Kosten sind nicht Aufmerksamkeit. Es ist die Evaluation, die Sie nicht zu Ende bringen
Fragen Sie einen Praktiker, wie sich Modellmüdigkeit tatsächlich anfühlt, und Sie hören nicht „Ich lese zu viele Launch-Posts“. Sie hören Arithmetik.
Suresh Vasudevan, CEO des Enterprise-KI-Start-ups Clockwork Systems, lieferte CNBC die nützlichste Zahl der ganzen Geschichte. Wenn sein Unternehmen 10 KI-Modelle für eine bestimmte Aufgabe evaluieren wolle, sagte er, nehme es womöglich einfach fünf. „Es ist wirklich anspruchsvoll, jedes einzelne der Modelle zu evaluieren, die gerade herauskommen.“
Bleiben Sie kurz bei diesem Verhältnis, denn es ist die tragende Tatsache dieses ganzen Themas. Ein Unternehmen, dessen Geschäft Enterprise-KI ist, besetzt mit Leuten, die das beruflich tun, mit einem Compute-Budget, das genau dafür bereitsteht, evaluiert die Hälfte der Kandidaten, die es selbst für prüfenswert hält.
Nennen wir die andere Hälfte die ungeprüften Fünf. Sie wurden nicht abgelehnt. Niemand hat sie für unzureichend befunden. Sie wurden schlicht nie ausgeführt, und damit bleibt die Frage, ob eines von ihnen auf Ihrer konkreten Arbeitslast schneller, günstiger oder genauer gewesen wäre, dauerhaft offen. Jede Release-Woche vergrößert diesen Stapel.
Und der Stapel ist teuer abzuarbeiten, denn ein Modellwechsel ist kein Versionssprung. Er ist eine Requalifizierung. Das hier muss tatsächlich passieren, bevor ein neues Modell in Produktion geht:
| Was neu geprüft werden muss | Warum ein neues Modell es bricht |
|---|---|
| Prompts und System-Instruktionen | Auf die Eigenheiten des alten Modells getrimmt; eine Formulierung, die ein Modell zuverlässig steuerte, steuert ein anderes woandershin |
| Stabilität des Ausgabeformats | Nachgelagerte Parser hängen an der Form – JSON, Überschriften, Trennzeichen – und Formatierungsgewohnheiten verschieben sich zwischen Modellen |
| Genauigkeit auf Ihren echten Daten | Benchmark-Differenzen werden auf öffentlichen Datensätzen gemessen, nicht auf Ihren Meetings, Ihren Tickets, Ihrer Codebasis |
| Verhalten bei Tools und APIs | Agentische Modelle unterscheiden sich darin, wann sie aufrufen, wie oft sie wiederholen und was sie tun, wenn ein Aufruf fehlschlägt |
| Latenz und Durchsatz unter Last | Ein Modell, das bei einer Einzelanfrage schneller ist, kann hinter Ihren Rate Limits langsamer sein |
| Gesamtkosten bei Ihrem Volumen | Preis pro Token mal verbrauchte Token mal Versuche – siehe unten |
| Sicherheits- und Ablehnungsverhalten | Grenzen verschieben sich zwischen Versionen in beide Richtungen |
| Regressionsfälle | Genau die Fehler, die Sie bereits behoben haben und von denen kein fremder Benchmark weiß |
Acht Kategorien, jede mit echten Beispielen, einem Vergleichslauf und dem Urteil eines Menschen. Das ist ein Projekt, keine Konfigurationsänderung. Multiplizieren Sie es mit der Zahl der Frontier-Releases eines beliebigen Monats, und der Grund für das Verhältnis von 10 zu 5 liegt auf der Hand.
Wir haben einen eigenen Text darüber geschrieben, wie man das auf der eigenen Arbeitslast misst, statt einem Leaderboard zu vertrauen, und die ehrliche Zusammenfassung lautet: Sauber gemacht dauert es Tage, nicht Stunden.
Günstiger pro Token ist nicht günstiger pro Aufgabe
Der kontraintuitivste Befund dieser Geschichte kam nicht aus einem Labor, sondern von einem Ingenieur, der die Wahl automatisieren wollte.
Moe Khalil, Produktingenieur beim Open-Source-KI-Gateway LiteLLM, veröffentlichte am 4. September einen Beitrag mit dem Titel „Model Fatigue is Real“. Er arbeitet an LiteLLMs Auto-Router – Software, deren gesamte Aufgabe darin besteht, ein Modell für Sie auszuwählen – und er legte diese Zugehörigkeit gleich zu Beginn offen, was mehr ist, als die meisten tun, die über dieses Thema schreiben.
Die Ausgangsannahme seines Teams war die intuitive. Nimm zwei Modelle, die beide eine Aufgabe lösen können; dasjenige, das laut Modellkarte pro Token halb so viel kostet, sollte sie für ungefähr den halben Preis lösen.
Die Tests zeigten etwas anderes. Das stärkere, teurere Modell löste die schwierigeren Aufgaben zu einem Bruchteil der Kosten des günstigeren. Khalils Erklärung: „Weil es klüger war, wählte es einen klügeren Ansatz und kam sehr viel schneller zum fertigen Ergebnis.“
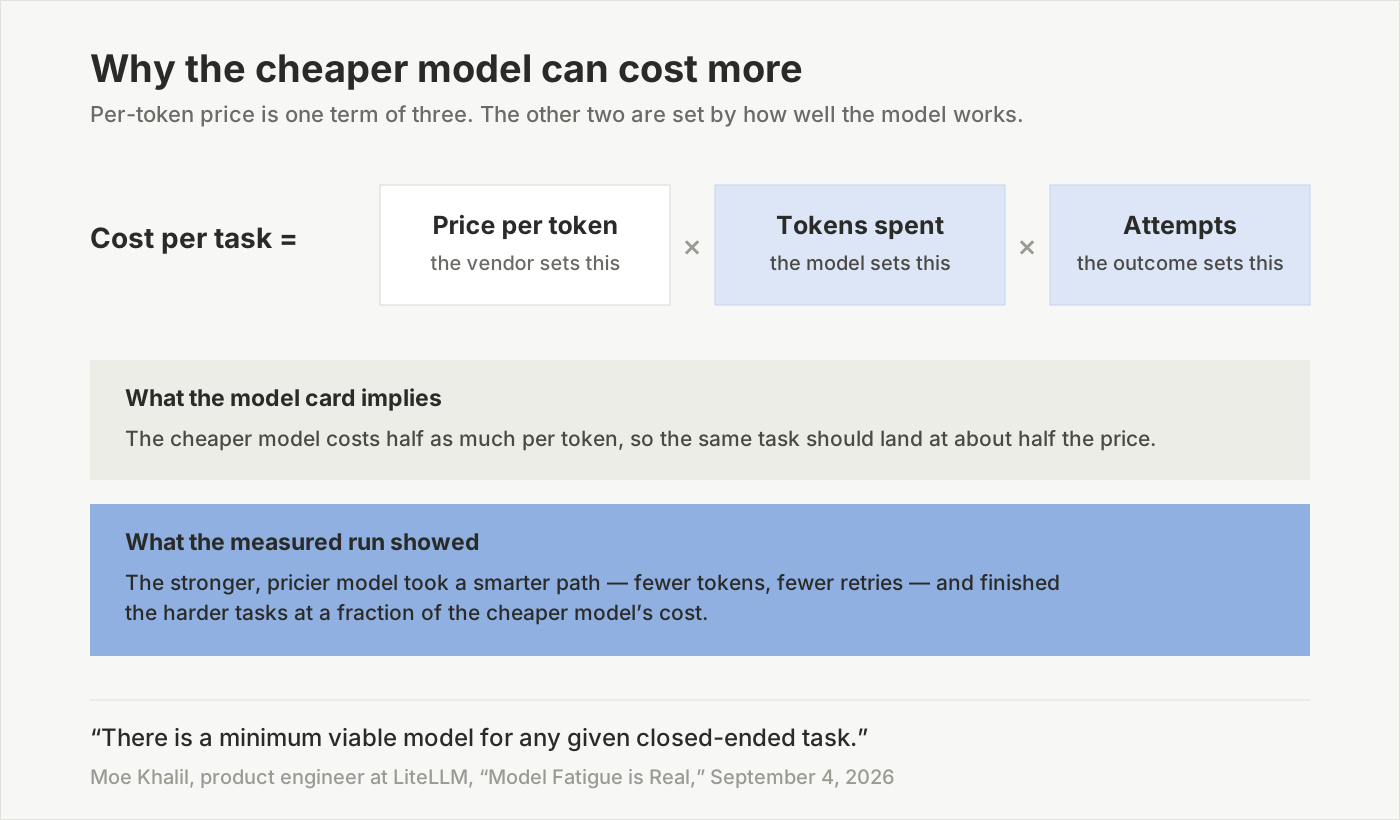
Von den drei Faktoren steht nur der Preis pro Token auf einer Preisseite. Die anderen beiden sind Eigenschaften der Modellkompetenz und zeigen sich erst, wenn Sie die Arbeit tatsächlich laufen lassen.
Das stellt die Preisseite komplett in Frage. Die Zahl, die ein Anbieter bewirbt, ist einer von drei Faktoren eines Produkts: Preis pro Token, verbrauchte Token und Versuche, bis die Aufgabe tatsächlich gelingt. Den ersten setzt der Anbieter. Den zweiten und dritten setzt das Modell selbst, und keiner von beiden ist bekannt, bevor Sie Ihre eigene Arbeit hindurchgeschickt haben.
Das heißt: Der Vergleich, den man Ihnen beigebracht hat – Preisspalte überfliegen, das Günstige nehmen – ist nicht bloß unvollständig. Bei echten Aufgaben kann er in die falsche Richtung zeigen.
Weiter oben hat niemand einen Anreiz, es Ihnen zu sagen
Khalil spricht dann aus, was sonst ungesagt bleibt, und es ist der schärfste Satz, der dieses Jahr zu diesem Thema geschrieben wurde:
„Für die Modellunternehmen ist diese Faulheit ein Feature – kein Bug. Ihnen ist es lieber, wenn ich [das Spitzenmodell] benutze, um meine E-Mails zusammenzufassen, und sie haben keinen Anreiz, mir zu sagen, wann ein günstigeres Modell genauso funktionieren würde. Ihr Job ist es, die Frontier weiter voranzutreiben. Herauszufinden, wann man die Frontier nicht verwenden sollte, bleibt mir überlassen.“
Lesen Sie das noch einmal mit der Gartner-Zahl im Kopf. Ein Markt von 2,59 Billionen US-Dollar, der um 47 % pro Jahr wächst, in dem die Anbieter davon profitieren, dass jeder Kunde standardmäßig nach oben greift, und keine Kosten tragen, wenn Kunden zu viel ausgeben.
Das ist keine Verschwörung und setzt nicht voraus, dass sich jemand schlecht verhält. So sieht das Anreizgefälle eben aus. Die Aufgabe eines Frontier-Labors ist es, die Frontier zu verschieben. Ihnen zu sagen, dass das Mittelklassemodell des Vorjahres 80 % Ihrer Arbeitslast erledigt, ist die Aufgabe von jemand anderem – und bis vor Kurzem war es die Aufgabe von niemandem.
Abbasis zweite Beobachtung gehört ebenfalls hierher. Er hält es für „keinen Zufall“, dass alle großen Entwickler in derselben Woche ankündigten, und Noah Faro, Technikchef des KI-Finanz-Start-ups Farsight, stimmte zu: Konkurrenten lesen die Pläne der anderen teilweise an der Verfügbarkeit von Cloud-Compute ab, da sie alle um Kapazität bei derselben Handvoll Anbieter konkurrieren. Faro machte auch den ernüchternden Punkt: Anders als GPT-6 Astra waren die Launches von Anthropic, Meta und Google in jener Woche Point-Releases, also Upgrades bestehender Modelle statt neuer. Nach seiner Einschätzung waren die letzten beiden Releases, die wirklich etwas bewegt haben, Anthropics Fable 5 im Juni und Moonshot AIs Kimi K3 im Juli.
Also: sechs Ankündigungen, ein tatsächlich neues Frontier-Modell und ein voller Evaluationszyklus an Arbeit für alle weiter unten.
Zwei Wege, wie die Branche das auffängt – und sie sind nicht dasselbe
Wenn die Labore die Entscheidung nicht treffen, muss es jemand anderes tun. Zwei Antworten haben sich herausgebildet, und sie sind strukturell verschieden.
Die horizontale Antwort ist Routing. Gateways wie LiteLLM legen jedes Modell hinter einen API-Schlüssel und versuchen, pro Anfrage auszuwählen. Khalil beschreibt das technische Problem präzise: Für jede geschlossene Aufgabe existiert ein minimal taugliches Modell – das günstigste, das noch Erfolg hat – und die Schwierigkeit besteht darin, vorherzusagen, welches das ist, bevor die Aufgabe läuft. Der derzeit beste Ansatz seines Teams leitet es aus öffentlichen Benchmark-Daten plus Heuristiken im Prompt ab; sie haben auch LLM-Klassifikation und Hybride ausprobiert. Sein eigenes Urteil: „Alles noch unvollkommen, aber ein Schritt besser als nichts.“
Routing ist echte Ingenieursarbeit und es hilft. Aber achten Sie darauf, was es verschiebt und was nicht. Es fängt die Verkabelung auf – ein Schlüssel, eine Schnittstelle, automatischer Zugang zu neuen Modellen. Es fängt nicht die Verantwortung auf. Wenn der Router falsch wählt, gehört die schlechte Ausgabe immer noch Ihnen, in Ihrem Produkt, vor Ihrem Nutzer. Die Bewertung, ob die Antwort gut war, bleibt bei Ihnen.
Die vertikale Antwort ist vollständig verwaltete Software für genau eine Aufgabe. Hier routet der Anbieter nicht in Ihrem Auftrag zwischen Modellen; er nimmt Ihnen die gesamte Aufgabe ab und liefert ein fertiges Ergebnis. Sie sehen keinen Modellnamen. Sie sehen ein Transkript, eine Zusammenfassung, eine Übersetzung, eine eingereichte Reisekostenabrechnung.
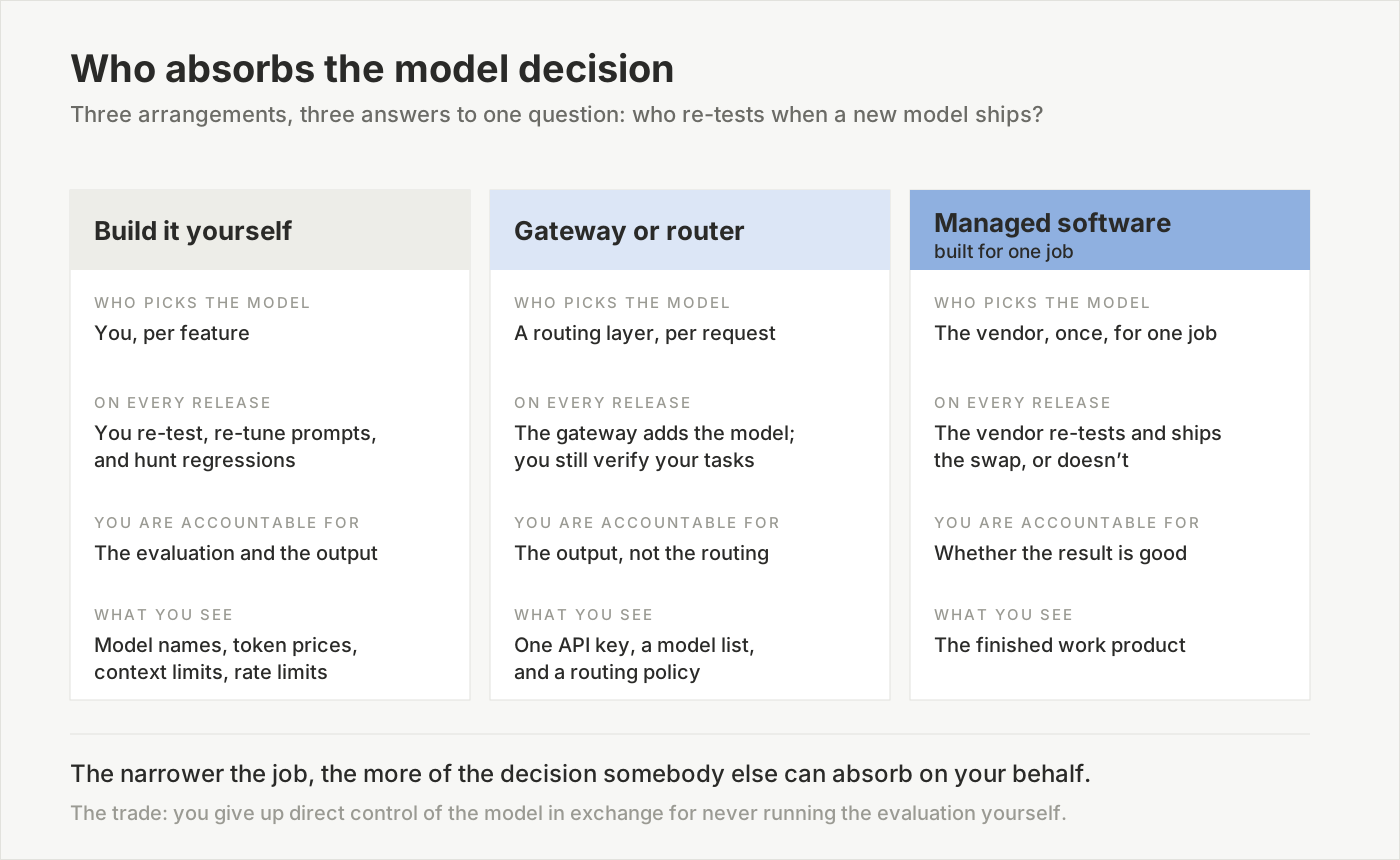
Je weiter rechts, desto weniger der Entscheidung bleibt bei Ihnen – und desto stärker hängen Sie davon ab, dass der Anbieter die Evaluation ehrlich gemacht hat.
Die Local-AI-Community kam aus der entgegengesetzten Richtung zu einem ähnlichen Schluss. Eine dieses Jahr veröffentlichte Analyse beschrieb die Szene der kleinen Modelle als Laufband: herunterladen, konfigurieren, ein paar Prompts laufen lassen, halb beurteilen, weiter zum nächsten Release. Die Empfehlung lautete, damit aufzuhören – sich auf ein bewährtes Alltagssetup festzulegen und ein neues Modell erst zu übernehmen, wenn es lange genug an echten, repräsentativen Aufgaben getestet wurde, um zu bestätigen, dass es für die eigene Arbeitslast tatsächlich besser ist. Derselbe Schluss, erreicht von einem Hobbyisten mit zwei GPUs und von einem CEO mit Compute-Budget: einmal richtig entscheiden und nicht jeden Donnerstag neu verhandeln.
Warum erst eine enge Aufgabe die Entscheidung abnehmbar macht
Hier ist unsere Einschätzung, und sie ist der Grund, warum es diese Kategorie überhaupt gibt.
Die Modellentscheidung kann nur treffen, wer die Aufgabe kennt. Das klingt trivial. Ist es nicht, denn es schließt fast alle aus.
Eine allgemeine Chat-Oberfläche kann die Entscheidung nicht für Sie treffen, denn an einem beliebigen Morgen könnte sie gebeten werden, ein Sonett zu schreiben, eine Race Condition zu debuggen oder einen Mietvertrag zusammenzufassen. Für „was auch immer der Nutzer als Nächstes eintippt“ gibt es kein minimal taugliches Modell. Der einzige sichere Standard ist das stärkste verfügbare Modell – exakt der Standard, der den Interessen des Anbieters dient, und exakt der Standard, von dem laut Khalil niemand einen Anreiz hat, Ihnen abzuraten.
Ein Gateway kann besser raten, weil es den Prompt sieht. Aber es sieht den Prompt ohne Wissen darüber, wie eine gute Antwort in Ihrer Domäne aussieht, und ohne Konsequenz, wenn es danebenliegt.
Zweckgebaute verwaltete Software steht an einer ganz anderen Stelle. Wenn die Aufgabe feststeht – ein 60-minütiges Meeting mit vier Sprechern transkribieren, die zwischen Deutsch und Englisch wechseln, und daraus Aufgabenpunkte erzeugen –, dann ist sie geschlossen in genau Khalils Sinn. Für sie existiert ein minimal taugliches Modell. Und entscheidend: Es ist für jeden Kunden mit dieser Aufgabe dasselbe minimal taugliche Modell, was bedeutet, dass die Evaluation einmal laufen muss und ihre Kosten sich auf alle verteilen.
Das ist das gesamte ökonomische Argument für diese Kategorie, und es lohnt sich, es als Regel festzuhalten: Je enger die Aufgabe, desto mehr der Modellentscheidung kann jemand anderes für Sie übernehmen. Ein Anbieter, der eine Arbeitslast bedient, kann es sich leisten, alle 10 Kandidaten zu testen, weil er sie einmal testet, für Tausende von Kunden, gegen eine feste Definition eines guten Ergebnisses. Dass Sie fünf testen, für sich allein, gegen eine Definition, die Sie erst erfinden müssen, ist der teure Weg zu einer schlechteren Antwort.
Der Tausch ist real und verdient es, ehrlich benannt zu werden. Sie geben die direkte Kontrolle darüber ab, welches Modell Ihre Arbeit ausführt. Im Gegenzug hören Sie auf, die Evaluation zu fahren, hören auf, Release-Kalender zu verfolgen, und beurteilen die Ausgabe – das Einzige, worum es Ihnen ohnehin ging.
Wie Sie erkennen, welche Konstellation Sie kaufen
Vor Ihrem nächsten KI-Einkauf vier Fragen, in dieser Reihenfolge:
- Ist die Aufgabe geschlossen? Können Sie in einem Satz sagen, wie eine korrekte Ausgabe aussieht? Wenn ja, kann ein verwaltetes vertikales Werkzeug die Entscheidung übernehmen. Lautet die Antwort „kommt darauf an, was wir fragen“, kaufen Sie ein allgemeines Modell und die Evaluation bleibt bei Ihnen.
- Wer testet neu, wenn ein neues Modell erscheint? Fragen Sie den Anbieter direkt. Ein verwalteter Anbieter sollte sein Evaluationsset und seinen Wechselprozess beschreiben können. Lautet die Antwort, Sie erhielten „Zugang zu den neuesten Modellen“, haben Sie Verkabelung gekauft, kein Urteil.
- Was wird Ihnen gezeigt – ein Modell oder ein Ergebnis? Wenn das Produkt Modellnamen, Kontextfenster und Token-Preise anzeigt, gibt es die Entscheidung an Sie zurück. Das ist ein legitimes Produkt, aber bepreisen Sie es entsprechend.
- Wie sehen die Gesamtkosten bei Ihrem Volumen aus? Preis pro Token, mal tatsächlich für Ihre Arbeit verbrauchte Token, mal Versuche bis zum richtigen Ergebnis. Lassen Sie Ihre eigenen Aufgaben laufen. Die Preisseite kann das nicht beantworten.
Fazit: Die Frontier ist ein Standardwert, keine Entscheidung
Modellmüdigkeit wird meist als Aufmerksamkeitsproblem beschrieben – zu viele Nachrichten, zu schnell. Ist sie nicht. Sie ist eine Kostenposition, die der am schnellsten wachsende Markt der Technologiebranche still und leise auf seine Kunden verschoben hat, wo sie unbepreist und weitgehend ungemessen liegen bleibt.
Die Labore werden weiter ausliefern, weil Ausliefern ihr Job ist und der Markt dafür zahlt. Die Evaluationslast wird weiter wachsen, weil sie mit jedem Release mechanisch wächst. Und die meisten Teams werden das so auflösen, wie ein beschäftigtes Team es eben kann: indem sie zum neuesten, größten, teuersten Modell greifen – der einen Option, die niemand in einem Meeting verteidigen muss.
Jede Software, die Ihnen eine Aufgabe vollständig abnimmt und nie einen Modellnamen zeigt, ist eine Wette darauf, dass dies eine schlechte Art ist, ein Unternehmen zu führen. Die Wette sieht mit jeder Release-Woche besser aus.
Wo Telli.sh hineinpasst: Das ist die Kategorie, in der wir bauen. Telli.sh zeichnet Meetings auf, trennt Sprecher, übersetzt in Echtzeit über 15 Sprachen hinweg und erstellt Zusammenfassungen und Aufgabenpunkte – und fragt Sie nie, welches Modell verwendet werden soll, denn das ist unsere Aufgabe, nicht Ihre. Unsere Browser-Erweiterung bietet durchaus neun Übersetzungs-Engines an, darunter eine vollständig geräteinterne Option, für alle, die diese Kontrolle wirklich wollen; das Meeting-Produkt tut das bewusst nicht, denn „dieses Meeting gut transkribieren“ ist eine geschlossene Aufgabe, und wir möchten lieber am Transkript gemessen werden als am Modell dahinter.
Zeichnen Sie Ihr nächstes Meeting auf und überlassen Sie die Modellwahl jemand anderem
Quellen
- CNBC, „'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace“, 6. September 2026 – die Release-Chronologie für den 1.–3. September 2026; Zhen Lus Zitat „Modellmüdigkeit ist real“; Sam Altmans Bemerkung zu „schnelleren Taktungen“; Ahmed Abbasi zum „Share-of-Wallet-Spiel“ und zu den Bewertungen von knapp 1 Billion US-Dollar; Noah Faro zu Point-Releases sowie zu Fable 5 und Kimi K3 als den letzten beiden, die etwas bewegt haben; und Suresh Vasudevans Zahl von fünf aus zehn Modellen. Recherche-Beiträge von Kate Rooney und MacKenzie Sigalos; abgerufen am 8. September 2026
- Moe Khalil, „Model Fatigue is Real“, 4. September 2026 – das Argument „kein Anreiz, mir zu sagen, wann ein günstigeres Modell reicht“; der Rahmen des minimal tauglichen Modells für geschlossene Aufgaben; und der gemessene Befund, dass das stärkere, teurere Modell schwierigere Aufgaben zu einem Bruchteil der Kosten des günstigeren löste. Khalil legte im Beitrag offen, dass er Produktingenieur bei LiteLLM ist, das einen Auto-Router baut; abgerufen am 8. September 2026
- Gartner, „Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026“, 19. Mai 2026 – weltweite KI-Ausgaben von 2,59 Billionen US-Dollar im Jahr 2026, ein Plus von 47 % gegenüber dem Vorjahr, mit KI-Infrastruktur als größtem Segment
- MindStudio, „Local AI Model Fatigue: Why One Setup Beats Chasing Every Release“ – die Laufband-Beschreibung des lokalen Release-Zyklus kleiner Modelle und das Plädoyer, sich auf ein bewährtes Alltagssetup festzulegen
- AI타임스, „[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'“, 7. September 2026 – koreanischsprachige Berichterstattung, die die CNBC-Geschichte und die umgebenden Entwicklerkommentare aufgriff
- Unsere Lesart der Übernahme von Hugging Face durch NVIDIA – die andere Ankündigung derselben Woche und die Distributionsschicht unter jedem hier genannten Modell
- Wie man Transkriptionsgenauigkeit auf der eigenen Arbeitslast misst – was eine echte Evaluation kostet, wenn man sie sauber durchführt