MiniCPM-OCRでスキャンをまとめてローカル処理。どのページを人が確認する?
MiniCPM-OCR 1.0.5 SDKは複数の入力を一度に処理できる。文書ごとに結果を保ち、重要な項目を確認して、検索用アーカイブに入れられるページを見極める。
古い請求書が三通ある。人なら読めるが、検索には向かない。一通はテキストを選択できないPDF、一通は角が折れた紙を撮った写真、もう一通はきれいなスキャンだが、表が二ページにまたがっている。ローカルで動くOCRなら画像を文字にできる。アーカイブへの登録を承認する人には、どの結果がどのファイルに対応するか、表の各列の意味が保たれているかも分かる必要がある。
OpenBMBは2026年11月9日、MiniCPM-OCR SDKのバージョン1.0.5を公開した。複数の入力を一度に受け取り、ファイルごとに結果を出力する。独立した画像を一つずつ別文書として扱うオプションもある。パラメーター数13億のMiniCPM-OCR 1.0モデルは、中国語と英語の文書やPDFを対象とする。モデルとSDKはそれ以前に公開されており、OpenBMBは認識サービスをローカルで動かす手順も掲載している。PyPIのリリース情報 · OpenBMBのプロジェクトと変更履歴
試すなら、結果を確認できる小さな一括処理から始めたい。入力ごとに固定のIDを割り当て、抽出結果を原本と対応づけて残し、間違えると困る項目を確認する。そうすれば、検索できる下書きと、実際の判断に使える記録を分けて扱える。
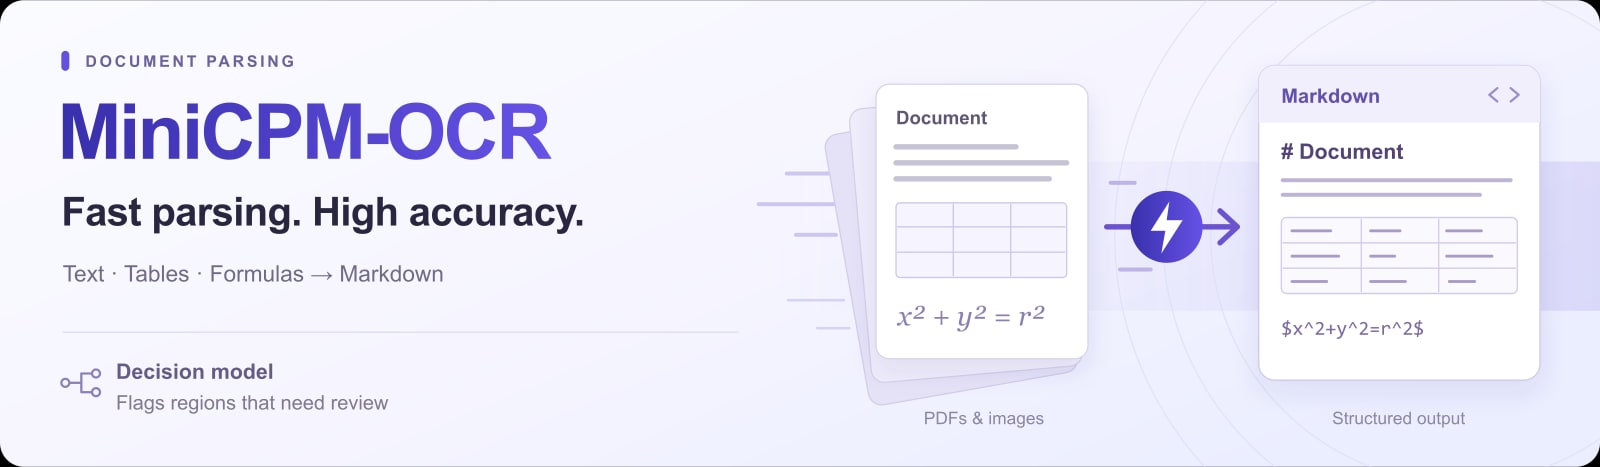
文書から構造化テキストへの流れを示すOpenBMB公式のMiniCPM-OCRリリース用イラスト。Apache 2.0。Telli.shがラスター画像に変換し、サイズを調整。元のイラスト

更新で文書のまとまりを維持しやすくなった
OpenBMBの11月9日のリリースノートによると、1.0.5は入力が複数あれば、ファイルごとに一つずつ結果を返す。--split-images を使うと、独立した画像を別々の文書として扱える。複数ページのPDFとカメラで撮った写真が混在する職場では、この二点が重要だ。一つのPDFにまとめた請求書は、ふつうは一通のまま扱いたい。無関係な写真二枚は別々の記録にする。MiniCPM-OCR 1.0.5のパッケージとリリースノート
小規模な評価用に、種類の違う文書を一件ずつ用意する。きれいなPDFなら、想定どおりの順序で読めるか確かめられる。紙を撮った写真なら、折り目や回転、光の反射で読み取りが乱れるか見られる。情報量の多い表では、値のよく似た二つの列がどう扱われるかを確認できる。同じ記録の別ページを撮った写真が二枚ある場合は、解析に渡す前に、どう一つにまとめるか決めておく。文書としてのまとまりは原本に由来するが、コマンドが受け取るのはファイルだ。
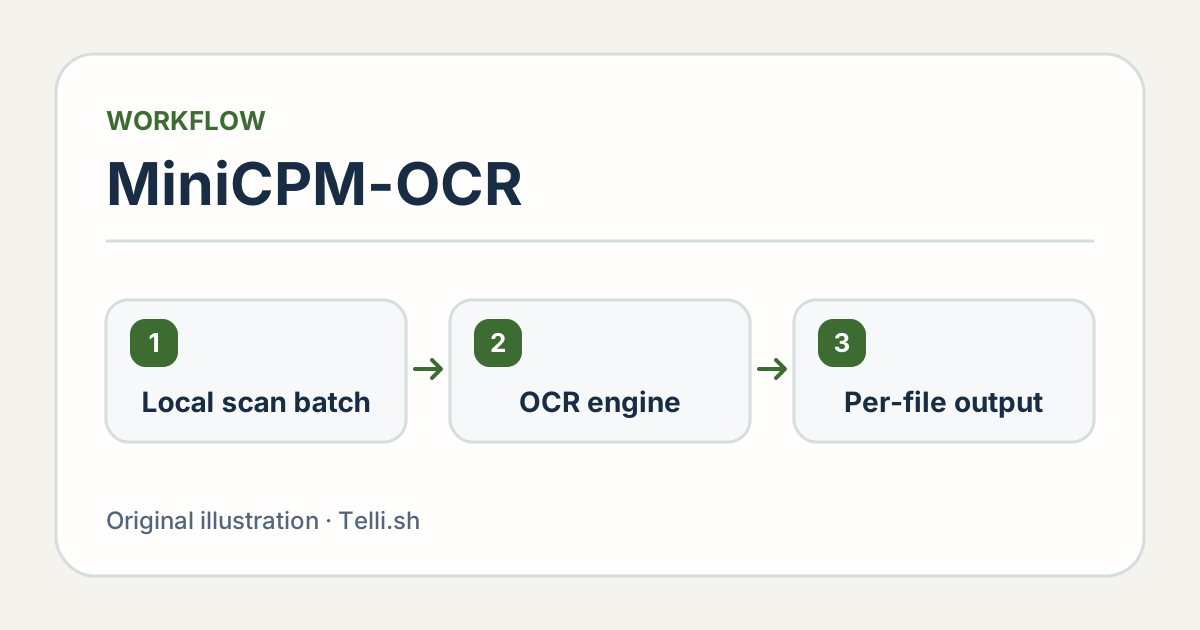
一括処理の例。入力ごとに固定の文書IDを割り当て、レビューまで原本を保持する。Telli.sh作成。
入力の一覧表に、原本、ページ数、想定する出力先を記録する。意図しない変更を検出するためにチェックサムを使うなら、処理の前に原本から計算する。抽出結果を別の場所に保存しておけば、再実行で唯一の原本を上書きする事態を避けられる。二つのフォルダーに偶然同じ名前のinvoice.pdfがあっても、固定のIDがあれば、ファイル名だけでは曖昧な対応関係を追える。
出力形式は、次の処理で読めるものを選ぶ。OpenBMBのSDKは設定に応じてMarkdownかJSONに結果をまとめる。Markdownは、人が下書きとして読むのに便利だ。構造化された出力なら、後続処理が解析で返された領域を扱いやすい。どちらでも、数値や項目を判断に使う場合には画像と照合する必要がある。OpenBMBの解析パイプライン
ローカル構成では、レイアウト解析と認識が別に動く
OpenBMBは、デスクトップでページ全体を解析する仕組みを二つに分けて説明している。SDKはレイアウトモデルを動かし、文章、表、数式などの位置と順序を特定する。切り出した領域をHTTP経由で認識サービスに送り、応答を読む順に並べ直す。両方を自分で管理する機器上で動かせる。認識サービスは別の実行環境で、SDKから別の場所にあるサービスを指定することもできる。OpenBMBのページ全体の解析とローカル導入手順
文書に非公開情報が入っていると、この境界が重要になる。確認したいのは、レイアウト処理で切り出した画像をどこに送るかだ。手元で動くSDKでも、外部ホストのサービスを呼び出す設定なら、文書の内容がネットワークに出ることがある。ローカル構成では想定どおりのサービスを指定し、組織が承認した保存とログの方針に従う。公開デモの画面を試すだけなら、実際の顧客文書を送らず、架空のサンプルを使えばよい。
OpenBMBは11月5日、SDK、vLLM、モデルをまとめたDockerイメージを公開した。文書に記載された要件は、Linux x86-64、NVIDIA GPU、CUDA 12.9互換ドライバー、NVIDIA Container Toolkitを備えたDockerだ。認識サービスには、llama.cppやOllamaなどのバックエンドも案内されている。モデルの大きさだけでは、その端末で処理全体を余裕を持って動かせるか判断できない。レイアウト処理、モデル形式、メモリ使用量、処理速度を対象の機器で確認する。OpenBMBの導入要件
一件ずつ処理するなら、モバイルで使う方法もある。OpenBMBは11月2日にiOSでのオフライン解析を発表した。11月12日の更新で、端末内で動くデモがAndroidとHarmonyOSにも広がった。モバイルデモとデスクトップ用の一括処理SDKは、モデルの別々の利用方法だ。ファイルがどこにあるか、結果をどのように確認するかに合わせて選ぶ。OpenBMBのモバイル版公開履歴
見た目では気づきにくい項目の誤りを確認する
請求書に「数量10、単価38.50」とあるとする。抽出された表では数量欄に38.50、単価欄に10が入っていた。二つの数値が出力に含まれるかだけを調べる仕組みなら、検査を通ってしまう。結果を使う人に必要なのは、値と列の正しい対応だ。行、列見出し、合計値をまとめて照合する。
検索用のアーカイブでは、別のリスクがある。説明欄に誤字があっても、原本にたどり着けるなら許容できる場合がある。発注番号を間違えると、別の文書を参照してしまいかねない。完全一致が必要な項目を決め、原本と照合する。コードに先頭ゼロがあるときは、確認中も維持する。解析は合っていても、数値表示や表計算ソフトへの取り込みでゼロが消えることがある。
| 文書の例 | 原本と照合するもの | 後続利用までに決めること |
|---|---|---|
| 請求書 | 取引先ID、請求書番号、通貨、合計とその列見出し | どの項目に完全一致が必要か |
| 複数列の報告書 | 見出し、列の順番、図の近くにあるキャプション | 意図した順序で読めるか |
| 傾きのある用紙や撮影した書式 | 氏名、チェック欄、印影、折り目付近の記入内容 | どのページに目視確認や再スキャンが必要か |
| 複数言語が混在するスキャン | IDと、使われている各言語の項目テキスト | どの言語がアーカイブ独自の受け入れ基準を満たすか |
OpenBMBはMiniCPM-OCR 1.0を中国語と英語向けと説明している。韓国語や多言語が混在するページを扱う場合は、そのページで実際の認識精度を測る。重要な言語ごとに、情報量の多い文書、きれいな書式、カメラ画像を含めるとよい。少数の異なる文書をまとめて一つの平均点にするより、どの種類のエラーが出たかを記録する。OpenBMBのモデル説明
領域ごとのスコアでレビュー順を決める
OpenBMBは、解析されたテキスト、数式、表と画像領域の対応を評価する別モデルMiniCPM-OCR Jevも公開している。プロジェクトでは、スコアを確認が必要そうな領域の発見に使うと説明している。一括処理では確認の優先順位をつける材料にしつつ、影響の大きい項目を原本と照合できる。スコアで確認順を決める前に、重視する間違いをどの程度上位に並べられるか確かめる。OpenBMBによるMiniCPM-OCR Jevの説明
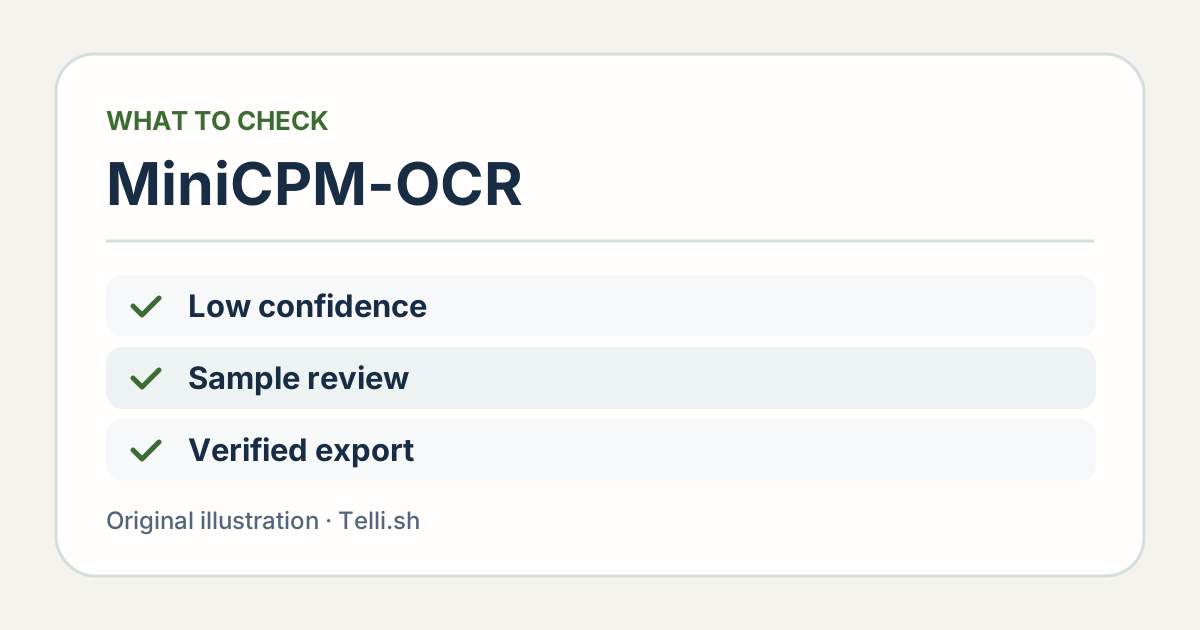
領域スコアは必要に応じてレビューの優先順位づけに使う。支払いや識別、ほかの判断に関わる項目は直接の照合が必要な場合がある。Telli.sh作成。
スコアが役立つ場面を探るため、チームが見分けられる誤りを含む小さな参照セットを作る。品番の一文字欠落、行のずれ、きれいなページから抽出した一文は、それぞれ異なる動作を試せる。正しい領域もいくつか含める。誤った結果に高いスコアがついたり、正しい結果に低いスコアがついたりした例を確認する。しきい値を手順に組み込む前に検討するのは、こうした例だ。
判定の食い違いが見えるようにする。確認者が合計金額を直す場合、元のOCR出力を保存し、どの原文書に対する修正かを記録する。文書の種類や取り込み方法に誤りが偏っているか、後から調べられる。また、次に見る人が、人による修正とモデルの初回出力を区別できる。
この一括処理を広げられるかは、人が確認にかける時間で決まることがある。修正にかかった時間と、再確認が必要になったページの特徴を記録する。きれいな文書ではローカル処理で時短できても、画質の悪いスキャンは人の確認待ちが増えるかもしれない。同じ書式で何度も失敗するなら、別モデルを追加する前に、スキャンの取り方を改善した方がよいこともある。
違う種類の失敗が起きそうな文書を少量まとめて試す
- 利用の許可を得たサンプルを集める。 きれいなスキャン、回転した写真、複数ページの表を、代表的な言語やレイアウトで用意する。原本ごとに固定IDを付けて保持する。
- 承認済みのローカル処理経路を選ぶ。 デスクトップの一括処理はOpenBMBのローカル導入手順に従い、認識サービスの接続先を確認する。ファイルを入れる前に、機器と実行環境の要件を確認する。公式のローカル導入手順
- SDKを実行し、ファイル単位の結果を残す。 SDKの版、モデルまたは量子化形式、バックエンド、出力形式を記録する。画像のグループ化方法を選び、すべての結果に対応する原本を保存する。SDK 1.0.5の手順
- アーカイブの用途に合わせて確認する。 検索用には読む順番を、後続処理用には抽出結果が重要な項目を確認する。受理、修正、却下した文書とその理由を記録する。
- 新しい少量の資料でもう一度試す。 同じ受け入れ基準で、確認までの所要時間と追跡のしやすさを比べる。件数を増やす前に、手作業が必要な文書の種類に対処する。
扱う用途は、手が届く範囲に収める。会議資料のスキャンを検索する支援ツールと、請求書の支払用フォームに値を入れるツールでは、必要な項目保証が違う。当面の課題が検索なら、検索や、ほかの取り消し可能な手順から始める。試験を通じて、後でどの抽出項目により厳しい確認が必要かが分かる。
何を検索対象にしたか、アーカイブの画面で分かるようにする。検索結果に機械が生成した文章しか出ないと、もっともらしい記述をそのまま正しいと思うかもしれない。結果の横に原本のファイル名や文書IDを表示し、該当ページを見つけやすくする。抽出結果にレビュー状態があるなら一緒に表示する。使う人が、いつ原本を読む必要があるか判断できる。
共通の出力先に書き込む一括処理では、失敗からの復旧も試せる。一つのファイルで失敗し、設定を変えてそのファイルだけを再実行したとする。ほかの結果が残っているか、二回目の結果を一覧表から特定できるかを確認する。自動再処理の仕組みは不要だ。ある文書の結果を改善しても、ほかのファイルの処理記録が失われないことを確かめる。
どの結果からも原本ページに戻れると、一括処理が役に立つ
MiniCPM-OCR SDKの更新で、ファイルを一つずつ渡す手間が減った。その先はアーカイブの設計で決まる。文書のまとまりを保ち、どこで画像を処理するかを選び、後続の用途に応じて項目ごとの確認の深さを決める。来月、誰かが抽出結果から数値を見つけたとき、その数値があったページを開いて、解析に使った画像を確認できるようにしたい。
出典
- PyPIのMiniCPM-OCR SDK 1.0.5(2026年11月9日)
- OpenBMBのMiniCPM-OCRリポジトリ、モデルカード、公開日程、導入手順
- OpenBMBの公開デモ
- OpenBMBのリリース用イラストとライセンス
文書アーカイブのレビューや判断を検索できる形で残すには、Telli.shアカウントを作成。