同样是 10.0% 的错误率,结论却完全相反:会议转写准确度该怎么测
单词错误率给「not」和「the」打的是同一个分数,所以两份转写稿可以同时落在 10.0%,而其中只有一份能用。这里是完整的测量流程:一段按会议规格搭建的 12 分钟测试音频、一份冻结了归一化规则的参考转写稿、cpWER 与 DER 的确切命令,以及一张只给原始 WER 100 分中 10 分的五维评分卡。
下面是同一句产品会议发言(二十个词)的两份机器转写稿。
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review"(Priya 说 Helios 迁移推迟到第三季度,安全审查之前不要签供应商合同)
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review"(Priya 说 Helios 迁移推迟到第二季度,安全审查之前应该签供应商合同)
对照真正说出口的内容,两份稿子各有整整两处错误。两份都拿到 10.0% 的单词错误率。转写稿 A 丢了两次冠词 "the"。转写稿 B 把截止时间提前了一个季度,并从一句承诺里删掉了 "not"。
如果你的评估流程把这两套系统判为平手,那么问题出在流程,而不是模型。
这篇文章就是我们会直接交给「周五之前选一个转写工具」的那个人的测量流程。它讲清楚单词错误率到底在数什么;为什么这个数字偏偏在会议音频上会误导人;以及一套用两个开源包加一段 12 分钟录音、一个下午就能跑完的五步协议。我们在另一篇文章里论证过转写准确度从来就不是最终交付物。这一篇是它的姊妹篇,不谈论点,只谈方法。
要点速览:
- WER 就是
(substitutions + deletions + insertions) ÷ reference words,每个词的权重完全相同。否定词 "not" 和冠词 "the" 一个价。- 公开榜单已经被压扁了。在 Artificial Analysis 的独立评测榜上(2026 年 8 月 31 日查阅),前五名模型的 AA-WER 落在 1.7% 到 2.6% 之间,这个跨度窄到根本选不出赢家。
- 改成给五个维度加权打分:承重词 30 分、说话人归属 25 分、数字与金额 20 分、分段 15 分、原始 WER 10 分。难的那几项工具早就有了,
cpWER和DER都随 MeetEval 发布,那是为 CHiME 挑战赛打造的工具包。
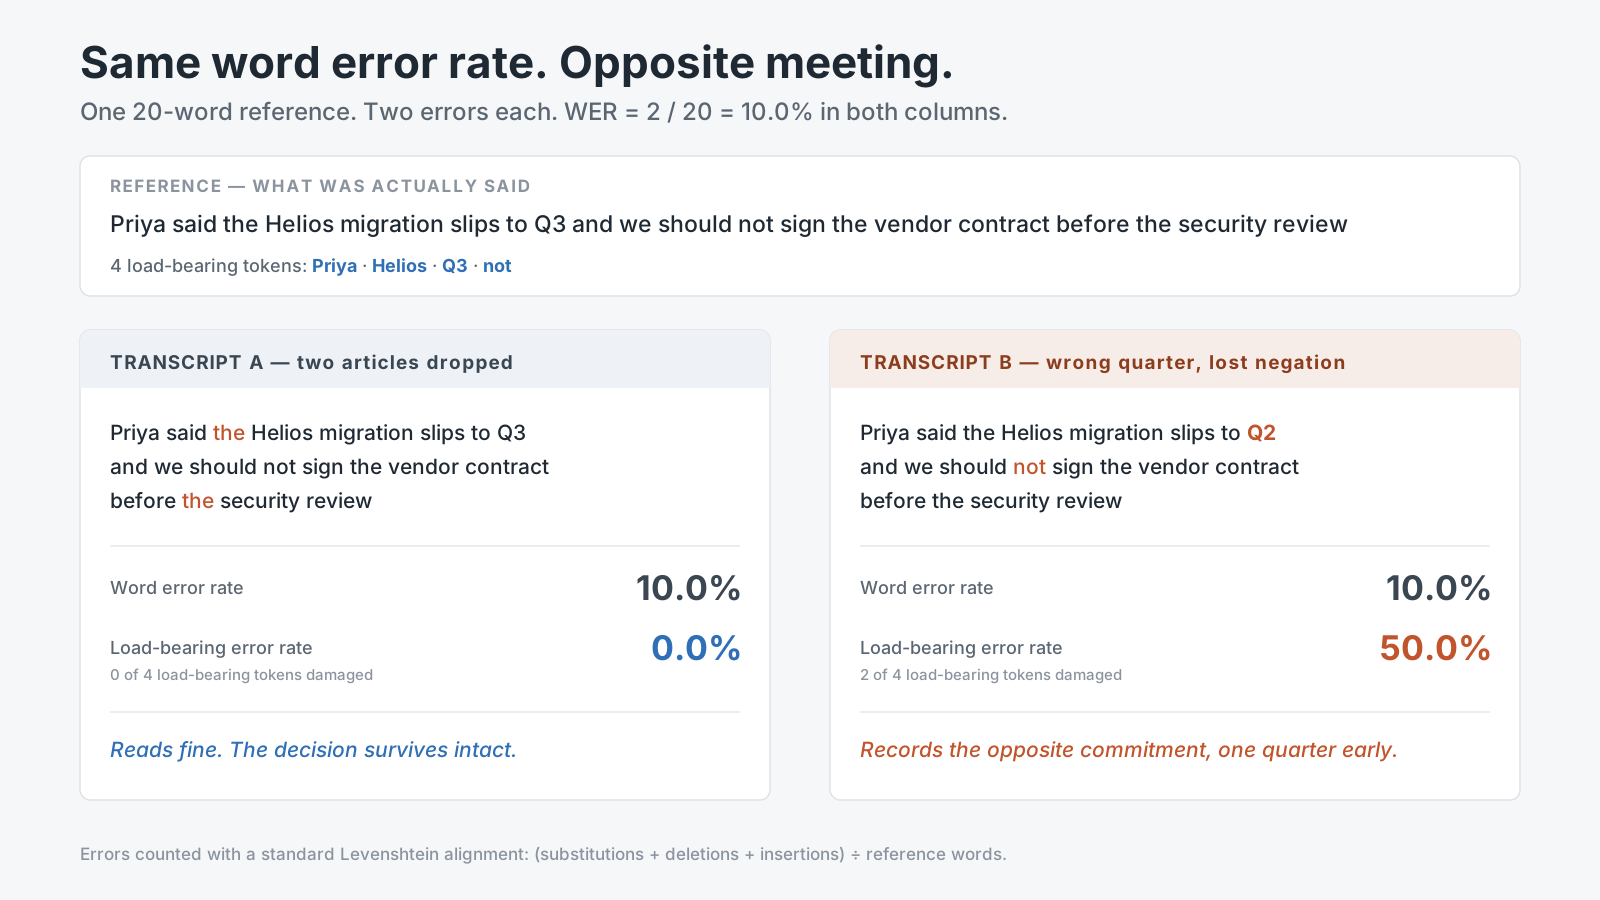
两列相对于 20 词的参考稿都只有两处错误。但只有其中一份,把会议室里真正做出的决定记了下来。
把单词错误率数的东西完整写出来
WER 来自一次对齐。拿出参考转写稿,也就是人类一致认定的原话;再拿出机器的输出。用经典的 Levenshtein 对齐找出把一方变成另一方的最省编辑序列,然后给每一次编辑贴标签:
- 模型写成了另一个词,叫 替换 substitution,比如把 "deploy" 听成了 "delay"。
- 参考稿里的词在输出中找不到对应,叫 删除 deletion。
- 模型造出了一个没人说过的词,叫 插入 insertion。
然后:
WER = (substitutions + deletions + insertions) ÷ reference words
分母是参考稿的长度,不是假设稿的长度。这就是 WER 可以合法地超过 100% 的原因:一个放开幻觉的模型,插入的词数可以比原本存在的词数还多。
下面这个算例直接取自 MeetEval 自己的文档,方便你拿已公开的输出核对。参考稿:"The quick brown fox jumps over the lazy dog",九个词。假设稿:"The kwick brown fox jump over lazy",七个词。对齐找到两处替换(quick→kwick、jumps→jump)和两处删除(the、dog),没有插入。即 (2 + 2 + 0) ÷ 9 = 0.4444,WER 为 44.4%,而 MeetEval 打印出来的正是这一行:ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2)
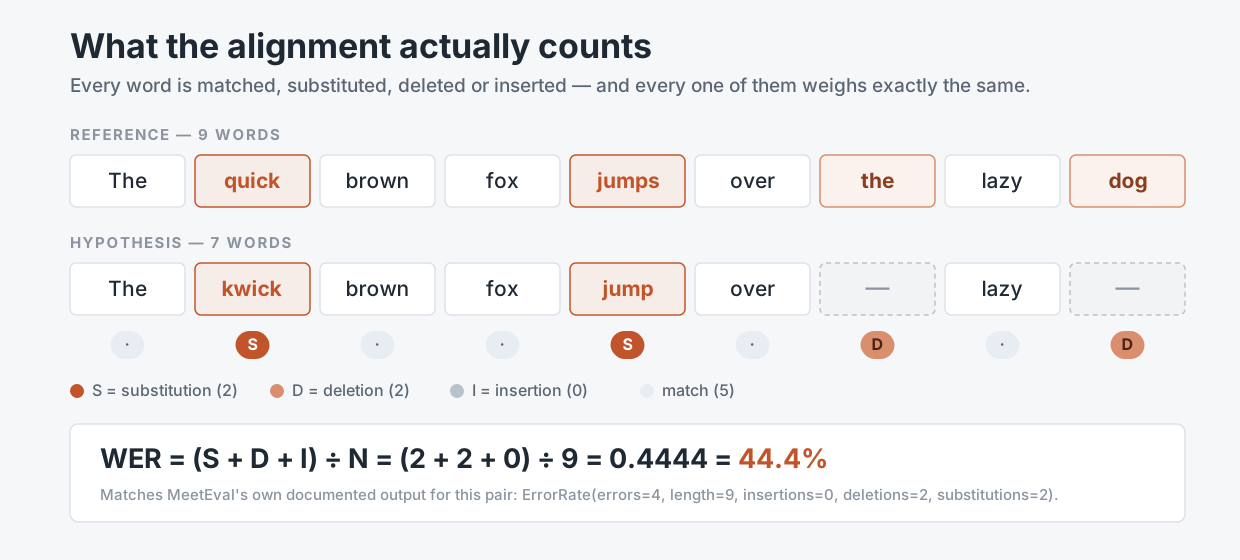
对齐过程是机械的、可复现的。它唯一没做的事,就是加权。来源:MeetEval 文档,2026 年 8 月 31 日查阅。
这个公式有两个性质,比任何厂商落地页上的说辞都重要。第一,它是 扁平的:这个指标完全没有「有些词撑起了整场会议、另一些词只负责语法」的概念。第二,它是 看不见说话人的:标准 WER 把所有内容拼接成一条流,于是一个把每个词都听对、却把其中一半安给了错误的人的系统,照样能交出一份漂亮的分数。
公开数字已经分不出你的候选者了
把榜单拉出来,问题就变成了算术。自己跑评测而不是转载厂商说法的 Artificial Analysis,在 2026 年 8 月 31 日列出的 AA-WER 前五名是:Fun-Realtime-ASR-preview 1.7%、ElevenLabs Scribe v2 2.2%、微软 MAI-Transcribe-1.5 2.4%、Smallest AI Pulse Pro 2.4%、Gemini 3.5 Transcribe 2.6%。开放权重中最好的 Mistral Voxtral Small 是 2.8%。
整个市场头部都挤在 1.1 个百分点的带宽里。 在一场约 6,300 个口语词的 45 分钟会议中,第一名和第五名的差距大约是 57 个词——不到一屏转写稿一个词。
还有第二个问题:基准音频不是你的音频。AA-WER v2 是对约八小时素材按音频时长加权的平均值,素材来自三个来源:AA-AgentTalk 占 50%,VoxPopuli-Cleaned-AA 占 25%,Earnings22-Cleaned-AA 占 25%。议会演讲和财报电话会录得干净、轮流发言,几乎完全不含定义内部会议的那样东西——四个人围着一个只有他们自己听说过的项目互相打断。
针对真正对话式音频的研究,多年来一直把这当成一门单独的学科。2020 年 4 月 20 日由 Watanabe、Mandel、Barker 与另外十八位合著者发表的 CHiME-6 挑战赛,把评测建立在晚宴录音之上,正是因为带重叠、带远场麦克风的自然对话会击垮那些在朗读语音上得分优异的系统。用近讲耳机和远场房间麦克风同步录下 100 小时的 AMI Meeting Corpus,存在的理由也一样。
这里是我们的判断,不加任何缓冲:一个公开的 WER 只能告诉你某家厂商的模型没坏。它没法告诉你该买谁的。
WER 抓得住什么,又在结构上抓不住什么
| 失败形态 | 原始 WER 抓得住吗? | 你为此付出什么 | 真正能测它的指标 |
|---|---|---|---|
| 常见词听错("their"/"there") | 抓得住,满权重 | 几乎没有代价 | WER |
| 语气词和口误被丢掉 | 抓得住,计为删除 | 没有代价——往往还是改进 | WER,但具有误导性 |
| 专有名词被揉碎("Xochitl" → "Societal") | 抓得住,但只值一个词的权重 | 负责人的名字 | 承重词错误率 |
| 数字或日期错了("Q3" → "Q2") | 抓得住,一个词的权重 | 一个被错过的截止日 | 数字准确度,单独计分 |
| 否定词被删掉("should not" → "should") | 抓得住,一个词的权重 | 一个被反转的决定 | 承重词错误率 |
| 词都对,说话人错了 | 抓不住 — WER 看不见说话人 | 没人知道是谁做的承诺 | cpWER、DER |
| 说话人轮次被并成一整块 | 抓不住 | 一堵读不下去的文字墙 | 带 collar 的 tcpWER、人工通读 |
| 句子边界丢失 | 抓不住 — 标点在归一化时被抹掉 | 一份靠猜测结构的摘要 | 分段得分、人工通读 |
| 静音段里凭空幻觉出整段内容 | 部分抓得住 — 计为插入 | 编造的内容被当作记录 | WER 之外单独看插入数 |
决定一份转写稿能不能变成可用会议纪要的,是这张表的下半部分,而标准 WER 一样都看不见。这不是指标的缺陷——WER 精确回答了 1990 年代口述听写研究提出的那个问题。缺陷在于 2026 年还只用它一个。
第一步:做一段像真会议一样运转的 12 分钟音频
不要用厂商的演示文件评估,也不要用你自己八小时的存档评估。你需要的是一段音频:短到能手工转写,密到能把工具压垮。
目标是 12 分钟。按每分钟约 140 词的正常对话语速、约 75% 的说话密度计算,大约能产出 1,260 个参考词——多到足以让 2% 的错误率差异体现为 25 个词而不是统计噪声,又少到两个人一个下午就能仔细转写完。
按规格做,不要凭感觉。我们的规格是:
- 四位以上说话人,其中至少一位通过压缩音频通道远程接入,至少一位在工作语言中带非母语口音。
- 九十秒以上的真实重叠——两个人同时说话、有人替别人把话说完、一声咳嗽压在某个决定上。说话人分离正是在串音处悄悄崩溃的,一段没有串音的音频什么也测不出来。
- 二十五个以上领域术语:产品代号、内部缩写、客户名、与会者姓名。这些词在会议室里每个字符携带的信息量最高,在任何训练语料里的出现频率最低。
- 十五个以上数字:日期、季度、金额、版本号、百分比。故意说得含糊一些,比如在同一分钟里同时出现 "fifteen" 和 "fifty"。
- 三条以上带否定的决定,用自然的说法讲出来:「这个版本我们不上」「合同先放一放」。
- 两路同时录音,条件允许的话——笔记本自带麦克风加上每位说话人的耳机轨。这就是 AMI 语料库的设计思路,它能让你把「模型不行」和「房间太吵」分开。
只录一次。WAV 以 16 kHz 或更高采样率无压缩保存。从此以后你评估的每一个工具,拿到的永远是这同一个文件。
第二步:写出参考稿,然后在打任何分之前冻结归一化规则
参考转写稿是一件测量仪器,而它自带误差棒。Artificial Analysis 之所以专门维护其公开评测集的「清洗版」,正是因为原始参考转写稿里本身就有转写错误;他们的说明毫不含糊——清洗版「移除了参考文本中的转写错误,为模型评估提供更准确的基准真值」。如果连基准运营方都得去订正已公开的真值,你的第一版转写稿同样不是圣经。
所以:两个人各自独立转写,然后逐条比对、消除全部分歧。按两人合计五到八倍实时来做预算,一段 12 分钟的音频大约需要一个工作日的合计工时。这是整套流程中最大的一项成本,而且绕不过去。
接着,在计算任何一个分数 之前 把归一化政策写下来,因为光是这些选择就能让最终数字挪动好几个点:
- 数字:"Q3" 和 "Q three" 算同一个词元吗?"forty thousand" 等于 "40,000" 吗?
- 缩写形式:"we're" 匹配 "we are" 吗?
- 语气词:"um"、"uh" 和口误到底进不进参考稿?进了的话计不计分?
- 大小写和标点:通常在打分前被剥掉——这意味着一个标点打得极漂亮的工具在这里拿不到任何加分,你必须在第三步里单独给它计分。
把结果存成 SegLST,也就是 CHiME 挑战赛使用、同时也是 MeetEval 默认的 JSON 格式:每个片段一个对象,包含 session_id、words、speaker、start_time 和 end_time。正是说话人字段和时间字段让说话人感知类指标成为可能,而事后回头补这些字段是件很痛苦的事。
第三步:给五个维度打分,原始 WER 只占一百分里的十分
装好工具——pip install jiwer meeteval——在同一段音频上逐项打分。JiWER 用 RapidFuzz 的最小编辑距离实现,计算 WER 以及匹配错误率、词信息丢失、词信息保留和字符错误率。会议专属的那些指标由 MeetEval 负责。
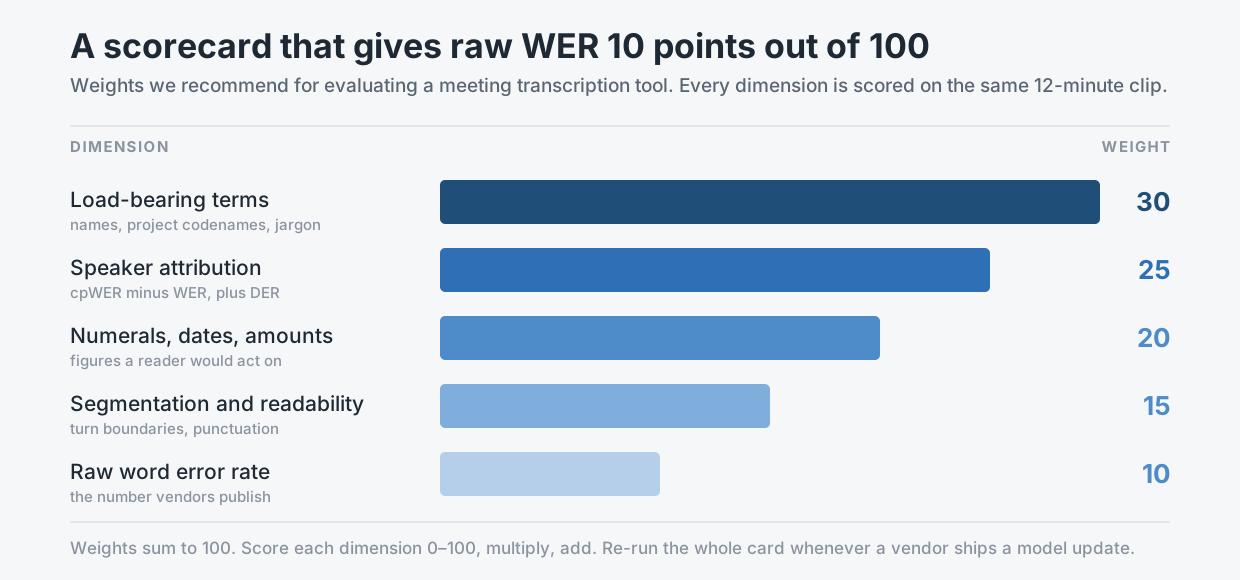
我们推荐的权重。每家厂商都在宣传的那个维度,恰好是分值最低的那个。
承重词 — 30 分。 把参考稿里的每一个专有名词、代号和领域行话都标出来,然后只对这些词元跑同一个 WER 公式。我们把这个结果叫做 承重词错误率,它是整套练习中预测力最强的单一数字。在本文开头那两份转写稿里,承重词元有四个:Priya、Helios、Q3 和 not。转写稿 A 一个都没有损坏:0.0%。转写稿 B 损坏了两个:50.0%。整体 WER 同样是 10.0%,但在真正要紧的指标上拉开了五十个百分点。
说话人归属 — 25 分。 运行 meeteval-wer cpwer -r ref.stm -h hyp.stm。拼接最小排列 WER 会在参考说话人和假设说话人之间找出最佳映射,把每位说话人的词拼接起来再打分——于是安错了人的词就变成了错误。然后做减法:cpWER 减去普通 WER 就是归属缺口,也就是纯粹因为不知道谁在说话而造成的那部分损失。再加上说话人分离错误率来补上时间视角;DER 是说话人错误、误报语音和漏检语音三者占计分时长的百分比之和,定义见 NIST RT-09 评测方案第 6.1 节,实现在 dscore 里,而 MeetEval 对它做了封装、它读取 RTTM 文件。如果你的候选工具支持时间戳,就用 tcpwer --collar 5 而不是 cpwer,这样一个贴错了时刻的正确词才不会被悄悄放过。
数字、日期与金额 — 20 分。 从参考稿中抽出每一个数字词元,按你写下来的归一化政策处理后,与假设稿做精确匹配打分。结果请报成朴素的分数形式——「15 个里对了 13 个」——而不是百分比,因为样本量很小,百分比会暗示一种你并不具备的精度。
分段与可读性 — 15 分。 这一项靠人。找两位没参加过那场会议的读者通读原始输出,按每分钟标记:位置错误的句子边界、被并成一整块的说话人轮次,以及需要回读才能懂的段落。标点在 WER 计算中已经被归一化掉了,所以这里是它唯一被打分的地方。
原始单词错误率 — 10 分。 跑 jiwer,把数字记下来。它是一次货真价实的底线检查:在干净的近讲音频上如果超过大约 12%,说明存在值得深挖的真实声学问题。越过这条底线之后,它几乎区分不出任何东西——这正是它值十分而不是八十分的原因。
每个维度按 0–100 打分,乘以权重后相加。得到的结果在不同工具之间、不同时间之间都可比,而这正是全部意义所在。
第四步:让每个候选跑完全相同的文件,并写下「相同」到底指什么
这一步是团队最爱跳过的,而跳过它会让上游所有工作作废。
同一个 WAV、同一个采样率,候选之间不做任何重新编码。同一份参考稿,同一套归一化政策,由同一个脚本执行。每个工具的说话人分离要么明确开启、要么明确关闭,并且无论哪种都要记录下来——关掉分离评估的工具,和开着分离评估的工具不具备可比性。关键词或实体偏置在第一轮关闭、第二轮开启,两轮都记录;微软报告称,给 MAI-Transcribe-1.5 提供关键词列表最多可让 WER 下降 30%,这个幅度大到足以让一次混杂了有偏置和无偏置运行的比较彻底失去意义。
尤其要盯住长音频的处理方式。Artificial Analysis 不得不把 Earnings22 的音频切成约九分钟一段,以适配那些无法稳定处理完整长度输入的模型;对限制更严的模型则切到约 30 秒——他们自己公布的说明点了名:GPT-4o Mini Transcribe、Amazon Nova 2 Pro、NVIDIA Canary Qwen 2.5B 和阿里巴巴的 Qwen3 ASR Flash 都在其列。切块会改变结果,因为错误会在边界处聚集。如果某家厂商切了你的文件,那是这个产品的属性,应该写进评分卡,而不是当作需要被修正掉的人工痕迹。
最后,记录每一次运行的确切模型版本字符串和日期。「Whisper large-v3」不是版本号;whisper-large-v3, run 2026-08-31 才是。
第五步:在厂商发版时重跑评分卡,而不是在你想起来的时候
托管的语音模型会在你脚下悄悄变化。端点名保持不变,背后的权重却不是;而当你的会议纪要在专有名词上变差了一点点时,没有人会发邮件通知你。
有三个触发条件应当让你在第一步做的那段音频上重跑整张评分卡:
- 厂商发布了变更日志,涉及模型、说话人分离器,或者标点与格式化层。
- 日历周期到了——对大多数团队来说每季度足够;如果转写输出会流向任何下游自动化流程,就改成每月。
- 你的承重词错误率在任意两次运行之间波动超过 5 个百分点,这时应该先触发一次调查,而不是先触发一次迁移。
把每一次运行都留在同一张表里:日期、模型版本字符串、五个维度的分数、加权总分。跑上三四次之后,你就拥有了任何榜单都给不了你的东西——某个具体产品在听起来像你真实会议的音频上的表现时间线。
结论:准确度是对你会议室的测量,而不是模型的属性
单词错误率是某个模型在某个语料库上的属性。你真正需要的,是这个模型 在你的音频上、面对你的词汇、听着你的同事互相打断 时的属性——而这个量在你测出来之前根本不存在。没有人能替你发布它,因为别人的参考转写稿里没有你的代号。
好消息是,这次测量很便宜。一段 12 分钟的录音、一个工作日的仔细转写、两条 pip 安装命令,以及一张一页装得下的评分卡。昂贵的那个方案,恰恰是大多数团队默认会选的:照着一个公开的百分比做决定,然后在六个月后才发现差别——在一份写着「团队同意了它其实明确拒绝过的事」的会议纪要里。
你更愿意在哪件事上出错:一个小数位,还是一个决定?
Telli.sh 的位置: 我们做的正是这张评分卡真正加权的那几层。Telli.sh 在语音识别之上运行说话人分离、分段、精修与摘要,翻译覆盖 44 种目标语言,界面提供 15 种语言,因为那张卡上不属于原始 WER 的 90 分,才是一份转写稿变成一份有人能据此行动的纪要的地方。如果你想要的是一个真实数据点而不是一个基准分数,就把你自己的 12 分钟音频丢进来,再用上面的流程给结果打分。
来源
- MeetEval — 会议转写评测工具包 — cpWER、tcpWER、ORC-WER、MIMO-WER 与 DI-cpWER 命令,SegLST 格式,以及
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2)算例,2026 年 8 月 31 日查阅 - JiWER — 语音识别评测包 — 基于 RapidFuzz 最小编辑距离的 WER、MER、WIL、WIP 与 CER
- dscore — 说话人分离评分工具 — 依据 NIST RT-09 评测方案第 6.1 节,DER 等于说话人错误加误报语音加漏检语音
- Artificial Analysis 语音转文字榜单 — AA-WER v2 方法论(约八小时,由 AA-AgentTalk 50%、VoxPopuli-Cleaned-AA 25%、Earnings22-Cleaned-AA 25% 组成)、前五名模型数据、清洗参考稿说明以及 Earnings22 切块说明,均于 2026 年 8 月 31 日查阅
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249),2020 年 4 月 20 日 — 已分段与未分段的多说话人赛道,以及晚宴录音的设计思路
- The AMI Meeting Corpus — 100 小时会议录音,由同步的近讲与远场麦克风采集
- Azure Speech 中的 MAI-Transcribe — Microsoft Learn — 关键词偏置及已记录的限制
- 我们此前那篇关于转写准确度从来就不是最终交付物的文章