Anthropic 将为 Claude 文字添加水印——从 1,922 起判决看它的局限
Claude 文本水印能识别模型可能参与过,却不能核实事实是否准确。本文说明检测的局限、错误指控的风险,以及 1,922 起已记录幻觉案例如何揭示来源与真相的区别。
2026 年 8 月 14 日,Anthropic 解释了未来 Claude 模型中的文本水印将如何工作。FAQ 将其与欧盟《人工智能法案》的透明度要求联系起来,该要求从 8 月 2 日起开始适用。FAQ 发布时已推出的模型将在过渡期内更新;这项公告并不意味着每条 Claude 回复现在都已带有水印。
这个思路的价值在于:信号藏在模型的用词选择中。在适当条件下,它有助于识别模型可能参与过,同时不改变读者看到的文本外观。
当生成文本中出现虚构证据时,这一区别尤为重要。下文讨论的一份公开数据库快照记录了 1,922 起 涉及 AI 幻觉内容的法院案件。这些案件不是水印检测测试,也无法证明任何特定检测器是否能识别出相关文本。它们揭示的是另一个问题:来源信号不能证明所引判例、研究或事实确实存在。理解这道界限,才能更好地使用水印结果,也避免误用。
速览
- 它并没有往文字里添加东西。 秘钥改变的是词语选择背后的随机性,不是可见格式。Anthropic 计划全球推广,旧模型会逐步加入。
- 命中是弱证据,未命中几乎不是证据。 Anthropic 自己说,这个标记无法区分"Claude 写了这个"和"Claude 大幅修改了这个",在短文本、代码和纯事实段落里很弱,重写一遍就会抹掉。2024 年研究者证明,不到 50 美元就能既抹掉这些标记,也能把它们伪造到人写的文字上。
- 来源不等于核实。 检测结果可以表明模型可能参与过,却不能核实文本中提到的判例、引文或书籍。
图片:Jon Rawlinson, Wikimedia Commons, CC BY 2.0。一整页真实性标记。每一枚都证明有人越过了一道边境。没有一枚对这位旅行者是否说了实话发表过任何意见。
Anthropic 到底改了什么,又没改什么
先说机制,因为后面几乎所有误解都源于这一步搞错。
语言模型写作时一次吐一个词,而在大多数位置上正确答案并不唯一。"这次会议很 有成效"和"这次会议很 有用"都说得通。模型手里有一份可接受的下一个词的清单,然后用一次随机抽取来挑一个。同一个提示词问两遍会得到略有差别的答案,原因就在这里。
文本水印把这次随机抽取换成由密钥驱动的 伪 随机抽取。模型依然只在它认为同样好的词里挑,所以质量不受影响。但几百个词累积下来,每次是哪个词胜出的模式就不再像巧合了,握有密钥的一方可以把它测出来。
没有隐藏字符,也没有可移除的文本元数据。信号来自用词选择;Anthropic 表示不会增加 token,对速度的影响也极小。其发布政策面向全球而非按地区区分,但具体覆盖哪些模型仍取决于 rollout 进度。仅凭这项政策,无法断定某条特定回复已经带有水印。
这不是什么新科学。Scott Aaronson 在 2022 年提出了这一思路,Kirchenbauer 等人在 2023 年 ICML 上发表了可用方案,Google DeepMind 于 2024 年 10 月在 Nature 上发表了 SynthID-Text,Anthropic 的实现是它的一个版本。Google 从 2024 年起就在 Gemini 里运行它,报告称约 2,000 万次真实响应中未检测到质量差异,此后声称已为超过 100 亿条内容加了水印。
更新,2026 年 10 月 12 日: Anthropic 9 月 1 日更新的 FAQ 介绍了面向符合条件组织的检测 API 私有预览,并计划扩大访问范围。这一更新取代了 8 月原稿中「API 即将推出」的状态。水印估计的是 Claude 是否参与,不会核实文字是否属实。
标记扛得住复制粘贴,扛不住重写
信号藏在 哪些词被选中 这件事里。所以凡是保留词语选择的操作都会保留标记,凡是替换词语的操作都会毁掉它。Anthropic 把上限说得很直白:"逐词替换的彻底重写会" 移除它。不过有两种情况打破了这个规律,也最容易让人栽跟头。
短文本和事实性文本几乎承载不了什么。 水印需要有选择可以藏身。一两句话凑不出足以成形的决策数量,而高度事实性的内容可能根本没有选择余地——Anthropic 举的例子很到位:在"牛顿的 Principia"之后,下一个词只能是"Mathematica",任何密钥都插不上嘴。同理,语法决定了大部分词元的代码也很弱,模型改动词语太少的校对同样如此。
翻译会带上完整的水印。 这一条反直觉。让 Claude 把一份文档译成日文,那段日文是 Claude 重新逐词生成 的,带着一贯的选择自由,所以哪怕原文是没有标记的人类文字,译文也会被完整打上标记。这看起来和 DeepMind 研究者在 Nature 中的说法正好相反——他们指出,把已带水印的文本译成另一种语言会大幅降低检测置信度。两者都对,因为场景不同:在 外部 翻译已带标记的文本会把标记冲淡,而让模型 亲自 翻译则会盖上一枚新的。
| 你对文本做的事 | 标记还在吗 |
|---|---|
| 复制粘贴到任何地方 | 在——本来就没有任何东西是粘贴能剥掉的 |
| 轻度编辑:改错字、改标题、删段落 | 在——绝大多数词语选择没动 |
| 让模型来翻译 | 在——译文是新生成的,因此被完整标记 |
| 用自己的话大幅改写 | 不在——你替换掉了承载信号的那些选择 |
| 逐词替换的彻底重写 | 不在——Anthropic 明确表示会被移除 |
| 一两句话的短摘录 | 几乎没有——可供成形的选择太少 |
| 代码,或纯事实段落 | 很弱——语法和事实没给模型留下自由 |
| 让模型校对你自己的草稿 | 几乎没有——改动的词太少 |
存活情况依据 Anthropic 于 2026 年 8 月 14 日发布的 FAQ,以及 2024 年 10 月 Nature 上 SynthID-Text 论文作者的表述。
命中是弱证据,未命中几乎不是证据
如果检测器返回了结果,你能合理得出什么结论?
如果结果为阳性,能得出的结论是该厂商的模型可能参与了这段文字。仅此而已。Anthropic 明确表示,这个标记 无法区分"Claude 写了这段文字"和"Claude 大幅修改了这段文字",也不能说明其中任何主张是否属实。它也无法识别 其他 AI 写的文字,因为它只认自己的密钥。
阴性结果同样几乎不能说明什么。阴性不能证明文字是人写的。
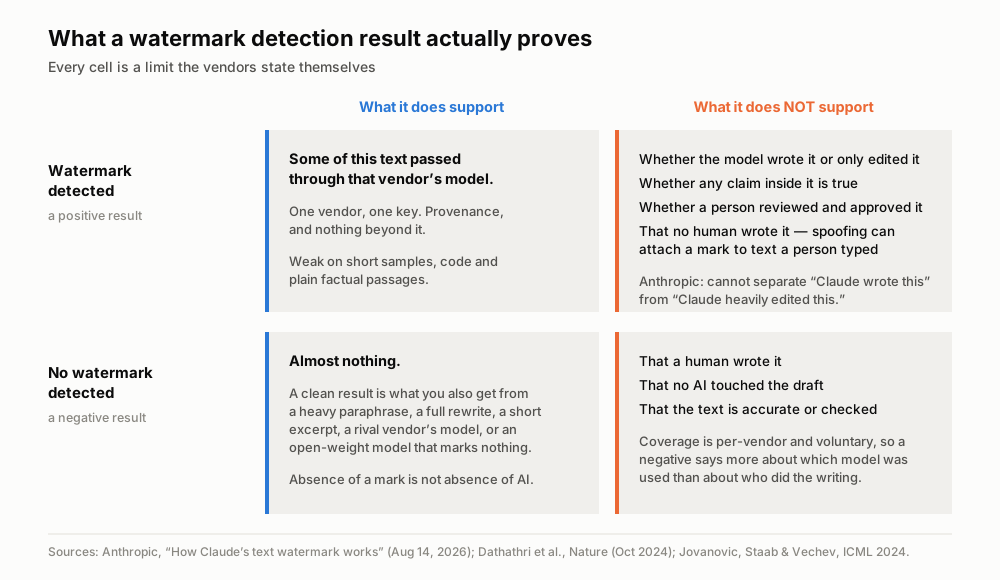
这里的每一格都是厂商自己公布的限制。来源:Anthropic 水印 FAQ(2026 年 8 月 14 日发布,9 月 1 日更新);Dathathri 等,Nature(2024 年 10 月);Jovanović、Staab 与 Vechev,ICML 2024。
没人做预算的那种攻击,方向是反的
抹除是人人都会想到的风险:有人把 AI 文字洗一遍以掩盖出处。这没错。但还有第二种箭头指向相反的攻击,而真正该让你担心的是它。
伪造 指的是让 人类 写的文字带上别人的水印。没人在隐藏什么,他们是在栽赃。目标要么是随后被指控使用 AI 的个人,要么是被扣上从未产出过的内容的厂商。
在 2024 年 ICML 上,Jovanović、Staab 与 Vechev 针对最先进的方案演示了这两种攻击,成功率超过 80%,算力成本不到 50 美元。DeepMind 的作者在自己的 Nature 论文里也承认了同一点:水印 "并不提供完整的解决方案",它的存在需要模型提供者配合,对任何人都能原样运行的开放权重模型无法强制,而且"易受窃取、伪造和抹除攻击"。最后这一句就是整个论点,还是造出这项技术的团队自己写下的。
早期 AI 检测器错把学生判成了 AI 使用者
检测工具早就存在,而它是另一种技术,还留下了一串有据可查的伤害记录。水印 是模型所有者在生成时用密钥植入的。分类器 则是第三方事后根据文字本身的特征来猜的:词语选择有多可预测,词汇有多丰富。前者知道一些东西,后者只是在对文风做模式匹配。这是测量与画像的区别。
OpenAI 于 2023 年 1 月 31 日推出 AI 文本分类器,同年 7 月 20 日又 "因准确率过低" 将其下线。按它自己的数字:只抓出了 26% 的 AI 文本,却把 9% 的人类文本错误标记。
随后在 2023 年 7 月,Liang 等人在 Patterns 上发表了本该终结这一品类的结果。他们把七款检测器用在英语非母语者写的托福作文上,平均误报率高达 61.3%;其中一款把这些作文的 97.8% 判为机器所写。而当他们提示用更丰富的词汇重写同一批作文时,误报率降到了 11.6%。这些检测器从来就不是在衡量作者身份,它们衡量的是流利度,惩罚的是英语更朴素的人。
范德堡大学于 2023 年 8 月 16 日停用了 Turnitin 的 AI 检测器。校方的说明给出了一个假设性计算:如果把声称的 1% 误报率应用于每年约 75,000 份提交的论文,可能会有约 750 份论文被错误标记。这是风险估算,并非实际遭到错误指控的学生人数。范德堡大学公告。
水印检测检查的是特定生成模式,而不是从文字风格推断作者身份。结果仍然是概率性的,短文本或经过大量编辑的文本可能无法得出结论。关于模型参与的结果不应变成对某个具体人物的指控;有关伪造的研究也说明,仅靠检测无法确定作者身份。
监管比工具先到
这一切挤在两周内发生,是因为立法者先动了手。
欧盟《人工智能法案》把义务分成两半。第 50 条第 2 款 约束提供者:造出生成式系统的一方,必须以机器可读的方式标记其输出,文本也包括在内。第 50 条第 4 款 约束使用者:发布 "就公共利益事项向公众提供信息" 的 AI 生成文本的部署者,必须予以披露。
而第二款带着一条豁免,对大多数读者来说,那正是整套制度的实际核心。若该内容 经过人工审阅或编辑把关,且有人对其承担编辑责任,此项义务不适用。请读两遍。欧洲对 AI 生成文本的答案不是一个检测器,而是一个审阅过它、并为之负责的、有名有姓的人。
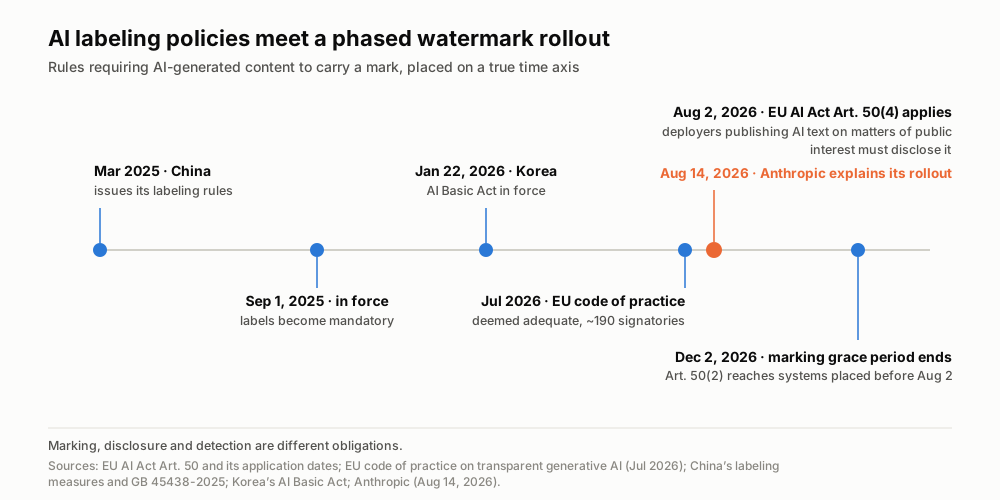
标识义务按时间表如约而至,可用的检测手段没有。来源:欧盟人工智能法案及其适用日期、欧盟透明度行为准则(2026 年 7 月)、中国的标识办法与 GB 45438-2025、韩国人工智能基本法,以及 Anthropic 的公告。
欧盟委员会将透明度行为准则描述为自愿合规框架,而非法律的替代品;截至 2026 年 7 月底,约有 190 个组织签署。委员会 FAQ 为 8 月 2 日前投放市场的系统规定了截至 2026 年 12 月 2 日的过渡期。关键在于,签署方的实施安排与法律义务不能混为一谈。欧盟委员会概览、欧盟委员会 FAQ。
其他地区采用不同的规则。中国的标识办法于 2025 年 9 月 1 日生效,GB 45438-2025 标准要求可见和嵌入式标识。韩国《人工智能基本法》于 2026 年 1 月 22 日生效。评估合规情况时,应查看适用的司法辖区和内容类型,而不是假设存在一套统一的全球标识规则。
这里还该放上另一处缺席。华尔街日报 在 2024 年报道称,OpenAI 已经做出了一套内部描述为准确率约 99.9% 的文本水印方法。这应当被当作报道而非事实:该数字从未经过独立验证,而 OpenAI 从未上线过文本标记。它自己 2026 年 6 月 11 日那篇关于欧盟合规的文章只涉及图像来源标识,并用自己的话承认了普遍限制——"元数据可以被移除,水印会衰减。"
水印无法核实幻觉引用是否真实
Damien Charlotin 维护着一个公开数据库,收录全球法官不得不处理含 AI 幻觉内容的判决。2026 年 8 月 16 日抓取时,它停在 1,922 起。轨迹是这样的:2025 年年中约 200 起,2026 年 1 月 719 起,4 月 1,227 起,6 月 9 日 1,598 起,今天 1,922 起——仅最近十周就增加了 324 起。
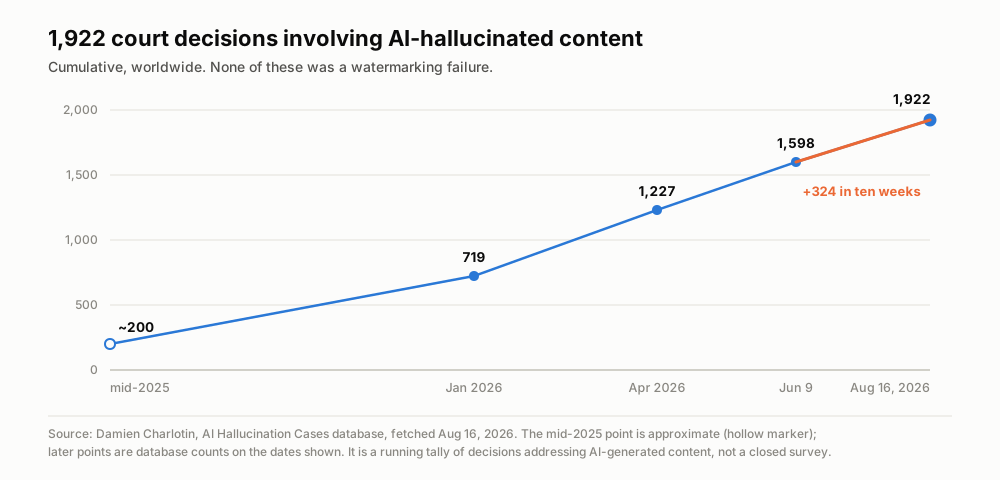
这些案例记录的是幻觉,并非经过测试的水印结果。来源标记无法核实其中事实主张。来源:Damien Charlotin 的 AI 幻觉案例数据库,2026 年 8 月 16 日抓取。
原型是 2023 年 6 月 22 日纽约南区联邦地区法院判决的 Mata 诉 Avianca 案:一份引用了六个并不存在的司法判决的诉状,以及 5,000 美元的制裁。
但最该被掂量的例子属于 Anthropic 自己。2025 年 5 月,在 Concord Music 诉 Anthropic 案中,该公司自己的律师提交了一份专家声明,其中引用了一项 Claude 编造出来的研究。人工核对没有发现,代理律师向法庭致歉。如今上线文本水印的这家公司,自己就栽在了对模型输出的不加批判的引用上——用的是自家模型,发生在自家诉讼中,还经过了自家律师的审阅。即使检测结果为阳性,也无法证明被引用的研究是否存在。
它也超出了法庭。德勤澳大利亚在 2025 年 10 月同意为一份 44 万澳元的政府报告部分退款,该报告含有不存在的参考文献和一段伪造的判决书引语。2025 年 5 月 18 日,芝加哥太阳时报 与 费城询问报 刊登了一份联合供稿的暑期书单,十五本书里只有五本是真的。Liang 等人在 arXiv:2404.01268 中分析了 950,965 篇论文,发现经 LLM 改动的内容在计算机科学摘要中最高达到 17.5%,而在数学和 Nature 系刊物中不超过 6.3%。
体量问题同样需要一个诚实的数字,而不是一个吓人的数字。2025 年 10 月发布的 Graphite 对 Common Crawl 的分析发现,2025 年 5 月抽样的新文章中约 51.7% 由 AI 撰写。而报道此事的 Axios 补上的那句限定语才是关键:这一比例并没有继续攀升,而是 在对半开附近趋于平稳。这不是洪水,这是新的常态。
重点来了。这份清单上没有一项是水印的失败。在每一起案子里,来源从来都不是争议点——所有人都知道有模型参与,或者一听就会接受。失败的是没有人去打开那条引注,核对那个判例、那项研究、那本书是否真的存在。
结论:来源不等于核实
不妨叫它 邮戳谬误。邮戳能证明是哪个邮局经手了这封信,却从来没有对信里的内容是否属实发表过看法。我们刚刚投入了大量工程努力,造出了一枚非常好的邮戳,而一部分公共讨论正准备把它当成事实核查员。
请同时记住三点。阳性检测表明模型可能参与过,不代表作者身份或事实真伪。阴性结果也不能证明文字由人撰写。覆盖范围取决于提供方、其密钥以及使用该水印的模型,并非普遍适用。Anthropic 更新后的私有预览 API 也设有资格条件,并非所有人都能不受限制地使用。
真正经得起推敲的不是输出上的一枚标记,而是一份你可以从源头重新推导出来的记录:一段仍然存在的录音,一份可以随时跳回那个时刻的带时间戳的转写,一句归属到真正说了它的那个人的话,一条能追到你可以亲手打开的原始文件的依据。我们在谈 实时翻译时说过,可复核的笔记比流畅的输出更重要,也在谈 警方讯问转写时说过,记录必须在有人提出异议时站得住。水印时代没有改变这个论点,而是让它更锋利:一旦标记变得普遍,"有 AI 参与"这句话就不再能区分任何东西。
水印回答的是文字从哪里来。回答它是否属实的那个东西,还没有人造出来,因为那个东西不是检测器,而是一个你可以回头去查的源头。
Telli.sh 的位置: 我们做的正是那个可以回头去查的源头。Telli.sh 记录会议,生成区分发言人的带时间戳转写,并把摘要锚定在它所依据的音频上——所以笔记里的任何一行,几个月后都能追回到某人说出它的那一秒。这不是在宣称能检测 AI,这是问题的另一半:当摘要断言了什么,你可以拿它去和录音对照,而不必只信那句话。
来源
- Anthropic, "How Claude's text watermark works"(2026 年 8 月)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature(2024 年 10 月)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns(2023 年 7 月)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, AI 幻觉案例数据库
- 欧盟委员会,人工智能法案第 50 条:透明度义务
- Wikimedia Commons 图片页面
