Llama Windows:ターミナル設定なしで始めるローカルAIチャット
Llama Windowsを安全にインストールし、PCに合うGGUFモデルを選び、実用的なプロンプトを3つ試しましょう。サーバーを外部に公開せず、ローカルAPIに接続する方法も紹介します。
ローカルAIで最初に試すタスクは、小さくしましょう。架空の会議メモ6件を、アクション項目3つにまとめるような作業です。推論エンジンをコンパイルしたり、起動フラグをいくつも推測したり、PCで回答できるか確かめるためだけに個人文書をアップロードしたりする必要はありません。
Llama Windowsは、Hugging Faceが2026年10月13日に発表した、Windowsのシステムトレイアプリです。llama.cppランタイムをアプリの背後で動かし、モデルの検索とダウンロードを支援して、ローカルチャット画面と他のアプリ向けAPIを提供します。名前はアプリを指しており、MetaのLlamaモデルだけに限定されるわけではありません。提供開始の発表
このガイドでは、安全なインストール、無理のない最初のモデル、自分で確認できる最初の会話まで進めます。続いて、役立つ3つの作業と、任意のローカルAPIリクエストを扱います。まずは公開情報か作り物の文章を使い、ワークフロー全体を理解してから機密情報を扱いましょう。
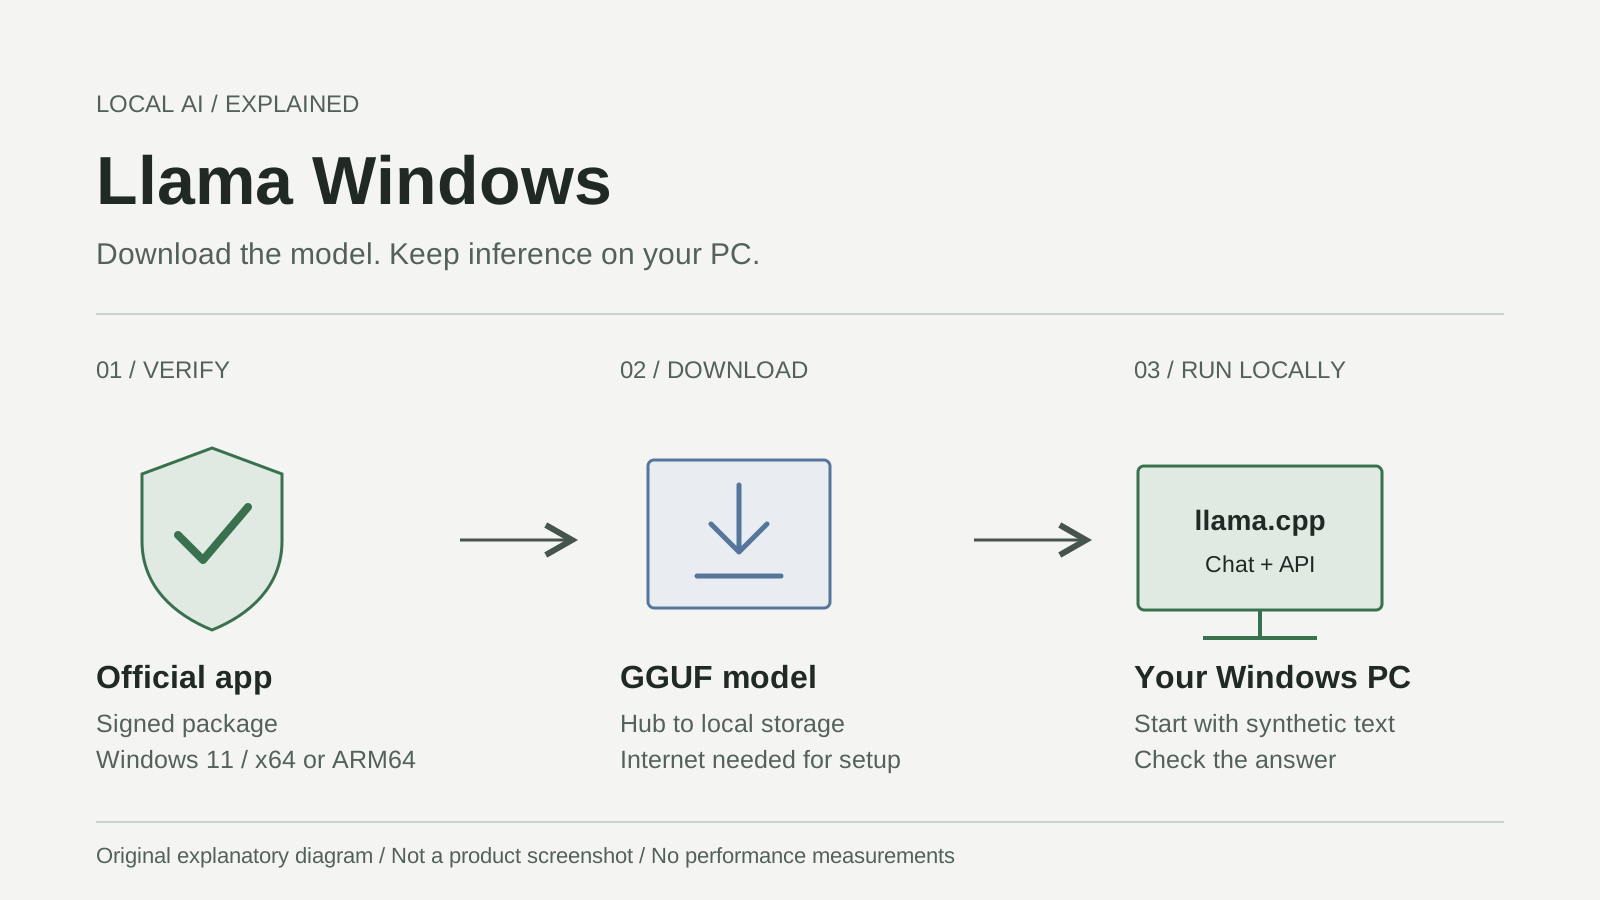
オリジナルの解説画像であり、製品のスクリーンショットではありません。セットアップ時のダウンロードとローカル推論は別の段階です。Windows公式インストールガイドに基づいています。
モデルを選ぶ前に、Windowsのビルドを確認しましょう
10月20日時点で確認した最新のWindowsリリースはv0.12.0です。パッケージマニフェストの要件はWindows.Desktop 10.0.26100.0以降です。ビルド26100はWindows 11バージョン24H2に相当します。インストール条件を満たす最古のバージョンではなく、現在サポートされているWindowsリリースを使いましょう。リリース、リリースマニフェスト、Microsoftのリリース情報
Windowsの検索からwinverを実行すると、ビルドを確認できます。Windowsの設定でシステム > バージョン情報を開き、システムの種類と搭載RAMを調べましょう。公式の.msixbundleにはx64とARM64のビルドが含まれています。Intel/AMD搭載の一般的なWindows PCではx64、Arm版WindowsではARM64を使います。バンドルがアーキテクチャを選択します。現在のリリースには32ビットx86版のパッケージはありません。Windowsリポジトリ、バンドルのパッケージ設定
Windowsのインストール文書には、RAM、VRAM、専用GPUについて一律の最低要件は明記されていません。必要量はモデルとコンテキストによって変わります。llama.cppはCPU推論と複数のGPUバックエンドに対応していますが、すべてのPCで同じように高速化されるという保証ではありません。特定のRTX Sparkは必要ありません。llama.cppの機能
Macでは、llama.appの別項目であるMac版をダウンロードを選びます。Windowsのバンドルを入れたり、Windows用ドライバーの手順を流用したりしないでください。サイトにあるMacアプリの容量も、Windowsインストーラーの要件ではありません。
Windowsのセキュリティを弱めず、署名済みアプリをインストールします
通常のパッケージ版は、何かをコンパイルしたり.NET SDKを入れたりする必要はありません。ソースからのビルド要件は開発者向けであり、最初のチャット手順には関係ありません。公式インストール文書
- llama.appを開いてDownload for Windows 11を選ぶか、リポジトリのReleasesリンクへ進みます。よく似た名前のダウンロードサイトではなく、
ggml-org/Llama-Windowsのリリースであることを確認してください。 - GitHubのソースコードアーカイブではなく、最新の
.msixbundleを選びます。確認対象のリリースのファイル名はLlamaApp-v0.12.0.msixbundleです。インストール中もリリースページを開いておきましょう。 - Windows App Installerでバンドルを開きます。Installを選択する前に、発行元と署名情報を確認してください。v0.12.0のマニフェストでは署名IDはHugging Face、発行元の表示名はMorgan Funtowiczです。見覚えのある表示名だけでは署名を検証したことになりません。Windowsがパッケージの署名を信頼する必要があります。パッケージID
- Windowsが不明な発行元、無効な署名、組織による制限を警告した場合は中止します。公式ファイルを確認し直し、Microsoft経由でWindowsまたはApp Installerを更新するか、管理者に相談してください。インストールを強行するためにDefenderやSmartScreenを無効化したり、実行ポリシーを回避したり、見知らぬ証明書をインポートしたりしないでください。Microsoft App Installerのトラブルシューティング
- Llamaを起動し、時計の横にある通知領域でアイコンを探します。必要なら隠れているアイコンを表示してください。不足している場合、アプリは管理対象のllama.cppランタイムをインストールするため、初回起動時にインターネット接続が必要になることがあります。Windowsのダウンロード手順、ランタイムのセットアップ
ネットワーク共有設定は変更しないでください。v0.12.0では、サーバーアドレスはSettings > Llama > Listen Onで指定します。既定値はlocalhostです。最初のチャットに、受信ネットワークの例外や、他のPCから到達できるアドレスは必要ありません。リリースのセキュリティ情報
ディスクに収まるモデルでも、メモリに収まるとは限りません
GGUFは、llama.cppなどの推論エンジン向けに、重みとメタデータを格納するモデルファイル形式です。チャットボットのブランド名でも品質評価でもありません。会話には指示調整済みまたはチャット用のモデルが適しています。ベースモデルとは用途が違います。ダウンロード数だけで選ばず、モデルカードを読みましょう。Hugging Face GGUF文書、モデルカードのガイド
パラメーター数は、モデルが学習した数値の数を表します。3Bはおよそ30億パラメーターであって、3GBのダウンロードという意味ではありません。量子化すると、それらの値をより少ない容量で保存できます。Q4_K_MやQ8_0のような名前は量子化方式の違いで、アプリのバージョンではありません。精度を下げると、品質や速度との兼ね合いはモデルやハードウェアによって異なりますが、ストレージとメモリを節約できます。常に最速または最良の選択になるわけではありません。llama.cpp量子化ガイド
次の4つの容量を分けて考えましょう。
| 項目 | 見積もる対象 | 初心者向けの判断 |
|---|---|---|
| ディスク容量 | ダウンロードしたモデル、ランタイム、一時ファイル | ダウンロード前に保存先ドライブを確認する |
| システムRAM | Windows、他のアプリ、モデルデータ、ランタイムの作業領域 | 普段のPC利用に必要な余裕を残す |
| GPU VRAM | 専用GPUに割り当てる作業 | システムRAMと同じものとして扱わない |
| コンテキスト | 指示、会話、生成結果を保持するトークン | 最大値ではなく短い設定から始める |
コンテキストは会話の作業机です。机が広いほど多くの資料を置けますが、その分メモリも使います。トークンはテキストのまとまりで、一定の単語数に相当するわけではありません。言語やコードによって分割のされ方も変わります。割り当てが必要なのはモデルの重みだけではなく、キー・バリューキャッシュやランタイムバッファーも含まれます。llama.cppサーバーのパラメーター
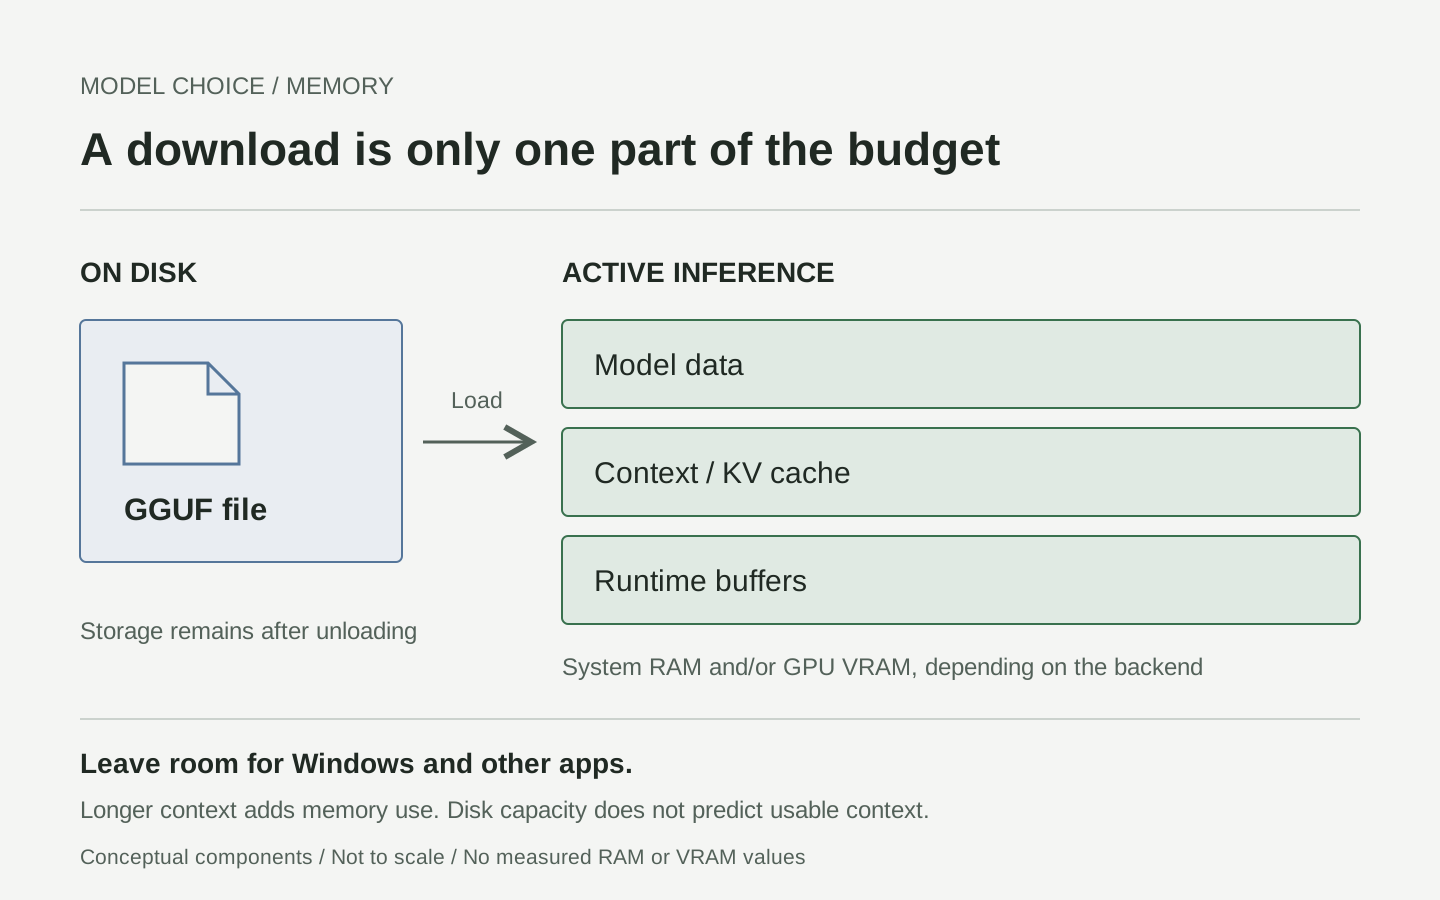
容量配分の考え方を示すオリジナル図で、実測値ではありません。モデル詳細の情報源ではモデルとコンテキストのメモリ量を推定しています。PC全体の使用量にはそれ以外も含まれます。
モデルの詳細を開き、コンテキスト長ごとのメモリ推定値を確認してください。小さめの推奨チャットモデルと、余裕を残せる短めのコンテキストを選びます。16GBのPCで、仮に4GBのファイルがディスクに置けたからといって、長い会話を処理できる証明にはなりません。後で量子化を比較するときは、モデル、プロンプト、コンテキストを固定し、変えた要素を一つにしましょう。商用利用の前には、モデル自体のライセンスも確認してください。アプリのMITライセンスが、ダウンロード可能なすべてのモデルを許諾するわけではありません。
最初の会話は、正誤を確かめやすくしましょう
提供開始時の記事ではRecommended ModelsとAvailableというパネル名が使われていました。確認したv0.12.0のソースでは、Models、Browse moreの区切り、Download model、Load model、Open WebUI、Stop modelといったアイコンのツールチップが使われています。古いパネル名を探し続けず、自分のリリースに実際に表示される操作を使いましょう。バージョン固定のWindows UIソース
- トレイのポップアップを開き、推奨モデルの容量と詳細を確認します。最初は、アクセス制限のない公開モデルを選びましょう。
- ダウンロード操作を選び、完了するまで待ちます。ダウンロード完了はファイルが届いたという意味であり、推論が動作中とは限りません。
- モデルの詳細で短いコンテキストを選び、Load modelを使います。読み込み後、Open WebUIを選ぶとローカルチャットが開きます。公式クイックスタートでも、チャット開始前にコンテキストを選ぶ手順が説明されています。クイックスタート
- 以下の合成プロンプトを貼り付けて送信します。テキストが表示されたかだけでなく、与えた事実と回答を照らし合わせてください。
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
有用な回答なら、2つの日付をそのまま保ち、Samの期限は未指定のままにします。期限を勝手に補うのは、インストールが完璧でも正確性の失敗です。比較用にプロンプトとモデルIDを保存し、終わったらStop modelを使いましょう。アプリにはAlt+Spaceで開くチャットオーバーレイもありますが、任意機能であり必須ではありません。Windows README
小さな作業を3つ試すと、ローカルモデルの得意分野がわかります
以下は架空の入力を使う例題であり、実際に記録したモデル出力ではありません。それぞれに課題、追加質問、具体的な合格条件を示します。
決定事項を捏造せず、走り書きのメモを引き継ぎにまとめる
ボランティアグループが週末のイベントを準備しているとします。次の依頼を入力してください。
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
大事なのは、確定した約束と提案を区別することです。「明確に割り当てられた作業と、提案にすぎないものはどれですか」と追加で尋ねましょう。Juneには担当が付き、Omarの申し出は未確定のまま、開始時刻は書かれていなければ合格です。他の人も根拠を確認できるよう、元のメモも引き継ぎ資料と一緒に残してください。
出典の範囲に収まる問題で文章を学ぶ
短いパブリックドメインの文章か、自分で書いた架空の説明を使いましょう。単独で実施できる例題です。
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
答えがもっともらしいかだけでなく、引用をすべて照合してください。答えられない質問として、温度の閾値を尋ねるのはよい例ですが、モデルはその閾値を捏造してはいけません。2回目には、事実をすべて残しながら簡単な表現にするよう依頼できます。一般的な温室の解説を追加させるのではなく、文ごとに確認できる書き換えにできます。
約束を勝手に増やさず、問い合わせへの返信案を作る
実際の顧客文を使う前に、架空の問い合わせで練習しましょう。
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
返金が処理済みだと述べたり、当日中の結果を保証したりする返信は不合格です。モデルに、作った約束をすべて強調表示させ、それを自分で確認しましょう。実際のサポートシステムにアクセスできる人だけが、アカウント操作を確認できます。ローカルで動かせば下書きの場所は変わりますが、返金を実行する権限がモデルに生まれるわけではありません。
同じモデルをローカルAPIでも使えます
チャットだけで十分なら、そこで終えてかまいません。エディター、スクリプト、試作から使う場合は、管理サーバーが**http://localhost:9931**で提供され、OpenAI互換リクエストは/v1以下にあります。これはローカル互換の仕組みであり、OpenAIのクラウドへのリクエストではありません。ポートが変更されていないか、設定で確認してください。Llama APIドキュメント
アプリを起動し、モデルを読み込んだ状態でPowerShellを開きます。まずルーターが利用できるモデルを一覧表示します。/modelsには読み込み状態が含まれ、/v1/modelsはOpenAI互換のメタデータエンドポイントです。自分が意図して読み込んだモデルの正確なIDをコピーしてください。先頭の項目を適当に選ぶと、別のモデルが読み込まれる可能性があります。
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
2つ目のブロックを実行する前に、下のプレースホルダーを正確なIDに置き換えます。合成テキストだけを送信し、追加SDKも必要ありません。
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
リクエストの形と出力フィールドは、llama.cppの公式サーバーリファレンスに基づいています。Listen Onはlocalhostのままにし、この例にクラウドAPIキーを貼らないでください。401エラーが出たら、保護を外すのではなくローカル認証を確認します。v0.12.0では、ループバック以外のアドレスを選ぶと、アプリがキーを生成し、確認を求めます。Windowsのセキュリティ動作
ローカル推論でも、すべてのネットワーク通信がなくなるわけではありません
Windows READMEによると、プロンプトと推論処理はローカルで行われ、アプリはテレメトリーを送信しません。同時に、モデルのダウンロードとリリース更新の確認ではネットワークリクエストが発生し、User-Agentにはアプリのバージョン、Windowsのビルド、アーキテクチャが含まれます。これは「オフライン」の意味が矛盾しているのではなく、別々の通信です。プライバシーに関する説明
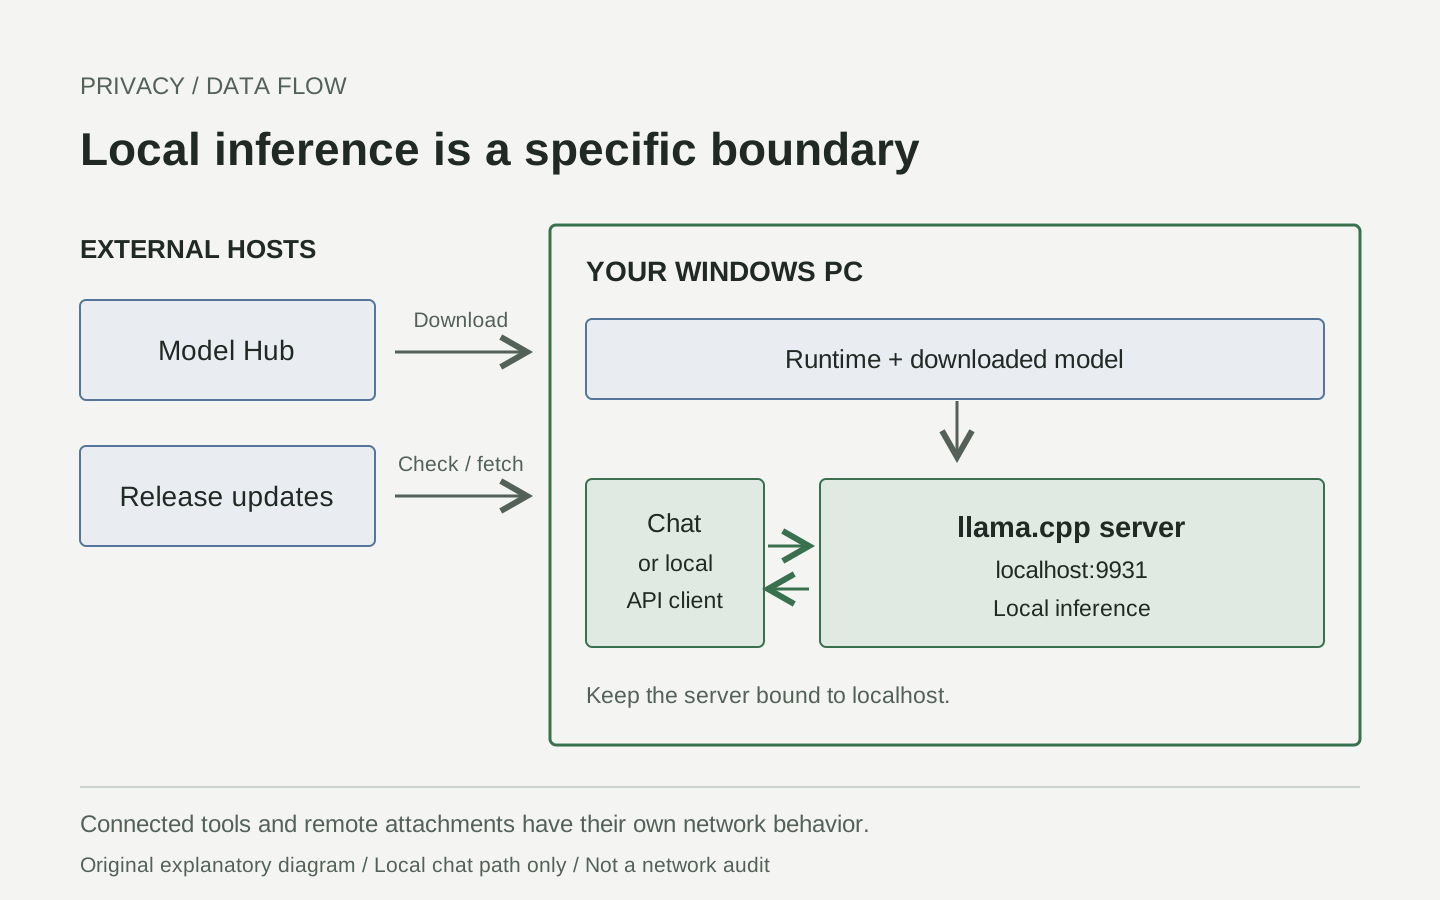
オリジナルのデータフロー図です。ダウンロード元は外部で、図に示したチャット経路はローカルです。出典:Windowsのプライバシー文書およびAPIリファレンス。
ダウンロード済みの対応モデルは、インターネット接続なしでも推論できますが、新しいモデルを使うにはダウンロードが必要です。接続されたエディター、ブラウザー拡張機能、リモート添付ファイルのURL、有効化された外部ツールには、それぞれ独自のネットワーク動作があります。サーバーがローカルだからといって、それらにもローカル限定の境界が適用されると思い込まないでください。
機密情報を扱う前に、会話の保存先、ブラウザー拡張機能、バックアップや同期先、組織のルールを確認しましょう。セットアップ後に架空の文章でオフラインチャットを試せば、機能の確認にはなりますが、すべてのコンポーネントを監査した証明にはなりません。公開される診断ログには、トークンや個人的なプロンプトを絶対に含めないでください。
インストール全体ではなく、失敗している段階を診断します
| 症状 | 最初に確認すること | 次に役立つ対応 |
|---|---|---|
| バンドルをインストールできない | ビルド26100の最低条件、アーキテクチャ、署名、デバイスポリシー | App Installerの正確なエラーを記録し、公式更新か管理者の支援を利用する |
| アプリのウィンドウが見当たらない | 通知領域と隠れているアイコン | トレイアイコンを開く。タスクバーに常時ウィンドウが出るとは限らない |
| モデルのダウンロードに失敗する | 保存先の空き容量、接続、アクセス制限、表示された失敗理由 | 原因を解消してから再試行し、まず公開モデルを使う |
| ダウンロード後、読み込みに失敗する | コンテキストの推定、空きメモリ、ランタイムエラー | 他の読み込み済みモデルを停止し、コンテキストかモデル容量を減らす |
| 返信が遅い | モデル容量、コンテキスト長、実際に使われているCPU/GPUバックエンド | 短いプロンプト一つで比較する。カタログの推奨を速度保証と考えない |
| APIに接続できない | アプリの起動、設定ポート、ローカルアドレス | 別サーバーを起動する前にサーバー状態を確認する |
| 流暢だが誤った説明が返る | 元の文章とモデルの適性 | タスクを短くし、根拠となる引用を求める |
現行READMEによると、設定とログは**%LOCALAPPDATA%\Llama**にあります。提供開始時の記事には別のログパスが記載されていました。場所を推測するのではなく、アプリのログフォルダー操作を使ってください。/healthエンドポイントは、サーバーが使用可能なモデルを読み込み済みか、まだ起動中かを区別する助けになります。ただし、ルーターが応答するだけでは、選んだモデルが読み込まれた証明にはなりません。現行の保存先文書、サーバーのヘルス状態
次の確認をすべて通過したら、初回セットアップは成功です
- 公式の署名済みパッケージが、セキュリティ制御を無効にせずインストールされる。
- 意図して選んだモデル一つのダウンロードと読み込みが完了する。
- ローカルアドレスでチャットが開き、架空の課題に回答する。
- 日付、名前、不明情報が、渡した文章と一致する。
- モデルを停止し、再度読み込める。
- APIを使う場合、意図したモデルが応答し、サーバーがlocalhostのみで待ち受ける。
つまり、ローカルAIは動作を確かめられるワークフローです
私たちの見方では、重要な進歩はターミナルのコマンドを一つ減らすことではありません。モデル選択、メモリ使用量、入力元、出力を理解できる状態にし、同じ作業を繰り返せるようにすることです。答えを検証できる小さなタスクを一つ選んで始めましょう。成功の条件がわかってから範囲を広げてください。
出典とメディア
2026年10月20日時点で確認。このガイドは公開文書にあるワークフローを説明しており、インストール試験、モデルの実行、有料リクエスト、ベンチマークを行ったとは主張していません。3点のSVGはいずれもオリジナルの解説素材で、画面の再現ではありません。実際の画面は提供元の公式トレイ画面とオーバーレイのデモをご覧ください。これらはリンクのみで、再掲載していません。
- Hugging Faceの発表、10月13日
- Windows版リリース、パッケージ、セキュリティ変更
- 公式インストールとクイックスタート
- GGUF形式とメタデータ
- ローカルAPIとエンドポイントの説明
- llama.cppランタイムとサーバーのリファレンス
実験を再利用できる形で残しましょう
最終回答だけを保存するのではなく、出典リンク、プロンプト、モデルID、確認メモを一緒に残してください。Telli.shは調査メモの整理に役立ちますが、Llama Windowsとの連携機能ではなく、メモがオフラインで保存されるという主張でもありません。Telli.shアカウントを作成