ローカルAIアプリをllama.cpp 1.0に更新しても、いつもの処理は動く?
llama.cpp 1.0では公開Cインターフェースの非互換変更がバージョン番号に表れます。稼働中のビルドを入れ替える前に、ライブラリ、ローカルサーバー、配布アプリを確認する方法を紹介します。
小さな開発チームが、回線の不安定な現場にオフラインの文書アシスタントを持ち込みます。整備マニュアルから一節を取り込み、出典のページ番号と短い回答を返すアプリです。開発用ノートPCでは新しいllama.cppのビルドが起動し、文章が出ます。現場用PCでは保存済みの起動設定が古いオプションを渡します。さらに処理を追うと、アプリが使う応答フィールドを開発者の手動テストは確認していませんでした。どれもllama.cppの更新と呼べますが、頼っているインターフェースはそれぞれ違います。
2026年11月13日、ggml-orgはllama.cppとggmlの1.0.0を公開しました。llama.cppは言語モデルを実行し、推論ライブラリを libllama として公開しています。ggmlはテンソル演算とハードウェアバックエンドを提供し、ライブラリは libggml と呼ばれます。メンテナーは、今後公開Cインターフェースの互換性を壊す変更をメジャーバージョン番号に反映すると発表しました。llama.cpp 1.0.0では、すでに非推奨だった呼び出しと廃止されたコマンドラインオプションが削除されています。11月13日のメンテナーのバージョン方針発表 · llama.cpp 1.0.0リリース · ggml 1.0.0リリース
ランタイムを替える前に、アプリの連携方法を三つに分けてみます。Cライブラリをビルドしてリンクする方法、ローカルHTTPサーバーを起動してリクエストを送る方法、インストール用アプリにランタイムを同梱して配布する方法です。一つのアプリが複数に当てはまることもあります。それぞれに合わせて少数の試験を行うと、開発用PCでのデモが一度動いたという以上の判断材料が得られます。
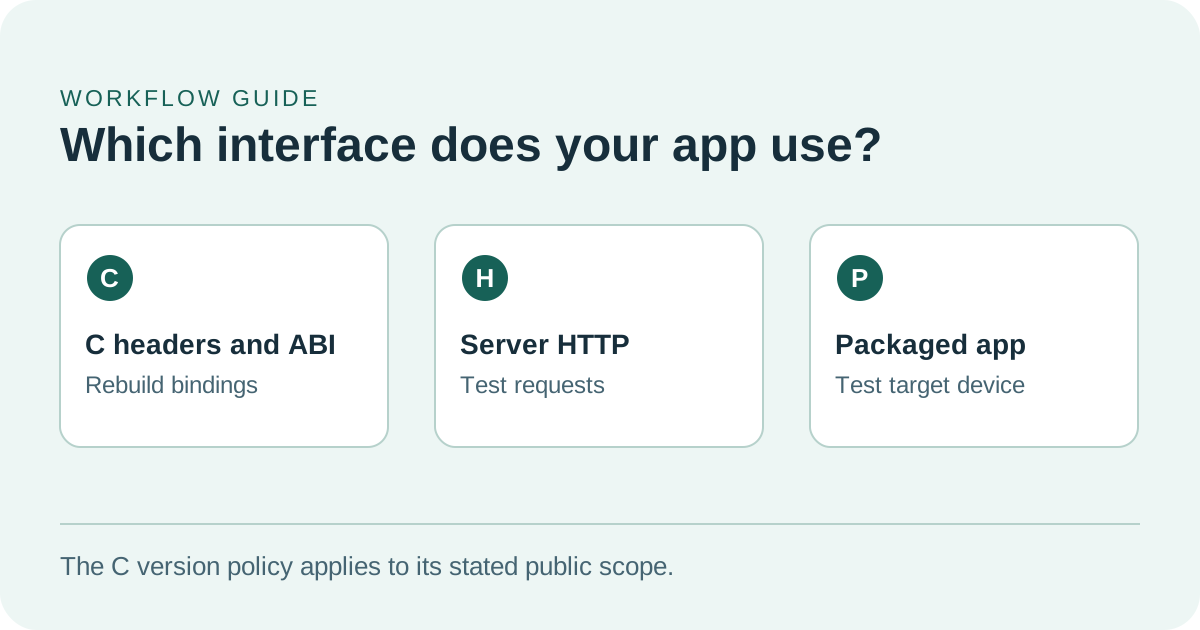
Cの互換性、HTTPの応答、配布パッケージには、それぞれ別の確認が必要です。
1.0ではネイティブ連携に影響する変更を見分けやすい
Cヘッダーは、ソースコードがライブラリをどう呼ぶかを記述しています。コンパイラは利用できる関数とデータ型をそこから知ります。ABIと呼ばれるバイナリインターフェースは、コンパイルしたコードとライブラリの接続方法を定めます。新しくビルドすれば、ソースが使う宣言の削除を早く発見できます。リンク済みのアプリを動かせば、対象機に入ったライブラリとの組み合わせを確認できます。ネイティブの依存ライブラリを自ら読み込むアプリでは、両方を試します。
メンテナーが11月13日に示した方針では、プロジェクトのincludeディレクトリにある公開C APIの破壊的変更はメジャーバージョンに反映します。互換性のある機能追加、バックエンドの更新、モデルのサポートはマイナー更新、APIを変えない修正はパッチ更新です。ネイティブバインディングを配布するチームには判断材料になります。コマンドラインの起動ツールやHTTPクライアントを配布する場合は、ユーザーがすでに使うオプションやリクエストも確かめる必要があります。メンテナーのバージョン方針発表
タグに記録された変更に具体例があります。llama.cpp 1.0.0のリリースノートでは llama.h から非推奨関数35個を削除したと記載し、llama_set_warmup と廃止済みのデフラグ制御の削除も別に挙げています。投機的デコーディング用のNextN APIは llama.h に移り、状態に関わる名前の変更も記載されています。まずアプリが使う呼び出しを確認します。コンパイラが関数の消失を示したら、置き換え方を決める前にノートと現在の公開ヘッダーを読みます。1.0.0のAPI変更 · 1.0.0タグの公開ヘッダー
オフラインのマニュアルアシスタントなら、ネイティブ連携の簡易試験として、既知のモデルを読み込み、短い抜粋と質問を渡し、回答を読み取り、モデルを正常に閉じるところまで試せます。ユーザーが実際に使うアプリのプロセスで読み込みと終了を繰り返します。別途コンパイルする言語バインディングがあるなら、所定のヘッダーを参照してビルドし、インストール後に意図したライブラリが読み込まれるか見ます。結果を読む前に使用した成果物を記録してください。手元のライブラリでコンパイルできても、現場用PCでアプリの横に配置する別のコピーが動くとは限りません。
ユーザーが頼る箇所を実際に動かしてみる
プロジェクトは、独自のコマンドライン引数と文書化されたエンドポイントを持つHTTPプロセス llama-server も提供しています。1.0.0が追加したOpenAI互換の /v1/audio/speech エンドポイントは、Cライブラリと並行して発展するサーバー機能の一例です。同じリリースで --defrag-thold は削除されました。そのオプションを渡す同梱サービスなら、Cの関数を直接呼ばなくても移行作業が必要です。1.0.0のリリースノート · 1.0.0タグのサーバー文書
サーバー文書には、アプリの試験と組み合わせやすい確認が載っています。/health はモデルの読み込み中にHTTP 503を返すことがあり、読み込み後に200を返します。HTTPクライアントをすでに使っているなら、続けて実際のチャット、埋め込み、その他のリクエストを実行し、応答が解析できるか確かめます。ストリーミングでは、正常に終わる短い応答とユーザーがアプリから中断する長い応答を含めます。最も単純なリクエストだけが成功しても、中断ボタンやテキストの解析までは試せません。v1.0.0のサーバー状態とエンドポイントの文書
| アプリが使うもの | 更新後に最初に確認すること | 実際の作業で追加する確認 |
|---|---|---|
| 公開Cヘッダーとネイティブライブラリ | クリーンビルドし、指定のライブラリで実行する | モデル読み込み、短いリクエスト、リソースの解放を繰り返す |
| ローカルHTTPサーバー | 保存済みの設定で起動し、モデルが準備完了になるのを待つ | クライアントが対応する実際のリクエスト、ストリーミング応答、中断、エラー状態を試す |
| ランタイム同梱のデスクトップ版またはオフラインインストーラー | 代表的な機器に入れ、ビルド成果物を記録する | 既存のユーザー設定でアプリを開き、インストール済みのビルドで既知のローカルモデルを使う |
| 特定のハードウェアバックエンド | 選択されたバックエンドと、モデルがメモリに収まるかを確かめる | 対応を約束している最も遅い構成で、メモリと所要時間を比較する |
三つ目の同梱方式にはサーバーの機能表に載らない事情があります。たとえばWindowsのパッケージでは、実行ファイルの隣にバックエンドのライブラリが必要な場合があります。ユーザーの既存モデルを見つける手段と、見つからなかった場合に読めるエラーメッセージも必要です。開発側では、動作するバックエンドが別にインストール済みかもしれません。一般の利用者を代表するインストール環境で試すと、開発環境が最初から提供する依存物の不足に気づけます。11月13日の発表には複数の配布方法とプレリリース向けプラットフォームが載っています。実際に出すタグかパッケージを使い、入手元を記録します。メンテナーの配布に関する説明
バージョン番号からマニュアルの回答時間は分からない
オフラインアシスタントを待つ人には、複数の処理がまとめて一つの待ち時間に感じられます。まずモデルを読み込みます。アプリが質問と文書の抜粋をトークン化します。ランタイムがプロンプトを処理してテキスト生成を始め、結果を画面に送ります。マニュアルから長い部分を取ればプロンプト処理が待ち時間の大半を占めることがあり、長文で答えるリクエストなら生成に時間がかかりやすくなります。利用者にとって違いが重要なら、起動時間、最初の文字が表示されるまでの時間、完了までの時間を分けて測ります。
1.0.0のタグの文書は、llama-bench にプロンプト処理、テキスト生成、両方を合わせる三つのモードがあると説明します。報告される時間にはトークン化とサンプリングが含まれません。条件をそろえてランタイムを比べるには便利で、画面から計測した待ち時間と一致しない理由も分かります。どの工程が改善したか知りたいときは両方の値を記録します。1.0.0タグのベンチマーク文書
まず両方のビルドに同じGGUFモデルを使います。双方が対応する範囲で、ハードウェアバックエンド、コンテキスト設定、オフロードの選択をそろえ、実際の設定とモデルのハッシュを保存します。短い入力と文書相当の入力を試します。メモリの測定では、読み込み直後に安定したときの値と、代表的なリクエストのうち最も長い処理中に観測できるピークを記録します。他のアプリがないPCで起動するモデルでも、ブラウザと文書ビューアーが開いている利用環境では別の上限に達することがあります。
1.0.0では推論に用いるキーバリューキャッシュに f8_e4m3 などのFP8オプションが追加され、混合専門家モデルでホストメモリ上のエキスパートキャッシュも設定できます。比較できる構成が増えました。バックエンドとモデルが対応する設定は、1.0への移行とは分けて影響を測ります。代表機一台に適用し、同じ入力をもう一度試し、回答がアプリの要件を満たすか比べます。時間が変わった場合や引用が欠けた場合でも、どの変更が影響したか調べやすくなります。1.0.0の主な変更点
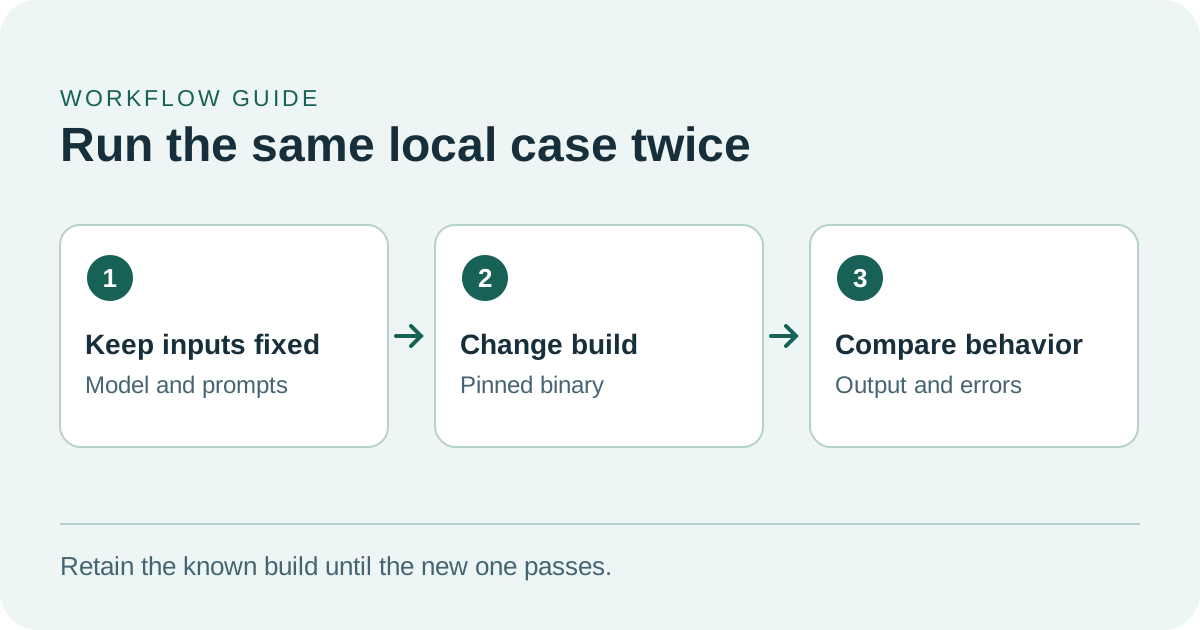
モデルと入力を固定すると、違いが更新から生じたかを調べられます。
小さな移行リハーサルで配布を判断できる
- 比較するビルドを正確に決めます。 配布中のものと1.0.0の候補を別々の場所に置きます。アプリ、ランタイム、モデルのバージョン、両方の実行で使う同じGGUFのチェックサム、ハードウェアバックエンドを記録します。ビルドを替えるときはユーザーデータとアプリ設定を保ちます。
- いつもの起動経路を使います。 ループバックだけでサーバーを試す場合、手元の承認済みモデルファイルに置き換えて
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931から始められます。廃止されたオプションを見つけるため、配布中の起動コマンドも試します。準備完了を確認し、ユーザーが実際に開くクライアントからテストします。タグに対応するサーバー設定とオプション - 少し難しい質問も用意します。 明確な答えが一つある短い抜粋、似た用語が出る長い抜粋、抜粋からは答えられない質問を試します。それぞれ何を有用な回答とみなすか決めます。本文に答えがあれば正しいページを引用し、根拠がなければそう伝えることを求めます。解析エラーと使えない出力は、モデルの品質と分けて記録します。
- 性能に関わる設定は一つずつ比較します。 代表機で両ビルドのバックエンドをそろえ、
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5から試せます。トークン数や5回の反復は例です。利用者の体験を判断する前に、アプリの起動、メモリ、遅延、長めの実入力も測ります。タグに対応するベンチマークオプション - インストールしたビルドを動かし、戻し方も確認します。 代表的でクリーンな環境に候補を入れ、再起動後に最大規模の対応ケースを繰り返します。起動に失敗しても既存の設定やファイルが使えるか、前のアプリ版に戻せるかを確かめます。配布拡大を中断すべき条件が伝わる記録を残します。
多くのプロジェクトでは、試験ケースを何件か選ぶだけで次に見るべき問題が分かります。長い抜粋への応答が遅くなったら、最初の文字が出る前、生成中、画面表示のどこで差が出るか探します。更新後にエラーになるなら、プロンプトやモデルを替える前に、発生するリクエストの形式とクライアントを記録します。パッケージ版だけが失敗するなら、インストーラーと実行中のプロセスを、動く開発版と比べます。各層を受け持つ人は再現すべき条件を絞れます。
必要とする端末で同じアップグレードを再現できることが大切だ
llama.cpp 1.0には、多くのローカルツールが依存するランタイムの変更を把握しやすくする価値があります。アプリチームは、ビルド、モデル、端末、ユーザーが実際に行うリクエストと結果を、小さな互換性の記録として残せます。ランタイムやアプリの担当が替わっても、次のバージョンを、利用者が頼る作業の試験から始められます。
出典
- ggml-orgのバージョン方針と配布の発表、2026年11月13日
- llama.cpp 1.0.0リリース、2026年11月13日
- ggml 1.0.0リリース
- 1.0.0タグのllama.cpp公開Cヘッダー
- 1.0.0タグのllama-server文書
- 1.0.0タグのllama-bench文書
アップグレードの判断やテストメモ、モデル設定を後でまとめて探せるようにするなら、Telli.shアカウントを作成できます。