Liquid LFM3、小型モデルを選ぶ基準は「どの仕事を任せるか」
LFM3は共通の基盤からテキスト、視覚、音声、Omni、意思決定モデルへ分岐します。用途に合う選択、実行時メモリの見積もり、実用的なローカル評価を解説します。
領収書を読むローカルアシスタントと、口頭の質問へ答えるローカルアシスタントは、必ずしも同じモデルを必要としません。許可された三つの操作から選ぶプログラムには、また違う役割があります。これらを同じ仕事として扱うと、小さなアプリが不必要に複雑になることがあります。
Liquid AIは、2026年10月27日に LFM3 を発表しました。共通の1.7B基盤から派生する、およそ2B規模の6モデルです。テキスト、視覚、音声、Omniと、二つの意思決定用モデルを含みます。公開重み、Playground、APIを提供しています。LFM3の発表。
重要なのは、アプリにどの役割を担わせるかです。本稿では、実際の選択に沿ってモデル群を説明し、小さな重みファイルと実行時のメモリ予算を区別します。そのうえで、用途特化型モデルが手元のハードウェアで役立つかを見極める最初の評価を提案します。
 Raspberry Pi 5。エッジコンピューティングのイメージであり、LFM3の試験ではありません。画像:RetroEditor、CC BY 4.0。余白を付けてサイズを調整。画像の出典 · ライセンスと画像に関する注記。公式製品情報。

必要な出力から、用途に合うモデルを選ぶ
対応入力の種類の多さから選ぶと、用途を見誤りやすくなります。アプリに必要な出力から考えます。段落、文字起こし、構造化した項目、許可された操作からの選択は、同じ資料から作れるとしても、それぞれ別の出力契約です。
Liquidの10月27日の発表は、四つのモダリティ系と二つの意思決定系として、LFM3-1.7B、LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2B、d1-2B、d1-Omni-2Bを挙げています。以下は各役割をアプリ選びの問いへ置き換えたものです。独立した品質順位ではなく、適合性のガイドです。モデル群の説明。
| モデルの役割 | LFM3の候補 | アプリについての問い |
|---|---|---|
| テキストでのやり取り | LFM3-1.7B | テキストから言語による出力を得たいか |
| 画像とテキストの理解 | LFM3-VL-2B | 答えが目に見える内容に依存するか |
| 音声と言葉のやり取り | LFM3-Audio-2B | アプリに聞く・話す機能が必要か |
| 視聴覚を組み合わせたやり取り | LFM3-Omni-2B | 視覚と聴覚を一緒に解釈する必要があるか |
| テキストと画像からの構造化判断 | d1-2B | 結果を型付きの判断で表せるか |
| 音声を含む構造化判断 | d1-Omni-2B | 選択肢を限定した判断にも音声が必要か |
私たちは、ローカルAIで考えるべき単位は一つの仕事を完結できる最小構成だと考えます。モデルには、不確かな場合の扱いも含め、明確なアプリの要件を満たす能力が必要です。それ以上の機能は、実行時間、テスト、統合の負担に見合う価値があるかを確かめるべきです。
モデル群を、工具を巻いて収納する道具入れにたとえてみましょう。すべて持ち歩く方がよい仕事もあれば、同じ調整を繰り返すなら必要な一本だけを選ぶ方が簡単な場合もあります。これはアプリ設計のたとえであり、あるモデルが常に別のモデルを上回るという主張ではありません。
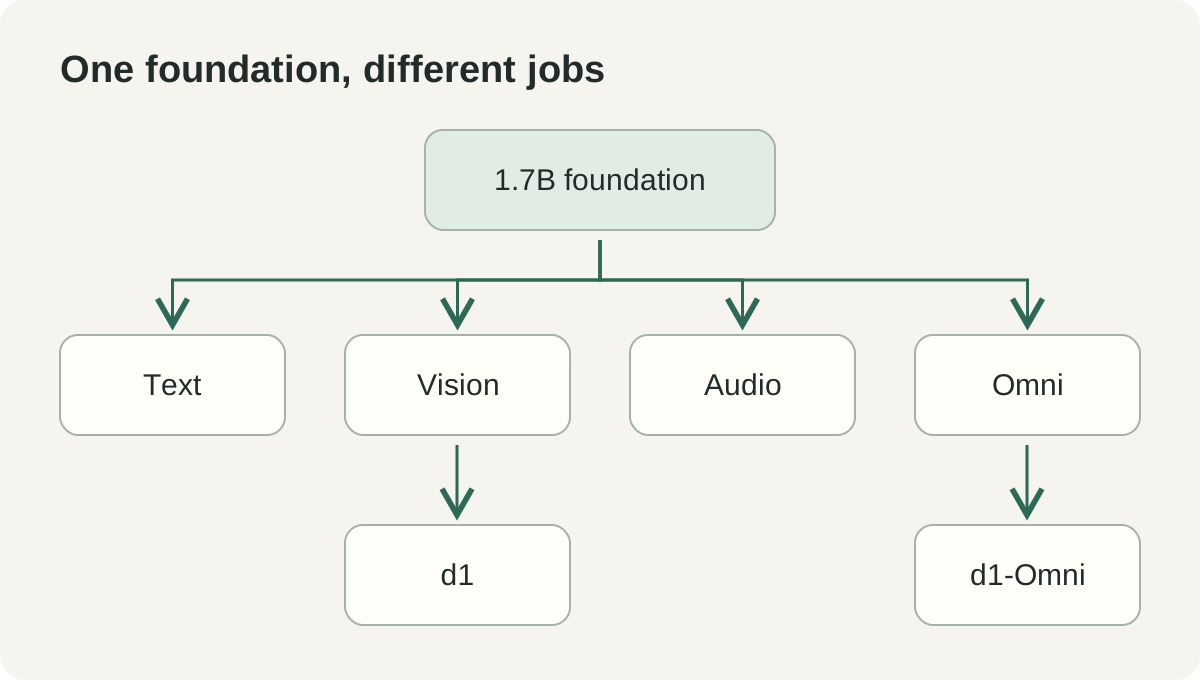 Liquid AIのLFM3発表で挙げた役割に基づく独自作成の説明図。アプリの選択肢を整理し、内部実装の詳細は省いています。
オープンウェイトは導入先の選択肢を広げるが、ライセンスの確認が必要だ
重みのダウンロードによって、開発者は評価し、組み込み、用途に適応させる具体的な実行物を得ます。アプリのデータ経路を管理下に置くローカル配備も可能になります。ただし、ファイルを入手できることだけで商用条件が解決するわけではありません。
11月2日に確認したLiquidのモデルカタログは、企業の 年間売上高が1,000万ドル を超えるまでは商用利用が無料としています。LFM3-1.7Bモデルカードは、LFM Open License v1.0を示しています。対象の重みに添付されたライセンスと現在のライセンス案内を、予定する配備、配布、売上条件に照らして読んでください。
これは実際に必要な調達の工程です。小さな社内試作、配布する消費者向けアプリ、他社へ提供するサービスでは、配布や義務について異なる問いが生じます。モデル識別子、版、ライセンスをアプリと一緒に記録し、規模が拡大しても判断をたどれるようにします。
実行用ソフトウェアとモデルの重みは、別々に版が更新されます。モデルが公開されても、端末の実行環境がまだ対応していない場合があります。旧モデル群を読み込めるアプリなら新モデルも正しく扱えると考えず、文書にある組み合わせを確認します。
チームでは、対象モデルが期待するプロンプトやテンプレートも記録します。互換性のある読み込み機構でも、入力形式が誤れば挙動が悪くなります。再現性は、実際に何を読み込み、アプリがどのような形式でやり取りしたかを把握することから始まります。
約1 GBの重みは、メモリ予算の出発点
Liquidは10月27日の発表で、テキストモデルの4ビット版の容量を約1 GBと説明しています。テキストモデルカードは、パラメーター数を1.73 billion(17億3,000万)、入力と出力を合わせたコンテキストを256Kトークンとしています。これらはモデルの仕様であり、アプリのピークメモリは処理内容と実行環境にも左右されます。
重みファイルは、実行中のプロセスの一部にすぎません。ランタイムには作業メモリが必要です。コンテキスト処理には状態が必要です。マルチメディア入力には追加のバッファとエンコーダが必要になる場合があります。デバイス上の他のプログラムが同じリソースをめぐって競合します。重みの容量の見出しだけでは、負荷がかかってもアプリケーション全体が快適に動作するかどうかはわかりません。
メモリの見積もりは、実測したプロセス全体の使用量から始めます。待機中、代表的な依頼を処理した際のピーク、繰り返した後の状態を記録します。収まりやすい小さなプロンプトではなく、利用者が実際に使うコンテキスト長と入力サイズを試してください。
時間も段階に分けて考えます。起動、プロンプトの処理、応答の生成では、それぞれ待ち時間が生じます。長く待った後でトークンが速く出ても、対話型アプリでは遅く感じられます。一方、バッチ処理では一時間あたりの完了件数が重要かもしれません。実際の操作に合う指標を選びましょう。
音声機能なら入力から使える結果まで、画像機能なら画像処理も含めて測ります。意思決定機能なら検証と操作への引き渡しを含めます。これは製品発表が示す性能値ではなく、自社で定義する評価要件です。
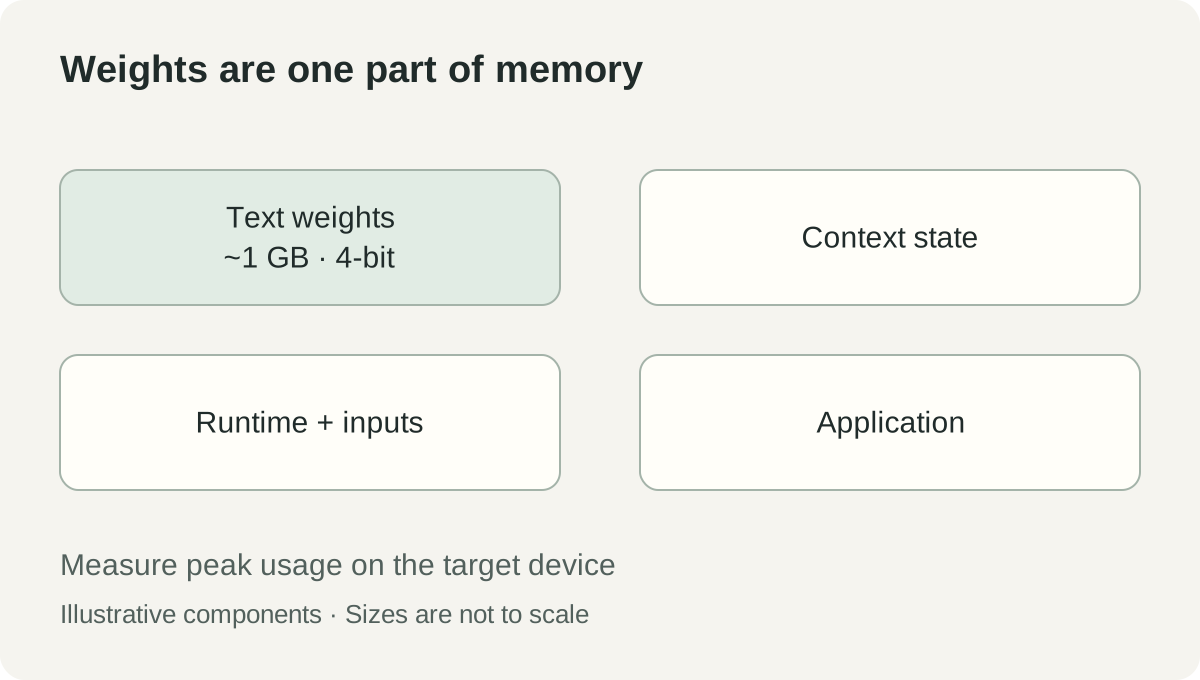 独自に作成したメモリ予算図。セグメントの幅は例示的なものであり、測定された比率はありません。約 1 GB という数字は、アプリケーション メモリの合計ではなく、Liquid が公開している 4 ビット テキスト モデルのフットプリントを指します。 出典.
三つの用途で、異なる利点と制約を確かめる
文書支援では、読み取りと判断を分ける
撮影した領収書を受け付ける小規模事業向けアプリを考えます。見えている販売店、日付、金額を読むことと、人が確認できるだけの情報がそろっているかを判断することは別の仕事です。一つのモデルが両方を担っても、出力は別々に検証する価値があります。
視覚言語モデルは画像についての問いを支え、意思決定モデルは範囲を限定した情報充足の確認に使えるか評価できます。アプリは元画像を保持し、抽出した項目と確定した帳簿データを区別する必要があります。欠けた日付は、人が解決するまで欠けたままにします。
評価用の例には、鮮明な画像、ぼけた画像、珍しいレイアウト、実際に使う言語の領収書を含めます。項目ごとの誤りと、確認に必要な作業量を測定してください。全体の成功率が高くても、業務上重要な項目で繰り返す誤りが隠れることがあります。
有用な製品上の成果は、短く明確な確認キューです。洗練された説明文より、元資料を見て項目を訂正できることが重要です。この優先順位は、自由な文章出力と、制約した意思決定インターフェースのどちらを選ぶかに役立ちます。
音声操作は、少数の許可された操作から始める
ローカル アプリケーションのハンズフリー アシスタントの例を考えてみましょう。ユーザーは、アイテムの検索、ステータスの読み取り、または下書きアクションの準備を依頼できます。音声機能は、入力するよりも話す方が簡単な場合に役立ちますが、アプリケーションはリクエストで何を変更できるかを認識する必要があります。
操作の種類を少数に絞り、目に見える確認手順から始めます。例えば、承認済みデータの検索は直ちに実行しても、記録の変更は提案を表示して確認を求められます。ルールはモデルの文言ではなく、アプリが管理します。
実際の音響条件で試します。周囲の会話、短い発話、似た名前は、きれいな録音とは違う失敗を生む場合があります。聞き直すことが正解の例も加えます。流暢さより、正確で訂正・復旧できるやり取りを重視します。
Omni系の候補が有効なのは、発話だけでなく、目に見える内容にも依存する依頼です。すべての作業が音声だけで済むなら、視覚処理を追加する理由が必要です。モデル群から選ぶ方式は、仕事に見合う機能に絞るのに役立ちます。
ローカルのサポート支援でも、判断を見送る経路を残す
サポート アプリケーションの例では、チケットと添付されたスクリーンショットを使用して 3 つのキューから選択する場合があります。制限された決定出力は、アプリケーションが解釈する必要がある長い回答よりも、そのタスクに直接適合できます。有益な質問は、選択したルートが許容可能なレビュー率で十分に信頼できるかどうかです。
明示的な「要確認」の結果を残します。どのキューにも当てはまらない依頼、矛盾する画面画像、背景不足を試します。スキーマが行き先を要求するからといって、モデルに正当な行き先を作らせてはいけません。
モデルを既存のルールや人によるルーティングなどの単純なベースラインと比較します。ベースラインがすでにカテゴリーを確実に処理している場合、モデルはワークフローの別の部分を改善する必要があります。新規性は受け入れ基準ではありません。
それぞれの間違いについて、なぜそれが起こったのかを理解するために十分な許可されたコンテキストを保持してください。入力の問題、あいまいなカテゴリ、モデルのエラーを分離します。この区別により、モデルを改善するか、キュー定義を変更するか、より良いソース資料を求めるかがわかります。
ベンチマーク表は、自社の仕事を評価する出発点
11 月 2 日にチェックされた公式の LFM3-1.7B モデル カード では、知識を必要とする作業の検索または情報取得を推奨し、このサイズでのエージェント コーディングと複雑な複数ステップの推論に対して警告しています。これは、ベンダーのベンチマーク テーブルに進捗が示されている場合でも、モデルを大規模なシステム内に配置する際の有益なガイダンスとなります。
ベンチマークは、特定の設定で特定の問いに答えます。アプリには自社のデータ、ツール、言語の分布、誤りの損失が加わります。公開の集計で改善していても、利用者が毎日出会う少数の分類には、慎重な検証が必要です。
試験では三つを分けて比べます。第一に、現在の手順に対する仕事の品質。第二に、対象端末での資源費用全体。第三に、失敗から復旧する手間です。それぞれで、優れた選択肢が違うかもしれません。
たとえば、ローカルの用途特化型モデルが回答を見送った際に、クラウドの汎用モデルへ引き継ぐ構成は考えられます。その場合には、明確なデータ方針と利用者に分かる動作が必要です。ローカルで動かすという選択は、ログや代替処理のリクエストも含め、アプリ全体を通じて検証すべきです。
ファインチューニングは、実際に確認した不足を埋めるために行います。原因が入力資料の欠落や出力定義の曖昧さなら、追加学習は間違った仕事を強化しかねません。カスタマイズが次に必要な手段かを決める前に、要件を定義し、誤りを調べましょう。
最初の試行は、一枚の判断メモに収まる範囲にする
公式のテキストモデルカードには、重みの形式と実行手順へのリンクがあります。そこからモデルと実行環境の正確な組み合わせを決めます。データ方針に合う場合は、最初の操作に公式Playgroundも使えます。ただし、どちらも出荷予定の配備構成のテストに代わりません。
- 入力契約と出力契約を作成します。 許可された内容、期待される結果、および明示的なレビュー結果を述べます。一般的なアシスタントのペルソナではなく、タスクを 1 つ選択してください。
- 候補とリビジョンを選択します。 モダリティと出力ロールを照合し、チェックポイント、ライセンス、互換性のあるランタイムを記録します。モデル固有の制限事項をお読みください。
- 代表的な評価セットを作ります。 よくある事例、難しい事例、対象外の依頼、実際の利用言語の例を含めます。評価用に取り分けたデータは、カスタマイズ用データと分けて保管します。
- 文書化されたクイック スタートを隔離された環境で実行します。 モデル カードの現在の依存関係とフォーマット手順に従ってください。出力を比較する前に、返されたモデルのアイデンティティを確認してください。
- 完全なアプリケーション パスを測定します。 正確性、レビュー率、レイテンシー、および現実的な入力サイズのピーク メモリをキャプチャします。ハードウェアとランタイムの設定を数値と一緒に記録します。
- 不確実性パスを実行します。 情報の欠落、無効な出力、および実行時のエラーが、理解できるレビューまたは再試行状態につながることを確認します。
- 次にどこを特化させるかを決めます。 繰り返す誤りの種類を基に、入力の改善、規則の明確化、検索による情報取得、ファインチューニング、別モデルへの変更から選びます。
最初のパスでは、書面による決定は単純なものにすることができます。つまり、この候補モデルは、これらのレビュー条件を備えたこのデバイスでのこのタスクに役立ちます。限定的で再現可能な結論は、ローカル AI があらゆることに対応できるという一般的な主張よりも価値があります。
小型モデルの価値は、定義した仕事を完了できるかで決まる
LFM3 は、アプリケーションの近くでテキスト、視覚、音声、または限定された決定を必要とする開発者向けのメニューを広げます。その実用的な重要性は、これらの役割の中から選択し、製品の一部として評価できることにあります。
次のステップは、1 つのジョブを品質、メモリ、回復のすべてを測定できるほど正確にすることです。スペシャリストは、アプリケーション全体がその入出力の要件に依存でき、応答できない場合の対処方法を知っている場合に役立ちます。
出典
- Liquid AI: LFM3 の紹介、2026 年 10 月 27 日。 2026 年 11 月 2 日に確認済み。
- Liquid AI モデル カタログ および 価格とライセンス、2026 年 11 月 2 日に確認。
- 公式 LFM3-1.7B モデル カード、2026 年 11 月 2 日に確認。
- 公式 d1-2B モデル カード、2026 年 11 月 2 日に確認。
判断の背景となる資料を残す
Telli.shは、利用を許可された資料を、確認済みのメモと一緒に残すための選択肢です。ノート用ワークスペースを作成する。