1台のサーバーにGPUを30枚つなぐと、研究室のAI処理の待ち時間は減る?
LIQID UltraStackはAMD Instinct MI350Pをモデルごとに割り当てます。GPU20枚の実測値と30枚の予測値を比べ、研究者が実際に待つ時間を測る方法を解説します。
朝9時、ある研究チームが前日にスキャンした資料から文字を抽出し始めます。別のチームはメモの翻訳を依頼し、さらに別のチームは測定機器のマニュアルについて、すぐに答えが欲しいと思っています。推論キューを共有していると、短い質問でも大量の文書処理の後ろに並ぶことがあります。答えが出る頃には、質問した人はもうPDFを開き直しているかもしれません。
インフラ企業のLIQIDは2026年11月12日、デュアルソケットのAMD EPYC 9005ホスト1台にAMD Instinct MI350Pアクセラレーターを4〜30枚つなぐUltraStackの構成を発表しました。公表された推論提供方式は、カード1枚にモデルインスタンスを1つ配置します。あるGPUがOCRを処理する間に、別のGPUが翻訳や質問に対応できます。LIQIDは、シカゴで11月17〜19日に開かれるSC26の展示期間にデモを行うと発表しました。LIQIDの11月12日付発表と公式システム画像 · SC26の日程
複数のジョブを期日までに終える必要があり、各モデルがカード1枚に収まる研究室には、この構成を検討する理由があります。まず利用者が実際に待った時間を測ります。GPUを分ければ別のジョブによる待ち時間がどれだけ減るか、次にどの制約が現れるか、その改善幅が電力や費用に見合うかを調べましょう。大半は、カードを最大数まで載せた構成よりもずっと小規模な試験で確認できます。
GPUごとに144 GBの専用メモリがあります
LIQIDの公開構成では、AMD EPYCホストとMI350PカードをPCIe Gen 5ファブリックで接続します。カードは、ホストにつないだ独立のGPUシャーシに収める場合があります。AMDの仕様では、MI350Pは1枚につき144 GBの専用HBM3EとPCIe 5.0 x16インターフェースを備えます。1枚に1モデルを配置すると、各モデルは割り当てられたGPUのメモリを使います。モデルインスタンスは、推論用ソフトウェアとメモリの制約の範囲で、複数の要求に対応できます。LIQID UltraStackのデータシート · AMD MI350Pの仕様
カード20枚では、HBM3Eの合計は10進単位で2.88 TBです。この数値は、システムで別々のモデルインスタンスをいくつ動かせるかを見積もるときに使えます。7枚目のカードに割り当てたジョブにとっては、144 GBが目安です。パラメータと作業中の状態を複数のGPUに分けなければモデルが収まらないなら、分散方式を検討し、その構成をベンチマークで直接評価します。LIQIDのスケーリングの報告は、各カードで独立したインスタンスを動かした場合のものです。LIQIDの試験構成とメモリ容量
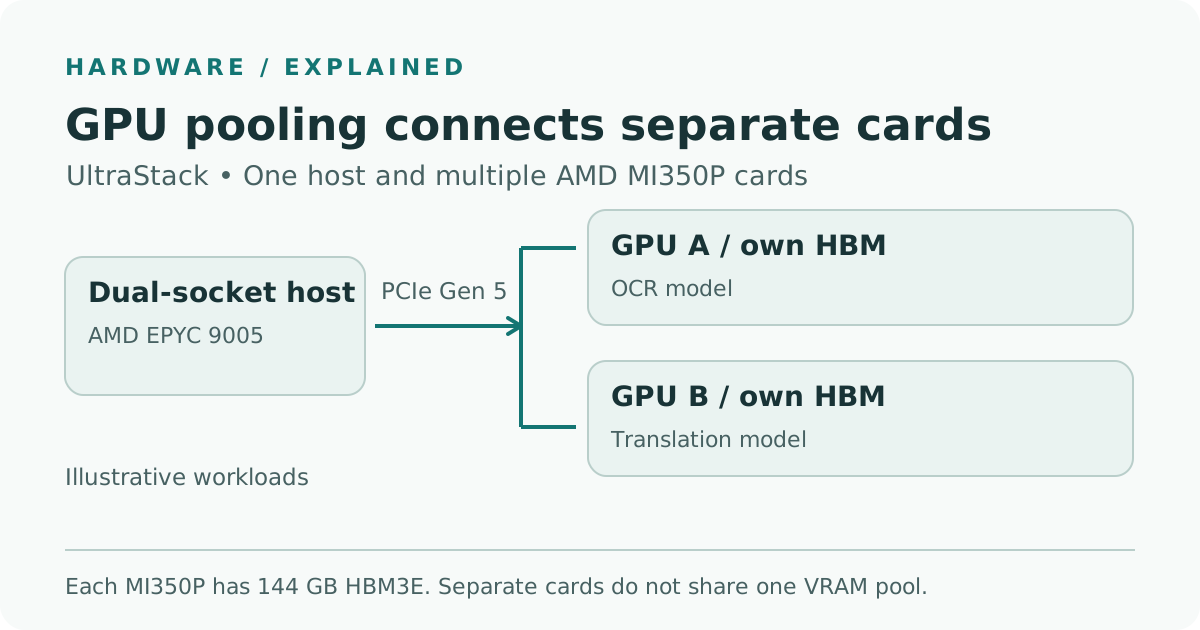
LIQIDのハードウェア説明とAMDのカード仕様をもとにしたTelli.shの図です。独立した推論提供の例を示し、シャーシやホストの周辺機器は省いています。
パラメータ数は候補を絞る目安になりますが、同じパラメータ数でも必要メモリは異なります。まず実際に使う重みと精度を確認し、ランタイムや、続くトークンの生成時に過去のトークンを参照するためのキャッシュも見込みます。長い要求を同時に複数受けるサービスなら、候補モデルを起動し、実際に想定する組み合わせでメモリを観測してください。ほかの処理が走っていないカードに短いプロンプトを入れれば、サービスが起動するかは分かります。最大長の入力を連続して処理する試験で、要求を受け続けられるかを確認できます。
ジョブの到着頻度が違うときに独立キューが役立ちます
大学の資料室で聞き取りの音声と紙の記録を一緒にデジタル化する場合を考えます。試験では、1枚のGPUを文書OCRに、もう1枚を文字起こしに、3枚目を短い翻訳に割り当てられます。1週間分の利用データを見たあと、4枚目に最も混雑するサービスの2つ目のインスタンスを置いてもよいでしょう。サービスごとにキューを設け、一度に受け付ける作業量を決めます。スキャン文書の滞留によって、同じアクセラレーターを使う短い翻訳が遅れる可能性を下げられます。
OCRのあとにテキストを翻訳してほしいという依頼が来たとします。文書が複数あれば、処理段階を重ねて実行できます。1件目が翻訳に進む一方で、2件目のOCRを始めるのです。1件目の翻訳は、その文書のOCR出力がそろってからです。その文書をアップロードしてから使える結果が返るまでの時間を、処理全体の完了文書数と一緒に測ります。1時間に処理できる文書が増えても、翻訳を待つ人が1ページに長く待たされることはあります。
別の例として、工学研究室が日中は文書アシスタントを利用し、夜間は過去の計測ログを処理する場合を想像してください。日中のアシスタントには、質問後の初回応答までが予測できることが求められます。夜間ジョブには締め切りがあり、途中の停止を許容できる場合が多くあります。各GPUをサービス専用にする前に、サービス別の稼働時間の割合を実測しましょう。アシスタントが普段はほとんど使われず、会議後だけリクエストが集中するなら、常設の予備インスタンスには閑散時間にも費用がかかります。定時実行や独立したキューでピークに対処できている構成は、比較対象になります。
モデルの配置は復旧にも影響します。ホスト1台で構成作業の一部は簡単になりますが、全サービスがそのホストに依存します。メンテナンス後に待てるジョブ、先に復旧すべきジョブ、別の提供先が必要なジョブを整理してください。文書処理では途中結果を保存し、再起動後に終わった抽出処理の続きから再開できるようにします。対話型の処理では、許容する停止時間に合意するか、別のエンドポイントを用意します。主ホストのカード枚数が示すのは平常時の推論能力です。復旧時間は別の試験で測ります。
LIQIDはGPU20枚で毎秒約89,000出力トークンを測定しました
LIQIDのスループット資料によると、試験は7BクラスのモデルをFP4精度、同時実行数128で動かしたものです。GPUごとにモデルインスタンスを提供し、20枚全体で毎秒約89,000出力トークンを記録したと報告しています。30枚で毎秒約133,000出力トークンという値は、20枚で観測した伸びを延長した推計です。どちらも試験または推計の構成全体での出力を指します。研究者が1件の要求を送ったときに体感するのは、その要求の待ち時間、入力処理時間、生成速度です。LIQIDのスループット資料と測定方法
| LIQIDの試験 | GPU枚数 | 合計出力トークン数/秒 | 根拠 |
|---|---|---|---|
| 7Bクラス、FP4 | 1 | 4,653 | LIQIDの実測 |
| 7Bクラス、FP4 | 10 | 44,383 | LIQIDの実測 |
| 7Bクラス、FP4 | 20 | 約89,000 | LIQIDの実測 |
| 7Bクラス、FP4 | 30 | 約133,000 | LIQIDが20枚の結果から推計 |
| 72Bクラス、FP8、対話時の遅延条件あり | 8 | 1,256 | LIQIDによる別試験の実測 |
別に実施した72B FP8試験では、99パーセンタイルで最初のトークンまで2秒以内、利用者ごとに毎秒30出力トークン以上が目標でした。LIQIDは2枚、4枚、8枚での測定値を報告しています。モデルサイズ、精度、推論提供条件は7Bのスループット試験と異なります。対話型の結果は同種の試験を設計する参考にし、想定するプロンプトと同時実行数にはチーム独自の遅延目標を適用します。LIQIDの測定方法と対話型処理の結果
7Bの数値は、同じモデルインスタンスを追加しながらベンチマークを繰り返す理由になります。複数の処理を混在させたいチームにとっては、別の点も気になります。小さなファイルを多数読み込んだり、ストレージから文脈を組み立てたり、CPUによる画像の前処理を待ったりする時間があったらどうなるでしょうか。モデルとGPU枚数をそろえたまま、同じ要求の記録を、まずサービス単体に、次にすべてのサービスを動かした状態で流します。同時稼働でGPU使用率が低いのに待ち時間が増えるなら、アクセラレーターを増やす前に、ホストCPU、ファイルシステムの稼働、要求ルーティングを確認します。
遅延の制約内で使える成果を測ります
現在の構成でできる試験から始めましょう。たとえば、利用が承認され、言語とスキャンページ数が分かっている代表的な文書200件を選びます。その一括処理と並行して、対話型要求の到着時刻を匿名化した記録を再生します。2つのシステムに同じ組み合わせの入力を渡します。ハードウェアやソフトウェアの変更によって精度を変える必要がある場合は、同じサンプルで出力品質を確認し直します。チームの通常の品質基準を満たし、完了した結果だけを数えます。
- 良い結果の基準を決めます。 アシスタントなら、対象とする対話サンプルの95パーセンタイルで最初のトークンが2秒以内に返るなど、初回応答と全体の所要時間に目標を置きます。一括抽出では日ごとの締め切りと、検証を通過すべき最低ページ数を決めます。これらは提案する試験の目標例です。LIQIDが別に実施した72Bの試験では、最初のトークンに99パーセンタイルの条件を使っています。
- 要求が各段階に費やした時間を記録します。 到着、ワーカーでの処理開始、初回出力、完了の時刻を記録します。ジョブの種類を付記し、再試行も残します。こうした時刻があれば、キューで待った時間と実際の処理時間を分けて比べられます。推論が短時間で終わる場合、全体所要時間だけでは長い待ち時間が見えにくくなります。
- 条件を1つだけ変えて同じ要求を流します。 モデルインスタンスのカードへの割り当てを保ち、共有キューと独立キューを比較します。カードの割り当て変更は別の試験にします。プロンプトと出力の制限、投入順、品質確認を固定し、共通のウォームアップのあとに各試験を行います。平均的な負荷に加え、混雑時間帯も確認しましょう。都合の悪い時刻に大きなジョブが来るときに、キューを分ける効果が表れるはずです。
- 結果と一緒にホストと電力計も確認します。 同じ時間帯に、アクセラレーターの使用率とメモリ、ホストのCPUとRAM、読み書き、システム入力電力を記録します。ジョブ別の完了時間の95パーセンタイル、1時間あたりの成功ページ数または要求数、成功した結果1件あたりのエネルギーを報告します。受け付けられなかった処理も見えるように、パーセンタイルと一緒に未処理とタイムアウトを確認します。
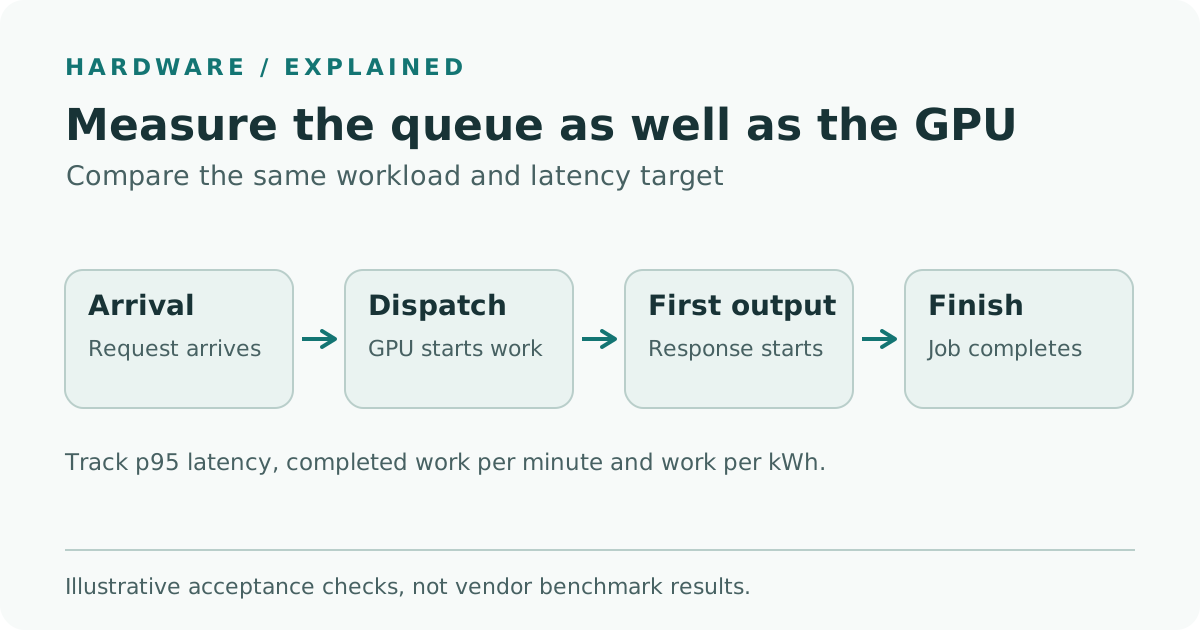
受け入れ試験の例を示したTelli.shの図です。キューの待ち時間、初回応答、完了時間のどこが動いたかで、制約の候補を絞れます。
サービスごとに遅延の分布を別に描きます。p95は、測定した事象の95%が完了するまでの時間です。中央値が変わらなくてもp95は動きます。担当者がいつも混雑時間帯にアクセスする場合は、この違いが重要です。分布ごとに測定件数も残しましょう。夜間ジョブ5件から求めたパーセンタイルと、数百件の対話型要求から求めた値は、異なる情報を伝えます。混雑サービスの待ち時間が継続して減り、品質が同等で、タイムアウトも減ったなら、ピーク時のスループットだけを見た場合より、専用カードを割り当てる根拠になります。
比較では同じ範囲を測る必要もあります。電力効率を比較するなら、決めた時間内に使える出力を数え、両方の構成で同じ機器を計測します。サーバーとGPUシャーシのみを測った場合は、ITシステムのエネルギーと表記します。共有ストレージや冷却を比較に含める場合も、両方の構成で同じ基準を使います。24時間稼働のサービスでは、アイドル時の電力も記録します。高速な構成は1ジョブに必要な稼働時間が短くなりますが、高いアイドル電力で夜通し待機すれば、1日あたりの消費電力量は増えるかもしれません。
22 kWは設置場所の検討に使う数値です
LIQIDはGPU30枚の空冷システム全体で約22 kWと案内しています。AMDはMI350Pの最大典型ボード電力を1枚600 Wとし、450 Wの設定にも対応するとしています。30枚に600 Wを掛けると、そのボード電力でカードの合計は18 kWです。メーカーが示した約22 kWはそれ以外の機器も含むシステム全体の値です。施設の消費電力、ラックへの給電、冷却能力は設置環境に左右されます。450 Wでの稼働は実用的なスループットにも影響する可能性があります。見積もり構成でベンダーが両方の設定に対応する場合は、同じ負荷と品質基準で比較します。LIQIDのシステム電力の案内 · AMD MI350Pのボード仕様
大きな構成を選ぶ前に施設の担当者と確認しましょう。シャーシの正確な数、通常時と冗長運転時の回路容量、実際の吸気条件で排出できる熱量、再起動直後に急に最大負荷に戻った場合の対応を調べます。保守やサポート、電力調整を誰が担当するかは見積もりで確認してください。こうした項目と、長い文書処理待ちのコストを関連付けて管理します。ホスト1台で管理するサーバーを減らせても、必要な電力密度によっては、機器を置ける部屋が変わります。
LIQIDはパートナーへの発注でGPU4〜30枚のシステムを提供すると案内し、供給は在庫状況によるとしています。製品ページには4〜6週間の納品フローが載っています。別に記載する4週間のリードタイムは、注文書の確定から数える条件です。日付入りの構成見積もりと設置先の納期を書面で確認してください。LIQIDはSC26の展示を11月17日からMcCormick Placeで行うと案内しました。LIQIDのパートナー発注と納品の案内 · LIQIDのSC26発表
費用をかけて減らすべき待ち時間はどれくらいでしょうか?
次のチームが翻訳済みの段落をすぐ必要とするなら、翻訳にアクセラレーターを専用で割り当てる価値があります。どの翻訳も翌日まで待てる場所では、同じカードが週の大半で使われないかもしれません。研究室の同時処理を再現できる最小構成で始め、最も忙しい時間帯を何度か再現してください。短い待ち時間が実際の成果を改善する箇所に容量を加えます。資料室なら、担当者が必要な回答を時間内に受け取りながら、1日分のスキャン資料を引き継ぎまでにすべて処理できるか、といった具体的な受け入れ基準が作れます。
出典
- LIQIDのSC26発表と公式UltraStack画像、2026年11月12日
- LIQID UltraStack AMD Instinct MI350Pの製品ページ、注文と電力の案内、2026年11月15日参照
- LIQID UltraStackのデータシート、2026年11月15日参照
- LIQIDフェーズ3のベンチマーク方法と結果、2026年11月15日参照
- AMD Instinct MI350Pカードの仕様、2026年11月15日参照
- SC26の2026年イベントと展示の公式日程
試験メモ、グラフ、導入時の判断を検索できる場所にまとめるには、Telli.shのアカウントを作成できます。