動いているロボットの指示を途中で変えられるか?
LeRobot 0.7に対話型ロールアウトが加わった。稼働中のロボットに指示を出し、見えたものと実際の動作を分けて、安全に試す方法を考える。
ロボットがスポンジのブロックを仕分けていると、赤い箱がいっぱいになった。次のブロックはもうグリッパーがつかんでいる。ここで役立つ操作画面なら、次の動作を変更する、カメラに何が見えるか聞く、試行を中断するという選択ができるはずだ。グリッパーが物を持っているとき、この三つがもたらす結果はそれぞれ違う。
11月5日、Hugging FaceはLeRobot 0.7.0を公開した。ロボットの実演を収集し、制御ポリシーを学習させ、実機で動かすオープンソースのツールキットだ。対話型ロールアウトではロボットとの接続と読み込んだポリシーを維持したまま、端末から新しい指示を出せる。対応ポリシーや外部プランナーが場面を解釈し、次のサブタスクを決めることもできる。同じリリースではデータセットのストリーミング、学習、リモート推論も改められた。実験の途中で人が何をできるかを変える点で、実行中の操作は特に見ておきたい。LeRobotの発表 · v0.7.0リリース
以下は、小規模な予備試験を計画するための作業台での例だ。モデルに頼んだこと、コントローラーが実際に送ったこと、そのあと観察できることを分けて考える。
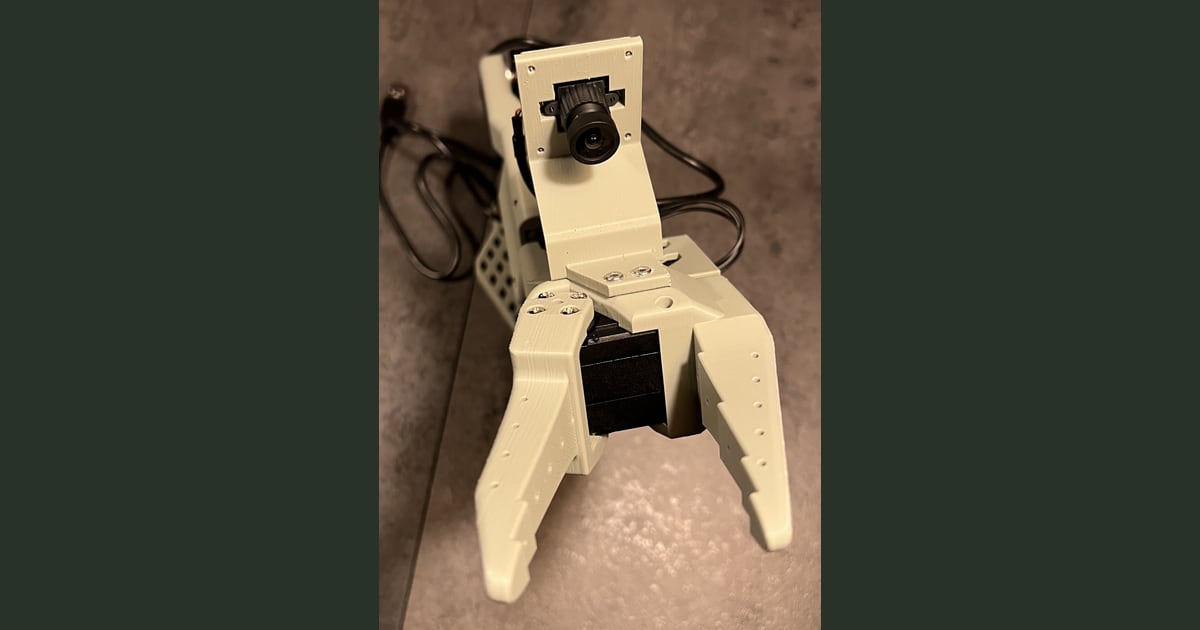
The Robot Studio撮影のSO-101用手首カメラマウント。この機器で使える取り付け位置の一例で、SO-ARM100プロジェクトのApache 2.0ライセンスの画像。Telli.shがサイズを調整し、余白を追加した。

三つのコマンドで操作の目的を切り分ける
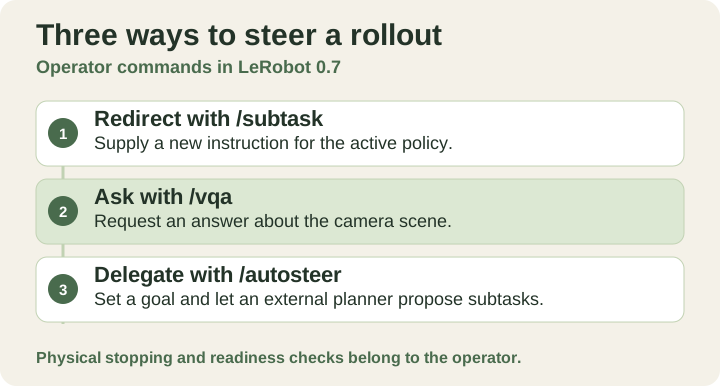
対話型コマンドとそれぞれの役割。Telli.shオリジナル図解。
ロールアウトとは、ポリシーが観測データを受け取り、動作を出す実行セッションをいう。観測にはカメラ画像や測定した関節位置が含まれることがある。バージョン0.7でオプション --interactive=true を設定済みの lerobot-rollout に加えると、次の指示までロボット接続、ポリシーの重み、処理コンポーネントを保持できる。発表資料にある端末コマンドは五つ。開始の /start と終了の /stop の間で、進行中のセッションに指示を出したり質問したりする三つの方法がある。LeRobotの発表 · v0.7.0ロールアウト文書
| 端末コマンド | 操作者の目的 | 確かめたい結果 |
|---|---|---|
/subtask | 動作ポリシーへの指示を入れ替える | 次の動きが新しい目標に向かうか、操作者が介入できる |
/vqa | ロボットに何が見えるかを聞く | 目の前の場面と照合できる回答が返る |
/autosteer | 目標を委ね、サブタスクの選択を任せる | システムがサブタスクを選び、操作者が制御を取り戻せる |
LeRobotの発表は、質問への回答や目標の処理に必要なテキストを生成できるポリシーの例に、FineART-VLAとWall-OSS-0.5を挙げている。テキストを生成しない動作ポリシーには、対応する外部の視覚言語モデルでその機能を補える。同リリースでは、ローカルでもホスト環境でも、このプランナーにOpenAI互換APIを使えると説明している。外部プランナーは視覚に関する質問に答え、ポリシーに指示を渡せる。サブタスクをロボットの動作に変換するのは動作ポリシーの役割だ。対話型ロールアウトと外部プランナー · v0.7.0ロールアウト文書
物の多い作業台なら、この区別がはっきりする。カメラから容器のふちが見えなければ、もっともらしい説明が返っても証拠は乏しい。プランナーが正しく青いブロックを選んでも、グリッパーから滑り落ちれば、言語処理は成功し、実機の試行は失敗したことになる。質問、ポリシーの動作、結果を分けると、カメラを動かすべきか、指示を変えるべきか、把持を改善すべきか判断しやすい。
小さな作業で途中の目標を変えてみる
色分けした箱を二つ、柔らかいブロックを三つ、対応するアームを一台用意する場面を考える。赤いブロックを拾うなど既知の作業から始め、似た条件でポリシーがすでに扱えた別の目標を選ぶ。初回はブロックに触れる前に指示を変更する。切り替わったことが確認できたら、最初の状態に戻し、もっと動作が進んでから変更してみる。アームが動いている最中の指示と、グリッパーが閉じたあとで送る指示では、ポリシーに求めることが違う。
新しい目標に向かった最初の動きと、ブロックが最終的に置かれた場所を観察する。動画の時刻で目に見える方向転換までの時間が分かり、端末の時刻で指示を打ったときが分かる。両方残せば、入力は受理されたが動作の変化が分かりにくい場合でも、遅れを読み解く手がかりになる。停止条件を先に決めておけば、起きるか分からない修正を待ち続けずに済む。
別の例は、試験後に作業台を元に戻すことだ。物を一つだけ所定の位置から外し、テーブルに何が残っているか聞く。片付けを頼む前に、遮るものがない場合と一部が隠れた場合を試す。カメラの角度で回答が変わるなら、配置を見直すか目標を絞る理由になる。ポリシーの挙動をつかむまでは、慣れた動作を一つずつ任せる。
三度目は /autosteer に「スポンジのブロックを二つ、同じトレイに片付ける」のような目標を渡す。システムが途中で何を選んだか記録する。最初に妥当な物を選んでも、二つ目が届かない場所にあると、人の助けが要るかもしれない。この目標の使い方は、各サブタスクを予想した簡単な手順と照合できるときに役立つ。記録を見れば、プランナーが悪い手順を選んだのか、ロボットが適切な手順をうまく実行できなかったのかを切り分けられる。
ソフトウェアの停止と実機の停止は別々に試す
対話型セッションでは、ロボットを見ている人がすぐに指示を出せる。同時に、新しい指示が効いたと思っているのに、目の前では以前の動作が続く時間も生まれる。予備試験では四つの時点を分けて記録する。指示を送った時刻、確認信号があれば実行側が受理した時刻、観察できる挙動が最初に変わった時刻、そして最後の状態だ。受理が確認できなければその欄は空欄にしてよい。ほかの三つからでも学べることはある。
LeRobotのバージョン別デプロイ文書では、対応ロボットの修正操作で使うソフトウェアの位置保持が説明されている。ドライバーが適用した最後の目標位置を更新し続ける仕組みだ。荷重のかかったアームはその位置に向かって落ち着くことがあり、グリッパーの挙動は実機で確かめる必要がある。言語インターフェースはこうした機構の上にある。機器に合った物理停止と監視の手順を維持し、動作中の変更を試す前に、周囲を片付けた状態で停止の効果を確認する。v0.7.0ロールアウト文書
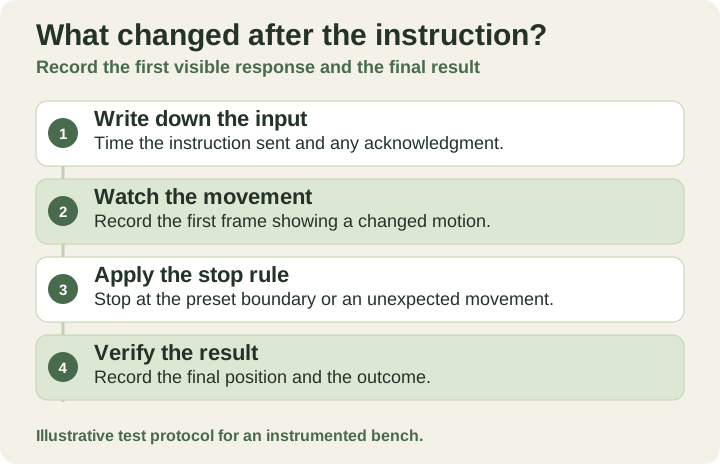
指示変更を送った時刻、動作が変わった時刻、試行がどう終わったかを記録する。Telli.shオリジナル図解。
一見成功した試行の見方も変わる。正しいトレイにブロックが一つ入っていても、その前に操作者が二度、誤った動きを止めたかもしれない。介入の頻度と、残った状態から再開できた頻度を測る。通常の失敗状態から復帰できるポリシーと、失敗のたびに全体のリセットを要するポリシーでは、人に求められる役割が違う。作業空間と物を揃えた試行で比べたい。
FineARTは途中の手順も学習データにする
このリリースでもう一つ注目したいのが実演データだ。記録が順調な開始と成功した終了しか示さなければ、指示が変わったときにポリシーにどの挙動を学ばせたいか分かりにくい。サブタスクのラベルを付けると、物をつかむ、置く、次の物に移るといった動作の切り替わりを学習工程に伝えられる。
Hugging FaceとScale AIは、FineARTについて両腕を用いるエピソードが4万件超、1,718時間、サブタスク注釈が53万3,000件超と報告している。11月5日の発表によると、LeRobot形式で1.9 TBだ。FineART-VLAはπ0.5を土台とし、動作部分が実際に動く前に、言葉で表したサブタスクを予測できる言語出力部を加えた。数字は著者らのデータセットについてのもので、言語と動作の分担はモデル設計についての説明だ。形の異なるグリッパー、視野の狭いカメラ、学習になかった物を使うなら、必要な評価も変わる。リリース発表とFineARTの説明 · FineART-VLA文書
小さな修正データセットを集めるなら、あとで何を再現したいか決める。新しい指示、該当のカメラ映像、変更時点の状態、観察した結果を含める。「赤い箱がいっぱい」というラベルと「次の赤いブロックは空のトレイに置く」という指示では役割が異なる。前者は状態を説明し、後者はそれを受けて何をするかを伝える。試験に両方必要なら、両方残す。後のポリシーを、試験のきっかけになった場面で評価できるよう、失敗した例も保存する。
最初の予備試験は作業台一つでできる
-
バージョンを固定し、対応する組み合わせを選ぶ。 プロジェクトのバージョン別文書を使ってLeRobot 0.7.0を導入する。ロボット、カメラの構成、選んだポリシーが既知の作業で動くか確認する。11月5日のリリースノートによれば、Linuxの既定のPyTorchビルドはCUDA 13を使い、その場合はNVIDIAドライバー580.65以降が必要だ。古いドライバーには文書記載の別の導入方法を使う。ドライバーの変更とロボットの挙動は別の試験とする。インストール文書 · v0.7.0リリース
-
途中の指示を加える前に基準の試行を一回行う。 片付けた作業台で、動作範囲を絞り、アームを監視する。開始時の姿勢と目標を保存し、ポリシーが作業を完了したか記録する。通常の試行と指示を変えた試行を比べるときは、カメラ位置、照明、対象物を揃える。SO-101セットアップ文書
-
動作確認済みのロールアウトに対話型オプションを加える。 端末からセッションを開始し、サブタスクを一つ送り、一度変更して終了する。次はリリースで紹介された端末コマンドに、例の指示文を付けたものだ。対話型セッション文書
プレーンテキスト/start /subtask move the red block to the tray /subtask move the blue block to the tray /stop -
基準の試行が再現できてから、視覚への質問と小さな目標の委任を加える。 テキスト生成対応のポリシーを選ぶか、文書に沿って外部プランナーを設定する。同じカメラ映像を見れば人にも答えられる質問から始める。終了条件が目で分かる目標を試し、プランナーが使えない場合や有用なサブタスクを出せない場合も記録する。外部の接続先を使うと観測の処理場所も変わり得る。カメラが試験台の外まで映すなら重要な点だ。外部プランナー文書
-
完了だけでなく復帰も比べる。 条件を揃えて数回繰り返し、失敗はすべて残す。何が起きたかを操作者が確認し、適切に介入し、最終状態を確かめられたか記録する。少数の試行は環境の調整に役立つ。信頼性を主張するには、実際に遭遇する条件を広く含む、はるかに多くの証拠が要る。
0.7.0では従来の非同期推論インターフェースも、ポリシーサーバーとリモートロールアウトに置き換わった。推論をGPUサーバーに移すなら、実際の回線でも時間と中断の試験を繰り返す。サーバーで計算能力を増やせる一方、新しい観測から次の動作までにネットワークが介在する。回線が遅い場合や切れた場合も独立した試験項目になる。v0.7.0の互換性に影響する変更 · リモート推論文書
試したいのは作業の途中
ロボットのデモで興味深いのは、予定していた手順が状況に合わなくなる瞬間だ。箱がいっぱいになる、物が動く、カメラが見落としたことに人が気づく。LeRobotの端末コマンドなら、その瞬間を実験に組み込める。監視する人が何が変わったかを把握し、次の動作を切り替え、自分の目で結果を確かめられるかが試される。
出典
作業の背景にある判断や試験を検索できる記録に残すなら、Telli.shのアカウントを作成できます。