Deep Hat Sift、エージェントの実行を省くにも人の承認を求める
Kindoのイベント選別モデルは、エージェントが対応不要と判断するアラートを学びます。シャドウモード、しきい値の確認、見落としの抽出が、大量処理の費用と品質をどう変えるかを解説します。
運用エージェントは、アラートを適切に調べていても、一日の大半を「対応は不要」と結論づけることに費やすかもしれません。件数が増えると、判断は正しくても何も起きない実行の積み重ねが、システム設計上の課題になります。
Kindo は、2026 年 10 月 28 日に Deep Hat Sift を発表しました。これは、エージェントの判定とスコアから学習し、どの受信イベントが実行に値するかを学習する System One 意思決定モデルです。これはシャドウ モードで開始され、すべてを通過し、人がしきい値を承認した後にのみイベントの配信抑制が開始されます。 Kindoのお知らせ。
注目したいのは、「実行を始めない」という不在の判断にも承認が必要な点です。本稿では、この判断を説明し、より単純なコスト管理策と比較します。さらに、減らせた呼び出しと併せて、重要な見落としも測る試行を考えます。
 メリーランド大学の物理セキュリティ監視センター、2008 年発行。過去のアラート監視コンテキスト。これには、Kindo、Sift、またはサイバーセキュリティ ダッシュボードは表示されません。写真: UMD-Eskin、パブリックドメイン。余白を付けてリサイズ。 画像ソース · ライセンスと画像の注意事項。 公式製品情報

実行を省くと、システムが観察できる範囲も変わる
すべてのイベントがエージェントに到達すると、システムはすべての判定を検査できます。フィルターがイベントの保留を開始すると、その単純なフィードバック パスが変更されます。最も興味がないと判断されたイベントは、エージェントの完全な注意を受けられなくなります。
これにより、フィルタリングは、同じリクエストに対してより安価なモデルを選択することとは異なります。安価なモデルでも各イベントの結果が生成されます。保留の決定により、通常のパスから実行が削除されます。測定計画では、その欠落した結果を考慮する必要があります。
本稿では、実行を省くこと自体を、責任者のいる製品動作として扱うべきだと考えます。何を根拠に許容し、どのイベントを保護し、入力元が変わったらどうするかを誰かが決める必要があります。見えない最適化として扱うと、その判断を見直しにくくなります。
フィルターを配車の窓口と考えてください。何を残したか記録しつつ、適切な仕事を先へ送る役割です。後続の専門家は届かなかったものを調べられないため、この振り分けの品質が重要になります。
試験では、フィルターの成功を定義する前に、エージェントの役割を定義します。インシデントの特定、背景情報の追加要求、問い合わせの振り分け、調査の準備のどれでしょうか。「実行が必要」はその役割に対応しなければなりません。そうしないと、一貫していても運用目的と違う判断を学ぶ可能性があります。
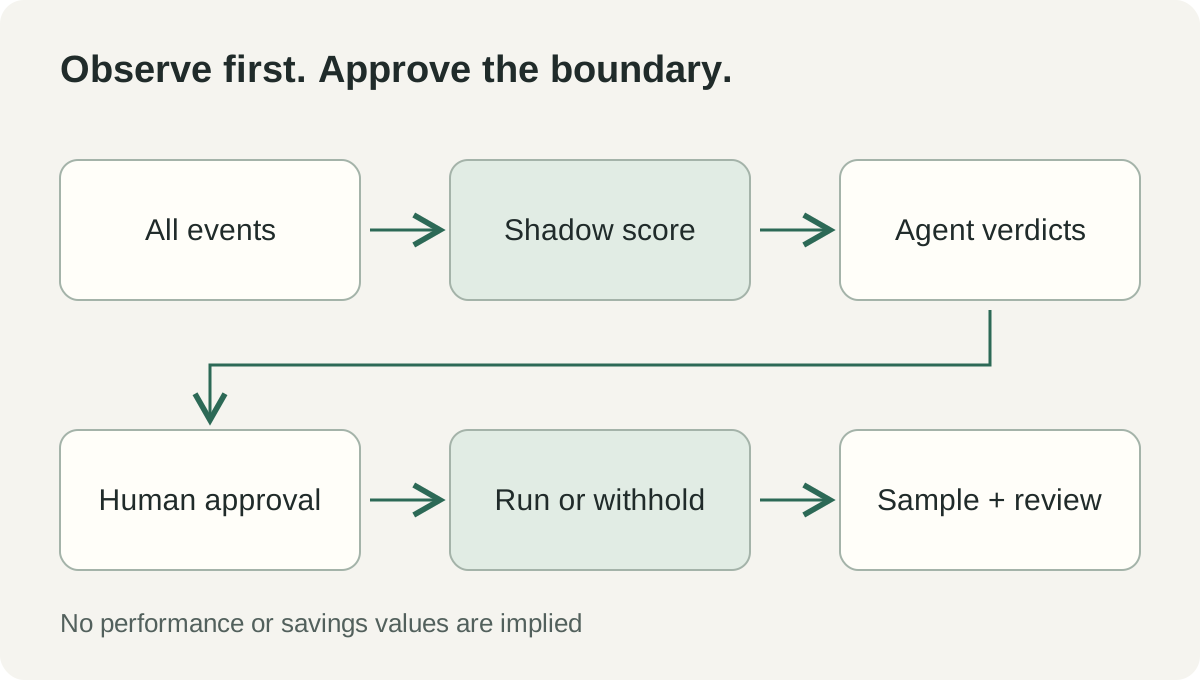 Kindoの発表にある、シャドウ観察から承認までの流れを独自に図示。実際の配備図ではなく、簡略化した運用の説明です。
配信を変える前に、シャドウモードで比較する
Kindoの10月28日の発表は、全イベントを対象エージェントへ送りながらSiftが採点する、最初の観察期間を説明しています。その後、入力元ごとの結果を使って配信抑制案をプレビューします。承認には理由の記載があり、有効化後も無作為の一部を通して見落としを調べます。公表された運用方式。
この順序なら、運用チームは「もしその基準を適用していたら」を検討できます。配信を変える前に、提案されたしきい値では過去のどの実行が省かれたかを調べられます。イベントの発生元とエージェントの責任者が、一緒に確認できる具体的な問いです。
プレビューは集計だけでなく具体例も含めます。大量の日常イベントが全体の比率を支配する一方、少数でも重要な分類で悪い動作をしている場合があります。省く損失が大きいものと、提案した境界の近くにあるものを、承認者に見てもらいます。
観察期間は、必要な状況を網羅できる長さにします。忙しい平日、週末、リリース日、例外的な障害では様子が異なります。判断に関係する条件を含んで初めて、期間に意味が生まれます。静かな日が一定日数続いたことを、どの環境でも使える準備完了の合図にしてはいけません。
承認には想定する運用条件を明記します。「この入力元とエージェントについて、この除外条件と確認間隔で承認した」という記録なら、単なる「はい」より役立ちます。入力構造、プロンプト、運用優先度が変わったときに再検討できます。
三つのキューでは、注意すべき点が異なる
繰り返すインフラのアラートは、範囲を限定しやすい
SRE キューが定期メンテナンス中に既知の通知を何度も繰り返し受信すると想像してください。チームはすでにソースを理解しており、緊急の例外に対する文書化されたルートを持っています。試験運用では、エージェントが同じ対応不要の判定に至るまでに繰り返し時間を費やしていないかどうかを調査することができます。
まず、既知の重複処理を新しい決定から分離します。単純な相関ルールによって同一のイベントがすでに折りたたまれている場合は、そのベースラインを保持します。モデル評価を使用して、完全なエージェントの実行にコストがかかる、または不要になる残りの変動を調べます。
シャドウ観察中は、省くという提案と、エージェントの実際の対応を比べます。表面上似たイベントを区別する重大度、対象サービス、背景の変化を探します。運用側が既に重要とする違いを、フィルターが保てるかが有用な問いです。
例えば、定めた確認率を満たし、評価中に保護対象のイベントを見逃さないことを達成条件にできます。これはチームが選ぶ条件で、Siftの普遍的な保証ではありません。直ちに全社へ広げず、一つの入力元について明確に判断するための試験です。
フィッシング報告では、見落とす損失の非対称性を考える
従業員が不審なメッセージを報告するセキュリティ チームの例を考えてみましょう。多くのレポートではそれ以上のアクションは必要ありませんが、まれにアクション可能なメッセージが不釣り合いに重要になる場合があります。フィルターの経済性はその非対称性に依存します。
この入力元では、通常の通信に似ていても、チームが重視する兆候のある例を確認します。後続のセキュリティツールとインシデント処理は維持します。AIエージェントの前のフィルターは、検出全体の代わりではなく、振り分け判断として評価します。
評価には、調査を怠った場合の結果を理解しているアナリストが参加する必要があります。財務関係者は、実行コストの定量化に協力できますが、許容可能なインシデント範囲を単独で定義することはできません。しきい値は共有の運用上の選択であり、その承認には適切な専門知識が必要です。
エージェント自身の誤りも確認してください。エージェントが不要と判断する傾向を学ぶと、その盲点まで再現する可能性があります。アナリストが別途確認した評価セットを用いれば、エージェントとフィルターが一致していても、両方がチームの求める結果から外れる事例を見つけられます。
問い合わせキューでは、有用な対応の定義が必要
例示的なサービスデスクでは、チケットは日常的に見えるかもしれませんが、依然として確認応答、サービスレベルタイマー、またはルーティングステップを必要とします。したがって、「調査は必要ありません」と「エージェントの実行は必要ありません」は異なるラベルになる可能性があります。保留された実行で何を省略できるかを正確に定義します。
必要に応じて、必須の処理は曖昧なモデル判断から切り離します。たとえば、受付確認はチケットシステムが必ず行い、特定の調査エージェントを起動するかだけをモデルが補助する構成です。こうすれば責任の境界を説明しやすくなります。
さまざまなチーム、言語、リクエスト タイプからのチケットをテストします。主に 1 つの部門の日常的なリクエストに基づいてトレーニングされたフィルターは、別の部門のエスカレーション パターンとあまり一致しない可能性があります。ソース固有の評価は、ボリュームだけで 2 つのキューが同等になると仮定するよりも役立ちます。
この試験の成果は、問い合わせ件数を減らすことではなく、調査キューを整理することかもしれません。人への引き継ぎと、次の意味のある対応までの時間を測ります。呼び出し数の少なさだけでなく、サービス品質に結び付けて評価できます。
四つの費用管理は、異なる問いに答える
次の比較では、チームが評価できる設計の選択肢について説明します。特定のベンダーの実装がすべてのカテゴリーで優勝するとは主張しません。複数のコントロールは異なるポイントで動作するため、同じシステムに属する場合があります。
| 管理策 | 判断する内容 | 測定するもの |
|---|---|---|
| 重複排除・相関ルール | 繰り返し、または関連するイベントか | 別々のインシデントを保ちつつ、重複をまとめられたか |
| 各イベントに安価なモデルを使う | より低コストの分析で対応できるか | 品質と、一件あたりの総費用 |
| Siftなどの実行選別フィルター | そもそもこのイベントに、このエージェントが必要か | 省けた実行、対応すべき見落とし、確認範囲 |
| 呼び出しごとの予算・振り分け | どのモデル呼び出しが許可され、予算内に収まるか | 支出、拒否された呼び出し、後続作業の完了 |
判断の種類から比較すれば、節約の二重計上を避けられます。相関ルールで既に取り除いた繰り返しイベントを、フィルターの実行削減として再び数えることはできません。既存の制御後を基準にし、追加の効果を計算します。
フィルター自体の運用コストも含みます。ホスティング、モニタリング、サンプル実行、人間によるレビューはすべてパイロットの会計に属します。 1 つのプロバイダー エンドポイントに対する請求額が少なければ便利ですが、それは完全なワークフローの 1 つのコンポーネントにすぎません。
品質と費用は一緒に扱います。有用な仕事を隠しながら多くの呼び出しを省くしきい値は、サービス自体を変えています。一般的な正解率一つではなく、実際のキューに即して、その引き換えを説明できる必要があります。
抽出して確認した見落としから、評価の問いを改善する
11月2日に確認したKindoのFAQは、配信抑制対象の一部を通す比率を既定で 3%、設定範囲を 1%〜5%、初期に必要な判定ラベル数の既定下限を 400件 としています。ドリフトや設定した上限の超過で、シャドウ動作へ戻ると説明しています。公開された既定値であり、すべての仕事で十分な根拠が得られるという保証ではありません。
抽出範囲が重要な理由を、計算例で示します。配信を抑えた10,000件から3%を抽出すれば、約300件です。重要な事例がまれなら、その300件が、見落としの重大な分類を代表するかも調べる必要があります。サンプリングの問題を示す計算で、Siftの実際の誤り率の推定ではありません。
自分たちの評価では、少なくとも二つの分母を明示しましょう。一つは、対応が必要なイベントのうち、フィルターが見逃す割合です。もう一つは、実行を省いたイベントのうち、後に対応が必要と判明した割合です。前者は重要な作業をどれだけ拾えているか、後者は省いた集合に対応対象がどれだけ混ざるかという、異なる運用上の問いに答えます。
入力元の種類、重大度、チーム、入力形式の変更ごとに分けて確認します。全体が改善しても、小さな分類が悪化することがあります。分類はグラフの描きやすさではなく、運用上のリスクと負荷を反映するべきです。
最後に、エージェントの判定と、独立した確認による結果を区別します。エージェントとの一致率は、Siftがそのエージェントをどれだけ予測できるかを測ります。それだけでは、エージェント自体の判断の正しさを証明しません。意味を明示すれば、どちらの指標も役立ちます。
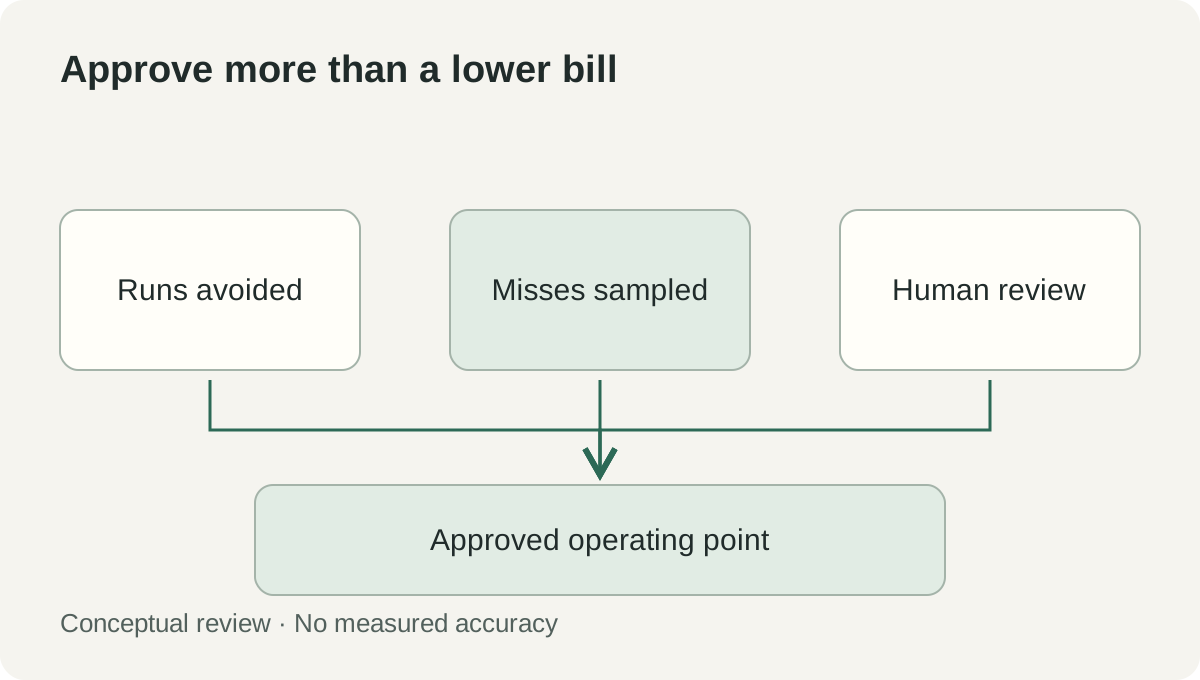 独自に作成した判断レビュー支援図。これはオペレーターが比較すべき内容を示しており、節約の測定値や精度の値は含まれていません。サンプリングと承認については、Kindo の製品ページ に文書化されています。
現行の導入条件も、試験の対象にする
11 月 2 日の時点で、Kindo では、Sift を Kindo エージェントのセルフホスト型サービスとして説明しています。その FAQ には、単一ホストの Docker Compose 導入、クラスタリングやフェイルオーバーなし、SSO や MFA なしのローカル アカウントがリストされています。個別の Sift の無料トライアルや使用量枠はありません。 現在のリリースに関するよくある質問。
これらの条件は、パイロットがどこに適しているかに影響を与えます。 ID、可用性、インシデント対応の責任者とデプロイメントの境界を確認します。スコアリングのデモンストレーションが成功しても、サービスが組織の運用要件に適合しているかどうかを判断することはできません。
- 入力元、エージェント、判断責任者を定めます。 エージェントの仕事と、実行を省いたときに失われるものを書きます。既存の検出と問い合わせ処理の責任は維持します。
- Kindo で現在の展開要件を確認してください。 利用可能なホスティング契約とチームが所有する運用サポートを確認してください。
- 合意した比較基準を定義します。 既存のルール、相関処理、モデル振り分けを含め、追加の価値を測れるようにします。
- シャドウ モードで開始します。 配信を変更する前に、代表的な判定を収集し、重要なカテゴリ全体で提案されているイベントの配信抑制を検査します。
- エラーを個別にレビューします。 対象エージェントとの合意に完全に依存するのではなく、アナリストがレビューした例と保護されたケースを含めます。
- 特定の動作点と理由を承認します。 範囲、レビュー担当者、サンプリング計画、および再レビューが必要な条件を記録します。
- シャドウモードへ戻す手順を試します。 運用担当者への表示と、全イベントが再びエージェントへ届く流れを確認します。費用、品質、可用性を最終評価に含めます。
最後には、責任者のいる、範囲を限定した運用判断を下せるようにします。不確かな分類が分かり、そこは引き続き全件を分析すると決めることも有用です。最初から省く件数を最大化するのではなく、どの条件で配信抑制を正当化できるかを知ることが重要です。
省いた呼び出しの価値は、必要な作業を隠していないと説明できるかで決まる
Sift は、エージェントのワークフローに重要な疑問をもたらします。それは、どのイベントが完全な実行に値するのか、その境界の責任者は誰なのかということです。そのシャドウファーストのアプローチにより、チームは配信を変更するために使用する前に決定を検討する機会が得られます。
長期的な基準は、節約できた実行、確認した見落とし、現在のしきい値が引き続き適切な理由を、運用側が示せるかどうかです。そうして初めて、何も実行しなかったことが、責任を持って説明できる判断になります。
出典
- Kindo の Deep Hat Sift の発表、PR Newswire を通じて配信、2026 年 10 月 28 日、東部時間 09:00。
- Kindo: Deep Hat Sift 製品の詳細と最新リリースの FAQ、2026 年 11 月 2 日に確認。
決定の背景となる資料を保存する
Telli.shは、利用を許可された資料を、確認済みのメモと一緒に残すための選択肢です。ノート用ワークスペースを作成する。