Granite Switch 4.1:英語音声を次の判断につなげる
Granite Switch 4.1を試し、現実的なセットアップ、メモリ、プライバシー、コストの指針とともに、チャット・英語音声認識・判断の実用ワークフローを構築します。
音声での依頼には通常、言葉を聞き取り、意味を説明し、次に何をするか決めるという3種類の作業が必要です。Granite Switch 4.1は、3つのモデルサーバーを個別に組み立てなくても、これらの機能を1つのエンドポイントから利用できます。
IBMは2026年10月15日の発表で、チャット、汎用の判断アダプター、Guardianによる安全性チェック、音声認識をまとめた8B版と30B版を公開しました。実用面での魅力は、英語の音声メモから人が確認できるアクションまでの道のりを短くできることです。IBMの発表記事、2026年10月15日。
このガイドでは、まず簡単なブラウザー演習を行い、次にローカル環境の構築と3つの実用ワークフローを紹介します。英語音声は多言語音声ではないこと、判断スコアは証明ではないこと、モデルの重みだけでGPUメモリの使用量が決まるわけではないことも説明します。
ヒーロー画像:英語音声が文字起こしになり、チャット応答、判断の選択肢、安全性チェックへ分岐するオリジナルの解説図。最終アクションの前に人が確認します。公式スクリーンショットでも、性能の主張でもありません。
インストール前に、まず役立つ結果を1つ得る
公式のSpeech to Decisionsデモから始めましょう。IBMは10月15日の発表でこのデモを紹介しています。デモのドキュメントには、マイクからのリアルタイム入力、短いトピック説明、安全性チェック、はい/いいえの判定が記載されています。公式デモのドキュメント、2026年10月18日確認。
-
デモを開き、架空の内容など、機密性のない情報だけを使います。これはホスト型サービスであり、ローカル処理ではありません。
-
アプリを利用できる場合はマイクへのアクセスを許可し、ASRが対応する英語で次のように話します。
プレーンテキストThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow.意味:「交換品のキーボードが破損して届きました。新しいものを送ってください。明日なら写真を共有できます。」発話する文は、英語音声認識の動作確認用に原文のままにしてください。
-
録音を止め、表示された文字起こしを実際に話した内容と照合します。トピックの説明と判定フラグも、それぞれ別に確認してください。
-
依頼内容、破損した品物、約束したフォローアップが保持されているか確認します。否定表現が抜けたり品物が変わったりしたのに、もっともらしいトピックラベルが出たことを成功と見なしてはいけません。
これは有用な最初のチェックポイントです。入力が理解され、出力を自分で確認できます。ただし、文言の完全一致、応答時間、デモが常時利用できることを保証するものではありません。Spaceが利用できない場合や組織が外部への音声アップロードを禁止している場合は、機密情報を外部に送らず、後述のローカル環境に進みましょう。
Switchは何を切り替えるのか?
ベースの言語モデルは通常のチャットを処理します。アダプターは、特定のタスクに特化するための学習済み調整をまとめた、より小さな構成要素です。decisionアダプターはラベル付き選択肢から選び、guardian-coreは特定の安全上のリスクがないかテキストをチェックします。モデル全体をもう1つ読み込むのではなく、チャットテンプレートを通してアプリがアダプターを選択します。Granite Switchリポジトリ、2026年10月18日確認。
音声は別の経路をたどります。自動音声認識(ASR)が波形をテキストに変換してから、言語モデルが読み取ります。同梱の認識器はIBMの4億7,000万パラメーターの英語版Granite Speech TurboCTCモデル、2026年10月18日確認です。この文字起こしを引き継ぎ記録と考えてください。後続の処理はすべて、ここに記録された言葉に左右されます。疑わしい判断を入力までさかのぼって確認できるよう、整形した要約と一緒に文字起こしも保管しましょう。
| チェックポイント | 状況と想定される開始方法 | 音声について |
|---|---|---|
granite-switch-4.1-8b | 公開済み。構成済みモデルのうち小型の選択肢 | 英語ASRを含む |
granite-switch-4.1-30b | 公開済み。同じ機能一式を備えた、より大きなベースモデル | 英語ASRを含む |
granite-switch-4.1-3b-preview | アダプター構成が異なるプレビュー | 公開済みの音声対応構成ではない |
8Bモデルカード(2026年10月14日公開)では、音声対応の公開版と音声非対応のプレビュー系列が区別されています。30Bカードと3Bプレビューカードは、2026年10月18日時点で、それぞれの構成を説明しています。小型のプレビュー版を、音声対応版の代わりにそのまま使うことはできません。
8Bのモデルカードには、英語、ドイツ語、スペイン語、フランス語、日本語、ポルトガル語、アラビア語、チェコ語、イタリア語、韓国語、オランダ語、中国語の12言語がチャット対応言語として記載されています。ただし、この一覧によって既定の音声認識器が英語以外にも対応するわけではありません。
コマンドをコピーする前にOSを選ぶ
ここで紹介するCUDA/vLLM構成には、互換性のあるNVIDIA GPUとドライバーを備えたLinuxを選びます。WindowsではGPUアクセスを適切に設定したWSLを使ってください。以下のBashコマンドは、PowerShell用ではありません。macOSでは、このCUDA手順がApple Siliconにも適用できると考えず、ホスト型の演習かLinux搭載GPUマシンから始めましょう。vLLMのGPUインストール手順、2026年10月18日確認。
vLLM-Metalなどのランタイムには、それぞれ独自の互換性要件があります。OSに対応したランタイムだからといって、このSwitchチェックポイント、そのアダプター、音声処理の連鎖がすべて動くとは限りません。その経路を選ぶ前に、同じ構成で動作する例を確認してください。
まずローカルでチャットを動かし、音声と判断を追加する
LinuxまたはWSLのBashターミナルで、新しい作業フォルダーを使います。最初にGitとPython 3.12をインストールし、nvidia-smiでGPUが認識されることを確認してください。ここで参照するリポジトリのスナップショットは、Python >=3.11,<3.14、PyTorch >=2.11.0、Transformers >=5.16,<=5.17.0、vLLM >=0.26.0,<0.31.0を必要とします。リビジョン7e72456のパッケージ宣言、2026年10月18日確認。
- Switchパッケージと音声依存関係をまとめてインストールします。 古い公開済みwheelに依存せず、ソースで確認できる手順に固定します。
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
追加機能はタスクごとに異なります。[hf]はHugging Face推論サポート、[compose]は構成ツール、[audio]はvLLMの音声デコード依存関係を追加します。vllmだけをインストールしてもSwitchプラグインは入りません。解決されたPyTorch/CUDAの組み合わせがドライバーと互換性を保つようにしてください。依存関係の解決エラーを、チェックを外して回避してはいけません。初回利用時にはモデルの重みがダウンロードされるため、録音を始める前にチェックポイントの取得時間とディスク容量を確保しましょう。
- ループバック接続だけを受け付けるサーバーを1つ起動します。 以下のコンテキストと同時実行数は、控えめな初期値であり、ハードウェアに収まる保証ではありません。
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
このパッケージはvllm.general_pluginsにregister_granite_switchを登録します。vLLMはインストール済みのエントリーポイントを検出し、環境変数でこのプラグインを明示的に選択します。この手順では、登録スクリプトをコピーしたり、--trust-remote-codeで回避したりする必要はありません。Switchの登録元コードおよびvLLMのプラグインシステム、2026年10月18日確認。
- 通常のチャット応答を確認します。 2つ目のBashターミナルでサーバーの準備ができるまで待ち、次を実行します。
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
JSON応答内のassistantメッセージを読みます。注文番号、期限、返金の承認をでっち上げずに依頼内容を保てていれば成功です。HTTP応答が返っただけでは、役立つ回答かどうかは確認できません。
- 短い英語WAVを送ります。 同意を得た機密性のない録音を、リポジトリのフォルダーに
request.wavという名前で置きます。2つ目のターミナルで同じ仮想環境を有効にし、次をtry_audio.pyとして保存してpython try_audio.pyを実行します。
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
これは内部で挿入された文字起こしをもとにした言語モデルの応答であり、未加工のASR出力ではありません。音声ガイドには処理の連鎖と入力形式が記載されています。両方の段階を個別に確認する必要がある場合は、文字起こしを表示できるアプリを使ってください。音声ドキュメント、2026年10月18日確認。
- 確認済みのテキストを使い、範囲を限定した判断を1つ試します。 サーバーを起動したまま、次を送信します。
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
これはアダプターの選択を試し、確率の報告ではなくラベルを1つ返すよう求めています。確率を確認するには、モデルカードの判断例、2026年10月18日確認に従い、ラベルがそれぞれ1トークンであることを確かめ、logprob_token_idsを要求し、候補ラベル間で正規化してください。判断アダプターの読み出しドキュメント、10月18日確認では、選択肢レベルのsoftmaxを説明しています。「95%の確信があります」というチャット生成文を確率の代わりに使ってはいけません。
自動化するだけでなく、3つのワークフローを人が確認できる形にする
以下は実例の報告ではなく、用途の例です。まず人が確認しやすい出力から始め、代表的なケースを評価してから、重大な結果を伴うアクションを追加してください。
顧客の音声メッセージを振り分ける。 ASRで依頼を捉え、チャットで中立的な要約を作り、判断の質問で交換対応、アカウントサポート、人による振り分けから選びます。元の音声を、確認済みの文字起こしにひも付けて保管します。「注文をキャンセルしないでください」という依頼は、キャンセルの自動化を始めた後ではなく、最初から意識的にテストすべきケースです。
受け入れ条件は明確です。選ばれた窓口が実際の発言に合っているか、何かを送信する前にサポート担当者が修正できるかを確認します。安全性フラグは追加確認を求めるために使えますが、怒っている顧客の苦情を黙って破棄してはいけません。
プロジェクトの進捗報告をタスク案にする。 同僚が「I can review the draft Friday, but I cannot approve the budget.(金曜日に草案を確認できますが、予算は承認できません)」と録音したとします。チャットに約束と対象外事項を分けさせ、次に判断アダプターへ、予算承認がある・ない・不明のどれかを尋ねます。録音や文脈が不十分なときに備え、「不明」を選択肢に残します。共有トラッカーにタスクを登録する前に、人が日付と担当を確認します。
インタビュー後の確認事項を準備する。 話者の許可を得たうえで、短い英語のインタビュー抜粋を文字起こしし、不足情報について質問案を作ります。たとえば、"Does this passage explicitly name a delivery date?"(この箇所では納期が明示されていますか?)のように範囲を限定して判断させ、「この人は信用できますか?」とは尋ねません。各フラグの根拠となった抜粋を残します。そうすれば、モデルの解釈を話者への評価と見なさず、意見の違いを検討できます。
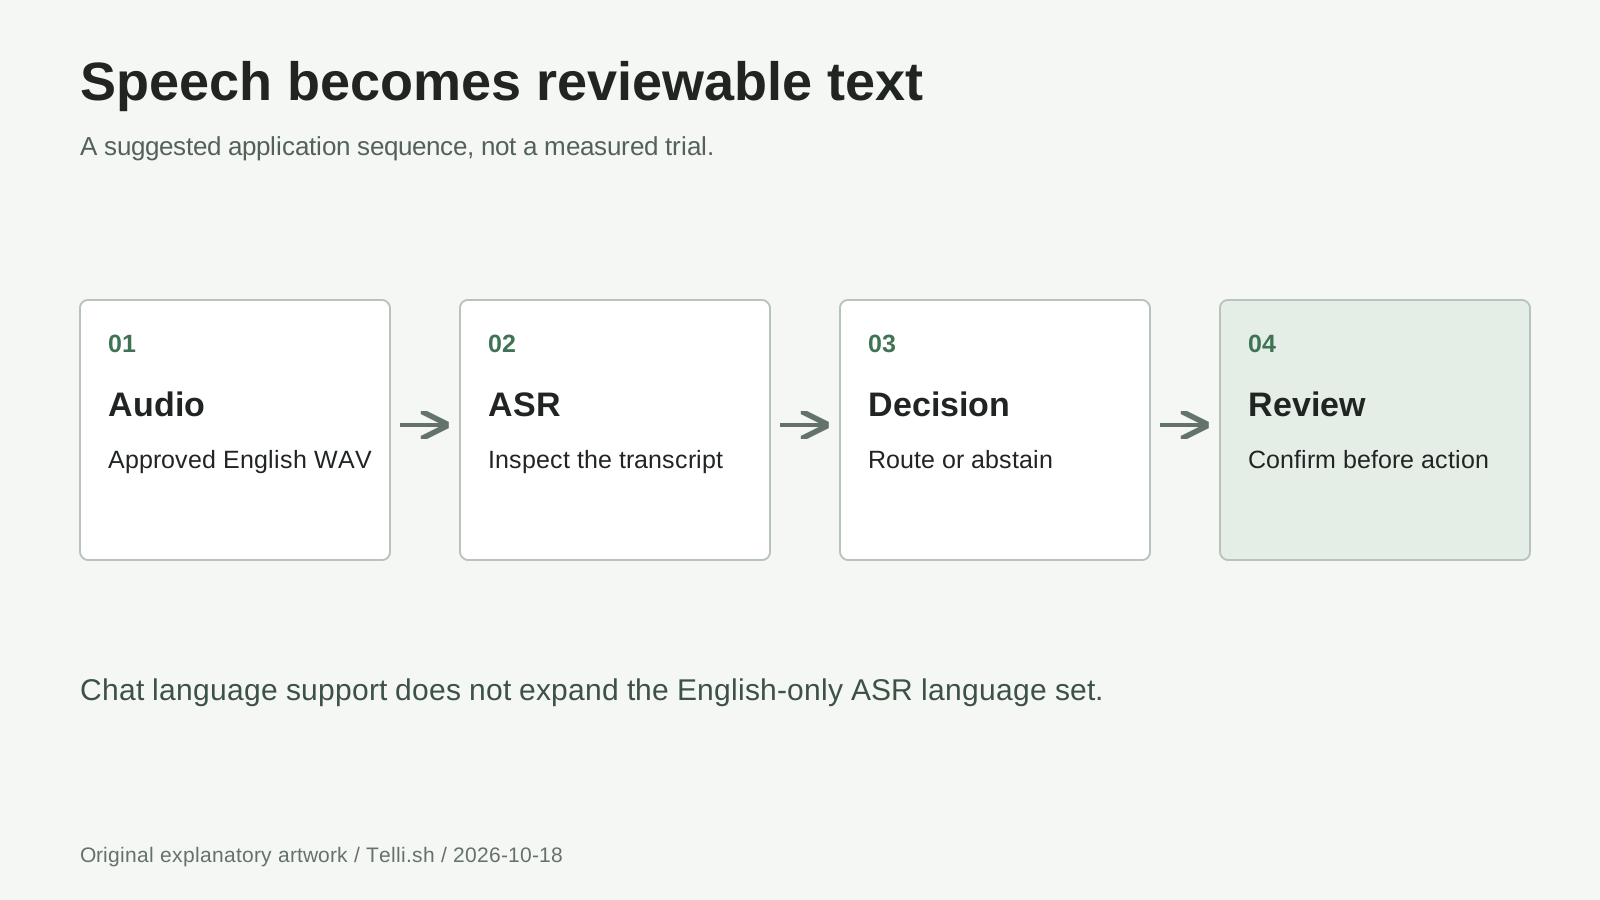
オリジナルのワークフロー図:音声と文字起こしを保持し、派生する出力を分け、アクションの前に確認します。上記の活用例を示すもので、公式インターフェースではありません。基盤となる処理の連鎖は音声ガイドで説明されています。2026年10月18日確認。
複数の機能が同じコンテキストを共有できるのはなぜ?
Key/valueキャッシュは、先行トークンについて計算したattention情報を保存します。Activated LoRA(aLoRA)では、通常のアダプター固有処理のようにプロンプト全体を再計算しなくても、共有コンテキストの後から専門アダプターを有効化できます。IBMはこの基礎となる手法を、2025年4月17日の研究解説で紹介しました。IBM ResearchのaLoRA解説。
Switchは正規化したベースモデルのキャッシュ状態を使い、各専門アダプターが互いの専用調整状態を消費しないようにします。アプリケーションでは、根拠となる先頭部分を同一に保ち、タスク固有の質問を後ろに追加します。確認のたびに文字起こしを書き換えると、プレフィックスの再利用を妨げます。Switchの仕組みのドキュメント、2026年10月18日確認。
キャッシュ共有は効率化の仕組みであり、推論が無料になるわけではありません。プレフィックスキャッシュは同じプロンプトの再処理を減らしますが、回答生成や音声認識をなくすものではありません。vLLMのプレフィックスキャッシュのドキュメント、2026年10月18日確認。私たちの見解は、目立つ速度の数字だけではなく、人が確認する工程全体を比較すべきだということです。
8Bの重みだけでなく、処理全体のメモリを見積もる
計画用の概算では、80億パラメーターを各2バイトで保持すると約16GB(14.9GiB)、300億パラメーターなら約60GB(55.9GiB)です。これはベース重みの算術例であり、チェックポイントの実サイズや最低VRAM要件ではありません。アダプター、音声エンコーダー、キャッシュ、一時バッファー、ランタイムのオーバーヘッドは含みません。
コンテキストを長くし、同時に処理するシーケンスを増やすと、メモリ負荷が高まります。モデルが掲げる最大コンテキスト長は、初回の実験で確保すべき長さを意味しません。vLLMのドキュメントでは、メモリ調整手段としてmax_model_lenとmax_num_seqsを減らす方法を紹介しています。vLLMのメモリに関するガイダンス、2026年10月18日確認。
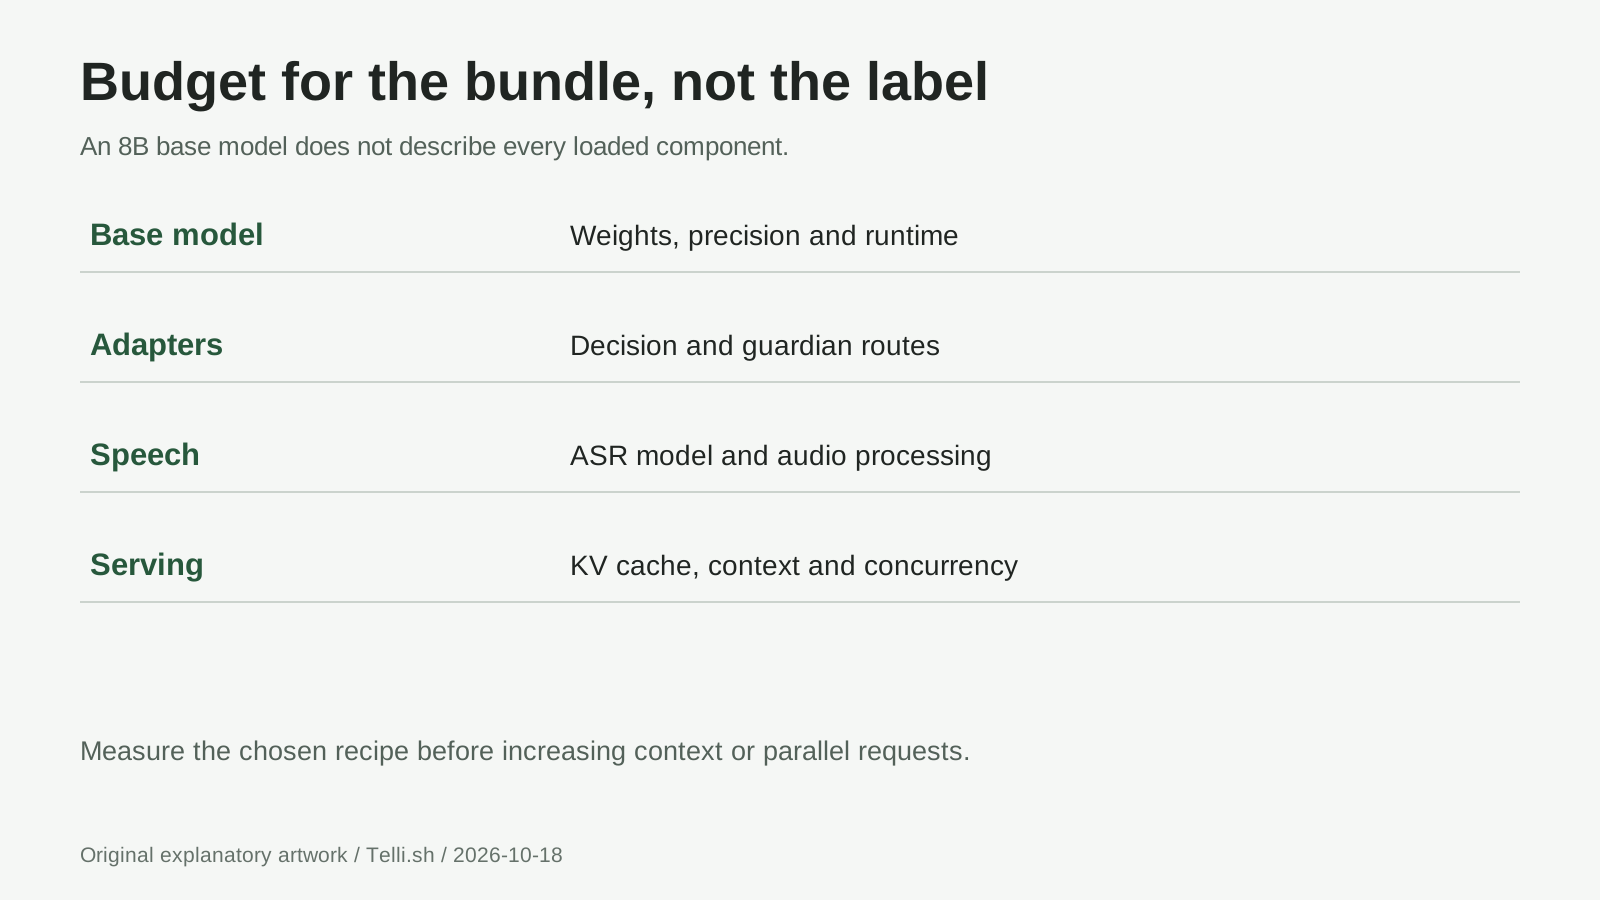
オリジナルのメモリ確認図。各要素の比率を示すものではありません:ベース重み + アダプター + ASRの重みと活性値 + KVキャッシュ + ランタイム/画面表示の余裕領域。音声ガイドでは、キャッシュの事前確保によってASR用メモリが不足する可能性が説明されています。2026年10月18日確認。
短いチャット、短い音声、普段使う中で最も長い入力を、それぞれ別にテストしてください。メモリのピーク、完了時間、誤りを記録します。キャッシュ割り当てを減らせば音声用の余地が増える場合はありますが、大きすぎる重みを収められるわけではありません。量子化した代替モデルも、ダウンロードが小さいというだけでは不十分です。Switchのアダプターと音声に対する互換性を別途確認してください。
デプロイ方法とコスト、プライバシーを一緒に考える
Apache-2.0のモデルライセンスでも、運用が無料になるわけではありません。ローカル利用にはハードウェア、電力、ストレージ、保守のコストがかかります。ホスト型エンドポイントには、プロバイダーの料金とデータ取り扱い条件が加わります。Granite Switchに一律の分単価があると想定しないでください。試験運用では、失敗した依頼や修正も含め、計算と確認にかかった総コストを正常に完了した項目数で割ります。
単純な仮定で考えると、プロバイダーの料金が1時間あたり1ドルの場合、10時間の計算コストは10ドルで、ストレージ、転送、人による確認の費用は別です。これは説明用の仮定であり、実際のサービス料金ではありません。エンドポイントのアイドル時間も費用に影響します。
機密性の高い作業では、録音前に音声、文字起こし、キャッシュ、ログ、バックアップの保存先を決めます。ループバック接続に限定しても、保持期間が決まるわけではなく、すべてのライブラリのテレメトリーが無効になるわけでもありません。サーバーを外部向けインターフェースに公開せず、依存関係とログを確認し、話者の許可を得て、元音声と派生記録それぞれの削除方針を定めましょう。ホスト型デモは学習には便利ですが、機密会議の標準的な送信先には適しません。
スタック全体を変える前に、失敗した段階を直す
構成が分からない。 仮想環境にgranite-switchが入っていること、vLLMがその環境を使っていること、VLLM_PLUGINSにregister_granite_switchが含まれることを確認します。パッケージを入れ替える前に、最初に出たプラグインのインポートエラーを読みましょう。
チャットは動くが音声が失敗する。 音声対応版のリリースID、[audio]依存関係、拡張子だけを変えたものではない実際のWAVファイルを確認します。Transformersのバージョンと利用可能なメモリも調べてください。デコード用ライブラリを入れても、テキスト専用プレビューが音声対応チェックポイントに変わることはありません。
名前や句読点が正しくない。 既定の英語CTC認識器は小文字で句読点のないテキストを出力し、デコード時に言語を指定できません。生のテキストを保持し、句読点の復元は派生編集として扱いましょう。誤った文字起こしは、後続の判断にも伝播します。音声の制限、2026年10月18日確認。
長い音声がコンテキストを超える。 入力を短くするか、元の参照情報を保持したまま意味のある単位に分割します。文字起こしがテキストコンテキストを消費するため、質問と回答のための余地も必要です。コンテキスト上限を増やすと、メモリ予算も変わります。
利用を任せる前に知っておくべきこと
回答を音声で読み上げられますか? 同梱の音声処理はASRであり、音声合成(TTS)ではありません。音声出力を行うアプリには、別のTTSコンポーネントが必要です。
チャット対応の12言語すべてを文字起こしできますか? 既定の英語認識器ではできません。音声ガイドでは、多言語入力に対応するためにASRバックエンドを置き換える方法を説明していますが、別の構成として評価が必要です。
選択肢の確率が0.95なら、現実でも95%正しいということですか? いいえ。これは提示された選択肢に対するモデルの分布であり、あなたの領域で検証された成功率ではありません。選択肢の不足、誤った文字起こし、曖昧な質問でも、特定の選択肢が強く支持されることがあります。アクションを自動化する前に、ラベル付きの例で評価し、判断を保留する条件を定めてください。判断アダプターのドキュメント、2026年10月18日確認。
Guardianは回答が真実だと証明しますか? いいえ。安全性チェックと事実確認は別の機能です。構成済みの公開版に、Granite Libraries全体のあらゆる専門アダプターが含まれるわけではありません。事実性を検証するワークフローを設計する前に、アダプター一覧を確認してください。
要点:エンドポイントが1つでも、根拠を追える記録は必要
Granite Switch 4.1が最も役立つのは、チャットが説明し、音声が確認可能な言葉を提供し、範囲を限定した判断が次の対応を整理するときです。モジュール型のサービング設計はインフラの重複を減らしますが、許可、根拠、行動する権限は引き続きワークフロー側が担います。
まず短い録音1つと、取り消し可能な判断1つから始めましょう。文字起こし、解釈、アクションが担当者にとって分かりやすいと確認できたら、対象を広げます。
出典
公開日は、IBMの発表記事が2026年10月15日、8Bモデルカードが2026年10月14日です。リンク先のドキュメントは2026年10月18日に確認しました。セットアップ手順は一次資料に基づいており、実機での性能測定結果ではありません。図は編集用に制作したオリジナルの解説図であり、ベンダー画像は転載していません。
- IBMの発表記事、8Bモデルカード、30Bモデルカード、3Bプレビューカード:公開範囲とチェックポイントの違い。
- Granite Switchリポジトリ、固定したパッケージ要件、音声ガイド:インストール、アーキテクチャ、音声の制限。
- 公式音声デモ、デモのドキュメント、公式aLoRAレースノートブック:試せるデモであり、このガイドの測定結果ではありません。
- IBMによる2025年4月17日のaLoRA解説とvLLMのドキュメント:本文で説明した仕組みと動作要件。
次の判断に必要な情報源を、あとから確認できるようにする
元の録音、メモ、確認済みの結果を一緒に保管すれば、後から判断するときにも文脈をたどれます。Telli.shのアカウントを作成して、ワークフローの発展に合わせて参照情報を整理できます。