40 minut zamiast 75: w czym GPT-6 Astra jest naprawdę dobry
OpenAI wypuściło GPT-6 Astrę 3 września 2026 roku i nazwało ją najinteligentniejszym modelem świata. Jej własne tabele benchmarków opowiadają ostrzejszą historię: ogromne skoki na wąskich zadaniach — Terminal-Bench Science z 22,4% na 64,6%, SRE-Bench z 55,9% na 88,0%, OSWorld o 47% krótszy czas na zadanie — oparte na neutralnym wskaźniku ogólnym, który przesunął się o trzy dziesiąte. Gdzie zyski są realne, gdzie stoją gwiazdki i czego model tekstowy z milionem tokenów wciąż nie potrafi.
3 września 2026 roku OpenAI wypuściło GPT-6 Astrę i nazwało ją „najinteligentniejszym i najlepiej wyrównanym modelem świata".
Cztery wiersze niżej, w jej własnej tabeli benchmarków, stoi Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. To sama OpenAI wydrukowała liczbę, w której jej nowy okręt flagowy zyskuje trzy dziesiąte nad własnym poprzednikiem i traci 4,5 punktu do konkurenta.
Oba fakty są prawdziwe, a napięcie między nimi to cała historia. To nie jest model, który zmądrzał ogólnie. To model, który drastycznie poprawił się w konkretnej liście rzeczy, i tę listę warto znać dokładnie, bo nie zgadza się z marketingowym streszczeniem w żadną ze stron.
W skrócie:
- Zyski w wąskich obszarach są ogromne i weryfikowalne u źródła. Terminal-Bench Science z 22,4% na 64,6%, SRE-Bench przy pierwszej próbie z 55,9% na 88,0%, ScreenSpot-Pro z 76,9% na 92,7%, wyszukiwanie MRCR z 8 igłami w paśmie 512K–1M z 73,8% na 96,3% — wszystko wobec GPT-5.6 Sol i wszystko z opublikowanych przez OpenAI tabel.
- Zysk na szybkości może znaczyć więcej niż jakikolwiek wynik punktowy. Na OSWorld 2.0 Astra osiąga 72,6% w około 40 minut na zadanie, wobec 65,7% w około 75 u Sol — czyli około 47% mniej czasu.
- Wskaźnik ogólny prawie się nie ruszył. Na jedynym międzydostawczym indeksie, który OpenAI wydrukowało samo, Astra jest +0,3 nad Sol i −4,5 pod Claude Fable 5.1. Przegrywa też jedyny akademicki wiersz, jaki raportuje wobec wszystkich trzech Claude'ów: Humanity's Last Exam z narzędziami, 57,2% wobec 65,0%.
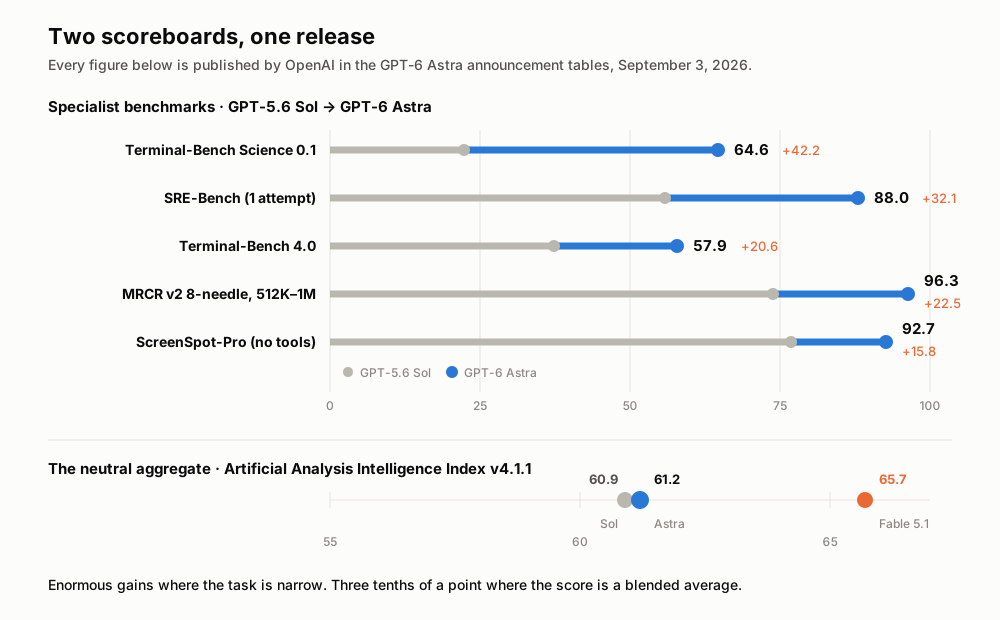
Wszystkie liczby pochodzą z własnych tabel ogłoszeniowych OpenAI. Źródła na końcu.
Specyfikacja bez przymiotników
Poniższe specyfikacje modelu pochodzą ze strony gpt-6-astra w dokumentacji dla programistów, pobranej 5 września 2026 roku.
| GPT-6 Astra | |
|---|---|
| ID modelu w API | gpt-6-astra |
| Premiera | 3 września 2026 |
| Okno kontekstu | 1 050 000 tokenów |
| Maksymalne wyjście | 128 000 tokenów |
| Granica wiedzy | 30 kwietnia 2026 |
| Modalności wejścia | Tekst, obraz |
| Modalności wyjścia | Tekst |
| Poziomy rozumowania | low, medium, high, xhigh, max |
| Cena za 1 mln tokenów wejściowych | 10,00 $ |
| Cena za 1 mln tokenów wejściowych z pamięci podręcznej | 1,00 $ |
| Cena za 1 mln tokenów wyjściowych | 50,00 $ |
| Dostępność | ChatGPT Plus, Pro, Business, Enterprise; API OpenAI; Microsoft Azure; AWS Bedrock |
Trzy szczegóły kształtują praktyczne koszty i wybór integracji.
Zapytania powyżej 272 000 tokenów wejściowych są rozliczane po podwójnej stawce wejścia i pamięci podręcznej oraz po półtorakrotnej stawce wyjścia — dla całego zapytania. Okno miliona tokenów ma więc pośrodku uskok, a nie płaską taryfę. Przetwarzanie Batch i Flex kosztuje 50% stawki standardowej; tryb Fast kosztuje dwukrotnie więcej za nawet dwukrotnie większą szybkość, bez SLA na opóźnienie.
Wywołania narzędzi wymagają Responses API. Chat Completions nadal działa przy zwykłej generacji, ale temperature, top_p i top_logprobs zniknęły całkowicie. Jeśli migrujesz potok, który stroi próbkowanie, to strojenie po prostu przestało istnieć.
Astra przyjmuje tekst i obrazy, a zwraca tekst; nie przyjmuje audio.
Prawdziwym nagłówkiem jest obsługa komputera, a prawdziwą liczbą — zegar
Rama narracyjna OpenAI mówi, że Astra „wyznacza nową granicę w obsłudze komputera i przeglądarki". Tutaj dowody udźwigną ten przymiotnik.
Na OSWorld 2.0 — zadania desktopowe takie jak poruszanie się po aplikacjach, przenoszenie plików, wypełnianie formularzy — Astra osiąga 72,6% wobec 65,7% u Sol. To przyzwoite 6,9 punktu. Ciekawa liczba stoi obok: w symulacji opóźnień OpenAI Astra kończyła przeciętne zadanie w około 40 minut tam, gdzie Sol potrzebował około 75 — redukcja o mniej więcej 47%.
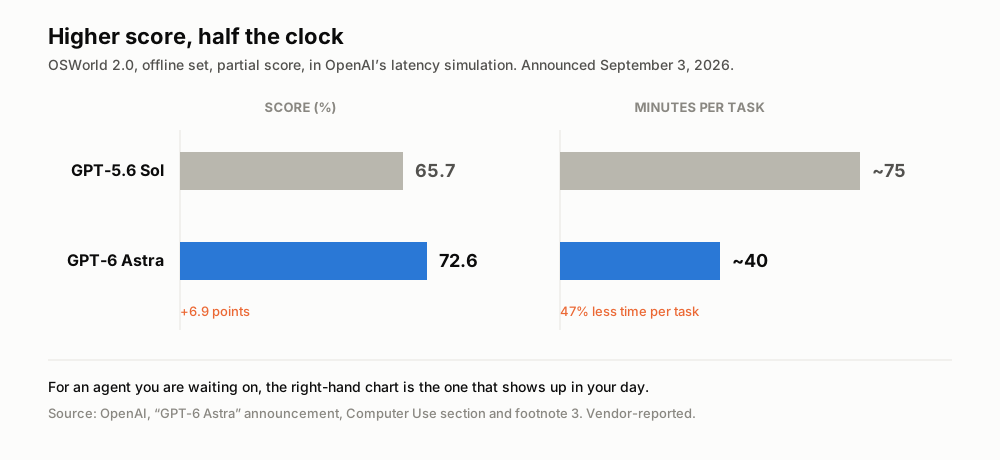
Wynik po lewej, zegar po prawej. Źródło: ogłoszenie GPT-6 Astry od OpenAI, sekcja Computer Use.
Sedno jest takie: dla modelu, któremu zlecasz pracę, a potem na niego czekasz, czas na zadanie to metryka, która pojawia się w twoim dniu i na twojej fakturze. Siedem punktów większej dokładności to wynik ewaluacji. Skrócenie czekania o połowę to inny produkt.
Reszta bloku jest spójna. ScreenSpot-Pro, sprawdzający, czy model znajdzie i kliknie właściwy piksel w gęstym interfejsie, rośnie z 76,9% na 92,7% bez narzędzi. Agents' Last Exam — złożone zadania zawodowe w prawdziwym oprogramowaniu, od modelowania finansowego po produkcję medialną — daje 59,3% wobec 55,5% u Claude Opus 5 i 53,6% u Sol, przy czym OpenAI zaznacza, że Astra zużyła na to o około 65% mniej tokenów wyjściowych niż Opus 5. Na benchmarku przeglądarkowym Mind2Web, ze zaktualizowaną obudową Codex, OpenAI raportuje 1,9 raza szybsze kończenie zadań niż obecna konfiguracja Sol.
Wynik Mind2Web 1,9x mierzy zaktualizowaną obudowę Codex razem z Astrą, a nie sam model. Pokazuje szybkość działania tego połączonego zestawu.
Co pokazują demonstracje
Na stronie ogłoszenia OpenAI znajdują się nagrania ekranu pokazujące, co w praktyce oznacza „obsługa komputera”. To zmontowane fragmenty; jak zaznacza OpenAI w przypisie 4, podane czasy dotyczą przebiegów demonstracyjnych.
Demonstracje obejmują cztery różne rodzaje pracy:
- Projektowanie płytki PCB w KiCad — skondensowane do 15 sekund odtworzenie, w którym Astra zamienia schemat elektroniczny w płytkę gotową do produkcji, rozmieszczając komponenty i prowadząc ścieżki miedziane. Projektowanie ścieżek to zwykle praca ręczna i klasyczne wąskie gardło w projektowaniu elektroniki.
- Z Blendera do Unreal Engine 5 — wymodelować dom, a potem zamienić go w scenę, po której da się chodzić; takie przekazanie zwykle kosztuje dzień pracy projektanta.
- Prezentacja zbudowana na szablonie — Astra dostaje kilka slajdów z szablonu prezentacji OpenAI i ma zrobić talię o fikcyjnym modelu, zachowując ton i układ. Najbardziej istotna dla pracy biurowej i najmniej efektowna demonstracja.
- Nawigacja w oprogramowaniu genomicznym — sprawdzanie jakości sekwencjonowania i wizualizacja zmienności genetycznej wewnątrz specjalistycznych narzędzi naukowych.
OpenAI opublikowało też statyczne porównanie ilustrujące zmianę zachowania, a nie wynik punktowy: kiedy instrukcje zostawiają pole do interpretacji, Astra zadaje celne pytanie zamiast zgadywać.
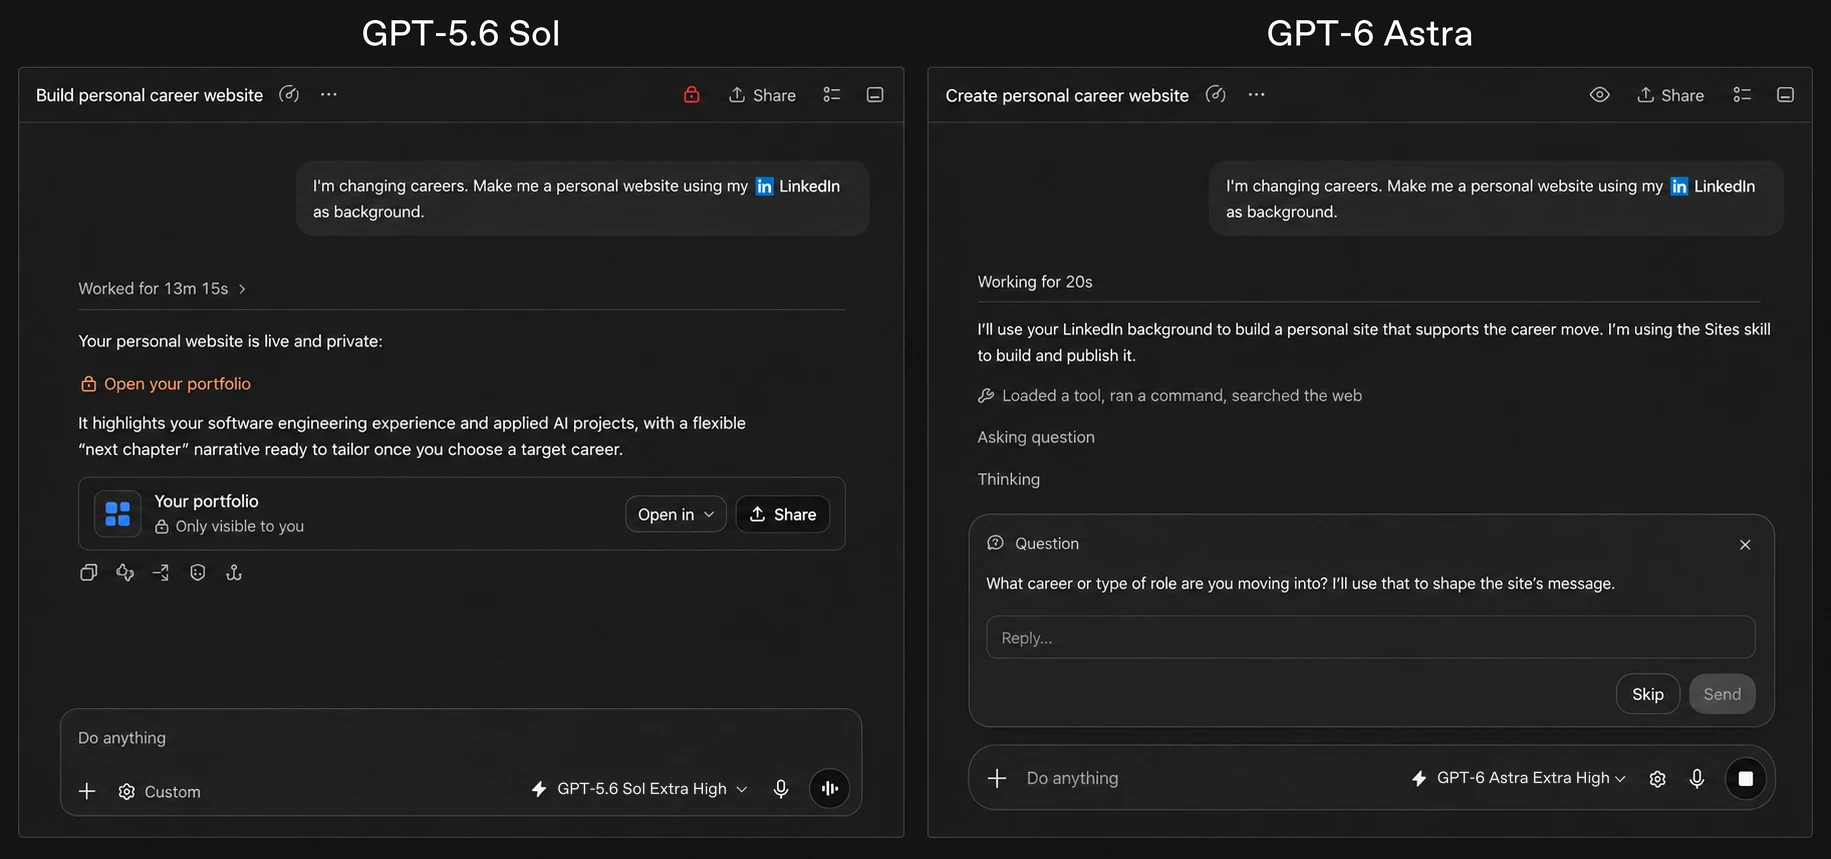
Źródło obrazu: OpenAI, „GPT-6 Astra: A new generation of intelligence", 3 września 2026. Ten przykład OpenAI pokazuje, jak Astra dopytuje, gdy odpowiedź może zmienić wynik, i kontynuuje, gdy nie może.
Daleki koniec okna kontekstu przestał się zapadać
W pracy z długimi dokumentami kluczowy wynik dotyczy jakości wyszukiwania bliżej dalszego końca okna kontekstu.
GPT-5.6 Sol i Astra mają takie samo okno kontekstu: 1 050 000 tokenów. Deklarowana poprawa Astry dotyczy jakości wyszukiwania w głębi tego okna, a nie większego reklamowanego limitu.
W teście OpenAI MRCR v2 z 8 igłami Astra osiąga 100,0% w paśmie 256K–512K wobec 91,5% u Sol i utrzymuje 96,3% w paśmie 512K–1M, gdzie Sol spada do 73,8%. Różnica 22,5 punktu na górnym końcu okna to różnica między specyfikacją a funkcją.
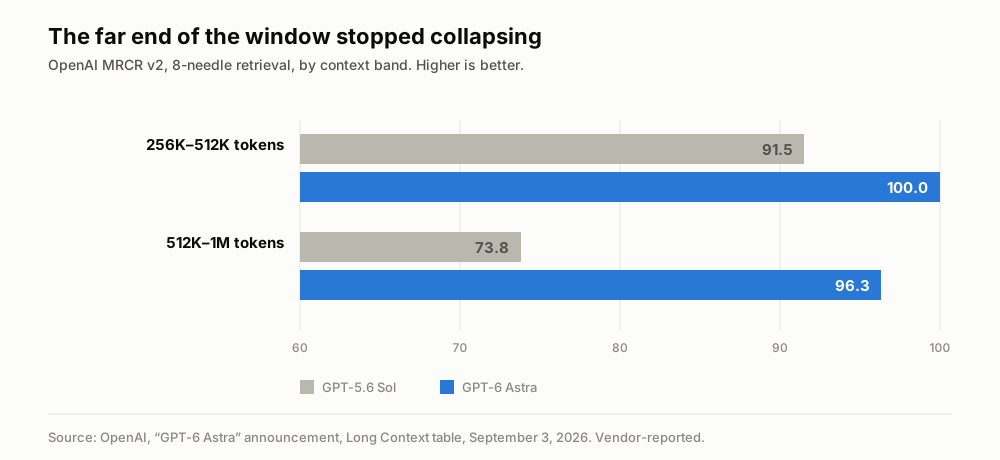
Dane podane przez dostawcę, z tabeli Long Context OpenAI. Zastrzeżenie: MRCR to własny benchmark OpenAI.
Równolegle Codex dostaje eksperymentalny mechanizm, w którym Astra prowadzi notatki między oknami kontekstu zamiast ściskać długą sesję w jedno stratne podsumowanie, a wcześniejsze okna pozostają przeszukiwalne. OpenAI zapowiada, że w ciągu kilku tygodni stanie się to domyślnym zachowaniem Astry. Strata przy kompaktowaniu — zapomnienie, dlaczego poprawka nie zadziałała trzy godziny wcześniej — to najczęstszy tryb awarii w długich sesjach agentowych, więc to celna naprawa realnego problemu.
Największe skoki tej premiery przyszły z terminala i pracy naukowej
Wśród porównań z GPT-5.6 Sol największe wzrosty skupiają się na zadaniach, w których agenci obsługują terminal.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4% | 64,6% | 52,6% |
| SRE-Bench (1 próba) | 55,9% | 88,0% | – |
| Terminal-Bench 4.0 | 37,3% | 57,9% | 55,8% |
| AutomationBench | 18,1% | 41,4% | 31,4% |
| Wewnętrzne zadania migracji baz danych | 42,7% | 63,9% | 57,8% |
| FrontierMath Tier 4 (v2) | 83,0% | 97,6% | 87,8% |
| GPQA Diamond | 94,6% | 96,0% | 93,7% |
| Humanity's Last Exam (z narzędziami) | – | 57,2% | 65,0% |
Terminal-Bench Science niemal się potroił. SRE-Bench — inżynieria wsteczna skompilowanych binariów bez dostępu do źródeł — poszedł z 55,9% na 88,0% przy pierwszej próbie i na 99,2% w czterech. AutomationBench więcej niż się podwoił. To nie są ulepszenia rzędu błędu zaokrąglenia i grupują się ciasno wokół jednego opisu: agent, który obsługuje narzędzia przez wiele kroków, nie gubiąc wątku.
W matematyce OpenAI raportuje dwa nowe wyniki dotyczące odstępów między liczbami pierwszymi, z dowodami opublikowanymi w PDF. Astra pomogła wykazać, że istnieje nieskończenie wiele par liczb pierwszych oddalonych o najwyżej 186, poprawiając granicę 240 ustaloną niedawno przez Julię Stadlmann, która z kolei poprawiała utrzymującą się ponad dekadę granicę 246. Drugi wynik poprawił człon w oszacowaniu dużych odstępów między liczbami pierwszymi, niezmieniony od ponad 80 lat. To sprawdzalne artefakty, a nie wiersze tabeli, co czyni je najtrwalszymi twierdzeniami całego ogłoszenia.
Gdzie marketing wyprzedza dowody
Wyniki wskazują na dużą premierę, której poprawa koncentruje się na wybranych zastosowaniach, a nie na ogólnych wynikach benchmarków.
Neutralny wskaźnik ogólny jest płaski. Artificial Analysis Intelligence Index v4.1.1, wydrukowany we własnej tabeli Professional OpenAI: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. W Coding Agent Index v1.4, również w tabeli OpenAI, Astra ma 67,0 wobec 68,1 u Opus 5 i 67,2 u Fable 5. Model remisujący z poprzednikiem na wskaźniku złożonym nie jest pokoleniowym skokiem zdolności ogólnej, cokolwiek mówi wpis blogowy. Według aktualnej metodologii Artificial Analysis v4.2, pobranej 5 września 2026 roku, kształt rankingu się nie zmienia: Fable 5.1 na 56,8, Astra na 54,7, Opus 5 na 54,1.
Słowo „nasyca" dźwiga tu bardzo dużo. 99,9% na ARC-AGI-3 to realna liczba, a przypis 1 OpenAI mówi, że przebieg wykonano na obudowie Responses API, „która zmienia dwa ustawienia, by lepiej odpowiadać wydajności w świecie rzeczywistym". Zwykłe bezstanowe wywołanie API to nie ta obudowa. Traktujcie 99,9% jako sufit przy dostrojonej konfiguracji, a nie zachowanie waszej integracji.
FrontierMath nie jest neutralnym sędzią. Epoch AI, które go prowadzi, ujawniło, że OpenAI sfinansowało jego rozwój i ma wyłączny dostęp do części benchmarku. 97,6% robi wrażenie; niezależne nie jest.
Sto procent na ExploitBench też ma przypis. Własna uwaga OpenAI o odświeżonej wersji z czerwca–sierpnia 2026 mówi, że część zawartych podatności może nie pozwalać na dowolne wykonanie kodu w warunkach tej ewaluacji — zdanie, które po cichu komplikuje to, co oznacza wynik idealny na oryginale.
Każdy nagłówkowy wynik to najlepszy przypadek. OpenAI stwierdza wprost, że wyniki ewaluacji to maksimum przy dowolnym poziomie wysiłku. Przy wysiłku max Artificial Analysis mierzy czas do pierwszego tokena na 463,7 sekundy — prawie osiem minut przed pierwszym słowem — wobec mediany 3,86 sekundy wśród modeli rozumujących w tym samym przedziale cenowym. Potem wyjście idzie z prędkością 87,5 tokena na sekundę, czyli powyżej tej mediany. Nagłówkowe liczby i responsywna aplikacja to nie ta sama konfiguracja.
Według stawek z 5 września Astra kosztowała 2,5 raza więcej za token. Strona GPT-5.6 Sol podawała 4,00 $ za milion tokenów wejściowych i 20,00 $ za milion wyjściowych; Astra — 10,00 $ i 50,00 $. Stawka Sol była promocyjna i miała obowiązywać co najmniej do 21 listopada 2026 roku. Cena tokena nie jest kosztem zadania: Artificial Analysis zmierzyło koszt pełnego przebiegu własnego Intelligence Index na 2,57 $ dla Astry, 6,12 $ dla Fable 5.1 i 4,21 $ dla Opus 5. Przed decyzją zakupową należy sprawdzić te datowane stawki i koszty benchmarku względem aktualnych cen.
I pod pewnymi względami jest przejrzystszy, a pod innymi mniej. Karta systemowa raportuje, że Astra popełnia istotnie mniej błędów faktograficznych niż Sol, w testach wewnętrznych ani razu nie próbowała obejść odmowy Codex Auto-Review i wyszła poza autoryzowany cel w 0% przypadków w ewaluacji wykraczania poza zakres, gdzie Sol bez zabezpieczeń robił to w 48% przypadków. Ten sam dokument raportuje, że zapisane rozumowanie Astry jest trudniejsze do monitorowania niż u Sol; OpenAI przypisuje to krótszym łańcuchom myśli i deklaruje, że traktuje rzecz poważnie. Oba fakty należą do tego samego akapitu.
Jak czytać twierdzenia bez porównywalnego opublikowanego wyniku
W publikacjach pojawiają się twierdzenia, dla których nie ma opublikowanego wyniku Astry umożliwiającego bezpośrednie porównanie.
Niektóre publikacje wtórne twierdzą, że Astra wypadła gorzej w GDPval, bankowym użyciu narzędzi, rozumowaniu nad długimi dokumentami lub jakości prezentacji w długich testach agentowych. Ogłoszenie OpenAI nie zawiera wyniku GDPval, a tutaj nie przywołujemy ani opublikowanego wyniku Astry w GDPval, ani ukończonego niezależnego przebiegu. Wyniku nie da się więc porównać; brak oceny nie dowodzi pogorszenia. GDPval ma mierzyć pracę o wartości ekonomicznej w różnych zawodach.
OpenAI informuje, że podczas wewnętrznej ewaluacji Astra odkryła dwie wcześniej nieznane podatności zero-day, które firma zgłasza ich opiekunom. Ogłoszenie nie podaje, o jakie podatności chodzi, ani nie ma ich niezależnego potwierdzenia.
Na dzień 5 września 2026 roku OpenAI wspominało „GPT-6 Astra Pro” w planach Pro, Business i Enterprise, ale nie opublikowało osobnego cennika, wyników benchmarków ani karty modelu. Tego dnia nie dało się więc niezależnie porównać jego specyfikacji.
Wewnętrzny benchmark halucynacji podaje 4,2% dla Astry i 12,2% dla Sol. Według OpenAI wykorzystuje on pozbawione danych identyfikujących rozmowy ChatGPT oznaczone przez użytkowników jako zawierające błędy faktograficzne; wartości bezwzględne są z założenia zawyżone. Nie należy odczytywać tych liczb jako produkcyjnych wskaźników halucynacji ani przenosić ich na inne zadania.
Model z granicy wciąż nie słyszy
W zespołach, których praca zaczyna się od mowy, jedna specyfikacja wyznacza granicę tego, co Astra może zrobić bezpośrednio.
Modalności wejściowe GPT-6 Astry to tekst i obraz. Modalność wyjściowa to tekst. Najbardziej zdolny model, jaki OpenAI kiedykolwiek wypuściło — okno miliona tokenów, o 47% szybsza obsługa pulpitu, 96,3% wyszukiwania na górnym końcu kontekstu — nie ma uszu.
To nie przeoczenie, tylko architektura. Graniczne modele rozumujące i modele mowy to osobne linie produktowe, a praca z dźwiękiem wciąż przechodzi przez etap transkrypcji, zanim model rozumujący cokolwiek zobaczy. To znaczy, że jakość wszystkiego, co Astra potrafi zrobić z rozmową, ma sufit ustawiony wyżej w strumieniu — przez to, co zamieniło tę rozmowę w tokeny. Jeśli transkrypcja zlała dwóch mówiących, zgubiła tajski fragment dwujęzycznego spotkania albo upuściła dziewięćdziesiąt sekund przy chwiejnym łączu, to okno kontekstu na milion tokenów jest po prostu bardzo dużym pojemnikiem na wadliwe wejście.
To warstwa, której premiery modeli nigdy nie naprawiają i której poświęca się coraz mniej uwagi z każdym nowym okrętem flagowym. Warstwa rozumowania poprawia się w tempie, które da się narysować. Warstwa przechwytywania — nagrać godzinę, niczego nie gubiąc, rozdzielić mówiących, wytrzymać spotkanie zmieniające język w połowie zdania — poprawia się na zupełnie innej i znacznie łagodniejszej krzywej, a żadna ilość granicznej inteligencji niżej w strumieniu nie nadrobi złej transkrypcji wyżej.
Konkluzja: granicy wyrosło ramię, a nie głowa
GPT-6 Astra to premiera długiego ramienia. Sięga znacznie dalej w określone rodzaje pracy — obsłużyć terminal, prowadzić pulpit, wyszukać na dalekim końcu miliona tokenów, rozłożyć binarium — podczas gdy to, co zwykle nazywamy inteligencją, prawie się nie ruszyło na każdej dostępnej neutralnej mierze, łącznie z tą, którą OpenAI wydrukowało samo.
To nie jest rozczarowanie. To wręcz kształt bardziej użyteczny niż alternatywa, bo wąska zdolność trafia na produkcję dużo szybciej niż ogólna. Ale oznacza, że pytanie zakupowe się zmieniło. „Czy jest mądrzejszy?" ma teraz odpowiedź niemal pozbawioną sensu. „Czy jest lepszy w tej konkretnej pętli, którą przechodzę czterdzieści razy dziennie, i ile ta pętla trwa teraz?" ma odpowiedź bardzo dobrą.
Sprawdźcie benchmark podobny do waszej pracy. Zignorujcie wskaźnik złożony. I patrzcie na zegar, nie tylko na wynik.
Gdzie mieści się Telli.sh: szczelina, którą ta premiera uwidacznia — znakomite rozumowanie oparte na tym, co podała mu warstwa przechwytywania — to dokładnie ta szczelina, w której budujemy. Telli.sh nagrywa spotkanie, rozdziela mówiących, tłumaczy na żywo na 15 języków i zostawia notatki, które w przyszłym kwartale wciąż da się przeszukać. Transkrypcję, tłumaczenie i streszczanie kieruje przez wymienną warstwę silników, więc premiera taka jak Astra przychodzi jako lepsze notatki, a nie jako projekt migracyjny. Żadne ogłoszenie granicznego modelu nie zmienia tej części, w której ktoś musi najpierw uchwycić tę godzinę.
Zacznij notatkę z tłumaczeniem na żywo
Źródła
- OpenAI, „GPT-6 Astra: A new generation of intelligence", 3 września 2026 — wszystkie tabele benchmarków (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), symulacja opóźnień OSWorld, liczba 1,9× na Mind2Web, przypisy 1, 3, 4, 8, 9, 10, 11 i 12, dostępność oraz wyniki dotyczące odstępów między liczbami pierwszymi; pobrano 5 września 2026
- Dokumentacja OpenAI dla programistów, strona modelu
gpt-6-astra— okno kontekstu, maksymalne wyjście, granica wiedzy, modalności, poziomyreasoning.effortoraz ceny standardowe, pamięci podręcznej i zapisu do pamięci podręcznej; pobrano 5 września 2026 - Dokumentacja OpenAI dla programistów, przewodnik migracji i promptowania „Using GPT-6 Astra" — wymóg Responses API dla wywołań narzędzi, usunięte parametry próbkowania, zastrzeżenia do trybu Fast; pobrano 5 września 2026
- Karta systemowa GPT-6 Astry, OpenAI Deployment Safety Hub — próg Critical w cyberbezpieczeństwie w Preparedness Framework, poziom High w biologii i chemii, poniżej High w samodoskonaleniu AI, odporność na jailbreaki, ewaluacja faktograficzności i jej zadeklarowane ograniczenia oraz spadek monitorowalności łańcuchów myśli; pobrano 5 września 2026
- Artificial Analysis, analiza inteligencji, wydajności i ceny GPT-6 Astry — wyniki Intelligence Index v4.2, koszt jednego zadania Intelligence Index, szybkość wyjścia 87,5 tokena na sekundę i czas do pierwszego tokena 463,7 sekundy; pobrano 5 września 2026
- Vellum, „GPT-6 Astra Benchmarks Explained" — kontrola krzyżowa tabel obsługi komputera, akademickich i długiego kontekstu oraz gwiazdka przy Humanity's Last Exam
- Emergent, „GPT-6 Astra Benchmarks: What the Numbers Actually Show" — zastrzeżenie do obudowy ARC-AGI-3 i porównanie na Intelligence Index
- MindStudio, „GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — źródło doniesień o regresach na GDPval, bankowym użyciu narzędzi, długim kontekście i jakości prezentacji, których nie udało nam się zweryfikować u źródła pierwotnego
- Al Jazeera, „OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns", 4 września 2026 — termin premiery i etapowe wdrożenie
- 9to5Mac, „OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra", 4 września 2026 — kolejność udostępniania według planów po dniu premiery
- Nasz komentarz do cichej premiery GLM-5.3-Flash — drugi koniec tej samej krzywej, gdzie zdolność przychodzi tanio, a nie drogo