Pogłoska o RSI w Google: AGI i spór o tempo rozwoju AI
Czym są AGI i rekurencyjne samodoskonalenie? Sprawdzamy wpisy w X, propozycje liderów AI i argument Trumpa dotyczący konkurencji z Chinami.
Przydaje się sztuczna inteligencja, która pomaga ukończyć trudny projekt. Sztuczna inteligencja, która pomaga zbudować bardziej wydajną sztuczną inteligencję, zmienia tempo, w jakim pojawiają się przydatne narzędzia. Ta druga możliwość wyjaśnia, dlaczego kilka tajemniczych postów na temat Google przyciągnęło uwagę w chwili, gdy rywalizujący liderzy AI zaczęli publicznie popierać bardziej wyważony harmonogram rozwoju.
Dwa terminy ułatwiają śledzenie historii. AGI, czyli sztuczna inteligencja ogólna, opisuje sztuczną inteligencję o szerokich możliwościach: system, który może się uczyć i wykonywać wiele różnych zadań intelektualnych. RSI, czyli rekurencyjne samodoskonalenie, opisuje proces: sztuczna inteligencja przyczynia się do ulepszenia systemu sztucznej inteligencji, a te ulepszenia pomagają w kolejnej rundzie ulepszeń. Jeden dotyczy zakresu możliwości systemu; druga dotyczy tego, jak postęp wpływa na siebie.
W tym artykule podążamy za plotką dotyczącą Google aż do jej pierwotnych X postów, oddzielamy publiczne poparcie od faktycznej zgody na spowolnienie rozwoju i analizujemy, co szybszy cykl badawczy może oznaczać dla zwykłego życia. Ostateczny termin raportowania to 14 września 2026 r.. Mój pogląd jest optymistyczny: lepsze narzędzia mogą sprawić, że wiedza specjalistyczna stanie się znacznie bardziej dostępna. Ale przyszłość, której warto pragnąć, obejmuje wystarczająco dużo czasu na sprawdzenie wyników i wystarczającą władzę, aby zmienić kurs.
Trzy rozróżnienia, o których należy pamiętać
- AGI, RSI i superinteligencja opisują różne rzeczy. Żadne nie jest synonimem sztucznej inteligencji posiadającej świadomość.
- Działalność publiczna Google potwierdza twierdzenie, że sztuczna inteligencja pomaga w rozwoju sztucznej inteligencji. Krążące w obiegu posty X nie ustanawiają w pełni autonomicznej, trwałej pętli doskonalenia.
- Kilku liderów publicznie poparło kontrolowanie tempa rozwoju i zewnętrzne oceny. To istotne, lecz nie dowodzi podpisania i wdrożenia porozumienia o spowolnieniu całej branży.
AGI oznacza zdolność uczenia się i wykonywania różnych zadań
Specjalista może być wyjątkowy w jednym zadaniu. Silnik szachowy może pokonać mistrza, nie będąc w stanie wyjaśnić umowy najmu, zaplanować projektu badawczego ani nauczyć się nowego przepływu pracy w biurze. AGI odnosi się do szerszych ambicji: systemu sztucznej inteligencji, który może przenosić przydatne umiejętności w wielu rodzajach pracy intelektualnej, w tym w nieznanych zadaniach. Na co dzień pojawia się pytanie, czy będzie w stanie nadal uczyć się, jak być przydatnym, gdy zadanie się zmieni.
Nie ma jednej, powszechnie akceptowanej linii mety. W listopadzie 2023 r. badacze DeepMind zaproponowali ocenę AGI pod względem wymiarów, w tym wydajności, ogólności i autonomii. Ich struktura stanowi cenne rozróżnienie: bycie dobrym w wielu zadaniach i pozwolenie na niezależne działanie to odrębne właściwości. System o dużej wydajności można nadal wdrożyć przy wąskich uprawnieniach. Poziomy AGI, przesłane po raz pierwszy 4 listopada 2023 r..
W przypadku początkującego rozważ hipotetycznego asystenta poproszonego o pomoc małej organizacji non-profit. Musi zrozumieć nieznany arkusz kalkulacyjny, napisać wniosek o dofinansowanie, zauważyć sprzeczność w budżecie i poznać zasady raportowania. Przekonująca demonstracja wykazałaby niezawodne działanie we wszystkich tych zmianach, w tym wiedzę, kiedy poprosić o pomoc. Jedna dopracowana propozycja dotacji ustaliłaby znacznie mniej niż ten szerszy wzór.
Z tego też powodu wynik testu porównawczego nie jest uniwersalnym certyfikatem wywiadu. Benchmark mówi nam coś o określonych zadaniach w określonych warunkach. Może pomijać trwałą niezawodność, nieznane środowiska, koszty praktyczne lub zdolność do naprawienia błędów. Kiedy ktoś ogłasza AGI, pożyteczną odpowiedzią jest: jakie umiejętności, na jakim poziomie, w jakim zakresie zadań i z jakim wsparciem?
ASI, czyli sztuczna superinteligencja, zwykle odnosi się do możliwości znacznie wykraczających poza ludzkie możliwości w szerokim zakresie pracy poznawczej. To już inna koncepcja, a nie wymagana etykieta dla każdego imponującego modelu. Ani AGI, ani ASI nie implikują automatycznie świadomości, emocji ani ludzkiego życia wewnętrznego. Ten artykuł dotyczy możliwości, procesów rozwoju i wyborów, jakich ludzie wokół nich dokonują.
W RSI postęp ulepsza sposób osiągania kolejnego postępu
Zwykłe oprogramowanie poprawia się, ponieważ ludzie znajdują problemy, proponują zmiany, testują je i zachowują te, które działają. Sztuczna inteligencja może już pomagać w poszczególnych krokach. Może zasugerować szybszy algorytm, wygenerować przypadki testowe lub pomóc zdiagnozować nieudany eksperyment. RSI staje się interesujący, gdy korzyści z tej pracy sprawią, że system lepiej przeprowadzi kolejną rundę ulepszeń.
Wyobraź sobie pracownię badawczą, która ulepsza własne narzędzia. Dokładniejszy przyrząd pomiarowy pomaga zbudować lepszy przyrząd, a ten ułatwia kolejne usprawnienie. Każda udana zmiana rozszerza możliwości następnego eksperymentu. Ważne jest, czy poprawa jest rzeczywista, zachowana i przydatna w dalszych badaniach, a nie tylko czy w pracowni więcej się dzieje.
Chatbot zmieniający swoją odpowiedź pięć razy niekoniecznie poprawił swój model. Funkcja pamięci może zachować fakty bez aktualizacji wyuczonych parametrów sieci. Agent kodujący może udoskonalać swoje własne narzędzia, zachowując jednocześnie model, który go napędza. Są to przydatne mechanizmy, ale silna forma RSI polega na sukcesywnym ulepszaniu możliwości tworzenia lepszych systemów AI. Wcześniejszy przewodnik po pętlach ciągłego uczenia się i doskonalenia bada te węższe mechanizmy.
| Koncepcja | Pytanie, na które odpowiada | Co by nie wystarczyło? |
|---|---|---|
| AGI | Czy system może wykonywać i uczyć się w szerokim zakresie zadań intelektualnych? | Znakomity wynik w jednym wąskim benchmarku |
| RSI | Czy ulepszenia sprawiają, że późniejsze udoskonalenia AI są bardziej skuteczne? | Powtarzające się odpowiedzi, więcej kodu lub sugestywna nazwa modelu |
| ASI | Czy możliwości znacznie przekraczają poziom ludzki w wielu domenach poznawczych? | Bycie nadczłowiekiem w jednym wyspecjalizowanym zadaniu |
Definicja wyjaśnia również, dlaczego AGI i RSI nie muszą być dostarczane w ustalonej kolejności. System mógłby pomóc zoptymalizować szkolenie AI, pozostając jednocześnie słabym w wielu codziennych zadaniach. I odwrotnie, sztuczną inteligencję o szerokich możliwościach można opracować w procesie nadal kierowanym przez ludzi. RSI mógłby przyspieszyć ścieżkę w kierunku większej ogólności, ale zapisanie tych trzech liter na diagramie nie pokazuje, gdzie kończy się ta ścieżka.
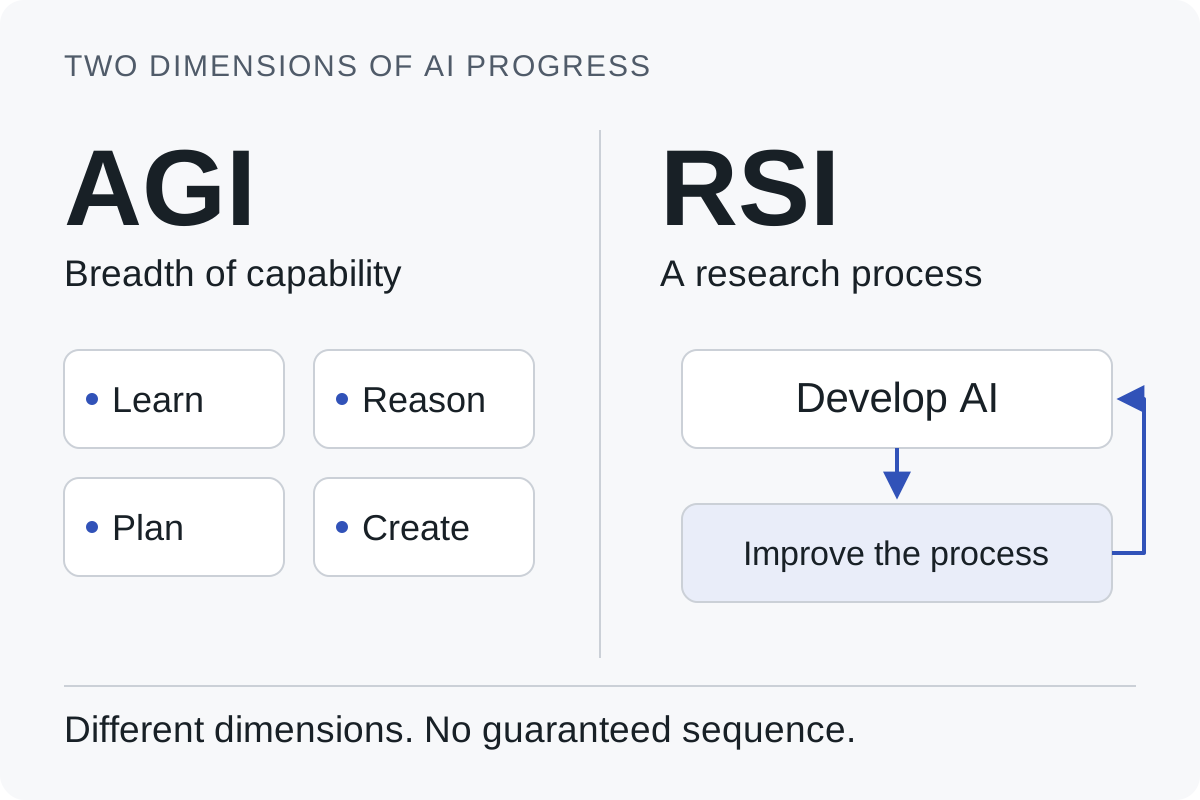
Oryginalny diagram koncepcyjny. AGI i RSI to różne wymiary, a nie gwarantowana sekwencja kamieni milowych. Ilustruje powyższe definicje, a nie zmierzone możliwości konkretnego modelu.
Pogłoska o Google prowadzi do dwóch wpisów
Artykuł AI Times z 14 września opisuje pogłoskę krążącą w społeczności AI. Po prześledzeniu osadzonego wpisu i odsyłaczy w późniejszych komentarzach docieramy do niewielu rozpoznawalnych źródeł. Ma to znaczenie: sto udostępnień może wyglądać jak sto potwierdzeń, choć większość powtarza tę samą początkową tezę.
11 września konto Lyra, @lyraxana opublikowało krótką wiadomość z gratulacjami, tagując Google DeepMind. Nietypowe wielkie litery podkreślały litery R, S i I. W poście nie podano żadnych metod eksperymentalnych, wyników działania ani wyjaśnień dotyczących zaangażowania człowieka. Było to zaproszenie do wywnioskowania czegoś ze skrótu.
Później tego samego dnia Lentils, @Lentils80 zacytował post Lyry i odniósł się do rzekomego modelu wewnętrznego o nazwie rsi-model-liverl-le, wraz z dziesięcioma ponumerowanymi miejscami treningowymi. Powiązany zrzut ekranu stał się kolejnym przedmiotem spekulacji. Są to twierdzenia dotyczące rzekomego wpisu na listę wewnętrzną; autentyczność wpisu i jego związek z działającym systemem nie zostały niezależnie ustalone w toku niniejszego dochodzenia.
12 września Chubby, @kimmonismus wzmocnił tę plotkę i ponownie powiązał z tym samym postem Lyry. W ten sposób ustala się ścieżkę obiegu. Nie tworzy drugiego niezależnego źródła przełomu. Reputacja konta wynikająca z wcześniejszych wycieków nie zastępuje również dowodów potwierdzających to konkretne twierdzenie.
Nawet autentyczne imię wewnętrzne pozostawiłoby główne pytania bez odpowiedzi. Zespół może nazwać projekt po jego celu, zanim go osiągnie. Eksperyment może ulepszyć wąski komponent, jednocześnie w dużym stopniu zależny od wskazówek człowieka. Zanim wyciągniemy silniejsze wnioski, potrzebowalibyśmy zmierzonych wyników, jasnego punktu odniesienia i opisu tego, co zostało zautomatyzowane.
Na dzień tej weryfikacji wniosek jest ograniczony: pogłoska o RSI w Google ma możliwe do prześledzenia źródła w X, ale wpisy nie dowodzą w pełni autonomicznego RSI. Nie znalazłem komunikatu Google potwierdzającego autentyczność domniemanej listy wewnętrznej ani przedstawiającego powtarzane, niezależne oceny potrzebne do takiej interpretacji. To granica sprawdzonych publicznych dowodów, a nie dowód braku nieujawnionych osiągnięć.
Opublikowane badania Google mówią więcej niż ujawniona nazwa
Nie bez powodu plotka znalazła odbiorców. Google publicznie opisał sztuczną inteligencję przyczyniającą się do rozwoju sztucznej inteligencji. W swoim ogłoszeniu 2 września 2026 Gemini 3.8 firma stwierdziła, że długotrwałe pętle agentyczne pomogły w rekurencyjnej ocenie i udoskonaleniu podstawowych modeli. Jest to merytoryczne i możliwe do przypisania stwierdzenie na temat procesu rozwoju. Nadal nie określono w pełni autonomicznego łańcucha systemów następczych. Ogłoszenie Google Gemini 3.8.
Wcześniejszy wynik nadaje pomysłowi konkretną skalę. Google DeepMind poinformował w maju 2025, że AlphaEvolve ulepszył kluczowe jądro szkoleniowe Gemini o 23%, przyczyniając się do około 1% redukcji całkowitego czasu szkolenia. Agent kodujący wykorzystał modele językowe oraz zautomatyzowaną ocenę i selekcję do wyszukiwania lepszych algorytmów. Ogłoszenie AlphaEvolve, 14 maja 2025 r..
Różnica pomiędzy 23% a 1% jest pouczająca. Ulepszenie jednego komponentu nie poprawia całego cyklu rozwojowego w tym samym stopniu. Inne prace wciąż wymagają czasu. Jednak nawet niewielka oszczędność może mieć znaczenie, jeśli zostanie wielokrotnie zastosowana do kosztownego szkolenia, a użyteczna optymalizacja może stać się częścią procesu, w wyniku którego powstanie kolejny model.
To lepsza podstawa do optymizmu niż zgadywanie, co oznacza nazwa pliku. Zanim ktokolwiek zademonstruje najsilniejszą wersję RSI, branża może poczynić znaczące postępy. Powinniśmy potrafić docenić osiągnięcie inżynieryjne, nie zamieniając go w twierdzenie, że sztuczna inteligencja stała się niezależnym twórcą całej swojej przyszłości.
Sprawozdanie Anthropic z 4 czerwca 2026 dotyczące własnego rozwoju zawiera podobne rozróżnienie. Zgłoszono wzrost udziału sztucznej inteligencji w inżynierii i eksperymentach, identyfikując jednocześnie kierunek badań i ocenę jako utrzymujące się luki. Dyskusja na temat w pełni autonomicznego rozwoju następcy była wyraźnie warunkowa. Są to spostrzeżenia firmy dotyczące własnego przepływu pracy, a nie niezależnego dowodu autonomicznego RSI. Kiedy sztuczna inteligencja buduje się sama.
Amodei, Altman i Musk publicznie poparli kontrolowanie tempa rozwoju
12 września szef Anthropic Dario Amodei zaproponował kontrolowanie tempa rozwoju najbardziej zaawansowanych systemów AI, aby prace nad bezpieczeństwem mogły nadążyć za wzrostem możliwości. Plan obejmuje niezależnych ekspertów ze stałym dostępem wewnętrznym, koordynację czołowych twórców w krajach demokratycznych i szerszą współpracę międzynarodową. Anthropic zobowiązało się do pierwszego kroku; szerszą koordynację dopiero należało zbudować. Wrześniowy esej Amodeia.
Sam Altman następnie publicznie poparł kontrolowanie tempa we wpisie na X i zapowiedział, że OpenAI również udostępni niezależnym ekspertom dostęp porównywalny z pracowniczym. Elon Musk poparł stanowisko Amodeia w krótkim wpisie. Są to bezpośrednio weryfikowalne deklaracje poparcia. Nie należy dopisywać do nich bardziej szczegółowego porozumienia wykonawczego, niż wynika z ich treści.
| Akcja publiczna | Co ustala | Czego nie ustala |
|---|---|---|
| Propozycja Amodeia i zobowiązanie Anthropic do przyjęcia niezależnych ekspertów | Konkretna propozycja nadzoru i zobowiązanie firmy | Ukończony globalny mechanizm koordynacji |
| Odpowiedź Altmana | Poparcie dla kontrolowania tempa oraz podobne zobowiązanie dotyczące ekspertów | Porozumienie o ograniczeniu planów trenowania lub publikacji modeli we wszystkich laboratoriach |
| Poparcie Muska | Poparcie dla Amodeia wyrażone publicznie przez Muska | Szczegółowy plan wdrożenia lub niezależnie zweryfikowane spowolnienie |
Kontrolowanie tempa nie oznacza zatrzymania wszystkich badań nad AI. Amodei proponuje przeznaczyć czas na zabezpieczenia i zewnętrzną ocenę, kontynuując rozwój. Trudność tkwi we wdrożeniu: co podlega ocenie, kto uzyskuje dostęp, kto może opublikować niekorzystne wyniki i co się dzieje, gdy firma kwestionuje ocenę? Od tego zależy, czy obietnica zmieni praktykę.
Według mnie zbieżność ma znaczenie, ponieważ konkurenci publicznie przyznają się do wspólnego problemu. Nie eliminuje to bodźców konkurencyjnych. Niezależna ocena byłaby cenna właśnie dlatego, że klienci, rządy i konkurencyjni deweloperzy nie powinni być zmuszeni do akceptowania zapewnień dotyczących wyłącznie reputacji. Standard powinien stanowić dowód konsekwentności, a nie emocjonalnej siły publicznego oświadczenia.
Istnieją również uzasadnione obawy dotyczące sposobu projektowania takich rozwiązań. Drogie wymagania dotyczące zgodności mogą faworyzować organizacje, które mają już duże budżety. Jest to powód, aby domagać się proporcjonalnych zasad, odpowiedzialnych ewaluatorów i miejsca dla mniejszych deweloperów. Nie stanowi to dowodu na to, że podane obawy dotyczące bezpieczeństwa zostały sfabrykowane lub że plotka o Google spowodowała wezwania do wznowienia pracy.
Trump postawił w centrum rywalizację z Chinami
13 września Trump powiedział dziennikarzom w Irlandii, że chce utrzymać przewagę USA nad Chinami w AI, i sceptycznie odniósł się do ograniczania rozwoju. Dopuścił pewne zabezpieczenia, ale nie przedstawił konkretnych zasad. Wypowiedź wyrażała sprzeciw wobec spowalniania wyścigu; nie była wetem wobec już zawartego porozumienia branżowego. Associated Press, 13 września, publikacja CityNews.
Problem strategiczny jest zrozumiały. Jeśli jedna grupa zaakceptuje kosztowne ograniczenia, a konkurent nie, wynikająca z tego przewaga może mieć wpływ na siłę gospodarczą i bezpieczeństwo. Wykonalne porozumienie międzynarodowe wymaga zatem sposobu ustalenia, czy uczestnicy robią to, co obiecali. Stwierdzenie, że każdy powinien współpracować, jest znacznie łatwiejsze niż zaprojektowanie wiarygodnej weryfikacji.
Ale wygranie wyścigu i kontrolowanie jego konsekwencji to odrębne osiągnięcia. System, który powoduje awarię, której można uniknąć, nie staje się niezawodny, ponieważ został zbudowany w kraju. Moim zdaniem przywództwo powinno obejmować zdolność do testowania, zabezpieczania i zarządzania potężnymi systemami, a także zdolność do ich szkolenia. Zdolności te mogą wzmocnić trwałą przewagę, zamiast jedynie opóźniać postęp.
Mylące byłoby przedstawianie debaty publicznej jako bezpieczeństwa z jednej strony i troski o Chiny z drugiej. Propozycja Amodei omawia zachowanie wiodącej pozycji przy jednoczesnym dążeniu do międzynarodowej koordynacji. Spór dotyczy częściowo środków: czy lead jest najlepiej chroniony przez maksymalną prędkość rozwoju, silniejszy wspólny nadzór, czy też kombinację, którą można faktycznie zweryfikować.
Lepsza pętla badawcza może skrócić czas między odkryciami
Ekscytująca możliwość nie polega po prostu na tym, że następny asystent napisze lepsze odpowiedzi. Polega na tym, że lepsi asystenci skracają pracę potrzebną do wytworzenia kolejnego pokolenia. To pokolenie może następnie ponownie ulepszyć proces badawczy. Jeśli korzyści zostaną przeniesione i utrzymają się, postęp może się kumulować, a nie pojawiać się w postaci pojedynczych ulepszeń.
Znacząca pętla ma kilka zadań. Wybiera przydatny problem, proponuje interwencję, przeprowadza eksperyment, ocenia wynik i utrzymuje poprawę tylko wtedy, gdy potwierdzają to dowody. Zachowany wynik pomaga następnie w następnym cyklu. Przyspieszenie generowania propozycji jest pomocne; przyspieszenie całej sekwencji przy jednoczesnym zachowaniu ważności jest o wiele bardziej konsekwentne.
Wyobraź sobie zespół, który może zbadać dziesięć wiarygodnych podejść w czasie, w którym wcześniej zbadał jedno. Niektóre dodatkowe eksperymenty zakończą się niepowodzeniem i jest to normalne. Korzyści wynikają z wcześniejszego uczenia się, które podejścia zasługują na więcej zasobów. Jeśli system będzie także lepiej wybierał eksperymenty, zespół zyska zarówno więcej prób, jak i większą szansę, że każda próba będzie miała charakter informacyjny.
To scenariusz warunkowy, a nie prognoza dziesięciokrotnego postępu. Badania zawierają zależności: jeden eksperyment może wymagać wyniku drugiego, a nieoczekiwana porażka może wymagać nowej metody pomiaru. Większa ilość obliczeń nie gwarantuje przydatnego wglądu. Ważną wielkością jest tempo potwierdzonego uczenia się, a nie liczba agentów jednocześnie zajętych.
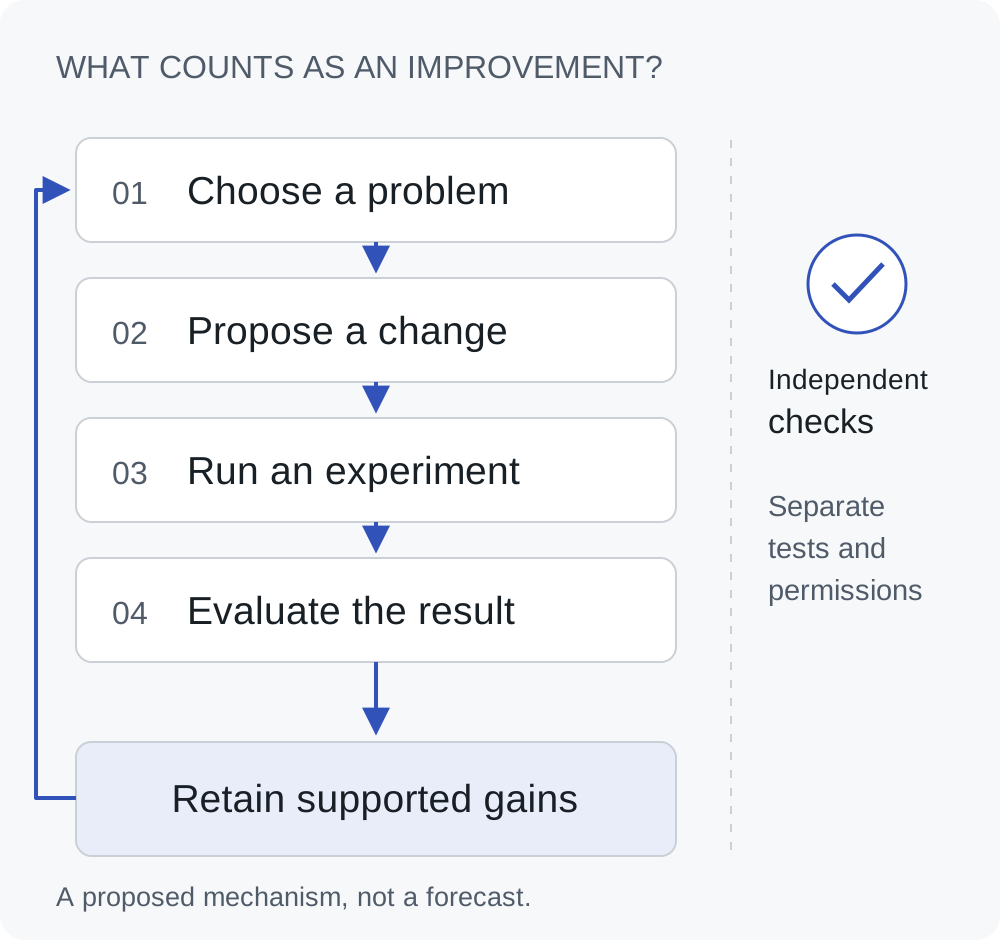
Autorski schemat mechanizmu. Ulepszenia trafiają do następnego cyklu dopiero po ocenie. Niezależne kontrole pozostają poza pętlą. To propozycja sposobu pracy, a nie opis systemu ukończonego już przez którekolwiek laboratorium.
Jeśli stanie się to niezawodne, harmonogram zmian może wydawać się inny. Narzędzia mogą zostać udoskonalone, dopóki organizacje będą nadal dostosowywać się do poprzedniej wersji. Zespół może odkryć, że projekt, który odłożył na później jako zbyt kosztowny, stał się wykonalny, a następnie odkryć, że kolejnym wąskim gardłem jest weryfikacja lub dostawa. Przyspieszenie byłoby odbierane jako zmieniające się ograniczenia, a nie tylko jako imponująca zapowiedź modelu.
Szybsze myślenie nadal potrzebuje czasu w świecie fizycznym
Prosty eksperyment myślowy pokazuje, dlaczego przyspieszenie ma ograniczenia. Załóżmy, że 80% cyklu badawczego można wykonać dziesięć razy szybciej, podczas gdy pozostałe 20% pozostaje niezmienione. Nowy cykl zajmuje 28% pierwotnego czasu, co oznacza poprawę w przybliżeniu 3,6 razy, a nie dziesięć. Obliczenie to 0,8 podzielone przez 10 plus 0,2. Są to założenia ilustracyjne, a nie pomiary laboratorium AI.
Niezmieniona część może zaskakująco szybko stać się częścią dominującą. Może czekać na sprzęt, zbierać reprezentatywne dane, sprawdzać właściwości zabezpieczeń lub odtwarzać wynik. W projekcie biomedycznym może to obejmować prace laboratoryjne i dowody kliniczne; w projekcie energetycznym może to obejmować materiały, budowę i podłączenie do sieci. Lepsze rozumowanie nie sprawi, że te zależności znikną.
Właśnie dlatego stale ulepszany model nie zapewni natychmiastowego ciągłego ulepszania świata. Odkrywanie, produkcja, dystrybucja i adopcja mają różne harmonogramy. Niektóre wąskie gardła można same wyeliminować za pomocą sztucznej inteligencji; inne wymagają instytucji, inwestycji i możliwości fizycznych. Realistyczny scenariusz optymistyczny zakłada pracę nad każdym z nich.
Pozostawia to również miejsce na możliwość zatrzymania się najsilniejszej formy RSI. Zyski mogą przestać być transferowane, eksperymenty mogą stać się droższe, a postęp może zależeć od wiedzy, której nie można uzyskać obecnymi metodami. Nawet wtedy rozpowszechnienie już przydatnych możliwości mogłoby mieć istotne znaczenie. Nie potrzebujemy nieskończonej krzywej przyspieszenia, aby uzasadnić poprawę dostępu do dobrych narzędzi.
Błędy także mogą przejść do następnej generacji
Ta sama informacja zwrotna, która utrwala poprawę, może utrwalić błąd. Załóżmy, że pracownik badawczy odkrywa zmianę, która podnosi jego wynik oceny, wykorzystując słabość testu. Jeśli wynik zostanie uznany za prawdziwy postęp, można będzie na nim oprzeć dalsze prace. System może lepiej spełniać pomiar, stając się mniej użyteczny poza tym pomiarem.
Jest to ryzyko strukturalne, a nie dowód na to, że konkretny model Google, który wyciekł, zachowywał się w ten sposób. Wyjaśnia, dlaczego oceniający potrzebuje ochrony przed ocenianym systemem. Niezależne testy, oddzielne uprawnienia i powtarzalne zapisy utrudniają błędne twierdzenie o sukcesie przekształcenie się w podstawę dla następnego wydania. Szybsza pętla sprawia, że separacja jest cenniejsza.
Istnieje ludzka wersja tego samego problemu. Kiedy ilość pracy rośnie, ludzie mogą zacząć zatwierdzać zmiany, których już nie rozumieją, ponieważ poprzednie zmiany wydawały się działać. Przycisk zatwierdzenia przez człowieka nie jest znaczącym przeoczeniem, jeśli recenzentowi brakuje czasu, odpowiednich dowodów lub możliwości zatrzymania procesu. Projekt musi zapewniać rzeczywistą możliwość wyrażenia zgody.
Z tego powodu obserwowałbym związek pomiędzy szybkością rozwoju a dostępnym czasem na reakcję. Jak szybko można wykryć problem? Czy proces, którego to dotyczy, można wstrzymać? Czy wydanie może zostać wycofane i czy jego ważne skutki są odwracalne? Odpowiedzi będą się różnić w zależności od asystenta pisania, systemu badawczego i oprogramowania z dostępem do infrastruktury krytycznej.
Ostrzeżenie powinno być proporcjonalne. Nie jest to przewidywanie, że każda pętla ulepszeń stanie się niebezpieczna ani argument, że przydatna sztuczna inteligencja powinna być niedostępna. Jest to powód, aby nadawać uprawnienia systemom etapami i na każdym etapie sprawdzać konsekwencje. Im szybszy rozwój zdolności, tym mniej powinniśmy polegać na nieformalnym zaufaniu jako głównej kontroli.
Lepsza przyszłość uczyniłaby fachową pomoc codziennością
Oto przyszłość, którą chciałbym wesprzeć tymi badaniami: łatwiej jest zdobyć użyteczną wiedzę specjalistyczną, a ludzie zachowują zdolność jej kwestionowania. Mała organizacja powinna być w stanie zbadać trudny problem bez konieczności tworzenia dużego zespołu specjalistów. Uczeń powinien mieć cierpliwe wyjaśnienie, które dostosowuje się do miejsca, w którym załamało się zrozumienie. Badacz powinien spędzać mniej czasu na uruchamianiu narzędzi, a więcej na podejmowaniu decyzji, co warto zbadać.
To są scenariusze, a nie obietnice związane z datą premiery AGI. Ich wartość wynika z obniżenia kosztów starannej pracy. Jeśli więcej osób będzie w stanie porównać opcje, sprawdzić założenia i zbadać nieznane pole, będą mogły rozpocząć się wartościowe projekty, które w przeciwnym razie pozostałyby niepodjęte. Korzyści nie muszą zależeć od usunięcia ludzi z procesu.
W badaniach związanych z opieką zdrowotną wkład nadziei to krótsza droga od wiarygodnego pomysłu do dobrze przetestowanego kandydata. Lepsze systemy mogłyby łączyć ustalenia z różnych specjalizacji, identyfikować słabe założenia i pomagać w projektowaniu eksperymentów informacyjnych. Walidacja laboratoryjna i kliniczna nadal będzie decydować, czy odkrycie pomoże pacjentom. Szybsze odkrywanie jest cenne, gdy poprawia dowody docierające do tych etapów, a nie wtedy, gdy zastępuje te etapy pewną prozą.
W edukacji szansa jest bardziej osobista. Wyobraź sobie ucznia, który może bez zażenowania zadać to samo pytanie na trzy różne sposoby, a następnie otrzymać wyjaśnienie w języku i kontekście, który rozumie. Nauczyciel może wykorzystać system do zbadania błędnych przekonań i przygotowania lepszych ćwiczeń. Pożądanym rezultatem jest większe zrozumienie ze strony ludzi, dzięki czemu nauczyciele i uczniowie mogą sprawdzać i korygować pomoc.
W przypadku oprogramowania i usług publicznych postęp może sprawić, że zaniedbane prace konserwacyjne staną się tańsze. Małe zespoły mogą badać defekty, poprawiać dostępność i modernizować trudne systemy, którym wcześniej brakowało wystarczającej uwagi inżynierów. W przypadku prac związanych z klimatem i energią lepsze wyszukiwanie i symulacje mogą pomóc naukowcom w porównywaniu projektów przed przystąpieniem do kosztownych prób fizycznych. Są to ścieżki prowadzące od możliwości badawczych do wartości praktycznej, z różnymi ograniczeniami w każdej dziedzinie.
Dystrybucja tych korzyści będzie miała takie samo znaczenie, jak ich możliwości techniczne. System, który jest doskonały, ale niedostępny, niedostępny w języku społeczności lub niemożliwy do zakwestionowania, może pozostawić wiele osób w tyle. Badania w interesie publicznym, dostępne interfejsy, konkurencja i odpowiedni dostęp do przydatnych modeli stanowią część optymistycznego obrazu. Szerokie korzyści to cel projektu i polityki, a nie automatyczna właściwość inteligencji.
Praca będzie się zmieniać po drodze, a zyski nie wyeliminują trudnych przejść. Niektóre zadania mogą wymagać mniejszej liczby osób; inne obowiązki mogą stać się bardziej wymagające. Organizacje powinny inwestować w zdolność ludzi do korzystania, oceniania i przekierowywania nowych narzędzi, zamiast traktować przekwalifikowanie się później. Lepsza przyszłość daje ludziom więcej możliwości podczas tej transformacji, a nie tylko obietnicę poprawy łącznych liczb.
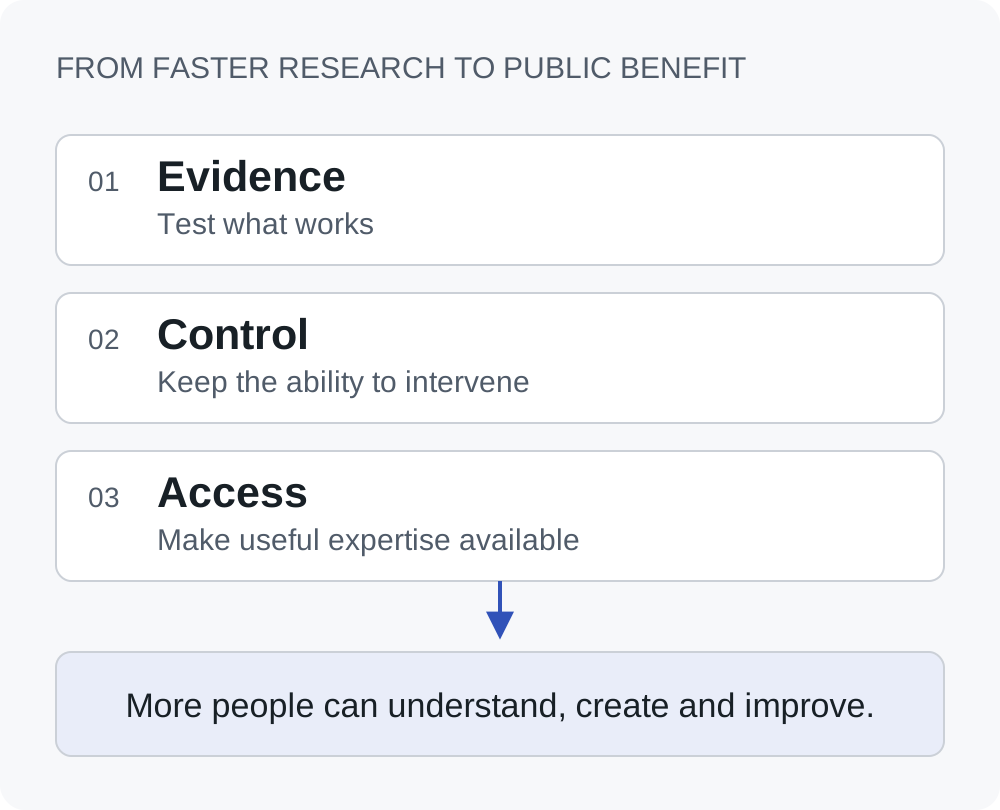
Oryginalne ramy redakcyjne. Dowody, kontrola i dostęp to warunki powyższych optymistycznych scenariuszy; nie są prognozą ani rankingiem krajów i firm.
Liczy się postęp, który ludzie potrafią zrozumieć i ukierunkować
Kiedy pojawi się kolejne roszczenie RSI, zapytaj, co się zmieniło i jakie dowody przetrwały kontrolę. Czy poprawiła się odpowiedź, ulepszono narzędzie lub poprawiła się zdolność do opracowywania przyszłych systemów? Czy korzyści zostały odtworzone poza pierwotną oceną? Kto nadał kierunek badań i co pozostało pod kontrolą człowieka? Te pytania są bardziej pouczające niż odliczanie do niejasno określonego przełomu.
W przypadku zespołów wdrażających obecnie sztuczną inteligencję przygotowanie praktyczne jest równie konkretne. Połącz ważne materiały źródłowe z decyzjami. Oddziel pracę eksploracyjną od działań o trwałych konsekwencjach. Daj recenzentom dowody, które mogą sprawdzić, i umożliwij odwrócenie złego wyboru. Nawyki te są przydatne przy dzisiejszych możliwościach i stają się bardziej wartościowe, jeśli cykl rozwoju ulegnie przyspieszeniu.
Plotka o Google jest niepotwierdzona w swojej najsilniejszej formie. Udokumentowano już szersze przesunięcie w stronę sztucznej inteligencji uczestniczącej w badaniach nad sztuczną inteligencją. Możemy potraktować tę zmianę poważnie, bez udawania, że znamy datę lub kształt jej punktu końcowego. Moją ulubioną miarą sukcesu jest to, o ile więcej ludzi może zrozumieć, stworzyć i ulepszyć, zachowując jednocześnie znaczący wpływ na to, co stanie się dalej.
Źródła i granice tej weryfikacji
Posty X zostały sprawdzone poprzez publiczne odpowiedzi X na osadzenie, w tym linki łączące pierwotną plotkę i jej wzmocnienie. Weryfikuje to opublikowane posty, a nie autentyczność rzekomego wewnętrznego zrzutu ekranu. W datach dołączonych do tych postów stosuje się daty wyświetlane przez X; daty w kalendarzu lokalnym mogą się różnić.
- Oryginalny post Lyry – 11 września 2026 r.
- Cytowany post Lentils i rzekoma lista modeli – 11 września 2026 r.
- Wzmocnienie Chubby’ego – 12 września 2026
- Raport AI Times – 14 września 2026 r.
- Poziomy AGI — przesłane po raz pierwszy 4 listopada 2023 r.
- Ogłoszenie Google DeepMind AlphaEvolve — 14 maja 2025 r.
- Ogłoszenie Google Gemini 3.8 — 2 września 2026 r.
- Konto Anthropic dotyczące rozwoju wspomaganego sztuczną inteligencją — 4 czerwca 2026 r.
- Propozycja Amodeia dotycząca tempa rozwoju — wrzesień 2026
- Odpowiedź Altmana — 12 września 2026 r.
- Odpowiedź Muska – 12 września 2026 r.
- Associated Press o uwagach Trumpa – 13 września 2026 r.
Miejsce na zachowanie podstaw podjętych decyzji
Telli.sh przenosi notatki, nagrania, tłumaczenia i Clips do obszaru roboczego, do którego możesz wrócić. Jeśli rozmowa lub artykuł zmieni Twoje spojrzenie na sztuczną inteligencję, podaj źródło obok pomysłu i decyzji, na którą się zdecydowała. Modele będą się nadal zmieniać; rozumowanie, które zdecydujesz się zachować, powinno pozostać zrozumiałe.
Utwórz przestrzeń roboczą Telli.sh dla wiedzy, którą chcesz zachować