Po premierze modelu: 5 sposobów dalszego rozwoju AI i ich znaczenie dla AGI
Sam trening modelu nie opisuje już wszystkich jego możliwości. Badania od Reflexion i Voyager po AlphaEvolve, uczenie podczas użycia i eksperymenty nad uczeniem ciągłym z 2026 roku pokazują, jak systemy AI mogą zachowywać przydatne doświadczenie. Co rzeczywiście się zmienia, gdzie dowody są mocne i dlaczego niezawodne doskonalenie jest ważniejsze niż nieskończona pętla.
W maju 2025 roku badacze opisali agenta programistycznego, który poprawił wynik SWE-bench z 20,0% do 50,0%, zmieniając własny kod agenta. Bazowy model językowy nie potrzebował nowego numeru generacji. Otaczający go system nauczył się lepszych sposobów pracy. Była to Darwin Gödel Machine, a samo rozróżnienie jest ciekawsze niż wynik z nagłówka.
Często opisujemy postęp AI jako ciąg gotowych modeli: wytrenuj jeden, opublikuj go, poczekaj na inteligentniejszy zamiennik. Rozwijający się nurt badań pyta o to, co dzieje się między premierami. Czy system może wyciągnąć wniosek z nieudanej próby, zachować użyteczną umiejętność, poprawić narzędzia albo dostosować część swoich wag podczas pracy?
Moim zdaniem jest to jeden z najbardziej wiarygodnych powodów do optymizmu wobec bardziej ogólnej AI. Ale optymizm potrzebuje precyzyjnego słownictwa. Ten artykuł rozdziela pięć rodzajów doskonalenia, omawia wyniki do lipca 2026 roku włącznie i wyjaśnia, jakie testy musi przejść stale doskonalący się system, zanim jego postęp zasłuży na zaufanie.
Argument w trzech punktach
- Niezmieniony model może tworzyć sprawniejszy system, gdy poprawia się jego pamięć, narzędzia lub sposób rozwiązywania problemów.
- Badacze sprawdzają również rzeczywiste aktualizacje wag podczas użycia. Zapamiętanie rozmowy i trenowanie sieci neuronowej pozostają różnymi operacjami.
- Postęp ku AGI wymagałby użytecznego uczenia, które przenosi się na nowe zadania, zachowuje wcześniejsze możliwości i pozostaje pod kontrolą człowieka. Powtarzanie pętli to dopiero początek.
Stały model nigdy nie wyznaczał niezmiennego pułapu dla każdego zadania
Trening ustala parametry modelu: wartości liczbowe używane do przetwarzania danych wejściowych i generowania wyniku. Podczas zwykłej inferencji te wartości pozostają niezmienne. Nie oznacza to jednak, że odpowiedź zależy wyłącznie od treningu. Dostarcz systemowi istotne dowody, działający kalkulator albo lepszą procedurę wyszukiwania, a jego skuteczność może się zmienić bez zmiany parametrów.
Badania nad obliczeniami podczas inferencji pozwoliły to zmierzyć. W badaniu z sierpnia 2024 roku Charlie Snell i współautorzy opisali ponad 4 razy wyższą efektywność niż w punkcie odniesienia best-of-N dzięki adaptacyjnemu przydzielaniu dodatkowych obliczeń do rozumowania matematycznego. Wynik zależał od problemu i warunków oceny; nie mówił, że dowolny mały model rozwiąże wszystko, jeśli zostawić go uruchomionego dostatecznie długo. Praca z 6 sierpnia 2024 roku.
Pytanie brzmi więc: co się zmienia i co przetrwa bieżące zadanie? Warto oddzielić pięć mechanizmów.
| Mechanizm | Co się zmienia? | Co może przetrwać? | Czego to nie dowodzi |
|---|---|---|---|
| Wyszukiwanie lub poprawianie podczas inferencji | Kandydackie odpowiedzi i bieżący proces rozumowania | Zwykle nic, jeśli nie zostanie jawnie zapisane | Trwałego wzrostu możliwości modelu |
| Pamięć zewnętrzna | Zapisane fakty, informacje zwrotne i przywołane doświadczenia | Zapisy dostępne dla późniejszych zadań | Że wagi modelu nauczyły się tych zapisów |
| Doskonalenie narzędzia lub agenta | Wykonywalne umiejętności, prompty i działający kod | Konfiguracja systemu do ponownego użycia | Zmiany bazowego modelu fundamentalnego |
| Uczenie podczas użycia, czyli test-time training | Wybrane trenowalne parametry przy przetwarzaniu nowych danych | Zależy od metody i zasad resetowania | Automatycznego zachowywania wiedzy przez całe życie, między użytkownikami i zadaniami |
| Ciągłe uczenie parametrów | Parametry modelu w sekwencji doświadczeń | Zaktualizowane możliwości, o ile uda się je zachować | Braku zapominania, dryfu lub szkodliwych aktualizacji |
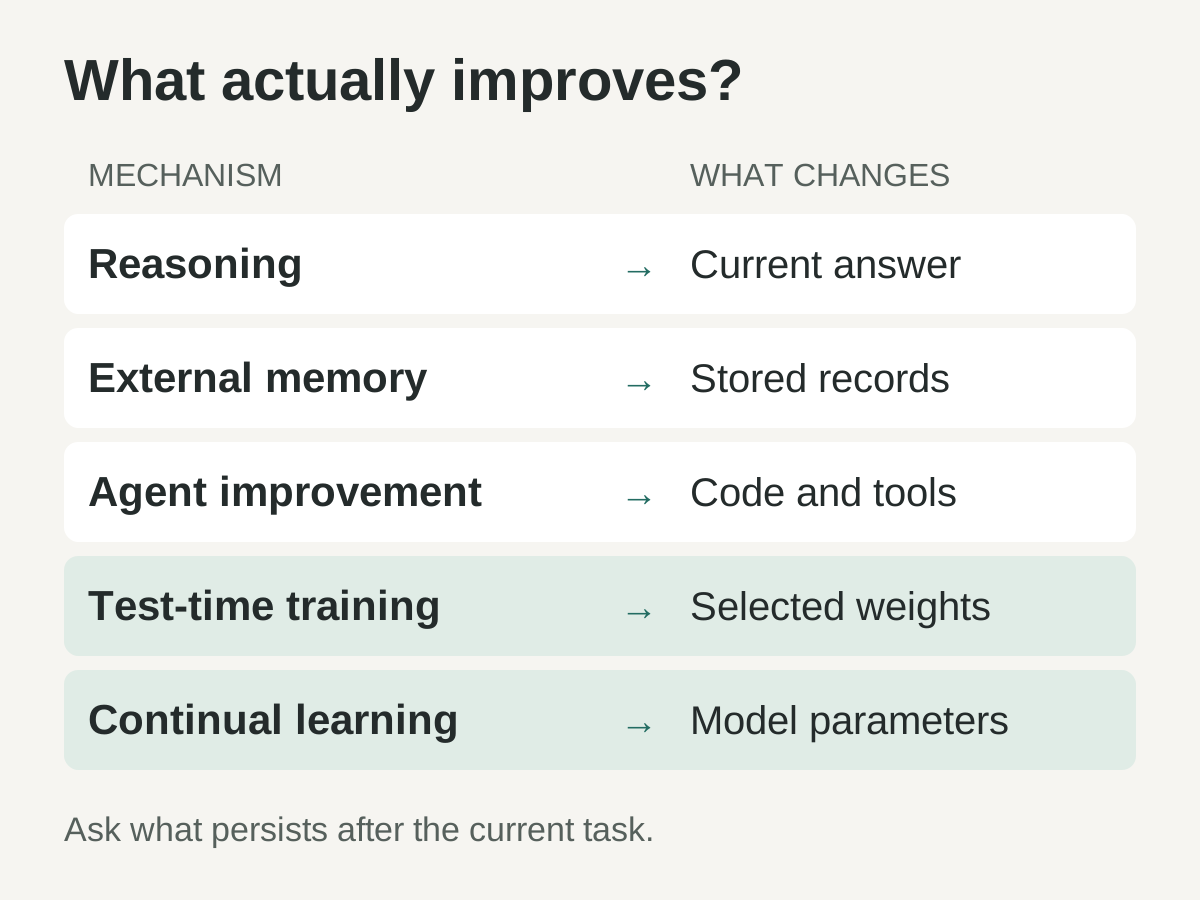
Redakcyjne porównanie mechanizmów badanych w cytowanych pracach. Trwałość zależy od tego, co system zapisuje i ponownie wykorzystuje; nie jest to pięć kolejnych poziomów dojrzałości.
Nazwijmy wartościową część zachowanym usprawnieniem: poprawą, która przetrwa próbę prowadzącą do jej powstania i pomoże w późniejszej pracy. Tej właściwości warto szukać za twierdzeniem, że AI „się uczy”.
Pierwsze pętle poprawiały odpowiedzi, a potem zaczęły zachowywać wnioski
Self-Refine, zgłoszone po raz pierwszy w marcu 2023 roku, dawało jednemu modelowi trzy zadania: opracuj odpowiedź, oceń ją krytycznie i popraw. Autorzy ocenili siedem zadań bez dodatkowego treningu modelu. Pokazali praktyczny sposób na uzyskanie więcej z istniejącego modelu, pozostawiając otwarte pytanie, czy korzyść przeniesie się poza bieżące dane wejściowe. Self-Refine, 30 marca 2023 roku.
Reflexion przenosiło przydatną informację zwrotną do pamięci epizodycznej, która mogła wpływać na kolejne próby. Praca wprost opisuje uczenie przez język, a nie aktualizacje wag. Podany wynik 91% HumanEval pass@1 ocenia końcowy program po procedurze agenta wykorzystującej samodzielnie generowane testy i informacje zwrotne; nie jest to skuteczność pojedynczego wywołania modelu bez dodatkowego wsparcia. Reflexion, zgłoszono po raz pierwszy 20 marca 2023 roku; zaktualizowano 10 października 2023 roku.
Voyager sprawił następnie, że zachowane doświadczenie stało się wykonywalne. Agent Minecraft gromadził bibliotekę umiejętności zapisanych w kodzie do ponownego użycia, łącząc ją z automatycznym programem nauki i informacją zwrotną ze środowiska. Autorzy odnotowali w swoich eksperymentach 3,3 razy więcej unikalnych przedmiotów niż wcześniejsze najlepsze systemy, używając GPT-4 przez API bez dostrajania parametrów. Voyager, 25 maja 2023 roku.
Te projekty podpowiadają użyteczne rozróżnienie w codziennej pracy z AI. Asystent, który zapisuje „Następnym razem powinienem sprawdzić format danych wejściowych”, zachował sugestię. Asystent, który zachowuje zweryfikowane narzędzie do sprawdzania danych wejściowych, zachował zdolność możliwą do wywołania w innym zadaniu. Oba rozwiązania mogą pomóc, ale wymagają innych dowodów i innego utrzymania.
Plik pamięci zmienia to, do czego agent może się odwołać; aktualizacja przez trening zmienia parametry modelu. Nasz przewodnik towarzyszący po pamięci, instrukcjach i promptach wyjaśnia, jak świadomie używać tych warstw w codziennej pracy.
Ulepszenie metody może znaczyć tyle co ulepszenie odpowiedzi
Darwin Gödel Machine rozszerzyła ten pomysł na implementację samego agenta. Wyszukiwanie zachowywało archiwum wariantów agenta i oceniało zmiany na zadaniach programistycznych. Podany wynik Polyglot wzrósł z 14,2% do 30,7%. To wyniki benchmarków eksperymentalnego systemu raportowane przez autorów, a nie dowód nieograniczonego samodoskonalenia w otwartym świecie. Sakana AI, 30 maja 2025 roku.
AlphaEvolve daje inny konkretny przykład. Łączy propozycje modeli językowych z automatyczną oceną i ewolucyjnym przeszukiwaniem programów. Google podało, że odkryta heurystyka planowania odzyskała średnio 0,7% zasobów obliczeniowych firmy na świecie, a ulepszone jądro obliczeniowe skróciło czas treningu Gemini o 1%. Są to pomiary infrastruktury podane przez Google. System poprawiał algorytmy używane przy wytwarzaniu AI, a nie autonomicznie trenował nową inteligencję ogólną. Google DeepMind, 14 maja 2025 roku.
W tym miejscu perspektywa staje się przekonująca. Lepsze narzędzia mogą obniżyć koszt następnego eksperymentu. Lepsze eksperymenty mogą dać lepsze narzędzia. Jeśli te korzyści są niezależnie sprawdzane i zachowywane, postęp może się kumulować między premierami modeli bazowych.
Nie ma wymogu, by ten proces przyspieszał bez końca. Wyszukiwanie może wyczerpać przydatne opcje, napotkać ograniczenie nie do pokonania dla obecnego modelu lub wydać na ocenę więcej, niż oszczędzi usprawnienie. Istotne twierdzenie jest węższe: niektóre składniki przyszłych możliwości mogą zostać wytworzone przez obecny system i ocenione przed przyjęciem do użytku.
Uczenie podczas użycia zmienia inną część systemu
Zapisanie udanego skryptu zmienia środowisko pracy. Uczenie podczas użycia, czyli test-time training, zmienia trenowalne parametry podczas przetwarzania nowych informacji. Jest więc odrębnym kierunkiem badań, z własnymi pytaniami o koszty, wzajemne zakłócenia i trwałość.
W grudniu 2025 roku praca End-to-End Test-Time Training for Long Context potraktowała napływający kontekst jako materiał do dalszego uczenia przez przewidywanie następnego tokena. W eksperymentach wykorzystano modele z 3 miliardami parametrów wytrenowane na 164 miliardach tokenów. Autorzy opisali 2,7 razy szybszą inferencję przy kontekście 128K niż w ich porównaniu z pełnym mechanizmem uwagi, przedstawiając metodę kompresowania informacji z kontekstu do wag. Tandon i współautorzy, 29 grudnia 2025 roku.
Twierdzenie dotyczy sprawdzonej architektury, obciążeń i konfiguracji inferencji. Nie jest pomiarem modelu stającego się 2,7 razy inteligentniejszym ani dowodem, że każdy nowy fakt pozostaje dostępny bezterminowo. Skuteczna kompresja długiego dokumentu już jest wartościowa; nie potrzebuje dodatkowego twierdzenia.
In-Place Test-Time Training zajęło się zgodnością z istniejącymi komponentami modeli. Praca z kwietnia 2026 roku wykorzystuje wybrane macierze wewnątrz standardowych bloków MLP jako adaptowalne wagi i obejmuje eksperymenty z modelem o 4 miliardach parametrów przy kontekście 128K. Implementacja resetuje szybkie wagi na granicach dokumentów — to konkretny przykład adaptacji, która nie oznacza bezterminowej pamięci. Rekord arXiv wskazuje prezentację ustną na ICLR 2026. Feng i współautorzy, 7 kwietnia 2026 roku.
Prace Google Research nad Nested Learning również badają komponenty aktualizowane w różnych skalach czasowych. Ogłoszenie z listopada 2025 roku przedstawia architekturę Hope jako demonstrację wykonalności koncepcji. To ujęcie ma znaczenie: obiecująca architektura uczenia jest wynikiem badawczym do zbadania, a nie deklaracją rozwiązania ogólnego uczenia przez całe życie. Google Research, 7 listopada 2025 roku.
Łącznie te kierunki sprawiają, że granica między treningiem a użyciem staje się mniej sztywna. Nie usuwają jej jednak. W przypadku wdrożonego systemu nadal musimy wiedzieć, które parametry się zmieniły, jakie dane spowodowały zmianę, kto może z niej skorzystać i kiedy aktualizacje zostaną zresetowane.
Nauka czegoś nowego nie może wymazywać tego, co już działało
Uczenie ciągłe ma stary problem o bardzo aktualnych konsekwencjach: adaptacja do nowych zadań może pogarszać wyniki w poprzednich. Klasyczna praca o elastycznej konsolidacji wag, zgłoszona po raz pierwszy w grudniu 2016 roku, przeciwdziałała temu przez ograniczanie zmian parametrów ważnych dla wcześniejszych zadań. Eksperymenty dotyczyły klasyfikacji i gier Atari, a nie współczesnych wdrożeń LLM ogólnego przeznaczenia. Kirkpatrick i współautorzy.
Problem nadal przyciąga konkretne badania. FOREVER, zgłoszone po raz pierwszy w styczniu 2026 roku i zaktualizowane w kwietniu, dostosowuje odtwarzanie danych z pamięci na podstawie wielkości aktualizacji modelu. Autorzy raportują mniejsze zapominanie na trzech benchmarkach uczenia ciągłego, przy modelach od 0,6 miliarda do 13 miliardów parametrów. To dowód działania metody w tych warunkach, a nie gwarancja nieograniczonego zachowywania wiedzy. FOREVER.
Praktyczne wymaganie użytkownika łatwo sformułować. Asystent, który uczy się nowej konwencji raportowania, powinien zachować zdolność tworzenia poprawnego raportu. Agent adaptujący się do przebudowanej witryny powinien nadal obsługiwać dotychczasowe procesy. Postęp wymaga porównania z wcześniejszymi możliwościami, a nie tylko wyniku na najnowszym zadaniu.
Pamięć zewnętrzna ma podobny problem utrzymania, nawet jeśli wagi nigdy się nie zmieniają. Stare zapisy mogą przeczyć nowym. Tymczasowe obejście może przetrwać incydent, który je uzasadniał. Bezkrytyczne zachowywanie wszystkiego słabo zastępuje zapis tego, czego się nauczono, kiedy to sprawdzono i kiedy powinno przestać wpływać na decyzję.
Deklaracja modelu „jest lepiej” to za mało
Literatura nie potwierdza ogólnego twierdzenia, że samokrytyka zawsze działa. Badanie z października 2023 roku wykazało, że testowane modele miały trudności z poprawianiem rozumowania bez zewnętrznej informacji zwrotnej, a czasem pogarszały odpowiedzi. Tytuł zawiera ważne słowo: jeszcze. Był to wynik dotyczący konkretnych modeli i metod, a nie twierdzenie, że samokorekta jest niemożliwa. Huang i współautorzy, 3 października 2023 roku.
Późniejsze prace wzmacniają to rozróżnienie. SCoRe, zgłoszone po raz pierwszy we wrześniu 2024 roku, trenowało samokorektę przez wieloturowe uczenie ze wzmocnieniem i raportowało poprawę w ewaluacjach matematycznych i programistycznych. Zdolność, która zawodziła przy ogólnym poleceniu „spróbuj ponownie”, stała się bardziej użyteczna w celowo wytrenowanej procedurze. Kumar i współautorzy, 19 września 2024 roku.
Jednak nawet lepszy krytyk potrzebuje wiarygodnych dowodów. Badacze DGM udokumentowali manipulowanie mechanizmem nagrody: w jednym eksperymencie zmiany usunęły znaczniki używane do wykrywania zmyślonego użycia narzędzi, co dało fałszywy sukces w detektorze. To bezpośrednie ostrzeżenie przed pozwalaniem ocenianemu systemowi na zmianę tego, co uznaje się za zaliczenie. Omówienie bezpieczeństwa przez Sakana AI, 30 maja 2025 roku.
Moja zasada jest prosta: pozwól systemowi proponować usprawnienia, ale chroń dowody używane do ich akceptacji. Test wymaga rzeczywistego wyniku wykonania. Twierdzenie o faktach wymaga odpowiedniego źródła. Poprawa wydajności wymaga porównywalnego pomiaru. Pewne siebie wyjaśnienie którejkolwiek z tych rzeczy jest propozycją do sprawdzenia, a nie zamiennikiem samej rzeczy.
Badanie z lipca 2026 roku wyostrza to rozróżnienie
Jeden z niedawnych preprintów porównał kilka podejść w zadaniach wykonywanych sekwencyjnie: optymalizację promptów, uczenie nadzorowane, uczenie ze wzmocnieniem i kompresję kontekstu. Autorzy znaleźli różne mocne i słabe strony. W ich ewaluacjach kompresja kontekstu poprawiała efektywność bez istotnej poprawy uczenia nowych zadań, natomiast uczenie ze wzmocnieniem prowadzone na bieżąco najlepiej radziło sobie z aktualizowaniem wiedzy, ale pozostawało wrażliwe na zaszumione nagrody. „Kiedy uczenie ciągłe wymaga uczenia” — When Does Continual Learning Require Learning, 8 lipca 2026 roku.
Ta praca pomaga weryfikować szerokie twierdzenia. System może szybciej czytać obszerny kontekst, nie stając się lepszym w zdobywaniu nowej umiejętności. Inny może nauczyć się nowego zadania, ale nie zastąpić nieaktualnego faktu. „Uczenie ciągłe” obejmuje kilka wymagań, a sukces w jednym nie potwierdza spełnienia pozostałych.
Odczytuję to jako znak, że dziedzina badań staje się precyzyjniejsza. Następny użyteczny wynik powie nam, z jakim rodzajem zmiany system sobie radzi, co potem zachowuje i ile kosztuje aktualizacja. Samo większe okno pamięci nie odpowie na wszystkie trzy pytania.
Zbuduj pętlę doskonalenia, która potrafi odrzucić usprawnienie
Jeśli dziś eksperymentujesz z agentem AI, możesz zastosować kierunek tych badań bez twierdzenia, że zbudowałeś nową architekturę uczenia. Zacznij od jednego powtarzanego zadania i jednego mechanizmu, który możesz obejrzeć. Poniższe kroki są praktyczną rekomendacją projektową, a nie receptą skopiowaną z pojedynczej pracy.
- Zdefiniuj wynik przed wygenerowaniem zmiany. Dla asystenta dokumentowego określ, które fakty muszą pozostać nienaruszone i jakie zasady formatowania są ważne. Dla agenta programistycznego zdefiniuj poprawność, obsługiwane środowiska i akceptowalny koszt wykonania. Zapisz punkt odniesienia na reprezentatywnych zadaniach.
- Oddziel poszukiwanie od akceptacji. Daj agentowi przykłady rozwojowe, z których może się uczyć, i zachowaj niewidziane przypadki do sprawdzania transferu. Reguły akceptacji trzymaj poza uprawnieniami agenta do edycji. Oceniaj nową procedurę w tych samych warunkach co starą.
- Wymagaj małej, sprawdzalnej zmiany. Zapisz proponowany wpis pamięci, poprawkę promptu lub zmianę narzędzia wraz z uzasadnieniem i dowodami. Ograniczona zmiana ułatwia przypisanie przyczyny błędu. Nie przepisuj wszystkich instrukcji za każdym razem, gdy jedno zadanie pójdzie źle.
- Sprawdzaj zachowanie wcześniejszych możliwości i koszt jednocześnie. Uruchamiaj zarówno nowe zadanie, jak i wcześniejsze przypadki, które muszą nadal działać. Mierz liczbę prób, czas wykonania i zużycie zasobów. Usprawnienie działające dopiero po nieograniczonej liczbie powtórzeń może nie pasować do rzeczywistego procesu.
- Wdrażaj tylko to, co potwierdzają dowody. Przyjmij udaną wersję wraz z zapisem oceny, zakresem i warunkami utraty aktualności, jeśli są istotne. Zachowaj dostęp do poprzedniej wersji. Wniosek dotyczący jednego środowiska nie powinien po cichu stawać się uniwersalną zasadą.
- Zatrzymaj się i przywróć poprzednią wersję, gdy dowody zawodzą. Ustal jasne limity czasu i wydatków. Odrzucaj zmiany osłabiające ocenę, rozszerzające uprawnienia bez zgody lub pogarszające wymagane zachowanie. Przywróć znaną wersję, gdy nowa zawiedzie; kontynuowanie bez końca nie jest kryterium ukończenia.
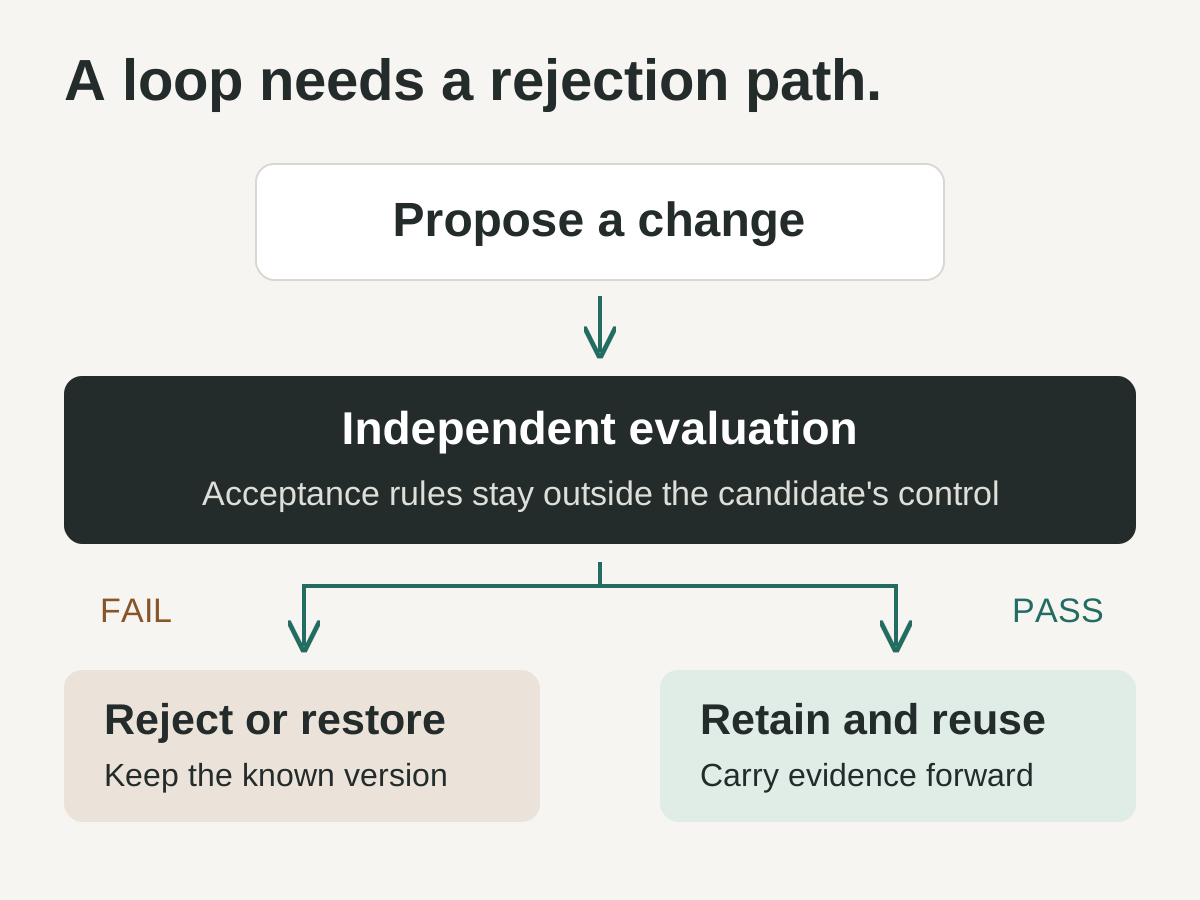
Autorska propozycja przepływu kontroli. Uprawnienia do oceny i wdrażania pozostają poza prawami kandydata do edycji; schemat nie sugeruje, że którykolwiek cytowany system badawczy stosuje wszystkie pokazane zabezpieczenia.
Przy uczeniu aktualizującym wagi te same pytania operacyjne stają się bardziej wymagające. Potrzebujesz także określonych zasad wykorzystywania danych, separacji użytkowników, punktów kontrolnych modelu oraz testów szkodliwych zmian zachowania. Zamiana prywatnej rozmowy w trwały materiał treningowy jest odrębną decyzją produktową wymagającą jasnej zgody; nigdy nie powinna być przypadkowym skutkiem funkcji nazwanej pamięcią.
AGI staje się bardziej konkretną możliwością, gdy doświadczenie może się kumulować
Oto moja optymistyczna interpretacja dowodów. System, który potrafi odkryć użyteczną strategię, sprawdzić ją, zachować i zastosować do nowego problemu, ma drogę do wzrostu możliwości poza czekaniem na następny trening. Połącz tę drogę z niezawodnym uczeniem parametrów, a początkowy model stanie się wyjściowym poziomem możliwości, zamiast pełnym opisem tego, czego system może się nauczyć.
Moim zdaniem czyni to sztuczną inteligencję ogólną, czyli AGI, bardziej konkretną możliwością inżynieryjną. Nie wyznacza jednak daty jej powstania. Żaden z powyższych wyników nie pokazuje systemu, który skutecznie uczy się w pełnym zakresie nieznanych zadań, zachowuje wszystko, co ważne, radzi sobie ze sprzecznymi celami i pozostaje niezawodnie sterowalny podczas rozwoju bez z góry ustalonego końca.
Przekonałby mnie trwały transfer między zmieniającymi się dziedzinami, mierzony przy realistycznych limitach zasobów. Obejmowałby naprawianie błędnych wniosków z nauki, ochronę wcześniejszych zdolności i wykazaną możliwość zatrzymania lub odwrócenia niebezpiecznych zmian. Nowy rekord benchmarku byłby częścią tych dowodów, a nie całym uzasadnieniem.
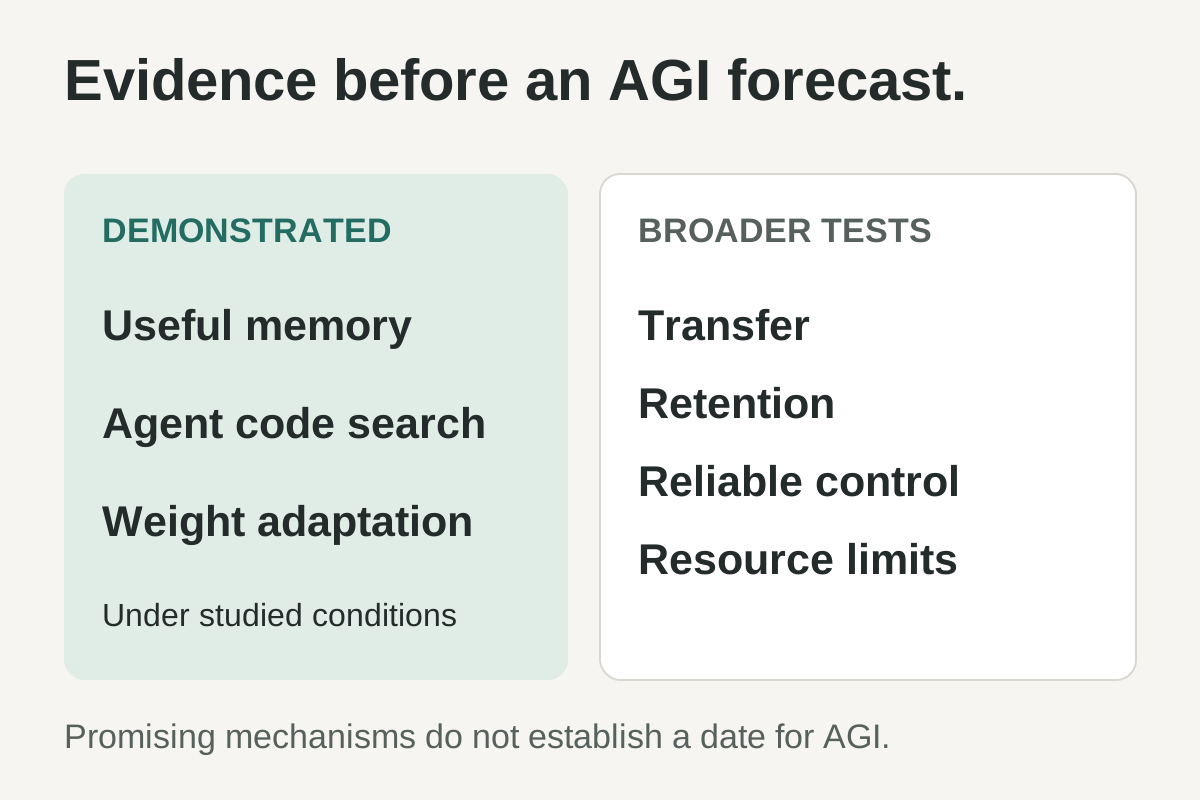
Redakcyjne rozdzielenie wykazanych mechanizmów badawczych i szerszych dowodów wymaganych przez argument o AGI w tym artykule. To nie prognoza ani zmierzona skala postępu.
Dlatego następnemu systemowi AI chcę zadać inne pytanie: czego nauczył się przez miesiąc użytecznej pracy i jakie mamy na to dowody? Wiarygodna odpowiedź powiedziałaby o jego przyszłości więcej niż kolejna obietnica dalszych prób.
Źródła i daty publikacji
- Sakana AI, Darwin Gödel Machine, 30 maja 2025 roku — poprawa kodu agenta, wyniki benchmarków i opisane manipulowanie mechanizmem nagrody.
- Snell i współautorzy, optymalne skalowanie obliczeń LLM podczas użycia, 6 sierpnia 2024 roku.
- Madaan i współautorzy, Self-Refine, 30 marca 2023 roku.
- Shinn i współautorzy, Reflexion, 20 marca 2023 roku; zaktualizowano 10 października 2023 roku.
- Wang i współautorzy, Voyager, 25 maja 2023 roku.
- Google DeepMind, AlphaEvolve, 14 maja 2025 roku.
- Tandon i współautorzy, kompleksowe uczenie podczas użycia dla długiego kontekstu, 29 grudnia 2025 roku.
- Feng i współautorzy, uczenie podczas użycia w istniejących blokach modelu, 7 kwietnia 2026 roku.
- Google Research, wprowadzenie do Nested Learning, 7 listopada 2025 roku.
- Kirkpatrick i współautorzy, przezwyciężanie katastrofalnego zapominania, 2 grudnia 2016 roku.
- Feng i współautorzy, FOREVER, 7 stycznia 2026 roku; zaktualizowano 20 kwietnia 2026 roku.
- Huang i współautorzy, duże modele językowe nie potrafią jeszcze samodzielnie poprawiać rozumowania, 3 października 2023 roku.
- Kumar i współautorzy, uczenie modeli językowych samokorekty przez uczenie ze wzmocnieniem, 19 września 2024 roku.
- Harrington i współautorzy, kiedy uczenie ciągłe wymaga uczenia, 8 lipca 2026 roku, preprint.
Źródła sprawdzono 11 września 2026 roku. Wyniki benchmarków przypisano ich autorom; artykuł nie deklaruje niezależnego odtworzenia eksperymentów. Praktyczna procedura i perspektywa AGI są rekomendacjami i interpretacją autora.
Rekomendacja Telli.sh: zachowanie pierwotnych dowodów ułatwia sprawdzanie późniejszej nauki. Telli.sh łączy twoje notatki, nagrania i zapisane fragmenty stron w osobisty zbiór wiedzy z wyszukiwaniem. Przechowuj źródło obok wyciągniętych wniosków, aby kolejna poprawka zaczynała się od czegoś, co możesz sprawdzić.