GPUノートブックを止めても、同じ実験の続きから始められる?
Googleのセルフホスト型GKE Workspacesは永続ファイル、再開できるアクセラレーターセッション、ブラウザーIDEを組み合わせます。層ごとに費用は異なります。
午後6時。ノートブックがようやくモデルを読み込み、検討する価値のある結果が出ました。セッションを止めると、明日は環境を作り直し、モデルを再び読み込むところから始まるかもしれません。動かしたままでは、貴重なアクセラレーターが一晩遊ぶ可能性があります。
Googleは11月4日、GKE Workspacesを発表しました。チームのGoogle Kubernetes Engineクラスターで動くオープンソースの開発環境です。ブラウザーのダッシュボードから、指定したリソースでJupyterLabやVS Codeを起動できます。Kubeflow Workspacesを土台に、対応するセッションを一時停止して再開する手順が記載されています。チームが決めるのは、明日どの状態が必要で、何を割り当てたままにする必要があるかです。
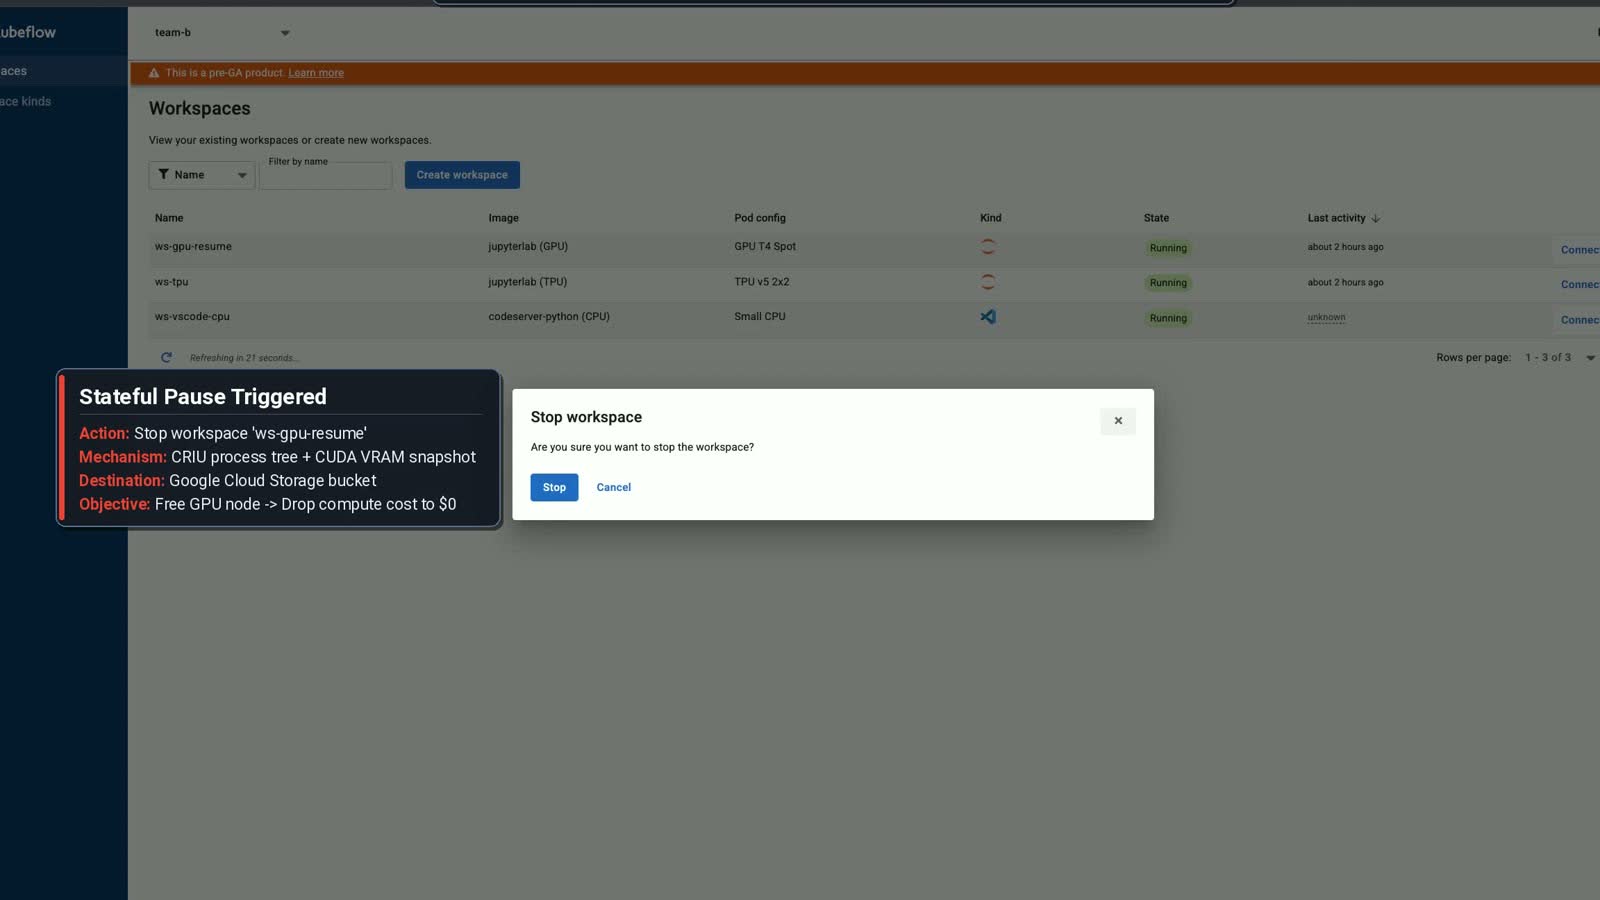
GKE Workspacesの再開可能なノートブックのデモから切り出した静止画、Apache 2.0。画像の出典 · ライセンス。
ノートブックのファイルと実行中のセッションで残るものは違う
GPUノートブックを一時停止する流れ。Telli.sh制作。
ノートブックを保存すると、書いたセルと保存済みの出力が残ります。ディスクに置いたデータセットとチェックポイントは、新しいプロセスでも使えます。いずれも実行中のセッションの状態を自動で丸ごと保存するわけではありません。実験には初期化済みの変数、アクセラレーターに載ったモデル、作り直しに時間のかかる中間状態が含まれることがあります。
GoogleはGKE Pod Snapshotsを使って、対応するワークスペースの実行状態を残しながら計算リソースを解放する方法を説明しています。ワークスペースのファイルは永続ストレージに残ります。再開には互換性のあるリソースとスナップショットが必要です。保存済みファイルを開くというより実験を続ける操作ですが、基盤環境の制約があります。
| 層 | 例 | 計画時の確認事項 |
|---|---|---|
| 永続ファイル | ノートブック、キャッシュした重み、成果、依存関係 | 新しく起動してもファイルは残るか |
| アプリケーションのチェックポイント | 学習のチェックポイントや保存済みの実行状態 | 元のプロセスなしでジョブを再開できるか |
| ワークスペースのスナップショット | 実行中のプロセスや対応するアクセラレーター状態 | このハードウェアと環境で復元できるか |
| クラスター容量 | ノード、アクセラレーターのクォータや予約 | 計算リソースは実際に解放され、後で使えるか |
再現性と利便性は、作業の別々の部分を改善します。すぐにセッションへ戻りたい人にはスナップショットが便利です。再現可能なノートブックとアプリケーションのチェックポイントがあれば、他の人が作業をやり直したり別環境に移したりしやすくなります。重要な実験では両方を残します。
研究チームは会議の間にGPUセッションを止めつつ、コードをコミットし、モデルの成果物を長期保存先に置けます。後でスナップショットを復元できなくても代替手段が残ります。長時間の学習ジョブも、開始に使ったワークスペースが一時停止に対応していても、定期的にチェックポイントを保存できます。
停止したワークスペースにも費用は残る
実際の費用を追う。Telli.sh制作。
直接の経済的な利点は、誰も作業していない間に計算リソースを使わずに済むことです。実際の請求は、セッション停止後にクラスターがどう動くかで決まります。他のPodが使うためノードが稼働し続けることもあります。予約の費用や契約が残る場合もあり、永続ディスクと保存済みスナップショットもシステムに残ります。
仮の例を考えます。研究者がほかに使っていないアクセラレーターを退勤後12時間割り当てたままにするなら、一時停止でプラットフォームがその12時間分を解放できる可能性があります。これは容量を別の用途に回せる機会です。金額の変化は、ノードとアクセラレーターの調達方法と課金方法によって決まります。別のジョブのためにノードが必要なら、すぐの請求額よりスケジューリングが改善するかもしれません。
公平に比べるには時間も見ます。スナップショットの保存にリソースがかかり、大きな状態の復元には時間がかかり、希望のアクセラレーターがすぐに得られないこともあります。使用率の高いクラスターでは、すでに容量プールの利用を約束していても、別の人にデバイスを回せることに意味があります。
実作業が終わった時刻、ワークスペースが止まった時刻、ノードが利用可能になった時刻を記録します。その後、再開した利用者が次のセルを実行できる時刻を測ります。翌朝に長い待ち時間を作らず、意味のある容量を返せるかが見えてきます。
ワークスペースの運用条件は引き続き基盤チームが決める
セルフサービスが変えるのは、誰がボタンを押すかです。起動できるイメージ、要求できるアクセラレーター、クォータと隔離をどう扱うかは引き続き管理者が決めます。GKE Workspacesのリポジトリには、Apache 2.0のコードでありGoogle公式サポート対象の製品ではないと記載されています。チームへの採用を検討するなら、導入と運用は自分たちの技術的な責任です。
機械学習エンジニアは使い慣れたIDE、十分なメモリ、実験データへのアクセスを求めるかもしれません。基盤担当者は既定のID、ストレージの権限、ワークロードの停止方法、どのイメージを更新できるかも考えます。ワークスペースの種類ごとに条件がわかれば、両方の要件を満たせます。小型のCPUノートブックとGPU実験セッションでは、出発点となる設定を変えられます。
発表ではアクセラレーターの選択肢や、ローカルツールまたはエージェントとの接続も説明しています。互いに置き換えられると考える前に、クラスターと用途に合う手順を確認します。ハードウェア固有の復元、クラスター間アクセス、ローカルの開発環境との接続には、それぞれ前提があります。担当者がワークスペースを調べ、動かしているクラスターを確かめられる簡単な例から始めます。
一時停止と復旧を一度試す
- プロジェクトのデプロイガイドと、利用するGKE環境のスナップショットおよびアクセラレーターの要件を読みます。想定する作業に合う権限とリソース制限で試験用ワークスペースを用意します。
- 再現可能なノートブックを起動します。入力、中間のアプリケーションチェックポイント、小さな結果ファイルを保存します。一時停止の前に時刻とリソースの割り当てを記録します。
- ワークスペースを一時停止し、クラスターのリソースを確認します。Podが止まったか、アクセラレーターを別の作業に割り当てられるか、何のストレージが残ったかを調べます。
- ワークスペースを再開します。期待したファイルと実行状態を確認し、読み込み済みのモデルを使うセルを一つ動かします。再開を依頼してからノートブックが使えるまでの時間を測ります。
- 保存したファイルとアプリケーションのチェックポイントから同じ復旧を試します。スナップショットの復元が遅い場合や不可能な場合に、代替手段と比較材料が得られます。
- チームでアイドル時の設定を見直します。何を未使用とみなすか、長時間ジョブに別のワークスペースや明示的な扱いが必要かを決めます。
クォータが小さいときや、クラスターが混雑しているときも復元を試します。空いているクラスターのきれいなデモでは、複数の利用者が一斉に戻ったときの容量確保の難しさが見えません。試行の目的は、リソースが希少なときの振る舞いを知ることです。
GPUの時間がどこに消えるかを計算する
開発者のワークステーションを一週間に40時間使うとします。一週間ずっと割り当てたマシンには、168時間が経過します。作業停止のたびにGPUノードを解放し、その40時間だけ再確保できるなら、保存や復元の負荷を数える前に、128時間はノードを割り当てなくて済みます。特定のクラウド料金や利用の仕方を仮定しない例です。共有ノードでは同じ時間帯に別の有用な仕事ができるため、この割り当て方における上限を示します。
チームのGPUプールの基準値があれば、もっと現実に近い比較ができます。試行の各区間について、ノード時間、別ジョブの使用有無、保存したワークスペースのデータ量を記録します。再開を依頼してから次のセルを動かせるまでの時間も残します。別のワークロードが動いてノードが残る場合、一時停止したノートブックがその処理に容量を譲っても、請求額は下がらないことがあります。これも別の有用な成果です。
スナップショットの時間も計算に入れます。古いPodを割り当てたまま一時停止に長くかかるなら、短いアイドルしきい値を設定すると、計算リソースの節約が少ないまま中断が増えます。オートスケーラーが互換GPUを確保するまで数分かかれば、短い休憩から戻った開発者の待ち時間が節約分を上回るかもしれません。毎回止める価値があると決めずに、複数のアイドル時間で測ります。
一時停止を有効にする前に残す状態を選ぶ
GKE Workspacesのリポジトリは、状態を保持しないVS Codeの手順と、状態を保持するJupyterLabの別の例を載せています。後者はGPU付きノートブックの復元を示しており、T4一基で3BのQwen2.5を使う例もあります。KubernetesのPodスナップショットとサンプルには互換性の条件があります。GoogleのGKE資料では、GKE Sandboxと互換性のあるノード、イメージ設定の役割を説明しています。GPUの例では、復元を当てにする前に、新しいノードに同じ対応GPUモデルと互換環境があるか確認します。
利用者が一時停止ボタンに何を期待するかを決めます。ファイル、出力、エディターの状態が必要な人もいれば、次のPythonセルからRAM上のオブジェクトやVRAM上のモデルを参照したい人もいます。共有データセットは外部のオブジェクトストレージにあり、スナップショットに含まれない場合もあります。選んだワークスペースが復元できる状態、通常のファイルの保存先、復元できないときの対処を記録します。
再開前に問題が起きる試験も役立ちます。テスト用の名前空間で一時的に互換リソースが使えないようにし、復元を重複して起こさず、ワークスペースが明確な状態を返すかを確認します。メモリ上のプロセスを再開できないとき、所有者がファイルや保存済み出力から復旧できることを確かめます。その後、テストのスナップショットを削除し、ストレージや保持規則が想定通りかを見ます。
費用と復旧の結果をチームへ戻す
研究者は作業を再開したいと考えます。基盤チームは貴重なGPU容量をプールに戻したいと考えます。費用担当者は実際に割り当てがなくなるのかを知りたいと考えます。アイドル時間、ノード配置、スナップショットの大きさ、再開成功、復旧時間を別々に記録すれば、一つの試行で三つの問いを扱えます。失敗時の案内も加え、ワークスペースが停止中、容量待ち、利用可能のいずれかを利用者が判断できるようにします。
その基準をもとに、ワークロードの種類ごとにアイドル方針を選びます。読み込みに時間のかかるモデルを使う長いノートブックセッションなら、交代時にメモリを残す価値があるかもしれません。保存済みスクリプトから始まる短い実験なら、永続ファイルと新規起動だけで足りる場合があります。同じプールを共有しながら、復旧時間は別の前提にできます。
リリースのチェックリストに再開テストを入れる
基盤のアップグレードでは、ワークスペース起動用イメージやGPUを提供するノードプールが変わることがあります。チームに適用する前に旧構成でテスト用ノートブックを作り、新構成で何が起きるかを確かめます。復元の成功と、同じファイルを開いただけの新規セッションを区別します。実行中のテストプロセスにだけ存在する値を読み、使っていたファイルも残っているか確かめます。
アップグレードで古いスナップショットが無効になるなら、重要な出力を保存する機会を利用者に用意し、代替手順を説明します。期限切れのスナップショットの削除は別に検証します。復元試験からは特定のワークスペースが戻るかわかり、削除試験からは利用を終えた後に古い状態がどれだけ残るかわかります。
作り直すのが難しい部分を残す
マシンのライフサイクルを意識し続けなくても作業を取り戻せると、ワークスペースはより便利です。そのために、ファイル、チェックポイント、スナップショット、容量を別の課題として扱います。無理なく再開するための最小限の状態を選び、元のセッションなしでもプロジェクトを再現できるようにします。
ディスクに残るもの、復元するもの、計算リソースが戻る時刻を説明できれば、チームは実際に使ってもらえるアイドル方針を決められます。
出典
仕事の背景となる会話や判断を検索できる記録にするには、Telli.shのアカウントを作成してください。