余ったDDR4でAIサーバーのメモリに余裕を作れるか
NetlistとMarvellがSC26でDDR4を使うCXL拡張構成を予告しました。ホストメモリを増やすと何に役立ち、購入前に何を測るべきかを考えます。
社内検索サービスは、朝のリクエストが集中するまでは快適です。GPUに回答の生成を依頼する前に、何千もの文書から関連箇所を探します。よく使う箇所はメモリに収まりますが、それ以外の文書を何度も検索するたびにストレージまで読みにいきます。アクセラレーターに余裕があっても利用者は長く待ちます。サービスを運用するチームには、GPUの追加よりサーバーのキャッシュを増やすほうが効果的な場合があります。
SC26に先立つ二つの予告は、そのキャッシュを構成する新しい選択肢を示しています。CXL Consortiumは11月10日、メモリを手がけるNetlistがNVvault-D4という概念実証を展示する予定だと発表しました。既存のDDR4をCompute Express Link(CXL)経由でホストメモリの拡張に使う設計です。11月13日には半導体メーカーのMarvellが、Structera Xメモリ拡張コントローラーとDDR4またはDDR5を使ったパートナー展示を発表しました。両社の発表は展示予定のハードウェアに関するものです。価格、納期、予定した実演の結果はまだ示されていません。SC26はシカゴで11月15日から20日まで開催され、通常の展示期間は現地時間の11月17日から19日です。CXL ConsortiumによるNetlistの予告 · MarvellのSC26発表 · SC26の公式日程
購入するチームが確かめたいのは、応答の遅いリクエストを許容範囲に保ちながら、実際の作業データを十分にメモリへ載せられるかです。手元に余ったDDR4があるチームでは、モジュールが適合し、適切なデータをそこに置ければ、コストを抑えられる可能性があります。効果は、現状でどの処理がどこで待たされているかによって変わります。
追加したメモリはどこにつながるのか
CPUはメモリコントローラーを通じて、直接つながったDRAMにアクセスできます。対応するサーバーとCXLメモリ拡張装置があれば、CPUはCXLリンク経由で、その装置の先にあるメモリにもアクセスできます。ホスト側にデータの格納先が増える仕組みです。経路、帯域、遅延はローカルDRAMのチャネルとは異なります。ファームウェアとOSが拡張容量を利用できるようにし、アプリケーションまたはOSでワークロードに合ったページ配置方針を設定する必要があります。
余ったDDR4を新しいサーバーで活用する際には、この経路の違いが重要です。サーバーはローカルのDDR5を残したまま、対応する拡張装置に接続したDDR4にアクセスできます。装置のコントローラー、モジュールの適合性確認、ホストの互換性は引き続き必要です。既存のDDR4を使う概念実証は、再利用を調べるきっかけになります。どのモジュールを受け入れる構成が正式にサポートされ、どのシステムで安定して使えるかは今後の確認事項です。
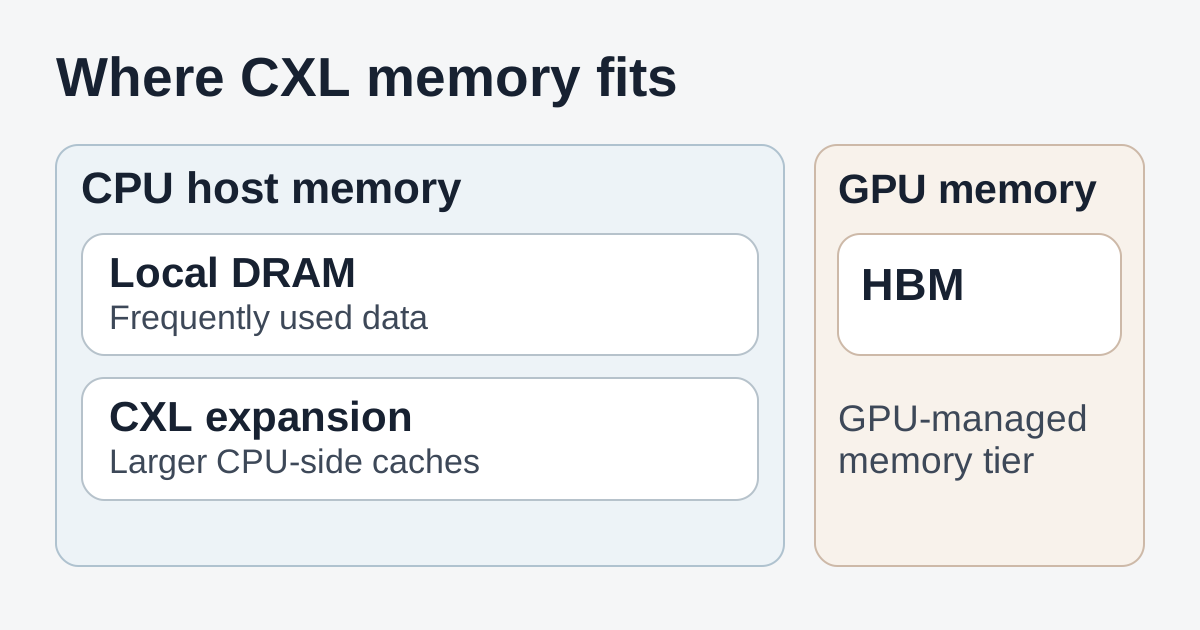
アクセスの多いページはローカルDRAMに置き、大きなCPU側キャッシュは拡張層に置けます。アクセラレーターの広帯域メモリには固有の容量と帯域の上限があります。
検索サービスなら、よく読むインデックスをローカルDDR5に置き、アクセス頻度の低い文書の抜粋や検索結果を、大きなCXLキャッシュへ移す構成を考えられます。関連する箇所が見つかると、推論バックエンドがGPU上のモデルに渡します。モデルの重みとアクセラレーターのカーネルが使うデータは、推論エンジンがアクセスするメモリに引き続き収める必要があります。今回発表されたCXL拡張層が扱うのはホスト側の容量です。GPUの広帯域メモリ(HBM)は独立した資源です。
まず、リクエストがどの工程で時間を使っているかを記録します。CPUがキャッシュから追い出されたデータを何度も待っているなら、ホストメモリを増やすことでストレージへのアクセスを減らせる可能性があります。モデルが処理時間の大半をGPUメモリからの重みの読み込みに費やし、ホスト側の待ち時間がほとんどなければ、同じ投資が応答時間に与える効果は小さいかもしれません。モデル自体の速度が変わらなくても、データの検索が速くなれば全体には効果があります。サービス全体の変化を説明するには、二つの工程を別々に計測します。
Netlistの3つの試作機はそれぞれ用途が違う
DDR4の再利用で注目するNetlist製品はNVvault-D4です。CXL Consortiumは仮想マシン、インメモリデータベース、ハイパフォーマンスコンピューティング、企業向けのワークロードを対象として挙げています。仮想化ホストでは、負荷の高いゲストをローカルメモリに置き、活動の少ないゲストのページを拡張層に配置できるか試せます。データベースなら、読み取りキャッシュの一部から同じ考え方を試せます。遅延に敏感なクエリのページをCPUの近くに置く割り当て方針が必要です。いずれも容量拡張の構成で試せる例です。展示の予告には、ワークロードごとの結果は載っていません。CXL ConsortiumによるNetlistの予告
残り2つのNetlistの設計を見ると、名称を区別する必要が分かります。NVvault-HMはNANDを使う容量の手前にDRAMキャッシュを置き、発表ではデータ移動とテレメトリ、AIのキー・バリューキャッシュや分析などの用途に触れています。NVvault-PMは別のCXL Type 3設計で、DRAM、NANDバックアップ、電源断に対応する内蔵電源を備えると説明されています。予告では、キー・バリューキャッシュの保持、チェックポイント、復旧などの用途を想定しています。バックアップやデータの永続化を評価するなら、自分たちが想定する障害時に該当する設計がどう動くか、詳細が必要です。D4の発表から、これら2製品のストレージや復旧機能をD4にも当てはめることはできません。CXL ConsortiumによるNetlistの予告
別のAIの試験例として、言語モデルのキー・バリューキャッシュを考えます。このキャッシュは、モデルが再利用できるように前のトークンのアテンションデータを保存します。ホストへのオフロードに対応した推論エンジンでは、非アクティブなセッションのキャッシュページをGPUメモリの外へ移し、セッションの再開時に読み戻すことができます。ホストの容量を増やすと何セッションを保持できるか、再開時に転送でどれだけ時間が増えるかを計測できます。ページの配置やコピーは推論エンジンとサーバーに依存します。ホストメモリを階層化した構成で試せる例です。今回のNetlistの予告でキー・バリューキャッシュ向けと明記されているのはHMとPMです。
Marvellの発表は、購入を検討するチームにもう一つの構成を示しています。パートナー各社はStructera Xコントローラー製品群とDDR4またはDDR5を組み合わせたシステムを展示する予定です。プログラムとメディアキットで展示や製品群の背景を確認できます。各供給元が検証したサーバー構成と使用できるメモリ、システム全体のサポート体制は確認が必要です。メディアキットのチップ画像は製品群を紹介する参考素材です。CXL ConsortiumのSC26展示プログラム · MarvellのSC26発表 · Marvell Structeraのメディアキット
応答の遅いリクエストから測る
平均応答時間だけでは、アプリケーションを重く感じさせる処理が隠れます。検索サービスでは人気の文書は一日中すぐにキャッシュで見つかっても、頻度の低い文書の検索は同じワーカーを何度も拡張層に向かわせます。最も遅いリクエストの時間が少し伸びても、夜間のインデックス作成なら許容できるかもしれません。検索結果を待つ利用者はすぐに気付きます。メモリの構成は、ピーク負荷で実際のサービス目標を満たす必要があります。
2025年の独立研究MELODYは、この点を具体的に調べました。研究チームは実際のCXLメモリ装置4台、CPUプラットフォーム5種類、遅延レベル7種類を使い、265のワークロードを評価しました。1マイクロ秒未満の140〜410ナノ秒の範囲で影響を調べ、ワークロード、テールレイテンシー、CPUの挙動によって、システムがCXLメモリを扱う際の結果が変わることを示しました。論文では検証した拡張装置をCXL-AからCXL-Dと表記しています。この結果からSC26で発表予定のシステムの性能は推定できません。一つの平均遅延や条件の良いベンチマークだけでは、対象とするサーバーの性能を判断できないことが分かります。ASPLOS 2025のMELODY研究 · 論文全文
プラットフォームが許すなら、三つの構成を比較します。まず既存のローカルDRAMで現在のサービスを再現し、次にホストを階層化して容量を増やします。最後に、合計容量が同じローカルDRAMだけの構成を比較対象にします。仮の容量設定として、ローカルDRAM 256 GiBと使用可能な拡張メモリ256 GiBを組み合わせた構成を、ローカルDRAM 512 GiBの構成と比べます。アプリケーション、データセット、ソフトウェア設定、投入する負荷をそろえ、構成によって変更が不可避だったプラットフォームやローカルチャネルの違いは記録します。運用上の代替案がストレージへの退避や別ホストへの分散であれば、その時間とコストも比較します。
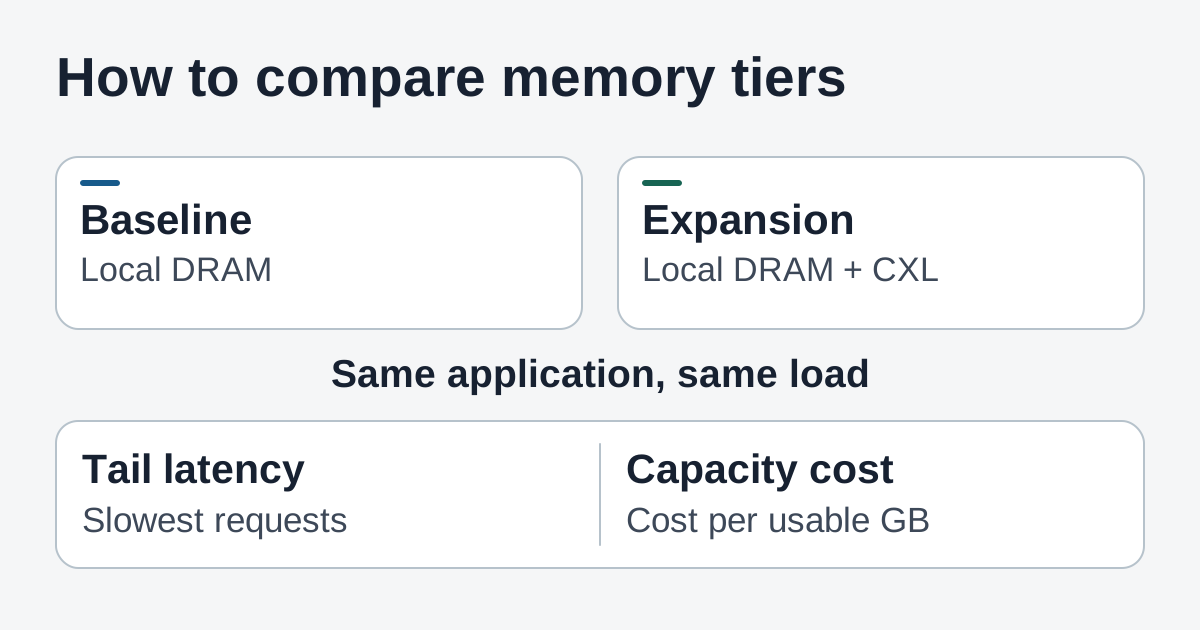
両方の構成で同じワークロードと通信量を使います。最も遅いリクエストを見て、実際に使える容量当たりのコストを計算します。
- キャッシュが埋まる通信を再現する。 よく使う文書とほとんど使わない文書を含む、実際に近いリクエストを用意します。起動直後とキャッシュが埋まった状態の両方で実行します。同じ同時実行数でリクエスト遅延の中央値、p95、p99、エラー率、スループットを確認します。AI検索では検索時間と推論時間を別々に記録し、キャッシュの高速化でモデルの処理低下が隠れたり、その逆が起きたりしないようにします。
- 実際にどのデータが移動したか確かめる。 メモリの階層とCPUのNUMAノード別の割り当てを見ます。取得できる場合はページの移行と回収、リンクや装置のカウンターも確認します。良い結果に見えても、ほぼすべてのリクエストがローカルDRAMに収まっていた可能性があります。悪い結果では、よく読むインデックスページが初期設定で遠い階層に置かれたかもしれません。測定値と一緒に配置方針を記録します。
- 負荷が重なる午後を再現する。 対話型の処理が混んでいるときに別のジョブを動かし、再起動後にキャッシュが埋まるまでの動きや、メモリの上限に近づいたときの挙動を観察します。OSによる装置やメモリのエラー報告、担当者によるホストの特定、以前の割り当て方針へサービスを戻す手順を確認します。チームが運用する構成なら、復旧まで試験に入れます。
- グラフを見る前に合格基準を決める。 現在のp99とエラー率の目標を出発点にします。その目標で追加容量をどれだけ使う必要があるか、どの事例なら遅い復旧を許容できるかを書き出します。高いキャッシュヒット率を前提に目標を満たす構成なら、とくに忙しい日の記録を使い、本番でもそのヒット率を維持できるか確かめます。
再利用にかかる費用をすべて数える
既存のDIMMを使えば、提案書のメモリ費用は低く見えます。導入には拡張装置、対応ホストまたはアップグレード、適合を確認したモジュール、展開とサポートを担う人員が必要です。装置に適したスロットやプラットフォームの接続部も必要です。予定したPCIeレーンの割り当てを、ストレージやネットワーク、アクセラレーターの利用と照合します。同じ作業がデータを運ぶために使う資源を削ってしまうと、メモリ増強の利点は小さくなります。
目標のサービス水準で使えるGiB当たりのコストを計算します。プラットフォームが予約する容量や、十分なページをローカルに残すために使えなくした容量も考慮します。電力と冷却、複数台の導入検証、予備部品、使用期間中のサポートも含めます。ファームウェアの更新を誰が提供し、稼働状態やメモリのエラーをどう確認できるかを調べます。拡張層により、これまでストレージへ退避したり別のマシンを増やしたりする必要があった作業を1台で扱えるなら、削減できた作業を測り、両方式の追加負担を計算します。ピークのリクエスト数で二つの構成を動かし、応答時間の目標を保つコストを比べると具体的になります。
SC26以降に確認したいのは、適合を確認済みの構成、文書化された対応モジュール、ソフトウェアの互換性、実際のワークロードの記録です。製品が提供されれば、頻繁に使うデータ以外にも大きな作業データを抱えるチームに、既存サーバーを拡張する手段が増えます。文書データをホストに多く置き、繰り返しのストレージ読み取りを減らしながら、従来のp99をより低い費用で維持できるサービスが、その有力な実例です。こうした結果が得られれば、次のサーバーの購入時に同じ判断基準を使えます。
出典
- CXL ConsortiumによるNetlistのSC26展示予告、2026年11月10日
- MarvellのSC26パートナー展示と接続技術の発表、2026年11月13日
- CXL ConsortiumのSC26展示プログラムとイベント画像
- Marvell Structera製品群のプレスキット
- SC26の公式プログラムと展示日程
- ASPLOS 2025のMELODY論文と掲載情報 · 論文全文
試験メモ、ワークロードの記録、購入の判断を一つにまとめるには、Telli.shのアカウントを作成してください。