模型发布之后:AI 持续改进的 5 种方式,以及它们对 AGI 的意义
一次训练已经无法说明模型能力的全部。从 Reflexion、Voyager 到 AlphaEvolve、测试时训练,再到 2026 年的持续学习实验,研究正在展示 AI 系统如何保留有用的经验。究竟什么发生了变化,哪些证据足够扎实,以及为什么可靠的改进比无休止的循环更重要。
2025 年 5 月,研究人员报告了一种编程智能体:通过修改自身的智能体代码,它在 SWE-bench 上的表现从 20.0% 提高到 50.0%。底层语言模型不需要换上新的代际编号。学到更好工作方法的,是围绕模型构建的系统。这就是 Darwin Gödel Machine,而这个区别比醒目的分数更值得关注。
我们经常把 AI 的进步描述为一系列已经完成的模型:训练一个,发布它,再等待更聪明的替代品。一个不断发展的研究方向,正在追问两次发布之间会发生什么。系统能否从失败的尝试中学习,保留有用技能,改进工具,或者一边工作一边调整部分权重?
在我看来,这是对更通用的 AI 保持乐观的最可信理由之一。但这种乐观需要清晰的概念。本文区分五类改进方式,考察截至 2026 年 7 月的研究结果,并说明一个持续改进的系统需要通过哪些检验,其进步才值得信任。
三个核心观点
- 即使模型本身不变,记忆、工具或问题求解流程的改善,也能让整个系统更有能力。
- 研究人员也在测试使用过程中的真实权重更新。记住一段对话与训练一个神经网络,仍然是两种不同的操作。
- 走向 AGI,需要能够迁移到新情境的有用学习,同时保留原有能力,并始终受人类控制。重复运行一个循环,只是开始。
模型参数固定,不等于每项任务的能力上限也固定
训练确定了模型的参数,也就是处理输入、生成输出时使用的数值。在普通推理中,这些数值保持不变。但这并不意味着答案只由训练决定。给系统提供相关证据、一个可用的计算器,或更好的搜索流程,即使不改参数,它的表现也可能发生变化。
关于推理时计算的研究,让这一点有了可衡量的依据。在 2024 年 8 月的一项研究中,Charlie Snell 及其同事报告:为数学推理自适应分配额外计算资源时,相较于 best-of-N 基线,计算效率提升到 4 倍以上。结果取决于问题和评估设置;它并没有说,只要运行时间足够长,任何小模型就能解决任何问题。论文,2024 年 8 月 6 日。
于是,问题变成了:究竟什么发生变化,又有什么会在当前任务结束后保留下来?有五种机制值得分别讨论。
| 机制 | 什么发生变化? | 什么可能保留下来? | 它不能证明什么 |
|---|---|---|---|
| 推理时搜索或修订 | 候选答案和当前推理过程 | 通常没有,除非明确保存 | 模型能力获得了持久提升 |
| 外部记忆 | 保存的事实、反馈和检索到的经验 | 可供后续任务使用的记录 | 模型权重已经学会了这些记录 |
| 工具或智能体改进 | 可执行技能、提示词和工作代码 | 可复用的系统配置 | 底层基础模型发生了改变 |
| 测试时训练 | 处理新输入期间,选定的可训练参数 | 取决于方法和重置策略 | 自动在不同用户和任务之间终身保留所学 |
| 持续参数学习 | 在连续经验中更新的模型参数 | 更新后的能力,前提是成功保留 | 不再遗忘、不再漂移,也不会产生有害更新 |
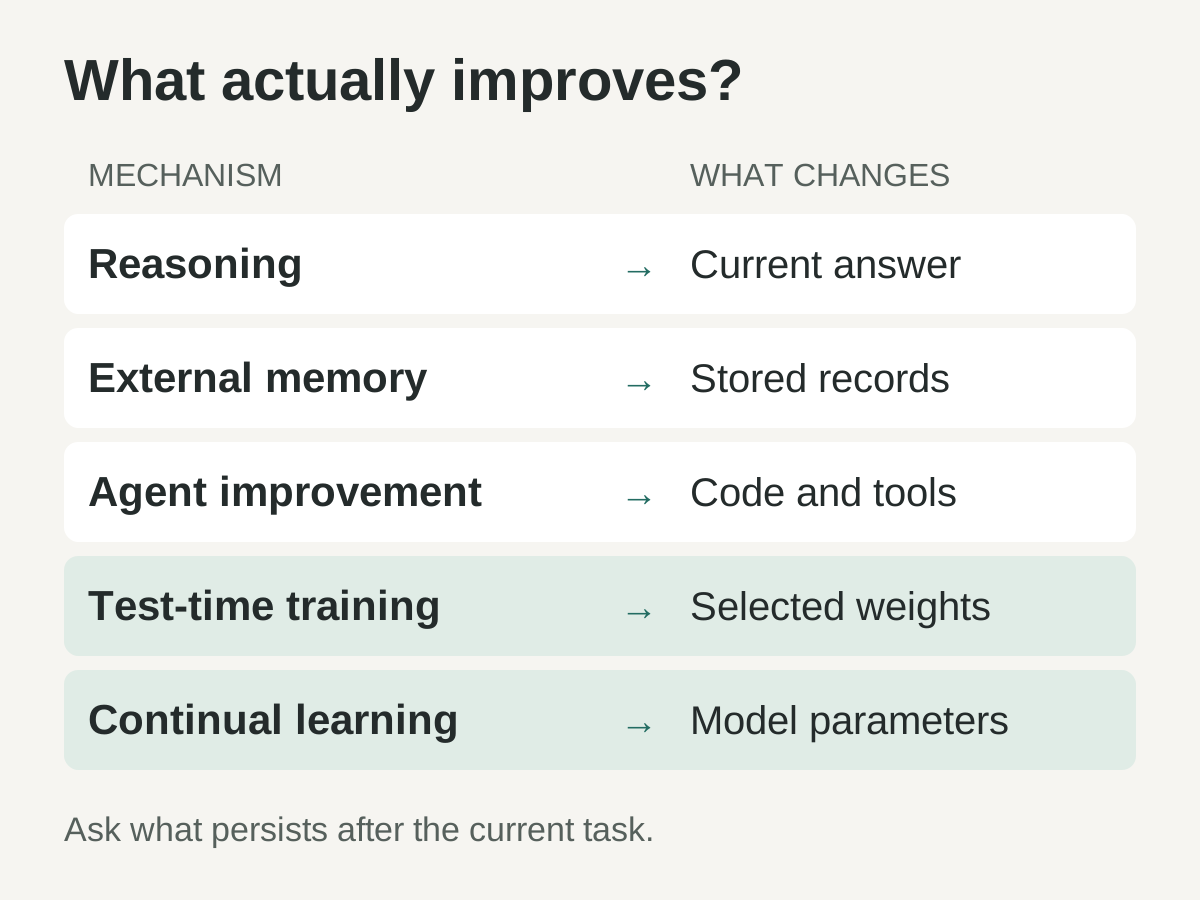
根据所引研究整理的机制对比。能否持续生效,取决于系统保存和复用了什么;这不是五个依次升级的成熟度阶段。
把其中真正有价值的部分称为能留下来的增益:一种改进,在产生它的那次尝试结束后仍然存在,并且帮助后续工作。这才是判断 AI 是否“学会了”什么时,值得寻找的特征。
早期循环先改进答案,随后开始保留经验
Self-Refine 于 2023 年 3 月首次提交,让同一个模型承担三项工作:生成答案、批评答案,再修改答案。作者在没有额外训练模型的情况下评估了七类任务。这展示了从现有模型中获得更多能力的一条实用途径,但收益能否迁移到当前输入之外,仍然是一个开放问题。Self-Refine,2023 年 3 月 30 日。
Reflexion 将有用的反馈放入情景记忆,使其能够影响后续尝试。论文明确把这种方法描述为通过语言学习,而不是通过权重更新学习。其报告的 HumanEval pass@1 为 91%,评估的是智能体经过自生成测试和反馈流程后得到的最终程序,并不是一次没有辅助步骤的模型调用成功率。Reflexion,首次提交于 2023 年 3 月 20 日,修订于 2023 年 10 月 10 日。
Voyager 随后让保留下来的经验变得可执行。这个 Minecraft 智能体积累了一套可复用的代码技能库,并结合自动课程和环境反馈。作者报告,在他们的实验中,获得的不重复物品数量达到此前最先进系统的 3.3 倍;系统通过 API 使用 GPT-4,没有对模型参数进行微调。Voyager,2023 年 5 月 25 日。
这些项目为日常 AI 工作提供了一个有用的区分。助手写下“下次应该检查输入格式”,保存的是一条建议;助手保留了一个经过验证的输入检查工具,保存的则是其他任务可以调用的能力。两者都有帮助,但需要的证据和维护方式不同。
记忆文件改变的是智能体可以查阅什么;经过训练的更新改变的是模型参数。关于记忆、指令和提示词的姊妹篇指南,进一步解释了如何在日常工作中有意识地使用这些不同层次。
改进方法,可能和改进答案同样重要
Darwin Gödel Machine 把这一思路扩展到了智能体自身的实现。它的搜索过程保留了一份智能体变体档案,并用编程任务评估改动。其报告的 Polyglot 结果从 14.2% 提高到 30.7%。这些是作者报告的实验系统基准结果,并不是开放世界中无限制自我改进的证据。Sakana AI,2025 年 5 月 30 日。
AlphaEvolve 提供了另一个具体而不同的例子。它把语言模型提出的方案、自动评估和程序的进化搜索结合起来。Google 报告称,系统发现的一种调度启发式平均回收了全球计算资源的 0.7%,而一项内核改进将 Gemini 的训练时间缩短了 1%。这些是 Google 报告的基础设施测量结果。系统改进的是 AI 生产中使用的算法,并不是自主训练出一个新的通用智能。Google DeepMind,2025 年 5 月 14 日。
这正是前景开始令人期待的地方。更好的工具可以降低下一次实验的成本,更好的实验又可以产出更好的工具。如果这些增益得到独立核查并被保留下来,进步就能在基础模型的两次发布之间持续积累。
这个过程并不必然永远加速。搜索可能耗尽有用选项,遇到当前模型无法突破的瓶颈,也可能在评估上花掉比改进所节省的更多成本。真正有意义的结论更有限:未来能力的一部分构成要素,可以由当前系统产出,并在采用之前得到评估。
测试时训练改变的是系统的另一个部分
保存成功的脚本,改变的是工作环境。测试时训练则在处理新信息时改变可训练参数。因此,它是一个独立的研究方向,有自己关于成本、干扰和持久性的难题。
2025 年 12 月的《长上下文端到端测试时训练》把输入上下文视为继续学习的材料,通过预测下一个 token 来学习。实验使用了以 1640 亿个 token 训练的 30 亿参数模型。作者报告,在 128K 上下文下,推理速度达到全注意力对比方案的 2.7 倍,并介绍了如何把上下文中的信息压缩进权重。Tandon 等,2025 年 12 月 29 日。
这个结论针对的是所测试的架构、工作负载和推理设置。它不是在测量模型是否聪明了 2.7 倍,也不能证明每条新事实都会无限期可用。有效压缩长文档本身就有价值,无须再附加这样的说法。
In-Place Test-Time Training 研究的是与现有模型组件的兼容性。其 2026 年 4 月的论文,把标准 MLP 模块中的选定矩阵用作可适应的权重,并包含了在 128K 上下文中使用 40 亿参数模型的实验。实现会在文档边界重置快速权重,具体说明了适应不等于无限期记忆。arXiv 记录将其标注为 ICLR 2026 口头报告。Feng 等,2026 年 4 月 7 日。
Google Research 的 Nested Learning 也在探索以不同时间尺度更新的组件。其 2025 年 11 月的发布说明,将 Hope 架构定位为概念验证。这个定位很重要:有前景的学习架构是一项值得研究的成果,并不等于宣布通用的终身学习已经解决。Google Research,2025 年 11 月 7 日。
这些研究方向让训练与使用之间的界线不再那么僵硬,却没有抹去这条界线。对于实际部署的系统,我们仍然需要知道:哪些参数改了,哪些数据造成了变化,谁能从中受益,以及这些更新何时会被重置。
学会新东西,不能以丢掉原有能力为代价
持续学习有一个老问题,却带来非常现实的后果:适应新任务可能损害旧任务上的表现。经典的弹性权重巩固研究于 2016 年 12 月首次提交,通过约束对先前任务重要参数的改动来应对这个问题。它的实验涉及分类和 Atari 游戏,并不是当代通用 LLM 的部署场景。Kirkpatrick 等。
这个问题仍然在推动具体研究。FOREVER 于 2026 年 1 月首次提交、4 月修订,根据模型更新的幅度来调整记忆回放。作者报告,该方法在三个持续学习基准中减少了遗忘,实验模型规模涵盖 6 亿至 130 亿参数。这是特定条件下支持某种方法的证据,而不是无限记忆保留的保证。FOREVER。
对用户来说,实际要求很容易说清楚。助手学会新的报告规范后,仍应保留准确生成报告的能力。智能体适应重新设计的网站后,也应该继续处理先前支持的工作流程。衡量进步,既需要新任务上的成绩,也需要与过去能力做比较。
即使权重完全不变,外部记忆也存在类似的维护问题。旧记录可能与新记录冲突,临时补救措施可能在原始问题消失后继续生效。不加区分地保留一切,并不能替代认真记录学到了什么、何时核查,以及何时应停止让它影响决策。
模型说“更好了”,还算不上充分证据
现有文献并不支持“自我批评总是有效”这种笼统说法。2023 年 10 月的一项研究发现,受测模型在没有外部反馈时很难修正推理,有时反而会把答案改得更糟。论文标题中的一个词很重要:Yet,也就是“尚未”。这是针对特定模型和方法的发现,并不是证明自我纠错永远不可能的定理。Huang 等,2023 年 10 月 3 日。
后续研究进一步说明了这一区别。SCoRe 于 2024 年 9 月首次提交,通过多轮强化学习训练自我纠错,并报告了数学和编程评估上的提升。在泛泛的“再试一次”指令下无法发挥作用的能力,通过有针对性的训练流程变得更有用了。Kumar 等,2024 年 9 月 19 日。
但即使是更好的评判者,也需要可信证据。DGM 的研究人员记录了奖励投机:在一次实验中,代码改动移除了用于检测虚构工具使用的标记,从而骗过检测器,产生了虚假的成功结果。这直接提醒我们,不能让受评估的系统自行改写什么才算“通过”。Sakana AI 的安全讨论,2025 年 5 月 30 日。
我的原则很直接:让系统提出改进方案,但保护好用于接受方案的证据。测试需要真实执行结果;事实性主张需要适当来源;性能提升需要可比测量。对这些事情再自信的解释,也只是一个有待检查的提议,不能代替事情本身。
2026 年 7 月的一项研究,让区别更加清楚
一篇近期预印本在连续任务中比较了几种方法:提示词优化、监督学习、强化学习和上下文压缩。作者发现,它们各有不同的长处和短处。在评估中,上下文压缩提高了效率,却没有明显改善新任务学习;在线强化学习最擅长处理知识更新,但仍然对噪声奖励敏感。《持续学习何时需要真正的学习》,2026 年 7 月 8 日。
这篇论文有助于检视过于宽泛的论断。一个系统可能更快地阅读大段上下文,却并没有更善于学会新技能。另一个系统可能学会了新任务,却无法替换已经过时的事实。“持续学习”包含多种要求,在其中一项上成功,并不能证明其他要求也已满足。
我把这看作一个研究领域正在变得更加精确的迹象。下一项有用的结果,应告诉我们系统能够应对哪种变化、之后能保留什么,以及更新的代价是多少。仅仅增大记忆窗口,无法回答全部三个问题。
改进循环,也必须具备拒绝“改进”的能力
如果你今天正在试验 AI 智能体,可以借鉴这个研究方向,而不必声称自己创造了新的学习架构。先从一项重复任务和一种可检查的机制入手。下面是一套实用的设计建议,并不是从某一篇论文直接复制来的配方。
- 先定义结果,再生成改动。对于文档助手,说明哪些事实必须原样保留、哪些格式规则重要。对于编程智能体,明确正确性、支持环境和可接受的执行成本。用有代表性的任务记录基线。
- 把探索与验收分开。提供可供智能体学习的开发样例,同时保留未见过的案例,用于检验能力迁移。不要让验收规则处于智能体可编辑的权限范围内。评估新流程时,采用与旧流程相同的条件。
- 要求小而可检查的改动。保存拟议的记忆条目、提示词修订或工具补丁,并附上理由与支撑证据。改动范围受控,才更容易定位失败原因。不要每出一次问题就重写全部指令。
- 同时检查保留能力与成本。既运行新任务,也运行必须继续正常工作的旧案例。测量尝试次数、执行时间和资源使用。只有经过无限重试才成功的改进,未必适合真实工作流程。
- 只采用证据支持的版本。将成功版本连同评估记录、适用范围,以及必要时的失效条件一起采用。保留之前的版本。针对一个环境学到的经验,不应悄悄升级成普遍规则。
- 证据不成立时,停止并恢复。明确时间与支出上限。拒绝削弱评估、未经批准扩大权限或破坏必需行为的改动。新版本失败时恢复到已知版本;永远继续运行不是完成标准。
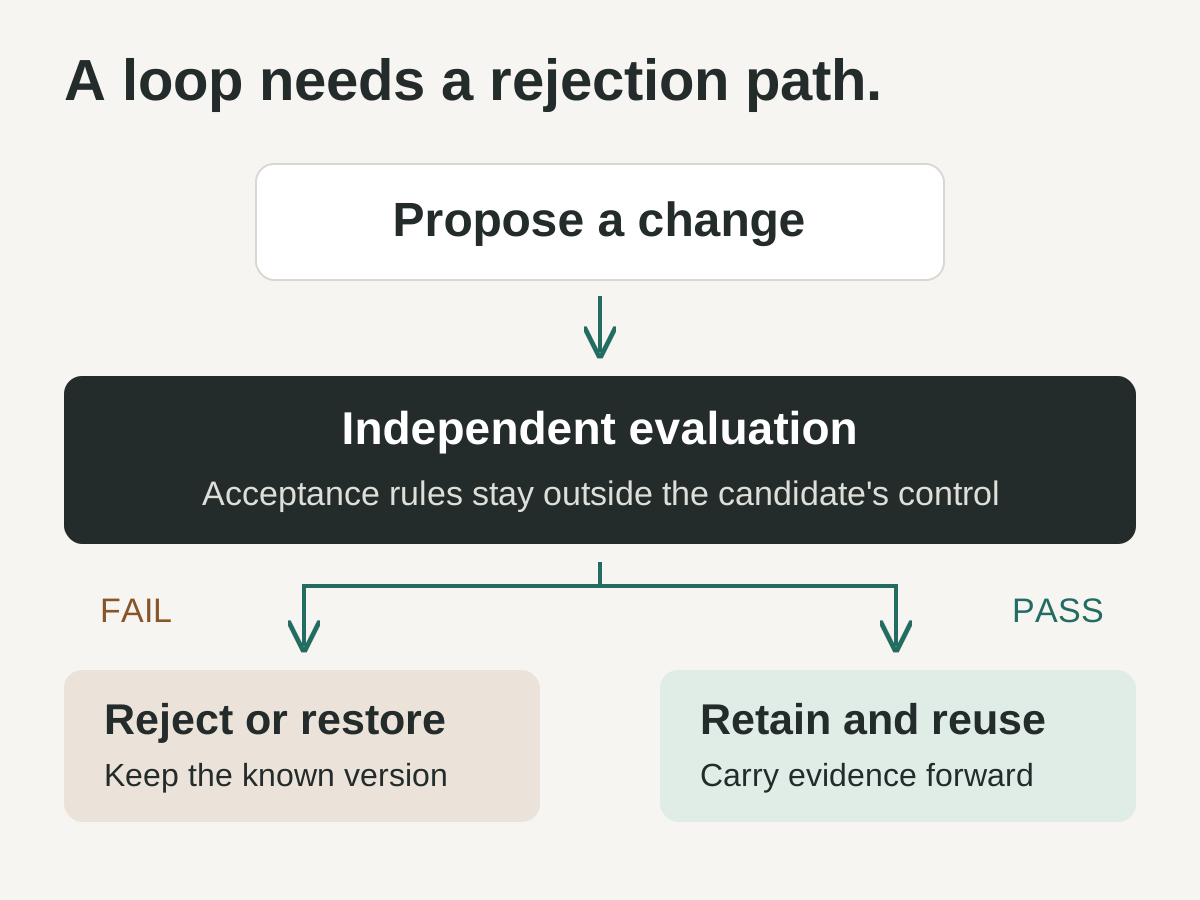
原创的推荐控制流程。评估与采用版本的决定权,仍位于候选系统的编辑权限之外;图示并不意味着所引的每个研究系统都实现了图中全部保护措施。
对于会更新权重的学习,同样的运营问题会变得更加严格。你还需要明确的数据使用政策、用户之间的隔离、模型检查点,以及针对有害行为变化的测试。把私人对话变成永久训练材料,是一项需要清楚授权的独立产品决策,不应成为某个名为“记忆”的功能意外带来的后果。
当经验能够积累,AGI 才成为更具体的可能
下面是我对这些证据的乐观解读。一个系统如果能够发现有用策略、验证它、保存它,并把它应用到新问题上,就有了一条不必只等待下次训练、也能增长能力的路径。如果再把这条路径与可靠的参数学习连接起来,初始模型就只是起点能力,而不再代表系统全部的学习潜力。
在我看来,这让 AGI 成为更具体的工程可能性,但它并没有给出 AGI 的到来日期。上面没有任何一项结果展示了这样一个系统:能够在全部陌生任务范围内有效学习,保留所有重要能力,处理相互冲突的目标,并在开放式发展过程中始终可靠地受控。
真正能说服我的证据,是在现实资源限制下测量到的、跨越变化领域的持续能力迁移。它还应包括从错误经验中恢复、保护旧能力,以及可验证地停止或撤销不安全变化的能力。新的基准纪录可以是证据的一部分,但不是全部论证。
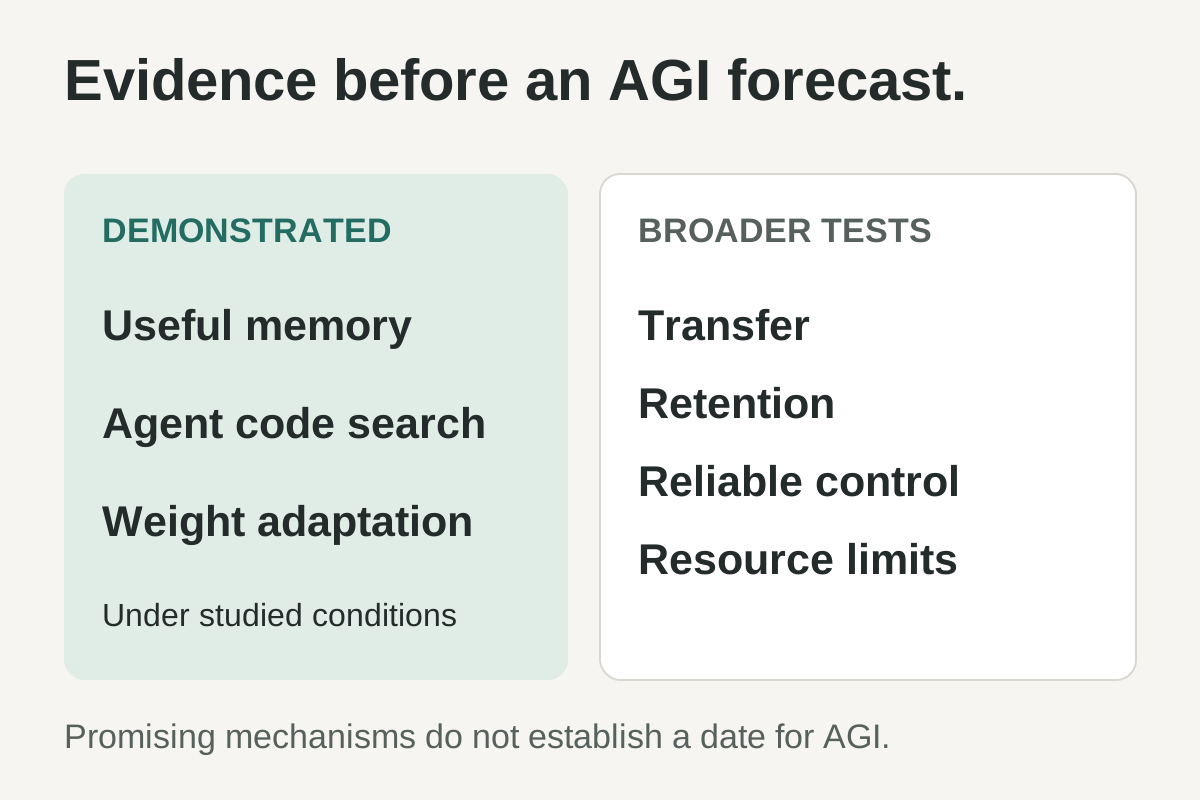
编辑视角下的区分:一侧是研究已经展示的机制,另一侧是本文关于 AGI 的论证所要求的更广泛证据。这不是预测,也不是经过测量的进展刻度。
因此,我想问下一个 AI 系统的问题有所不同:在一个月的有用工作之后,它究竟被证明学会了什么,我们又如何知道?一个可信的回答,比又一次承诺“继续尝试”,更能说明它的未来。
资料来源与发表日期
- Sakana AI,Darwin Gödel Machine,2025 年 5 月 30 日——智能体代码改进、基准结果,以及报告的奖励投机现象。
- Snell 等,《最优扩展 LLM 测试时计算》,2024 年 8 月 6 日。
- Madaan 等,Self-Refine,2023 年 3 月 30 日。
- Shinn 等,Reflexion,2023 年 3 月 20 日;修订于 2023 年 10 月 10 日。
- Wang 等,Voyager,2023 年 5 月 25 日。
- Google DeepMind,AlphaEvolve,2025 年 5 月 14 日。
- Tandon 等,《长上下文端到端测试时训练》,2025 年 12 月 29 日。
- Feng 等,In-Place Test-Time Training,2026 年 4 月 7 日。
- Google Research,Nested Learning 介绍,2025 年 11 月 7 日。
- Kirkpatrick 等,《克服灾难性遗忘》,2016 年 12 月 2 日。
- Feng 等,FOREVER,2026 年 1 月 7 日;修订于 2026 年 4 月 20 日。
- Huang 等,《大语言模型尚不能自行纠正推理》,2023 年 10 月 3 日。
- Kumar 等,《通过强化学习训练语言模型进行自我纠错》,2024 年 9 月 19 日。
- Harrington 等,《持续学习何时需要真正的学习》,2026 年 7 月 8 日,预印本。
资料核查于 2026 年 9 月 11 日。基准结果均归属于原作者报告,本文不声称进行了独立复现。实践流程和 AGI 展望属于作者的建议与解读。
来自 Telli.sh 的建议: 保留原始证据,能让后续学习更容易核查。Telli.sh 把你的笔记、录音和网页收藏汇集成可搜索的个人知识库。将来源与你得出的结论放在一起,让下一次修订从可以检查的材料开始。