[AIアイデアノート 03] ColGrep-Agent:大きなモデルが読む前に、ローカルの案内役がコードを探す
LightOnのローカルコード検索エージェントを紹介。返される情報、開発支援AIとの連携、検索と修正を混同せずトークン削減を検証する方法を解説します。
AIアイデアノートは、新たに登場するAIモデルやツールの発想と、実用につながる可能性を探るシリーズです。
アップロードが早すぎる段階で完了扱いになる、という不具合報告が届きます。リポジトリには数百のファイル、複数の進捗処理、似た名前の状態フィールドがあります。AIが修正を提案する前に、完了を管理するコード探しだけで多くの時間を使うことがあります。
LightOnが2026年10月12日に発表したColGrep-Agentは、その検索段階をローカルで担当します。リポジトリを探索し、関連ファイルのパス、行範囲、コードを主担当の開発支援AIへ返します。大きなモデルに修正を考えてもらう前に、小さな専門家が道を探す、ローカルの案内役という発想です。LightOnの発表
この記事では構成要素、実用的な始め方、最初の比較で測るものを説明します。魅力は検索の負担を減らせることです。それが自分のリポジトリ、質問、ハードウェアでも成立するかが課題になります。
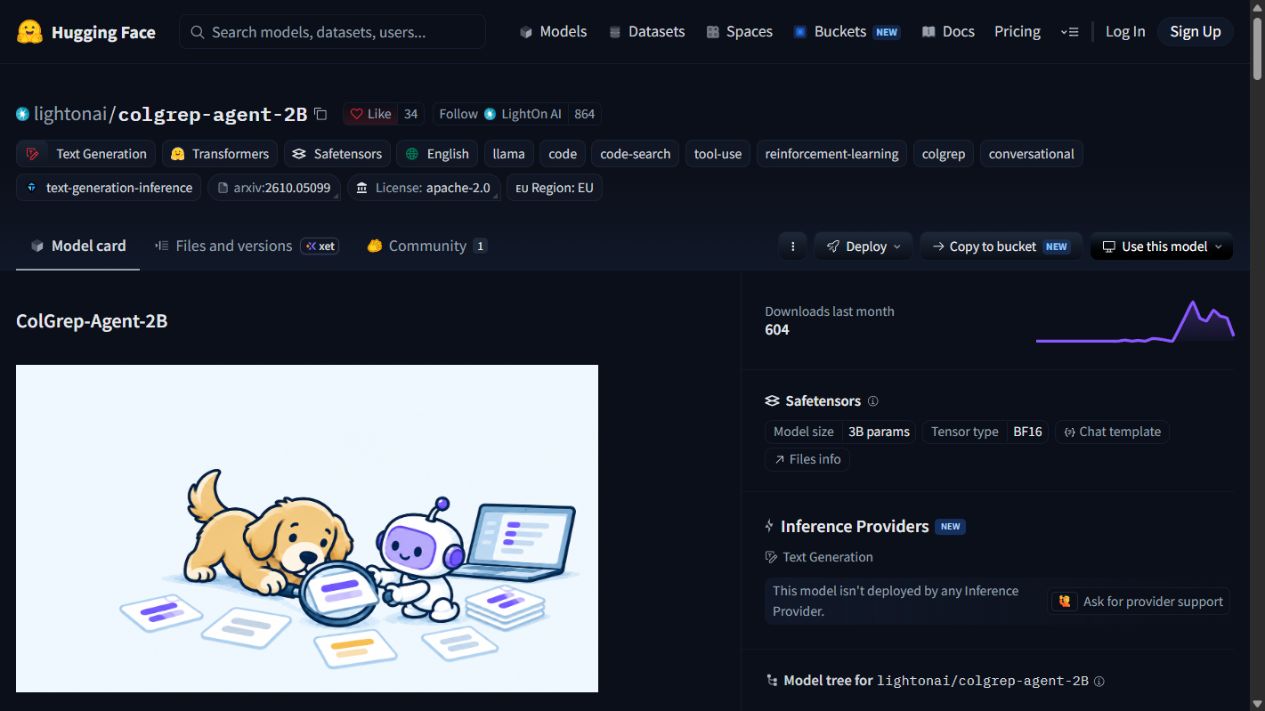 2026年10月20日に撮影した公開モデルページ。公開モデルカードの画面であり、私たちのマシンでモデルを実行した証拠ではありません。
3つの名前は、処理の3つの部品を指す
ColGrepは意味に基づく検索ツールです。ColGrep-Agent-2Bは公開モデルの名前です。colgrep --agentは、制約付きの検索実行環境でそのモデルを動かすコマンドです。別のモデル群ではなく、実際に使う組み合わせを表します。公式の説明
この区別は、追加する仕組みの規模を決める際に役立ちます。エージェントのループなしで、端末から意味検索だけを使いたい開発者もいます。別のチームは、開発支援AIがローカルエージェントへ質問し、小さく焦点の合った文脈を受け取る構成を望むでしょう。
検索システムは、意味に基づく質問と、パスやパターンなどの厳密な制約を組み合わせます。両者の役割は異なります。識別子が分からない処理は自然言語で探し、スタックトレースからコピーした関数名には完全一致検索が有効です。
入門者にとって重要な出力は、確認すべき場所の候補一覧です。コードを理解し、周辺の契約を調べ、振る舞いを変えた後にテストを実行する仕事は残ります。有用な場所は修正の材料であって、修正そのものではありません。
検索ループにも費用が積み上がる
開発支援AIは、語句を検索し、ファイルを開き、別の識別子に気付き、参照をたどり、再び検索する、といった手順を繰り返します。各段階で、後続のモデル呼び出しへ渡す文脈が増えます。保守担当者には分かりやすいリポジトリでも、初見のAIには探索コストがかかります。
ColGrep-Agentは、この探索をローカルのループへ移します。主担当AIが質問し、案内役が候補ファイルを検索・閲覧し、関連すると判断した場所を返します。ローカルモデルにあらゆる開発作業を解かせるのではなく、探索の担当を分ける考え方です。
たとえば、録音セッションが再接続後に復旧しない原因を調べるとします。「reconnect」の広い検索には、通信ヘルパー、画面通知、古いテストまで混ざります。有用な結果は、現在のセッション管理者と、接続を作り直す関数まで絞る必要があります。
そのため、短い返答が必ずよい検索とは限りません。最終保存を説明するファイルが省かれれば、主担当AIは自信があっても不完全な修正を作るかもしれません。必要な根拠を残しつつ、無関係な文脈を減らすことが目的です。
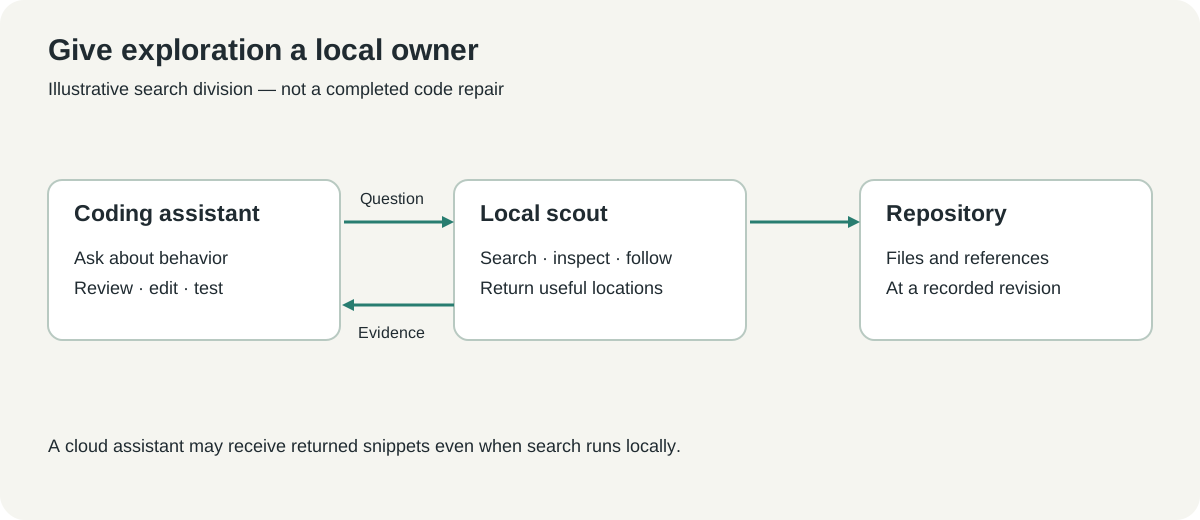 公開された役割分担を示す独自の解説図。質問と返される場所は例示です。
注目の数値は、コード検索に限った結果
LightOnは、13リポジトリの52件のコード検索質問を使い、grepとの比較でAPIトークン34%削減、キャッシュを考慮したAPI費用40%削減と報告しています。これはその比較に関する公開元の測定値です。アプリの開発・保守全体の費用が40%減ることまでは示していません。調査の説明
ソフトウェア作業には複数のコストがあるため、範囲が重要です。検索が減っても実装の推論は変わらないかもしれません。所要時間の大半がテストの場合もあります。クラウドのトークンを節約するモデルも、ローカルのCPU、GPU、メモリ、索引作成時間を使います。
正しいコードが見つかったか、開発作業が正しく完了したか、全体で何を消費したか、という3つを分けて考えましょう。測りやすい1つだけでは残りは分かりません。割合を万能な見通しとして使うより、自分の仕事に合う取捨選択が必要です。
同じ入力の繰り返しも価格比較を複雑にします。キャッシュ済み入力、未キャッシュ入力、生成出力の単価は異なる場合があります。ツールが情報を出すなら別々に記録し、使用量を取得してから、日付を明示した料金表を適用します。
確実に確認できるリポジトリから始める
公式の導入手順にはmacOS、Windows、ソースからのビルドが用意されています。クリーンな複製か、状態を把握したリポジトリから始め、インストーラー実行前にリリース手順を読みます。初めてのツールに未確認の本番作業環境を渡すところから始めないでください。ColGrep文書
macOSでHomebrewを使う場合、LightOnの発表は次の手順を示しています。
brew install lightonai/tap/colgrep
colgrep --install-agent
2つ目のコマンドは、ホスト型推論サービスへの登録ではなくローカルモデルの準備です。標準の量子化モデルは約2.5 GBのダウンロードと説明されています。これは文書上の転送サイズであり、すべての構成のメモリ・ディスク総量ではありません。モデルのセットアップ
Windowsでは公式リポジトリの最新のPowerShell手順に従い、実行前にインストーラーを確認してください。実行環境や高速化の経路はマシンによって違います。Macで成功したコマンドから、Windowsでも同じ設定、速度、リソース使用量になるとは判断できません。
最初は、実験を理解しやすくするために次の順で進めます。
- コミットと作業ツリーの状態を記録し、関連コードが分かっている質問を選びます。
- 公開手順で導入し、導入した版の
colgrep --helpと索引の説明を確認します。 - エージェント連携の前に通常の意味検索を試し、無視されるファイルや除外先が想定どおりか確かめます。
- その版のヘルプに示された呼び方で
colgrep --agentを試し、返された場所をすべて確認します。 - 単体検索が役立つと分かってから、対応する開発支援AIへ接続します。比較用に以前の検索設定も残します。
これはセットアップと評価の手順で、この記事のために実際に導入したという報告ではありません。入門記事の役割は、結果を作り上げずに最初の演習を選べるようにすることです。
ファイルを指定するより、振る舞いを質問する
よい検索質問は、起きた出来事と、探したい振る舞いを説明します。「受理済みのアップロードは、バックグラウンド処理後のどこで完了になるか」は、「アップロードのコードを探して」より具体的です。実際の担当を発見する余地を残しながら、探すべき契約を与えます。
質問に自分の修正案を埋め込まないようにします。特定フラグを設定すべき関数だけを尋ねると、その思い込みに沿って探し、本来状態を管理すべき構成要素を見落とすかもしれません。利用者が観測する現象から始め、説明する実装を確認しましょう。
練習には異なる探索経路を含む3問が役立ちます。要求の認証はどこか、バックグラウンド作業の最終結果をどこで保存するか、フロントエンドはどこで状態更新を購読するかです。1つの識別子ではなく、ファイルをまたいで責任をたどる例です。
厳密な文字列も有用です。スタックトレース、ルートのパス、エラーコードは質問を具体化します。観測された振る舞いと組み合わせ、検索が失敗中の処理から離れないようにしてください。
説明文より先に、返された場所を評価する
提案された行を開き、関数の役割が分かる程度の周辺コードを読みます。行番号が正しくても、ガード、呼び出し元、最終保存を省いた断片は誤解を招きます。もっともらしく見えるだけでなく、主張を確かめられる文脈が必要です。
ここでもコミットが重要です。便利だったパスと行範囲も、リファクタリングで古くなります。評価時と同じ版に検索結果を対応付け、ソースが変わったら文書の手順で索引を更新します。
| 検索結果 | 確認すること | 重要な理由 |
|---|---|---|
| 正しい担当と有用な周辺コード | 質問の振る舞いを実装しているか | 行動につながる結果か確認できる |
| 関連ヘルパーだけ | 呼び出し元や状態の管理者が欠けていないか | 本来の契約を壊したままの局所修正を防ぐ |
| 実装のないテストファイル | 現在の振る舞いか、古い期待か | 根拠と実装を結び付ける |
| 多数のもっともらしいファイル | 必須の文脈を失わず絞り込めるか | 確認の手間を減らせるか示す |
検索試験では、ツールの答えを見る前に保守担当者が期待するファイルを決めます。そうしないと、もっともらしい場所を受け入れ、成功の定義を変えがちです。曖昧な質問は別に扱い、すべての不具合に正解ファイルが1つあるように扱わないでください。
ローカルの費用も含む比較を作る
同じリポジトリの同じ版で、同じ質問を既存検索と新方式にかけます。通常の質問を十数件と、責任の所在が難しい質問を数件入れる程度から始められます。これは試験案であり、公式ベンチマークや統計的信頼性の保証ではありません。
既知の関連ファイルを含むか、無関係なコード量、クラウドのトークン、所要時間を記録します。索引作成も反復検索とは分けます。よく使うリポジトリなら初回準備の負担が妥当でも、一度だけの探索には割に合わないかもしれません。
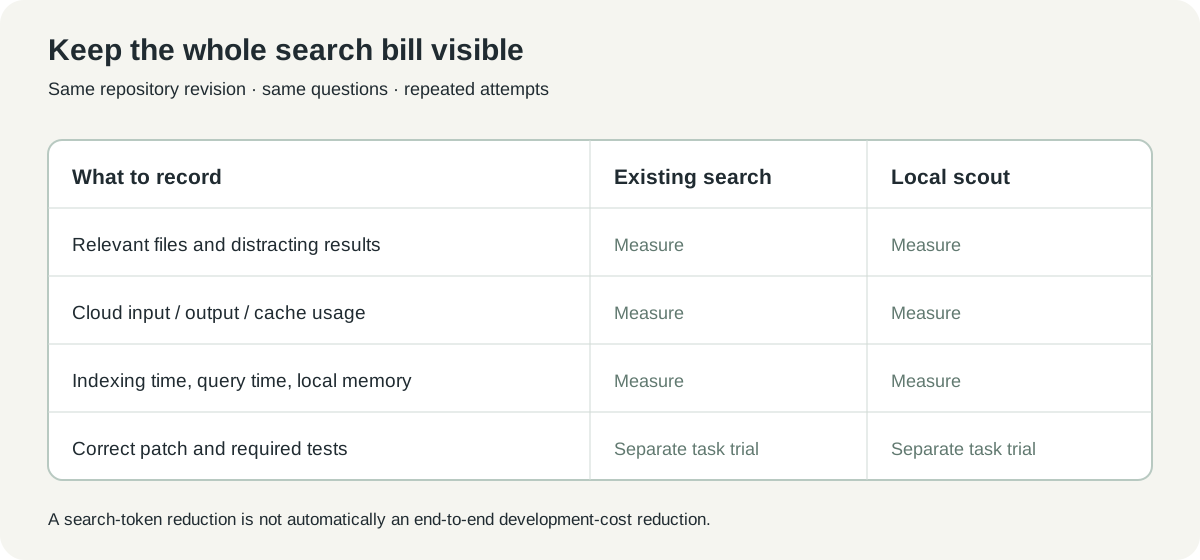 独自の評価表。測定欄が空なのは意図的です。取捨選択を判断する前に、自分の値を集めてください。
不具合修正全体も比較するなら、別の実験にします。同じ問題、リポジトリの状態、テスト基準、モデル構成を使い、完成した差分を確認します。検索に勝つツールも、探索、編集、テスト解釈、繰り返しの修正が必要な仕事では違う結果になる場合があります。
1回の幸運な結果を信じず、数問を繰り返してください。エージェントの探索経路は試行で変わります。通常のトークンは減るが難問は遅くなる、という結論もあり得ます。1つの集計値では表せない実際のトレードオフです。
ローカル検索でも、クラウドAIはオフラインにならない
LightOnは索引作成とエージェント推論をローカルで行うと説明しています。検索段階をマシン内に保てても、連携したクラウド開発支援AIには選ばれたコードが渡る場合があります。「ローカル検索」を「コードが外へ出ない」と同一視せず、質問から最終モデル呼び出しまでを確認します。構成の説明
除外対象も意識して確認してください。生成フォルダーはノイズとなり、認証情報や非公開の書き出しは、プロジェクト内にあるだけで検索対象にすべきではありません。ツールの無視設定と組織の通常の運用を使います。
読み取り専用検索は案内役に有用な境界ですが、その後の変更を承認するものではありません。主担当AIはリポジトリの指示を守り、現在の作業を保護し、修正を検証します。探索と権限は別の責任です。
チームでは連携文書に境界を明記しましょう。索引の場所、ローカルで動くモデル、外部へ渡る断片、連携を無効にする方法を共有します。担当が明確なら、導入者が離れた後も実験を理解できます。
一番の節約は、無関係な探索を減らすこと
私たちは、ColGrep-Agentは専門化の実用的な例だと考えます。ローカルの案内役が必要な根拠を確実に返せるなら、開発支援AIがすべてのディレクトリ探索に高価な推論を使う必要はありません。その「確実に」を試験で確かめる必要があります。
保守担当者が判断できる1つのリポジトリと1つの質問から始めます。必要な担当を隠さず、読む量を減らせるなら広げましょう。目標は検索費用を測りながら、正しい変更までの道を短くすることです。
出典と画像
2026年10月20日確認。性能値はLightOnによるコード検索の報告です。ローカル導入、レイテンシ測定、開発作業全体のベンチマークを実施したという主張はありません。公開画面は著者が撮影し、図は独自制作しました。出典・ライセンス表示はメディア記録にあります。
問題と根拠を結び付けて残す
元の報告、検索質問、関連コードのリンク、確認メモをまとめて保存しましょう。Telli.shは調査記録の整理に役立ちます。Telli.shアカウントを作成