Baseten joey-1、すべてのAI判断に大型モデルは必要か
20億パラメーターの意思決定モデルと、入力100万トークン当たり0.01ドルのAPI。不確かな仕事を大型モデルや人へ回す方法を、費用と運用の両面から解説します。
「この問い合わせはどのチームが担当するべきか」に、5段落の回答はめったに要りません。必要なのは、少数の正当な行き先からの選択、責任ある選択を支える確かさ、当てはまらない依頼で助けを求める経路です。
Basetenは、そのような仕事に向けて 2026年10月29日にjoey-1を発表 しました。研究部門のBase Labsが開発し、elephant-1とmammoth-1と並ぶ意思決定モデル群の小型側に位置します。魅力は出力の役割を絞ったことです。アプリが解釈する説明文ではなく、判断と確率を返します。Basetenの発表が製品を紹介しています。
実用上の機会は、仕事の分担を変えることにあります。明確で繰り返し発生する判断は小型モデルに任せ、不確かな残りに費用をかけます。本記事では、価格の計算、三つの用途例、振り分け戦略を有用にする確認事項を説明します。
 Baseten公式のjoey-1モデルカードのバナー。画像:Base Labs / Baseten。MITライセンスを掲げるモデルリポジトリに掲載。余白を付けてサイズを調整。画像の出典 · ライセンスと画像に関する注記。
意思決定モデルは、アプリが受け入れられる選択肢から始まる
汎用言語モデルは、「請求」と書いたり、JSONを返したり、返金が妥当な理由を説明したりして依頼を分類できます。各インターフェースには用途があります。専用の意思決定モデルは、与えられた答えの中から選び、確率を構造化して返すことに重点を置きます。
これにより、推論前の作業が変わります。正確な問いと、意味のある操作を表す選択肢が必要です。「何をするべきか」では契約が曖昧です。「請求、技術サポート、不正対策のどこが受け取るべきか」なら狭まりますが、複数に該当する依頼や、どれにも当てはまらない依頼のルールも必要です。
11月2日に確認したBasetenのjoey-1モデルライブラリは、テキストと画像の入力、選択式の問い、はい・いいえの判断、順序付きスコアを/v1/systemone経由で扱うと説明しています。結果はプログラムで使うためのものです。利用者が説明や回答文を必要とする場合、その生成機能を別途用意する必要があります。
小型モデルを仕分け窓口と考えてください。通常の仕事を正しい場所へ送り、特殊な事例は権限や背景情報をより多く持つ相手へ回すことに価値があります。難しい事例を自信満々に誤送する窓口は、推論が安くても、後続工程に隠れた仕事を作ります。
そのため、アプリは不確実性を残すべきです。暫定ラベルの記録、追加質問、人への引き渡しができます。すべての確率分布を直ちに業務操作へ変える必要はありません。
1セントで買うのは、一定件数の判断ではなく入力トークン
2026年11月2日に確認した公式料金は、 入力100万トークン当たり0.01ドル 、キャッシュ入力と出力は0.00ドルとしています。「1ペニー」はこのトークン単位のことです。長い履歴を含む依頼は、短く範囲を絞った依頼より入力処理量が増えます。
以下は、公開された入力単価を使った計算例で、税金、他サービス、商用契約条件は含みません。非キャッシュ入力と変わらない価格を仮定した計画用の例であり、請求額の見積もりではありません。
| 想定する処理量 | 入力トークン合計 | 100万トークン当たり0.01ドルでの入力料金 |
|---|---|---|
| 10万件 × 500トークン | 5,000万 | 0.50ドル |
| 100万件 × 500トークン | 5億 | 5.00ドル |
| 1,000万件 × 500トークン | 50億 | 50.00ドル |
| 100万件 × 2,000トークン | 20億 | 20.00ドル |
式は、入力トークン合計を100万で割り、0.01ドルを掛けるだけです。運用の計算はもっと広く、上位への引き渡し、データ準備、再試行、監視、手動訂正の費用も含めます。
二つの設定でモデル利用料が数ドル違うとします。一方はレビューを減らすものの、ときどき緊急の依頼を遅いキューへ送ります。もう一方は人へ回す件数が多く、その誤りを避けます。適切な選択は、最安のトークン請求額だけでなく、誤りの損失と確認担当者の処理能力で決まります。
推論が安くなるほど、この考え方は重要です。モデル利用料が全費用の小さな部分になれば、校正やラベル設計の小さな改善が、トークン単価の追加削減より意味を持つことがあります。安い推論は自動化できる範囲を広げますが、成果の価値を考える必要はなくしません。
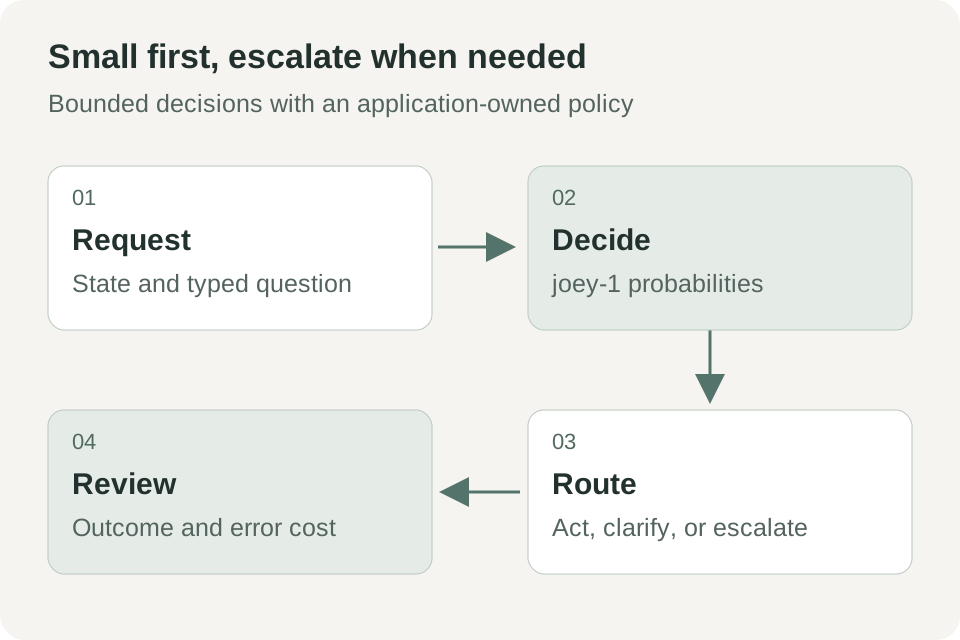 独自作成の振り分け図。Basetenの10月29日の発表にある上位への引き渡しの考え方を参考にしています。しきい値は導入するアプリ側が定めます。
問い合わせの振り分けは、ラベルの責任者が明確なら始めやすい
サポート業務の例では、joey-1がメッセージを請求、技術サポート、アカウント保護へ分類します。別の二値の問いで返金要求の有無を確認し、順序付きスコアで緊急度を判定します。
関連する問いですが、一つのラベルに押し込めるべきではありません。請求の依頼も緊急になり、アカウント保護の依頼にも返金要求が含まれます。判断を分ければ、各チームが受け取るものと、特別な処理が必要な組み合わせを定義しやすくなります。
キューの責任者とラベルを書き出すところから始めます。過去に判断が割れた例も含めます。ソフトウェアの不具合で支払いに失敗したというメッセージを、どう扱うか決めてください。組織が未定義のまま残した曖昧さを、モデルが解消することはできません。
導入時には、仕事を自動で移す前に、推奨結果と従来の判断を比較します。不一致を、ルールの曖昧さ、背景不足、明らかなモデル誤り、過去ラベルの誤りに分けて確認します。全体の正解率一つでは、これらの違いが隠れます。
Basetenの10月29日の発表は、joey-1を最初の判断を担うモデルとして位置付け、不確かな場合には上位モデルを使えると説明しています。平均 2,000トークンの依頼 について、同社の本番配信条件で エンドツーエンドのP50遅延20ミリ秒 と報告しています。特定のサービス負荷に関するベンダーの測定であり、自社アプリや機器の遅延保証ではありません。出典:Baseten。
文書の振り分けでは、適切な行き先がない場合を扱う
二つ目は文書の受け付けです。ファイルを請求書処理、経費確認、一般記録のどこへ回すかを決めます。提出する表現に必要な情報が含まれていれば、テキストと必要に応じた画像入力によって、複合的な文書にも適用できます。
実際の判断を狭く定義します。あるページが請求書らしいかを調べることと、その真正性、法的な充足性、支払い可能性を確認することは異なります。分類器は、支払いを承認する権限を得ることなく、進む手順を選ぶ手助けができます。
分類体系の外にある例が、最も価値のあるテストかもしれません。契約書に添付された領収書、読めないほどぼけた画像、未対応言語などです。正当な行き先を三つしか用意しないなら、根拠不足や未知の内容を扱う別の仕組みが必要です。無理な推測より、明示的なレビュー経路の方が運用しやすくなります。
入力集団の変化も追います。評価で短い国内請求書が中心だったモデルに、後から複数ページの明細やスキャンした書簡が届くかもしれません。最終ラベルだけの監視では変化を見逃します。適切なプライバシー水準で、依頼の長さ、入力種別、不確実性、レビュー結果を記録します。
11月2日に確認した公開モデルカードは、joey-1を Qwen3.5-2B から事後学習した 20億パラメーター(2B) のモデルとし、 MITライセンス を示しています。公開重みを使う導入の選択肢を支える事実です。ただし、一律の必要メモリ、CPU性能、発表内のあらゆる図の再利用許可を意味しません。
画像の確認は、観察できる条件を問うと役立つ
三つ目は、提出された商品写真を人によるカタログ確認の前に点検する例です。ラベルが見えるか、指定した物体が写るか、遮られすぎて判断できないか、といった問いが考えられます。各問いは、その画像から観察できるものを指定するべきです。
よくない基準は、観察できることと隠れた事実を混ぜます。「信頼できる販売者か」は商品写真だけでは答えられません。「指定されたシリアル番号の領域が見えるか」なら範囲が狭く、別画像を求める具体的な理由を後続工程に渡せます。
確認担当者が「利用不可・要確認・利用可」などの基準を共有している場合、順序付きスコアは有用です。人が一貫して適用できる言葉で条件を書きます。隣り合う段階を人でさえ区別できなければ、確率分布を返しても分類体系は直りません。
自動却下を認める前に、レビューの優先順位付けに使います。却下は顧客に直接影響し、誤った却下の損失は自動化の節約を上回る場合があります。レビューは、基準の改善や、入力条件による性能差の確認に使う例も生みます。
これらは設計の例であり、報告されたjoey-1の導入事例ではありません。共通するのは、範囲を限定した問いの後に、取り消し可能な次の処理を置くことです。自社データでの挙動を学ぶ、妥当な出発点になります。
確率を操作に変える前に、判断ルールが必要
確信度は許可フラグではありません。0.90を超えたら動く設計にするなら、その影響を測る必要があります。しきい値を決めたデータと依頼が異なるときは特に、高いスコアでも誤る場合があります。
誤りの種類によってルールを変えるべきです。通常の質問を違うチームへ送るのは不便ですが、アカウント乗っ取りの報告を通常扱いする損失ははるかに大きいかもしれません。同じ確率のしきい値を、両方へ自動で適用するべきではありません。
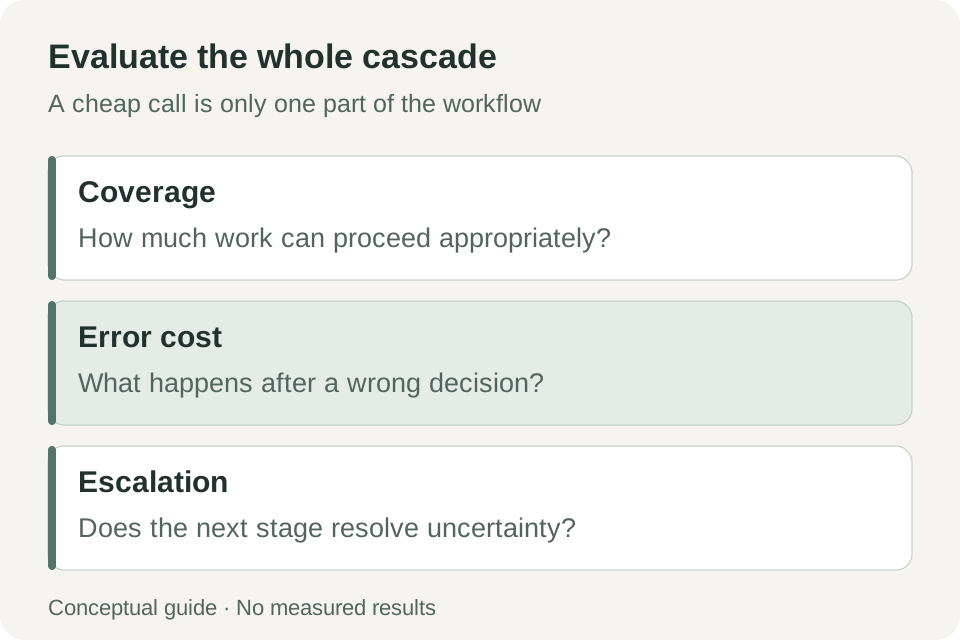 独自作成の評価枠組み。対象範囲、誤操作の損失、引き渡し品質はアプリ側の指標です。joey-1の実測結果は示していません。
代表的な通常例、難しい例、範囲外の入力からなる、調整に使わない評価セットを用意します。候補のしきい値ごとに、自動処理される割合と、その中の誤りを調べます。残りがどうなるかも確認します。ほぼすべてを上へ回して誤りを避けるモデルでは、業務が変わらないかもしれません。
一連の段階的処理全体を、大型モデル単独の場合と比べます。小型から始める設計には、独自の失敗と遅延を持つ振り分け段階が加わります。十分な依頼を最初の段階で適切に扱え、難しい残りを引き渡し先が改善するときに価値があります。
ホスト型APIから始めるか、自己ホストの費用を明示する
Basetenは、ホスト型Model APIs、専用配備、ダウンロード可能な重みを提供しています。コンテキストと配信条件は別々に確認する必要があります。発表はModel APIsで 16k 、専用配備で 262k の選択肢を説明する一方、モデルカードは 学習系列長16,384トークン を指定し、学習上限を超える依頼を拒否します。どの経路にも無差別に転記できる一つの最大値はありません。発表、モデルカード。
- 判断の契約を一つ選ぶ。 有効な選択肢と各意味、根拠が足りない場合のアプリの処理を定めます。
- 導入経路を選ぶ。 ホスト型の試験ではモデルのAPI入口から、提供元のアカウント画面で認証情報を作ります。ローカル配信ではモデルカードが固定した実行環境の要件に従います。
- 最小限の依頼を送る。 公式例は
https://inference.baseten.co/v1/systemoneに、state、型付きのquestions、モデル識別子decision-models/baseten-joey-2b-latestを使います。 - 構造化された応答を検証する。 不正な形式や利用不能の結果を拒否し、評価に必要な確率を残し、振り分けルールはアプリ内で管理します。
- 実処理を変えずに並行評価する。 自動操作を有効にする前に、推奨とレビュー済みの結果を比較します。
- 上位への引き渡しを追加して測る。 不確かな例や影響の大きい例を大型モデルや人へ送り、経路全体の成果を確認します。
モデルカードは、CUDA GPUと固定した配信環境を必要とする自己ホスト構成を説明しています。「2B」はモデル規模であり、どのノートPCにも十分なメモリがあるという約束ではありません。容量設計には、実行環境の追加負荷、画像処理、同時実行、コンテキスト長を含めます。
APIの試験なら、その基盤に投資する前に製品適合性を確かめられます。自己ホストは、制御、稼働率、運用負担、総費用についての別の判断です。公開重みは選択を可能にしますが、自動的に経済的にするわけではありません。
再評価用のデータで、モデルやプロンプトの変更から業務を守る
最初の試験が機能したら、レビュー済みの依頼を版管理して集めます。通常例、損失の大きい誤り、助けを求めることが正解の例を含めます。保存が許可されたデータを用い、期待する結果と一緒に、問いの文言と選択肢の説明を残します。
プロンプト、しきい値、配信構成を変える際は、処理量を広げる前に、その集合を再評価します。一つの分類の改善が、別の退行を隠すことがあります。例えば、断定的な振り分けでレビュー量は減っても、短く曖昧なメッセージの誤りが増えるかもしれません。全体平均だけでは、その引き換えを説明できません。
各評価に使った実際のモデル識別子と配信経路を記録します。変動するlatest識別子を追う配備では、挙動の変化に気付き、受け入れを見直す方法を定めます。アプリのスキーマが安定していても、判断が永遠に同じという保証にはなりません。
サービス障害も試します。タイムアウト、モデルの利用不能、不正な応答は、既定のチームを黙って選ぶのではなく、定義した復旧経路へ入れるべきです。既定値自体が業務判断であり、機微な依頼には不適切かもしれません。信頼できる小型モデルのシステムは、自信のある回答と同じくらい意図的に、回答を得られない場合も扱います。通常の依頼が1セントの何分の一で済んでも、この運用の規律は重要です。
小型モデルは、判断境界の品質を見えやすくする
本稿では、joey-1はアプリの選択肢が既に明確な場面で最も興味深いと考えます。安く速い判断は大量の仕事を動かせますが、分類体系が悪ければ、誤りを速く流すだけです。
価値のある問いは、既知の範囲内でどれだけ正しく扱え、残りをどれだけ適切に処理できるかです。価格の後の小さな注記ではなく、上位への引き渡しが製品の一部になっているとき、小型モデルの居場所が生まれます。
出典
- Baseten:1ペニーの判断、joey-1の紹介、2026年10月29日。
- Baseten joey-1モデルライブラリとAPI例、2026年11月2日確認。
- Base Labs joey-1モデルカード、2026年11月2日確認。ベンチマークは公開者の報告で、Artificial Analysisの項目は社内で再現した評価と明示されています。
検討の記録を、根拠となる資料と結び付けて残す
Telli.shは、利用を許可された資料と、技術判断の背景にあるメモを一緒に残すための選択肢です。ノート用ワークスペースを作成する。