Nikt nie powiedział „wrzesień”: dziewięciominutowa kontrola, której wymaga każde podsumowanie AI
Badania nad streszczaniem transkrypcji spotkań wykazały, że 30,4% streszczeń wygenerowanych z sesji rad miejskich zawierało co najmniej jeden błąd rzeczowy, a stoi za tym siedem nazwanych typów błędów. Praktyczny przewodnik po weryfikacji notatki napisanej przez AI względem jej własnej transkrypcji: co sprawdzać, w jakiej kolejności i co powiedzieć na spotkaniu, żeby kontrola zajęła dziewięć minut zamiast trzydziestu.
Streszczenie miało trzy akapity, było porządnie ułożone i błędne w dokładnie jednym zdaniu: zespół uzgodnił, że migracja zostanie wdrożona we wrześniu.
Nikt tego nie uzgodnił. Ktoś powiedział, że wrzesień jest prawdopodobnie realny, jeśli dostawca odpowie na czas — zdanie warunkowe, wypowiedziane raz, w środku dygresji o czymś innym. Model usunął warunek, awansował przypuszczenie do rangi decyzji, a notatka poszła do jedenastu osób, których nie było na spotkaniu. Dwie z nich zaczęły planować pod wrzesień.
Nie ma w tym nic egzotycznego. To jedno z najlepiej udokumentowanych zachowań automatycznych systemów streszczających, ma swoją nazwę w literaturze naukowej i nie zniknie dlatego, że kolejny model będzie większy. Ten tekst daje trzy rzeczy: siedem sposobów, w jakie streszczenie odchodzi od tego, co faktycznie padło, dziewięciominutową kontrolę, która wyłapuje wszystkie siedem, oraz kilka zdań wypowiadanych na spotkaniu, które tę kontrolę skracają.
W skrócie:
- W benchmarku TofuEval (NAACL 2024) 30,4% streszczeń wygenerowanych z rzeczywistych transkrypcji rad miejskich zawierało co najmniej jeden błąd rzeczowy; w tematach pobocznych — dygresjach — odsetek rósł do 43,6%.
- Błędy nie są losowym szumem. Badacze uporządkowali je w siedem nazwanych typów, a dwa najbardziej szkodliwe dla spotkań to przedstawianie opinii jako faktu i przesunięcia czasu i modalności — dokładnie tam, gdzie „moglibyśmy” staje się „zrobimy”.
- Sprawdzania nie da się też oddać modelowi: w FaithBench (październik 2024) najlepsze detektory halucynacji osiągnęły trafność około 50%, a w TofuEval oceniające modele językowe przegrały z mniejszymi, wyspecjalizowanymi metrykami.
Zdjęcie: Shixart1985, Wikimedia Commons, CC BY 2.0. Okulary są tu sednem. Ktoś i tak musi to przeczytać.
Rejestrowanie zostało rozwiązane. Weryfikacja nigdy się nie zaczęła.
Policz narzędzia do notatek ze spotkań pokazane na Hacker News przez ostatnie pół roku: od 1 marca do 13 sierpnia 2026 roku jest ich co najmniej piętnaście. Transkrypcja na urządzeniu, notatniki bez bota dołączającego do rozmowy, importery do Obsidiana, otwartoźródłowe klony Granoli. Każde wnosi te same dwie funkcje: nagrać dźwięk i wygenerować streszczenie.
Żadne nie wnosi trzeciego kroku — jedynego, w którym jest osąd. Streszczenie trafia do skrzynki już sformatowane, już pewne siebie, już rozesłane do całej sali. Ten przepływ w sposób niejawny twierdzi jedno: ten produkt jest gotowy.
I tu jest sedno: wygenerowane streszczenie nie jest zapisem spotkania. To wypowiedź o spotkaniu, wytworzona przez system, który nie odpowiada za swoją poprawność, i należy ją czytać jak każdą relację z drugiej ręki — zestawiając z dowodem, z którego powstała.
Ten dowód na szczęście leży obok. To samo narzędzie, które wyprodukowało streszczenie, wyprodukowało też transkrypcję, a porównanie jednego z drugim zajmuje mniej czasu niż runda przedstawiania się na początku spotkania.
Liczba, która powinna zmienić sposób czytania notatek
TofuEval, opublikowany przez badaczy Salesforce AI i współautorów na NAACL 2024, to najbliższe kontrolowanemu pomiarowi, co mamy w tej sprawie. Wzięli dwa korpusy dialogowe — jeden z wywiadów prasowych, drugi o nazwie MeetingBank, złożony z rzeczywistych transkrypcji posiedzeń amerykańskich rad miejskich — kazali pięciu modelom językowym napisać streszczenia tematyczne i zlecili zawodowym lingwistom oznaczenie każdego zdania pod kątem zgodności rzeczowej ze źródłem.
Na transkrypcjach spotkań, średnio dla pięciu modeli, 30,4% streszczeń dotyczących tematów głównych zawierało co najmniej jedną niezgodność rzeczową, a dla tematów pobocznych było to 43,6%. Artykuł mówi to wprost: poza GPT-3.5-Turbo „około 40–50% ich streszczeń zawiera co najmniej jedną niezgodność rzeczową”.
Uczciwe zastrzeżenie: te pięć modeli pochodzi z 2023 roku — Vicuna, trzy rozmiary WizardLM i GPT-3.5-Turbo — a dzisiejsze czołowe modele są wyraźnie lepsze pod względem wierności faktom. Dwa wnioski z tej samej pracy przetrwają jednak ten zarzut i to one dotyczą twojego wtorku.
Po pierwsze, skala nie rozwiązała problemu w sposób pewny. Na danych ze spotkań odsetek błędów WizardLM-30B był niższy od WizardLM-7B tylko o 3,8 punktu procentowego, mimo ponad czterokrotnie większego rozmiaru; w części porównań większy model z tej samej rodziny popełniał więcej błędów. Po drugie, liczba błędów nie miała istotnego związku z długością streszczenia (korelacja Pearsona ρ = 0,18). Dłuższe i bardziej szczegółowe streszczenie nie jest bezpieczniejsze. Czekanie na większy model nie jest procedurą kontroli.
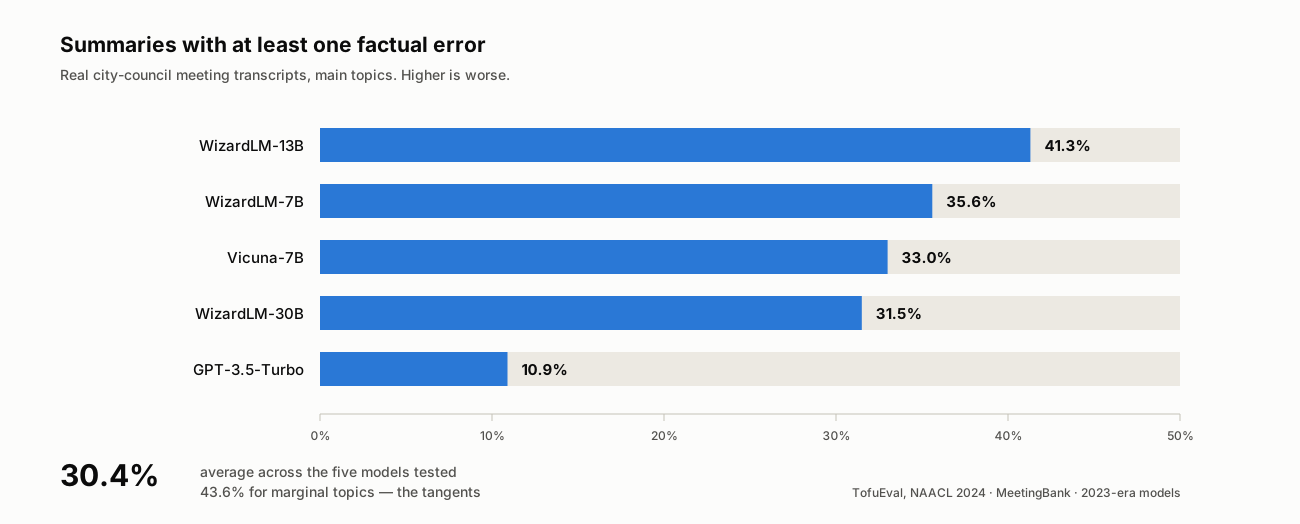
Udział streszczeń rzeczywistych transkrypcji rad miejskich zawierających co najmniej jeden błąd rzeczowy, tylko tematy główne. Źródło: TofuEval, Tang i in., NAACL 2024 (arXiv:2402.13249). Testowane modele pochodzą z 2023 roku; typy błędów poniżej je przetrwały.
Siedem sposobów, w jakie streszczenie odchodzi od sali
Najbardziej użyteczna w tej pracy nie jest liczba procentowa, lecz taksonomia: siedem nazwanych typów błędów, wyprowadzonych przez anotatorów z tysięcy oznaczonych zdań, jako rozszerzenie wcześniejszej klasyfikacji zbudowanej na krótkich dialogach.
Przeczytaj je raz, a zaczniesz je widzieć we własnych notatkach. To nie są przypadkowe usterki, lecz konkretne, powtarzalne ścieżki, na których kompresja mowy do prozy usuwa rozróżnienie, na którym opierała się sala.
| Typ błędu (TofuEval) | Jak wygląda w notatce | Jak go złapać |
|---|---|---|
| Informacja zewnętrzna | Szczegół obecny w streszczeniu i nieobecny w nagraniu — liczba, nazwa klienta, uzasadnienie, którego nikt nie podał | Wyszukaj tę nazwę własną lub liczbę w transkrypcji; brak wyniku oznacza, że została zmyślona |
| Błędne przypisanie | Właściwa decyzja przypisana niewłaściwej osobie albo sprzeciw jednej osoby zapisany na konto innej | Przeskocz do znacznika czasu i sprawdź, kto mówi |
| Opinia jako fakt | „Zmiana cennika zwiększy odejścia klientów”, gdy ktoś tylko obawiał się, że może zwiększyć | Poszukaj złagodzenia w oryginale: sądzi, obawia się, podejrzewa |
| Błąd wnioskowania | Pomyłka w rachunkach albo związek przyczynowy, którego sala nigdy nie postawiła | Przelicz każdą liczbę; sprawdź, czy to „ponieważ” padło, czy zostało wywnioskowane |
| Czas / aspekt / modalność | „Moglibyśmy wdrożyć we wrześniu” staje się „wdrożymy we wrześniu” | Zestaw każdy czasownik w czasie przyszłym z oryginalnym trybem |
| Sprzeczność | Zgubione przeczenie: „nie przesuwamy terminu” staje się „przesuwamy termin” | Szukaj nie, nigdy, chyba że w pobliżu danego stwierdzenia |
| Subtelne przesunięcie znaczenia | „sformułować rekomendację” przerobione na „zgłosić żądanie” | Porównaj czasownik ze streszczenia z czasownikiem ze źródła |
Trzy z nich najłatwiej rozpoznać na konkretnym okazie. Oto każdy z nich: transkrypcja i zdanie ze streszczenia obok siebie.
Zgubione przeczenie — błąd sprzeczności. Co padło na sali:
DANIEL (00:31:12): Czyli daty premiery nie przesuwamy. Cokolwiek innego
się zmieni, ta data stoi.
Co napisało streszczenie:
Zespół uzgodnił przesunięcie daty premiery.
Zniknęło jedno słowo i zdanie nakazuje teraz działanie odwrotne. Jest przy tym nienagannie poprawne gramatycznie — właśnie dlatego korekta się po nim prześlizguje, a wyszukanie „nie” w pobliżu decyzji znajduje je w cztery sekundy.
Błędne przypisanie — błąd odniesienia. Co padło na sali:
PRIYA (00:18:40): Ja jestem przeciw cennikowi za stanowisko. W zeszłym
kwartale dwóch klientów korporacyjnych mówiło nam, że to zabija deal.
MINA (00:18:55): Tak, zgadzam się.
Co napisało streszczenie:
Mina sprzeciwiła się cennikowi za stanowisko, powołując się na opinie
klientów korporacyjnych.
Każdy fakt w tym zdaniu jest w transkrypcji. Nie ma tylko właściwej osoby. Na tym polega cała trudność: nie wykryjesz tego, pytając, czy twierdzenia są prawdziwe — tylko pytając, czy należą do osoby, której je przypisano.
Awansowane przypuszczenie — błąd modalności. Co padło na sali:
SAM (00:44:02): Wrzesień jest prawdopodobnie realny, jeśli dostawca
odpowie nam na czas.
Co napisało streszczenie:
Zespół uzgodnił, że migracja zostanie wdrożona we wrześniu.
Usunięto dwa kwalifikatory — słowo „prawdopodobnie” oraz całe zdanie warunkowe — i wspólne przypuszczenie stało się zobowiązaniem z datą. Nikt nie musiał w tym celu kłamać. Zrobiła to kompresja.
Dwa z nich zasługują na szczególną uwagę, bo to one kosztują zespoły realne pieniądze.
Opinia jako fakt to dokładnie wrześniowy incydent z początku tego tekstu. Na spotkaniu większość zdań jest złagodzona — ludzie myślą na głos, a złagodzenie niesie cały sens. Modele streszczające usuwają złagodzenia z założenia, bo przy kompresji to pierwsza rzecz, którą się tnie. Efekt czyta się bardziej stanowczo, niż była sala, i właśnie dlatego nikt go nie kwestionuje.
Przesunięcia modalności robią to samo z datami. „Mogłoby”, „powinno”, „prawdopodobnie” i „jeśli dostawca się odezwie” to granica między planem a zobowiązaniem, a jednocześnie najtańsze słowa do wyrzucenia. Streszczenie, w którym zespół coś robi we wrześniu, po cichu wyprodukowało termin, za który nikt nie odpowiada.
Zauważ, co je łączy. Model nie wymyślił faktów z niczego — usunął kwalifikatory. To najmniej widoczna zmiana, jaką może wprowadzić, i taka, której żaden czytelnik nie wykryje bez źródła przed oczami.
Zmyśla na dygresjach
W danych jest jeszcze drugi wzorzec, który dokładnie pokrywa się z tym, jak przebiegają spotkania.
Streszczenia tematów pobocznych — rzeczy wspomnianych mimochodem, a nie omówionych szczegółowo — wypadały wyraźnie gorzej: 43,6% wobec 30,4% na korpusie spotkań. Badacze wyjaśniają mechanizm: gdy temat jest w źródle ledwie poruszony, modele „opierają się na własnej wiedzy, by wyciągać wnioski na jego temat, wprowadzając do streszczenia informacje bez pokrycia”. Miejsca o cienkim materiale dowodowym są dopychane wiedzą ogólną, a to dopchnięcie jest tonalnie nieodróżnialne od fragmentów faktycznie ugruntowanych.
Twoje spotkania są pełne tematów pobocznych: dwie minuty o przeglądzie bezpieczeństwa, dostawca wymieniony raz, liczba, którą ktoś pamiętał w połowie. Te linijki są najmniej omówione i najbardziej narażone na błąd — a czytają się równie płynnie jak reszta.
Warstwa niżej ma ten sam kształt. W pracy „Careless Whisper”, zaprezentowanej na ACM FAccT 2024, Koenecke i współpracownicy stwierdzili, że około 1% transkrypcji Whispera zawierało całe zmyślone frazy lub zdania, które nie istniały w żadnej postaci w nagraniu źródłowym, i że 38% tych halucynacji niosło wyraźne szkody: zmyślone powiązania, fałszywy autorytet, sfabrykowaną przemoc. Najciekawszy jest wyzwalacz: halucynacje występowały nieproporcjonalnie często u mówiących z dłuższymi odcinkami bez głosu.
Czyli w ciszy. A spotkanie składa się właśnie z ciszy: pauzy na myślenie, ktoś wyłącza wyciszenie, ładuje się udostępniany ekran, cztery sekundy po trudnym pytaniu. To dokładnie ten materiał, który model transkrypcji najchętniej wypełni czymś, co nigdy nie padło. Oznacza to również, że błędy transkrypcji i błędy streszczenia nie są niezależne: zmyślona linijka transkrypcji jest dla streszczenia idealnie ugruntowanym wejściem.
Nie da się oddać sprawdzania modelowi
Oczywisty pomysł to kazać drugiemu modelowi zweryfikować pierwszy. Pomiary nie napawają optymizmem.
W tym samym badaniu TofuEval autorzy ocenili modele językowe jako binarnych sędziów zgodności rzeczowej i stwierdzili, że wszystkie, łącznie z GPT-4, „słabo radzą sobie z wykrywaniem błędów w streszczeniach generowanych przez modele językowe” — przegrywając z mniejszymi metrykami faktyczności zbudowanymi specjalnie do tego zadania. Nawet gdy GPT-4 poprawnie oznaczył zdanie, jego wyjaśnienie dlaczego było trafne w około 80% przypadków; u pozostałych oceniających mniej więcej w połowie.
FaithBench, wydany przez Vectarę w październiku 2024 roku, nadał temu sufitowi liczbę. Zebrał halucynacje wytworzone przez dziesięć współczesnych modeli z ośmiu rodzin, co do których istniejące detektory były niezgodne, i podał, że nawet najlepsze detektory halucynacji osiągnęły trafność bliską 50%. Rzut monetą, dokładnie w przypadkach, które mają znaczenie.
Kontrola należy więc do ciebie. Brzmi jak obciążenie, dopóki nie zauważysz asymetrii: detektor musi ocenić dowolny tekst względem nieznanego dokumentu, a ty byłeś w sali. Już wiesz, które twierdzenie brzmiało dziwnie. Wystarczy je sprawdzić.
Trzy artefakty, trzy różne zadania
Większość sporów „notatki AI kontra prawdziwe notatki” to błąd kategorialny. Spotkanie wytwarza trzy artefakty, nie zastępują się nawzajem, a zespół, który zachowuje tylko jeden, zawsze traci coś konkretnego.
| Surowa transkrypcja | Streszczenie AI | Rejestr decyzji | |
|---|---|---|---|
| Zachowuje dokładne sformułowania | Tak — dosłownie | Nie — skompresowane, złagodzenia wypadają | Nie |
| Kto to powiedział | Tak, przy rozdzieleniu mówiących | Czasami; błędne przypisanie to nazwany typ błędu | Tak — odpowiedzialny jest sednem |
| Kiedy to padło | Tak — ze znacznikami czasu | Rzadko | Tylko termin |
| Decyzje z odpowiedzialnym i datą | Zakopane w około 9 000 słów | Częściowo i niepewnie | Tak — to jego jedyne zadanie |
| Co odrzucono i dlaczego | Tak, jeśli ktoś to powiedział | Zwykle wycinane jako zbędne | Tak, w jednej linijce |
| Da się przeczytać w 60 sekund | Nie | Tak | Tak |
| Można zestawić z dowodem | To jest dowód | Tylko jeśli transkrypcja przetrwa | Tylko jeśli przetrwają obie |
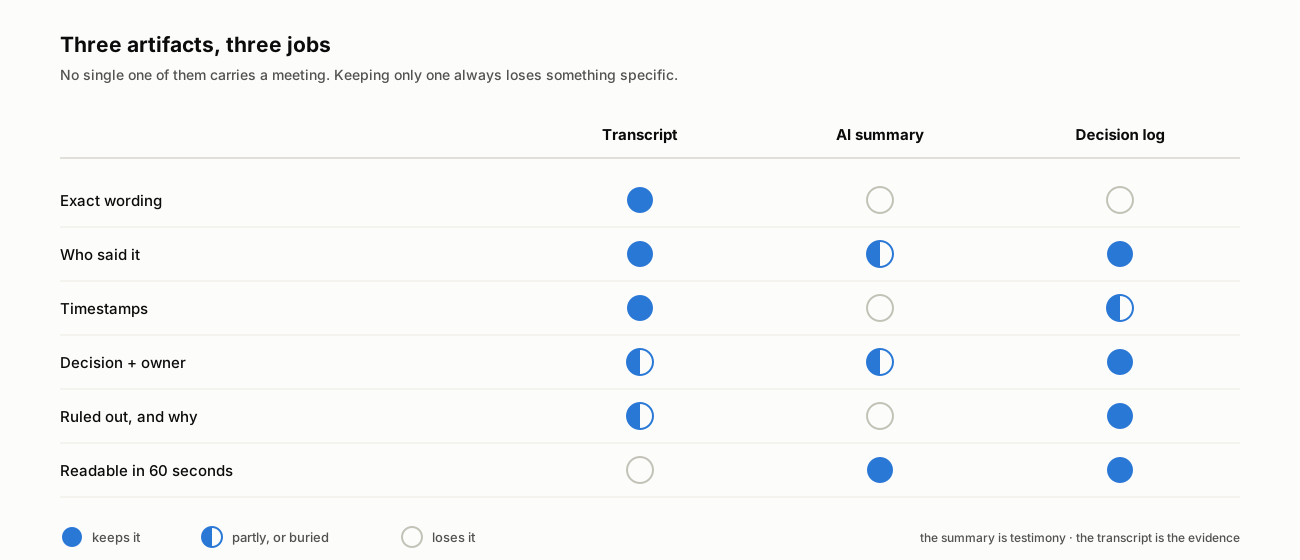
Co każdy artefakt zachowuje, zachowuje częściowo albo traci. To dolny wiersz decyduje, czy pozostałe dwa są cokolwiek warte.
Ten dolny wiersz to cały argument. Streszczenie bez zachowanej transkrypcji jest niefalsyfikowalne: gdy kolega mówi „nie tak się umawialiśmy”, masz dwie opinie i zero zapisów. I właśnie tu notatka AI jest bardziej krucha niż ludzka: protokół pisany przez człowieka nosił swoją omylność na wierzchu i wszyscy czytali go z odpowiednią nieufnością. Proza maszyny przychodzi w schludnych nagłówkach i pewnych zdaniach oznajmujących, pożyczając sobie autorytet, na który nie zapracowała.
Nazwijmy to wprost: streszczenie to zeznanie, a transkrypcja to dowód. Zeznanie bywa przydatne. Zeznanie jest też tym, co się weryfikuje.
Dziewięciominutowa kontrola, po kolei
Oto procedura, którą rekomendujemy, wymierzona dla spotkania sześćdziesięciominutowego. Kolejność ma znaczenie: na początku są kontrole o najwyższym koszcie pomyłki, więc jeśli ktoś przerwie ci w czwartej minucie, drogie błędy są już wyłapane.
- 0:00–1:30 — Czytaj wyłącznie zdania decyzyjne. W pierwszym przejściu całkowicie zignoruj narracyjne streszczenie. Znajdź każde zdanie, które stwierdza wynik, zobowiązanie albo datę. W typowym godzinnym spotkaniu jest ich od trzech do sześciu. Tylko na tych linijkach ktokolwiek będzie działał.
- 1:30–3:00 — Przywróć modalność. Dla każdego takiego zdania przeskocz do właściwego miejsca w transkrypcji i sprawdź czasownik. Padło zrobimy czy moglibyśmy, powinniśmy, prawdopodobnie? Jeśli oryginał był złagodzony, przepisz linijkę, przywracając złagodzenie — albo lepiej, oznacz ją jako pytanie otwarte z przypisanym właścicielem.
- 3:00–4:30 — Sprawdź każdą nazwę własną i każdą liczbę. Nazwiska, firmy, wersje, ceny, daty, procenty. Wyszukaj każdą w transkrypcji. To, czego tam nie ma, jest informacją zewnętrzną: usuń albo potwierdź poza spotkaniem. To praca w polu wyszukiwania, nie w czytaniu.
- 4:30–5:30 — Zweryfikuj przypisanie. Przy każdej decyzji i każdym sprzeciwie potwierdź, kto mówi w danym znaczniku czasu. Błędne przypisanie to błąd najbardziej skłonny wywołać problem międzyludzki, a nie planistyczny, i jednocześnie najszybszy do sprawdzenia.
- 5:30–6:30 — Poluj na zgubione przeczenia. Szukaj w transkrypcji nie, nigdy, chyba że, zamiast w sąsiedztwie każdej decyzji. Błąd sprzeczności odwraca sens, zostawiając zdanie nienagannie poprawne gramatycznie, więc korekta go nie znajdzie — wyszukiwanie tak.
- 6:30–8:00 — Zapytaj, czego brakuje. Tego kroku nie wykona za ciebie żadne narzędzie, bo streszczenie nie potrafi oznaczyć własnych pominięć. Dwa pytania: co odrzuciliśmy i dlaczego? Oraz na które pytanie nie odpowiedzieliśmy? Żadne z tego nie przeżywa kompresji, a właśnie to sprawia, że notatka będzie użyteczna za pół roku.
- 8:00–9:00 — Napisz rejestr decyzji i wyślij. Od trzech do sześciu linijek, każda z tym, co zostało postanowione, kto przejmuje następny krok i do kiedy. Podlinkuj transkrypcję. To ten odnośnik sprawia, że całą kontrolę może powtórzyć ktoś inny.
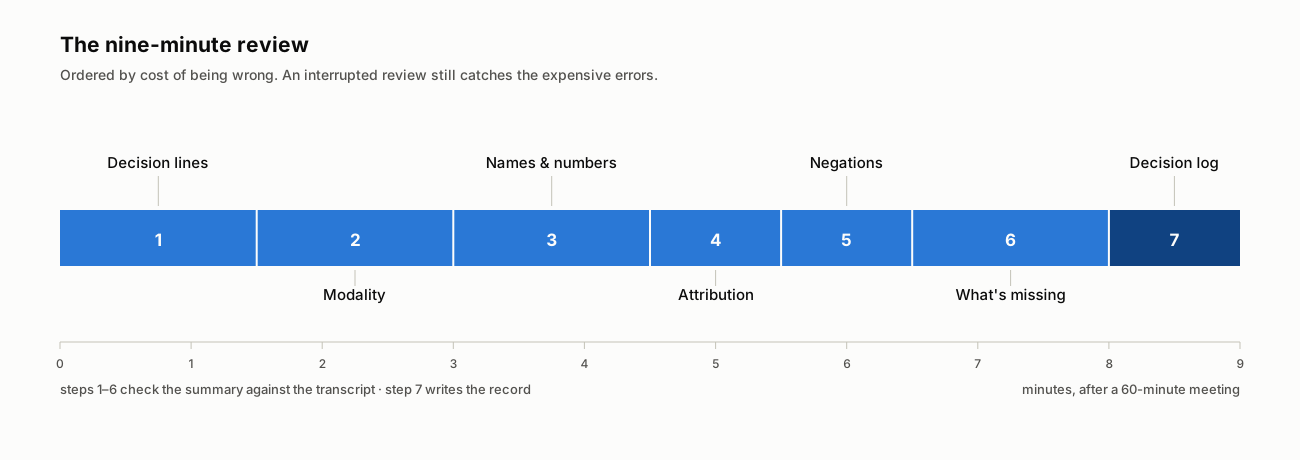
Kolejność jest projektem: modalność i zmyślone szczegóły najpierw, pominięcia na końcu. Przerwana kontrola i tak łapie drogie błędy.
Dwie uwagi praktyczne. Jeśli spotkanie trwało 30 minut, to zadanie na cztery minuty. A jeśli robisz to w narzędziu, które trzyma razem streszczenie i transkrypcję ze znacznikami czasu, kroki od 2 do 5 są wyszukiwaniem i klikaniem, a nie przełączaniem okien — i to jest różnica między nawykiem, który przetrwa zajęty tydzień, a takim, który nie przetrwa.
Dziesięć sekund na spotkaniu oszczędza pięć minut kontroli
Kontrola skraca się dramatycznie, jeśli informacja od początku jest w nagraniu. Model nie odtworzy tego, czego nikt nie powiedział, a większość tego, co czyni notatkę niejednoznaczną, nigdy nie znalazła się w dźwięku.
- Zacznij od pytania, wypowiedzianego na głos. „Dziś decydujemy, czy migracja wychodzi przed konferencją, czy po niej.” Wypowiedziane pytanie daje modelowi temat główny zamiast zbioru tematów pobocznych — a poboczne to był ten przypadek 43,6%.
- Powiedz decyzję jednym zdaniem, z nazwiskiem i datą, zanim ktokolwiek wyjdzie. „Decyzja: Mina prowadzi kontakt z dostawcą, wrześniową datę potwierdzamy do 25.” Każde narzędzie na rynku zapisze to zdanie bezbłędnie. Żadne go nie wymyśli.
- Wypowiedz przeczenie wprost. „Nie przesuwamy daty premiery” jest bezpieczniejsze niż wzruszenie ramion i skinienie głową, bo zgubione przeczenie to udokumentowany typ błędu — a przeczenia nigdy niewypowiedzianego nie da się zgubić.
- Nazwij w jednej linijce, co odrzuciliście i dlaczego. „Rozważaliśmy cennik za stanowisko i odrzuciliśmy go, bo w zeszłym kwartale dwóch klientów korporacyjnych było przeciw.” To zdanie powstrzymuje ten sam spór przed ponownym otwarciem za pół roku.
- Przeliteruj raz nietypowe nazwy własne. Nazwy dostawców, wewnętrzne kryptonimy i skrótowce to dokładnie to, co transkrypcja przekręca, a streszczenie potem pewnie powtarza.
- Nie pozwól mówić ciszy. Jeśli w sali zapada cisza, bo wszyscy czytają dokument, powiedz to. Długie odcinki bez głosu to warunki, w których modele transkrypcji halucynują najczęściej.
Nic z tego nie jest teatrem spotkań. To dyktowanie do zapisu — umiejętność, która zyskała na wartości, odkąd zapis zaczął pisać się sam.
Podsumowując
Streszczenie spotkania zrobione przez AI nie jest zapisem. Jest zeznaniem o zapisie, wygłoszonym płynnie, przez świadka, który nie ma żadnego interesu w dokładności i ma udokumentowaną skłonność do gubienia słowa „prawdopodobnie”.
Takie przeformułowanie zamyka spór „ręcznie kontra AI”, który nigdy nie był prawdziwym sporem. Zachowaj nagranie, bo to jedyny dowód. Pozwól modelowi napisać streszczenie, bo jest szybszy od ciebie i w czterdziestej minucie się nie nudzi. A potem poświęć dziewięć minut na jedyną część, która wymaga bycia obecnym: zestawienie pewnych siebie zdań z tym, co faktycznie padło, i zapisanie tych trzech linijek, na które ktoś musi zareagować.
Zespoły, które sparzą się w 2026 roku, to nie te, które odpuściły narzędzie AI do notatek. To te, które czytały jego wynik jak transkrypcję, choć była to parafraza — i nie zachowały transkrypcji, która pokazałaby różnicę. Pełniejszą wersję tego, co musi zawierać dobra notatka, opisaliśmy w sześciu rzeczach, których notatka ze spotkania nadal potrzebuje, a to, dlaczego współczynnik błędu słów prawie nic nie mówi o użyteczności transkrypcji — w dokładność to za mało.
Gdzie w tym Telli.sh: dziewięciominutowa kontrola działa tylko wtedy, gdy streszczenie i źródło mieszkają w jednym miejscu. Telli.sh trzyma transkrypcję ze znacznikami czasu i przypisaniem mówiących obok edytowalnego streszczenia AI, więc sprawdzenie twierdzenia to wyszukiwanie i kliknięcie, a nie polowanie w dwóch systemach — a gdy sala nie mówi jednym językiem, tłumaczenie stoi obok oryginału, zamiast go zastępować. Streszczenie przychodzi jako szkic, który poprawiasz, a nie wynik, który akceptujesz.
Źródła
- Tang i in., „TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization”, NAACL 2024 (arXiv:2402.13249, 20 lutego 2024)
- Koenecke i in., „Careless Whisper: Speech-to-Text Hallucination Harms”, ACM FAccT 2024 (arXiv:2402.08021, 12 lutego 2024)
- Bao i in., „FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs”, Vectara (arXiv:2410.13210, 17 października 2024)
- Hu i in., „MeetingBank: A Benchmark Dataset for Meeting Summarization”, ACL 2023 (arXiv:2305.17529, 27 maja 2023)
- Wang i in., „Analyzing and Evaluating Faithfulness in Dialogue Summarization”, EMNLP 2022 (arXiv:2210.11777, 21 października 2022)
- Strona zdjęcia w Wikimedia Commons
