Pięć etapów, cztery artefakty: co Telli.sh naprawdę robi z nagraniem spotkania
Przewodnik po całym potoku Telli.sh: nagrywanie na żywo lub przesłanie pliku audio, transkrypcja spotkań przez AI z identyfikacją mówiących, tłumaczenie spotkań w czasie rzeczywistym na 44 języki docelowe, podsumowania AI w 10 formatach i notatka do udostępnienia. Z uczciwymi ograniczeniami, dokładnymi cenami i tym, czego naprawdę wymaga dokładność transkrypcji.
Osiem osób stoi w pokoju. Jedna tłumaczy, dlaczego migracja się przesunęła. Dwie słuchają jednym uchem. Ktoś z tyłu wypowiada zdanie, które za trzy tygodnie okaże się kluczowe, i nikt go nie zapisuje.
To jest surowiec. Ten tekst opowiada, co nasz system z nim robi — etap po etapie, od chwili, gdy dźwięk zaczyna płynąć, do chwili, gdy wklejasz link na kanał.
To prezentacja produktu przygotowana przez zespół tworzący Telli.sh. Pokazuje drogę audio od nagrania lub przesłania pliku przez transkrypcję, tłumaczenie i dopracowanie aż do notatki, którą można udostępnić; po drodze podaje modele, ograniczenia i ceny.
W skrócie:
- Nagranie przechodzi przez pięć etapów przetwarzania i zostawia cztery osobno przechowywane artefakty: surową transkrypcję, mapę mówiących, oczyszczony skrypt oraz po jednym podsumowaniu na każdy zastosowany format.
- Identyfikacja mówiących działa na
pyannote/speaker-diarization-community-1, fragment po fragmencie, przenosząc dalej odciski głosu, żeby ta sama osoba miała tę samą etykietę w piątej i w pięćdziesiątej minucie.- Tłumaczenie obsługuje 44 kody językowe; sam interfejs istnieje w 15 językach; podsumowania dostępne są w 10 wbudowanych formatach plus dowolnych własnych, definiowanych nazwą, instrukcją i listą sekcji.
- Sprawdź aktualny cennik: rozliczenia miesięczne i roczne, minuty oraz funkcje planów. Mogą się zmieniać; walutę, podatki i warunki sprawdź przy płatności. Artykuł nie jest ofertą rozliczeniową.
Zdjęcie: Klean Denmark, „Daily sprint meeting", Wikimedia Commons, CC BY-SA 2.0. Dokładnie ten rodzaj spotkania, dla którego cały ten potok istnieje.
Dźwięk wchodzi dwiema drogami, i nie są to te same drogi
Punkty wejścia są dokładnie dwa, a różnica między nimi kształtuje wszystko dalej.
Pierwszy to nagrywanie na żywo. Przeglądarka otwiera AudioContext ustawiony sztywno na 16 000 Hz, ładuje AudioWorklet i buforuje wejście mikrofonu w blokach po 4096 próbek — przy 16 kHz to jeden pakiet co 256 milisekund. Każdy blok jest konwertowany z 32-bitowego float na 16-bitowy całkowitoliczbowy PCM i wysyłany przez WebSocket na /ws/audio/{sessionId}. Drugi socket, /ws/session/{id}, obsługuje kanał sterowania: zmiany języka, aktualizacje kontekstu, polecenie SUMMARIZE oraz polecenie FINISH, które zamyka sesję i zapisuje notatkę.
Drugi to przesłanie pliku. Wrzucasz nagranie do okna przesyłania, trafia strumieniowo do POST /upload, a odpowiedź wraca jako JSON rozdzielany znakami nowej linii — strumień, nie kręcące się kółko — dzięki czemu interfejs pokazuje realny postęp w nazwanych krokach, a nie zmyślony procent. Twarde limity warto powiedzieć wprost: 500 MB na plik, a selektor przyjmuje wyłącznie audio/*. Jeśli spotkanie siedzi w nagraniu ekranu MP4, ścieżkę dźwiękową trzeba wcześniej wyciągnąć. Tego dziś za ciebie nie robimy.
Obie ścieżki schodzą się w ten sam kręgosłup przetwarzania. Od etapu pierwszego nagranie na żywo i przesłany plik traktowane są identycznie.
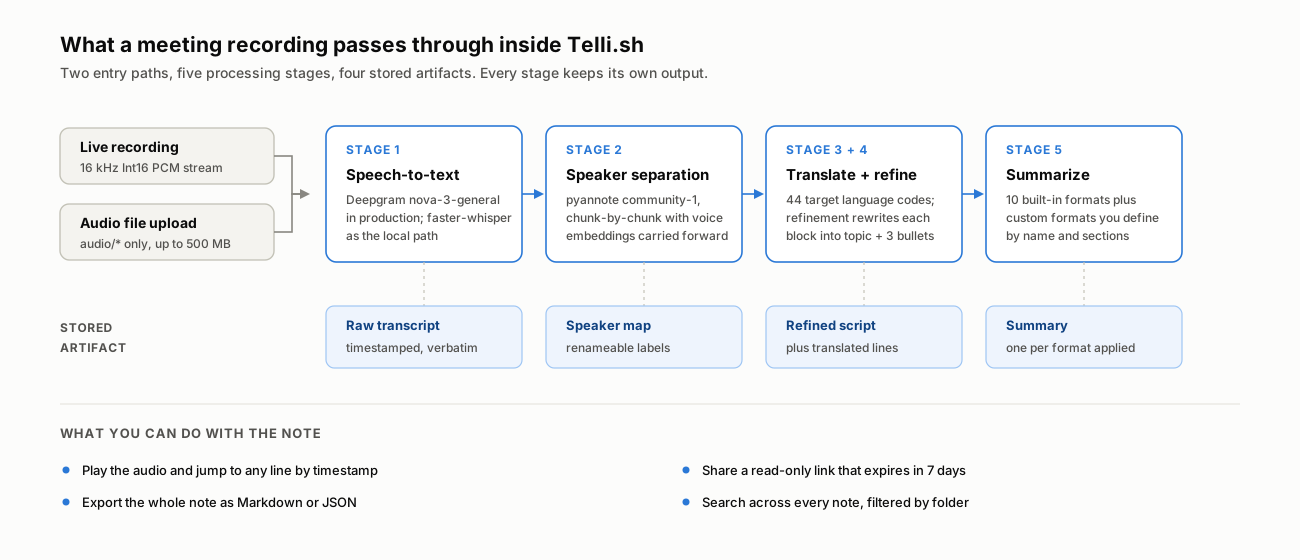
Każdy etap zachowuje własne wyjście. Kolejny etap niczego nie nadpisuje.
Etapy 1 i 2: usłyszeć słowa, a potem ustalić, czyje one były
Najpierw działa rozpoznawanie mowy. Na produkcji zarówno ścieżka wsadowa, jak i strumieniowa korzystają z modelu Deepgram nova-3-general; w kodzie jest też w pełni lokalna ścieżka oparta na faster-whisper dla wdrożeń własnych, wybierana jednym ustawieniem dostawcy. Ten wybór znaczy mniej, niż się powszechnie sądzi, a powód opisaliśmy szeroko: czołowe modele mowy w niezależnych rankingach mieszczą się dziś w przedziale około 1,5 punktu procentowego współczynnika błędu słów. Silnik przestał być miejscem, w którym powstaje różnica jakości.
Powstaje ona przy identyfikacji mówiących.
Diarizacja działa na pyannote/speaker-diarization-community-1. Szczegół implementacyjny, który naprawdę ma znaczenie, to sposób obsługi długich nagrań. Zamiast diarizować cały plik za jednym razem, potok przetwarza dźwięk fragmentami i przypisuje mówiących tuż po każdym fragmencie — ale utrzymuje narastający słownik odcisków głosu dla każdego mówiącego i w każdym kolejnym fragmencie identyfikuje ich ponownie względem tego zbioru. To ten mechanizm zapobiega klasycznej awarii, w której dwugodzinne nagranie po cichu przemianowuje tę samą osobę na SPEAKER_00, potem SPEAKER_03, a potem SPEAKER_07.
Gdy segment nachodzi na dwie wypowiedzi, etykieta trafia do tej, która pokrywa go bardziej, a przy niewielkim nałożeniu rozstrzyga podobieństwo odcisków głosu.
Dostajesz ogólne etykiety — SPEAKER_00, SPEAKER_01 — bo model nie może wiedzieć, że SPEAKER_01 to twoja dyrektorka inżynierii. Zmieniasz nazwy raz w notatce, a przypisanie zapisuje się razem z nią i obowiązuje potem wszędzie, także w eksportach i linkach do udostępniania. To uczciwy podział pracy: maszyna rozdziela głosy, ty podajesz nazwiska.
Co naprawdę zostaje po każdym etapie
Zasada projektowa, której się trzymamy, brzmi: żaden etap nie niszczy wyjścia poprzedniego. Zawsze musisz móc wrócić do słów, które faktycznie padły.
Cztery grupy to transkrypcja, mapa mówców, opracowany tekst i podsumowanie. Tłumaczone wiersze należą do transkrypcji; piąty wiersz nie oznacza piątego osobnego wyniku.
| Artefakt | Tworzony przez | Co zawiera | Do czego służy |
|---|---|---|---|
| Surowa transkrypcja | Etapy 1 + 2 | Dosłowne wiersze ze znacznikami czasu i etykietą mówiącego przy każdym | Sprawdzenie, co dosłownie powiedziano; kliknięcie wiersza przewija nagranie |
| Mapa mówiących | Etap 2 (+ twoje edycje) | Przypisanie etykieta-nazwisko w tej notatce | Czyni czytelnymi wszystkie pozostałe widoki — działa w notatce, eksportach i udostępnieniach |
| Oczyszczony skrypt | Etap 4 | Każdy blok przepisany na pogrubiony wiersz tematu plus maks. 3 punkty | Przejrzenie długiego spotkania bez czytania go |
| Przetłumaczone wiersze | Etap 3 | Tłumaczenie dołączone do każdego wiersza obok oryginału | Przeczytanie spotkania prowadzonego w języku, którego nie używasz w pracy |
| Podsumowanie | Etap 5 | Jeden ustrukturyzowany dokument na każdy zastosowany format | To, co faktycznie wysyłasz ludziom |
W interfejsie notatki wygląda to jak trzy rodzaje zakładek: Historia (surowa transkrypcja), Skrypt (wersja oczyszczona) oraz po jednej zakładce na każdy wygenerowany format podsumowania. Jeśli dźwięk nagrania został zapisany, nad nimi pojawia się odtwarzacz, a kliknięcie dowolnego wiersza transkrypcji przewija nagranie do tego znacznika czasu.
Etap 3: w tłumaczeniu liczbą, która się liczy, jest 44
Tłumaczenie spotkań w czasie rzeczywistym przyciągnęło do nas najwięcej wczesnych użytkowników i warto precyzyjnie określić jego zakres, bo „obsługa ponad 100 języków" to najtrudniejsza do zweryfikowania obietnica w tej kategorii.
W grze są dwie różne liczby i nie są tą samą liczbą:
- Do tłumaczenia przyjmowane są 44 kody języków docelowych. Ten zbiór jest jawnie wyliczony w konfiguracji backendu i zawiera
zh-TWodrębnie odzh— co waży więcej, niż brzmi, jeśli pracujesz między Tajwanem a Chinami kontynentalnymi. - 15 języków obsługiwanych jest dla samego interfejsu i dla języka, w którym AI pisze twoje podsumowanie: angielski, koreański, japoński, chiński, niemiecki, francuski, hiszpański, włoski, portugalski, rosyjski, polski, wietnamski, tajski, indonezyjski i malajski.
W sesji na żywo tłumaczenie jest przyrostowe, nie zbiorcze na końcu. Gdy do transkrypcji docierają granice interpunkcyjne, tłumaczenie danego fragmentu wpływa obok oryginału, a pamięć podręczna sesji nie pozwala tłumaczyć ponownie niezmienionego tekstu. Przy przesyłaniu pliku wiersze są natomiast grupowane w paczki: gdy nikt nie patrzy na ekran, przepustowość liczy się bardziej niż opóźnienie.
Istnieje też tryb pracy „tłumaczenie", odrębny od trybu notatki, na wypadek gdy to tłumaczenie jest efektem końcowym: dwujęzyczna rozmowa, którą trzeba śledzić na żywo, a nie spotkanie, z którego potrzebny jest protokół.
Etap 4: etap, o który nikt nie prosi, a którego wszyscy potrzebują
Tu opis przechodzi w opinię i nie zamierzamy jej łagodzić: oczyszczanie to najbardziej niedoceniany etap tego potoku.
Dosłowna transkrypcja ludzkiej mowy jest niemal nieczytelna. Ludzie zaczynają zdania od nowa, urywają, cztery razy mówią „tak, tak, dokładnie" i zakopują jedną decyzję w dziewięćdziesięciu sekundach chrząkania. Zapisanie tego bez jednego błędu to wciąż dziewięćdziesiąt sekund chrząkania.
Dlatego etap oczyszczania bierze każdy blok rozmowy i przepisuje go pod ścisłymi ograniczeniami, zdefiniowanymi w szablonie promptu, a nie w kodzie — dzięki czemu można je stroić bez wdrożenia. Każdy blok staje się pogrubionym wierszem tematu wyprowadzonym z treści — nie z nazwy roli, bez nawiasów kwadratowych — po którym idą najwyżej trzy punkty, z celem około 300 znaków na blok. Nazwy mówiących i znaczniki czasu są jawnie usuwane: są już w surowej transkrypcji, a ich powtarzanie sprawia tylko, że widok do przeglądania gorzej się przegląda.
Jedno ograniczenie w tym szablonie zasługuje na osobną wzmiankę: model ma dopasować się do rejestru tego, co usłyszał, i wyraźnie nie narzucać tonu spotkania biznesowego swobodnej rozmowie. Rozmowa na korytarzu podsumowana jak protokół z rady nadzorczej to gorszy artefakt niż brak podsumowania.
Wynik nazywamy skryptem: wersja, którą przeczytasz jednym rzutem oka, o jedną zakładkę od wersji, którą można zacytować w sporze.
Etap 5: dziesięć formatów podsumowania, bo „podsumowanie" to nie jedna rzecz
Ostatni etap tworzy dokument, który naprawdę wysyłasz. Poproszenie modelu o „podsumowanie" daje podsumowanie niczego konkretnego, więc format jest tutaj pełnoprawnym wyborem, a nie ukrytą wartością domyślną.
Wbudowanych formatów jest dziesięć: Podsumowanie AI (ogólne), Protokół ze spotkania, Raport zarządczy, Notatki z wykładu, Kazanie / Prelekcja, Zapis konsultacji, Podsumowanie rozmowy, Wywiad, Notatki z pomysłami i Szkic prezentacji. Każdy niesie własną strukturę sekcji: protokół tworzy przegląd, omawiane punkty, decyzje i kolejne kroki; szkic prezentacji tworzy konspekt, przebieg slajdów, kluczowe komunikaty, notatki prelegenta i następne działania. Same nagłówki sekcji są zlokalizowane dla każdego języka, a nie tłumaczone w momencie generowania — dlatego podsumowanie po japońsku czyta się jak dokument japoński, a nie przetłumaczony angielski.
Gdy żaden z dziesięciu nie pasuje, definiujesz format własny: nazwa, zestaw instrukcji i lista sekcji, zapisane i wielokrotnego użytku. „Cotygodniowa aktualizacja dla zarządu z ryzykami i otwartymi decyzjami" to format, który pisze się raz.
Każdy format można zastosować do notatki po fakcie i każdy tworzy własną zakładkę. Podsumowanie tego samego nagrania na trzy sposoby dla trzech odbiorców jest tu normalnym użyciem, a nie obejściem.
Dokładność transkrypcji to stos, a nie liczba
Współczynnik błędów słów to tylko jeden z elementów oceny transkrypcji spotkania. W tekście Sama dokładność STT nie wystarcza wyjaśniamy, dlaczego pominięte „nie" może odwrócić decyzję, niemal nie wpływając na wynik ogólny.
Wersja praktyczna: dokładność transkrypcji, która przeżywa zderzenie z prawdziwym spotkaniem, składa się z pięciu warstw, a model akustyczny jest tylko tą najniższą.
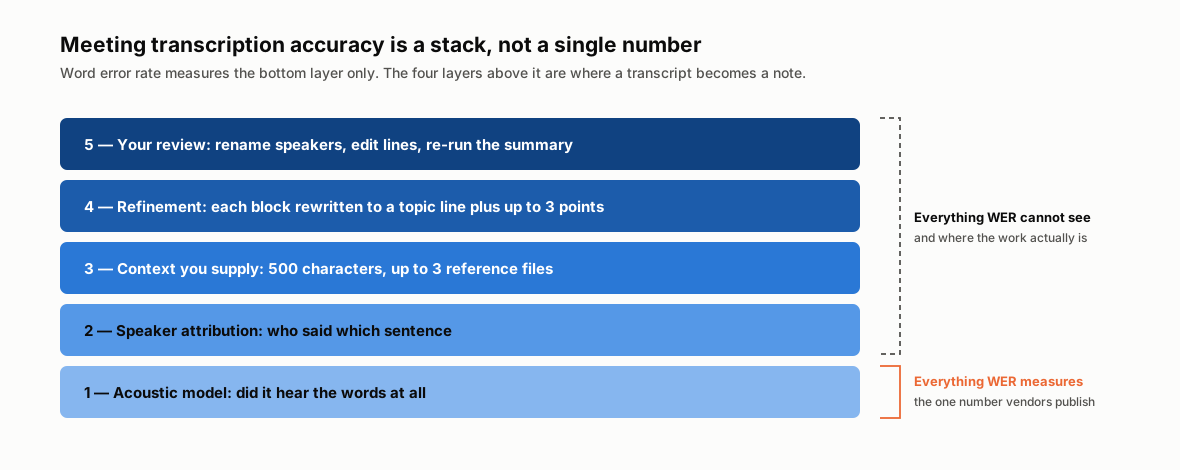
Współczynnik błędu słów mierzy warstwę 1. O tym, czy transkrypcja jest użyteczna, decydują warstwy od 2 do 5.
Warstwa 3 to ta, którą użytkownik kontroluje bezpośrednio i którą większość pomija. Przed nagraniem lub przesłaniem możesz podać blok kontekstu do 500 znaków — temat, nazwiska uczestników, kody produktów, skróty — i dołączyć do 3 plików referencyjnych (PDF, obraz lub tekst), z których tekst jest wydobywany w przeglądarce i składany do tego samego limitu. Ten kontekst trafia do etapów z AI.
Nazwy własne niosą dużo informacji, ale rzadko występują w ogólnych danych treningowych: to wewnętrzne nazwy projektów, nietypowe nazwiska i kody produktów. Dodanie kontekstu, na przykład że „Kestrel" to produkt, a „Ravi" to osoba, pomaga systemowi je rozpoznawać. Przed nagrywaniem wypełnij pole kontekstu nazwami i terminami, których system może nie znać.
Od zera do udostępnionej notatki w jedenastu krokach
Konkretnie, od pierwszego uruchomienia do artefaktu, którym można się podzielić:
- Załóż konto. Sprawdź aktualny cennik: rozliczenia miesięczne i roczne, minuty oraz funkcje planów. Mogą się zmieniać; walutę, podatki i warunki sprawdź przy płatności. Artykuł nie jest ofertą rozliczeniową.
- Wybierz ścieżkę: rozpocznij nagrywanie na żywo albo otwórz okno przesyłania i wrzuć plik audio (
audio/*, poniżej 500 MB). - Ustaw parę językową. Źródło może zostać na wykrywaniu automatycznym; język docelowy decyduje, w czym wyjdą tłumaczenie i podsumowanie.
- Wypełnij pole kontekstu — temat, nazwiska, skróty, do 500 znaków. Dołącz do 3 plików referencyjnych, jeśli masz prezentację lub agendę.
- Wybierz folder, jeśli notatka ma trafić w konkretne miejsce. Przenieść możesz ją później.
- Nagrywaj albo poczekaj na strumień przesyłania. W sesji na żywo transkrypcja pojawia się w miarę mówienia, a tłumaczenie wpływa obok, jeśli ustawiono język docelowy. Podczas przesyłania zobaczysz nazwane kroki: rozpoznawanie mowy, analiza, oczyszczanie, podsumowanie, finalizacja.
- Zakończ sesję. To wyzwala komunikat sterujący
FINISH, który domyka ostatni fragment, czeka na trwające oczyszczanie, zapisuje dźwięk, generuje podsumowanie i zapisuje notatkę. - Zmień nazwy mówiących. SPEAKER_00 raz staje się imieniem, a przypisanie rozchodzi się po wszystkich widokach i wszystkich eksportach.
- Przeczytaj zakładkę Skrypt, żeby wiedzieć, o czym było spotkanie; zejdź do Historii i kliknij wiersz, żeby usłyszeć nagranie w dokładnie tym momencie, gdy coś wygląda nie tak.
- Wygeneruj dodatkowe formaty podsumowania, jeśli jedna grupa odbiorców potrzebuje protokołu, a druga raportu zarządczego.
- Udostępnij lub wyeksportuj. Link do udostępniania jest tylko do odczytu, wygasa po 7 dniach i może mieć opcjonalne hasło. Eksport daje Markdown albo JSON, z podsumowaniem, oczyszczonymi blokami i pełną transkrypcją w jednym pliku.
Prześlij nagranie, które już masz
Prosty i przejrzysty cennik
Sprawdź aktualny cennik: rozliczenia miesięczne i roczne, minuty oraz funkcje planów. Mogą się zmieniać; walutę, podatki i warunki sprawdź przy płatności. Artykuł nie jest ofertą rozliczeniową.
Obecna licencja pozwala na osobisty użytek niekomercyjny. Przeczytaj warunki, zasady bezpieczeństwa i prywatności. O retencję i trenowanie AI zapytaj [email protected] przed wysłaniem danych wrażliwych.
Czego Telli.sh nie robi
Tekst produktowy, który wylicza wyłącznie możliwości, jest reklamą. Oto druga kolumna.
Nie przyjmuje plików wideo. Uploader akceptuje audio/*. Najpierw wyodrębnij ścieżkę dźwiękową.
Nie dołącza do twoich rozmów. Nie ma bota, który dzwoni do Zooma, Meeta czy Teamsów i siedzi na liście uczestników. Nagrywasz salę albo dźwięk własnej maszyny, albo przesyłasz plik po fakcie.
Nie naprawia złego dźwięku. Jeden dookólny mikrofon laptopa na końcu stołu dla dwunastu osób, w pokoju o twardych ścianach, pogorszy diarizację niezależnie od tego, czyj model działa — nakładające się wypowiedzi i odlegli mówiący to miejsce, w którym przypisanie pęka najpierw. Telefon na środku stołu wygrywa z laptopem na końcu za każdym razem i nie kosztuje nic.
Nie zna twojego słownictwa, dopóki mu go nie podasz. Patrz warstwa 3 powyżej. Nietypowe nazwy własne to najczęstsze źródło błędów, a pole kontekstu jest na to lekarstwem.
Etykiety mówiących zaczynają się ogólnie. Żaden system nie zgadnie, że SPEAKER_01 to Priya. Zmieniasz nazwę raz na notatkę.
Linki do udostępniania mają termin. Siedem dni, potem link umiera. To celowa wartość domyślna dla treści ze spotkań, a nie zapomniana funkcja — ale oznacza też, że taki link nie jest archiwum. Jeśli potrzebujesz trwałości, wyeksportuj Markdown.
Podsumowując
Telli.sh to coś więcej niż produkt do transkrypcji. Transkrypcja jest pierwszym z pięciu etapów, po którym następują przypisanie mówiących, dopracowanie, tłumaczenie i podsumowania.
To, co faktycznie budujemy, to dystans między nagraniem a decyzją: wiedzieć, kto mówił; ścisnąć dziewięćdziesiąt sekund chrząkania do jednego zdania, które w nich siedzi; oddać to zdanie w języku, w którym pracuje czytający; i położyć je tam, gdzie kolega może je otworzyć. Nagranie to dowód. Notatka to rzecz, która zmienia to, co wydarzy się w przyszłym tygodniu.
Jeśli masz nagranie ze spotkania, wypróbuj ten proces na własnym audio i porównaj otrzymaną notatkę z transkrypcją.
Rozpocznij sesję na żywo z tłumaczeniem
Źródła
- Sama dokładność STT nie wystarcza — blog Telli.sh, 4 sierpnia 2026 — pełny wywód o współczynniku błędu słów wraz z rozrzutem w rankingu
- pyannote/speaker-diarization-community-1 — Hugging Face — model diarizacji używany w tym potoku
- Dokumentacja modelu Deepgram Nova-3 — model rozpoznawania mowy używany na produkcji
- Cennik Telli.sh — aktualne limity i ceny
- Strona zdjęcia w Wikimedia Commons — zdjęcie nagłówkowe, Klean Denmark, CC BY-SA 2.0
