구글은 당신의 베트남어 회의를 실시간으로 통역한다. 하지만 단 한 글자도 기록하지 않는다.
구글 Meet의 번역 자막은 베트남어를 포함해 69개 언어를, 구글 번역의 Live translate는 74개 언어를 지원합니다. 반면 Meet의 Transcripts 기능과 Gemini 기반 노트 작성 기능은 각각 정확히 8개 언어만 지원하고, 베트남어는 어느 쪽에도 없습니다. DeepL Voice가 베트남어 음성을 받아쓸 수 있는 경로는 관리자가 따로 켜야 하고 자동 감지도 쓸 수 없는 서드파티 제공자뿐입니다. 2026년의 실시간 음성 번역이 베트남어 팀에게 실제로 주는 것과, 끝내 주지 않는 것을 정리했습니다.
베트남어로 실시간 음성 번역을 구글에 검색해 보면 꽤 괜찮은 답이 나옵니다. 구글 번역의 Live translate 기능은 안드로이드와 iOS 양쪽에서 74개 언어를 지원하고, 베트남어도 그 안에 들어 있습니다. 이어폰이 있든 없든 작동하고, 화면을 잠가도 계속 돌아가며, 화면을 반으로 나눠 두 사람이 각자 자기 쪽을 읽는 마주 보기 모드도 제공합니다.
작동은 합니다. 흥미로운 대목은 거기가 아닙니다.
흥미로운 대목은 같은 플랫폼에서 네 시간 뒤에 벌어지는 일입니다. 회의에서 실제로 무엇이 합의됐는지 확인하고 싶어질 때 말이죠. 오래 남는 구글 문서를 만들어 주는 기능인 구글 Meet의 Transcripts는 정확히 8개 언어만 지원하고, 베트남어는 그중에 없습니다. Meet의 「Take notes for me」가 지원하는 8개 언어에도 없습니다. 이 기능의 도움말 페이지는 한술 더 떠서 「한 번에 한 가지 언어만 지원한다」, 「같은 회의에서 여러 언어를 말하는 경우는 현재 지원되지 않는다」라고 적어 두었습니다.
TL;DR
- 베트남어는 듣는 쪽 구글 기능에서는 전부 지원됩니다. Live translate(74개 언어), Meet 번역 자막(69개 언어). 반면 쓰는 쪽 구글 기능에서는 둘 다 지원되지 않습니다. Meet Transcripts와 Meet의 Gemini 노트 작성 기능, 각각 8개 언어뿐입니다.
- DeepL Voice는 베트남어로 자막을 표시할 수는 있지만, 자체 모델로 베트남어 음성을 받아쓰지는 못합니다. 베트남어는 관리자가 켜 줘야 하고 자동 감지도 쓸 수 없는 서드파티 등급에 놓여 있습니다.
- 아래 비교표는 2026년 8월 31일 기준 주요 플랫폼별 베트남어 지원 여부를 보여주며, 기록이 남는 베트남어–영어 회의를 진행하는 6단계를 뒤이어 소개합니다.
같은 간극은 다른 언어에도 영향을 줍니다. 대화가 끝나면 사라지는 번역에 관한 개요 글에서 설명했듯이요. 베트남어 팀에게는 문제가 더 선명합니다. 기록을 보존하도록 설계된 회의 기능에 베트남어가 없습니다.
지금 베트남어에서 「실시간 음성 번역」이 실제로 해 주는 일
정직한 회계부터 시작하죠. 구글의 무료 도구들은 자기가 만들어진 목적에 관해서는 대단히 훌륭하니까요.
2026년 8월 31일에 확인한 안드로이드 도움말 페이지에 따르면, 구글 번역의 Live translate에는 네 가지 모드가 있습니다. Listening(휴대폰을 귀에 대거나 이어폰을 끼고 상대방의 말을 실시간으로 번역), Conversation(번역이 소리로 재생되고 화자가 번갈아 말함), Text only(소리 없이 읽기만), 그리고 Custom settings입니다. 여기에 더해 별도의 Face to face 모드가 있는데, 화면이 반으로 갈라져 각 화자가 자기 쪽에서 자기 언어의 전사와 번역을 함께 봅니다. 마이크가 한 언어가 끝나고 다른 언어가 시작되는 지점을 자동으로 감지하기 때문에, 문장 사이마다 버튼을 누를 사람은 필요 없습니다.
보통 받는 평가보다 더 인정받아야 할 디테일이 둘 있습니다. 첫째, 세션이 멀티태스킹을 견딥니다. 구글 문서는 번역이 「앱을 전환하거나, 애플리케이션을 최소화하거나, 화면이 잠겨도 끊김 없이 계속된다」라고 명시합니다. 둘째, 베트남어는 오프라인용으로 내려받을 수 있고, 내려받은 팩은 같은 화면에서 더 높은 품질의 버전으로 업그레이드할 수 있습니다. 현장 방문이나 공장 라인이 통신 품질을 보장해 주지 않는 나라에서는 이게 꽤 중요합니다.
사람들이 의외로 자주 놀라는 한계가 하나 있어서 분명히 짚고 갑니다. 이건 휴대폰 기능입니다. 웹 버전에 대한 구글 도움말 페이지는 한 문장으로 이렇게 말합니다. 「웹용 구글 번역에서는 말하면서 동시에 번역할 수 없습니다.」 이중언어 회의가 노트북에서 열린다면, Live translate는 그 방에 없습니다.
택시, 업체 방문, 방문 고객과의 복도 대화에서는 Live translate가 거의 해결된 문제에 가까운 무료 도구이므로 망설임 없이 권할 만합니다. 대화에서 실패하는 것이 아닙니다. 회의에서 실패합니다.
Gemini 3.5 Live Translate가 Meet를 5개 언어에서 70개 이상으로 끌어올린다
구글의 실시간 번역 지원은 이 글이 작성될 당시 제공되던 휴대전화 및 자막 기능을 넘어 확장되고 있습니다.
2026년 6월 9일, 구글은 70개가 넘는 언어를 다루는 음성-대-음성 번역 모델 Gemini 3.5 Live Translate를 발표했습니다. Slator가 2026년 6월 16일 보도한 바에 따르면, 이 모델은 Gemini Live API와 Google AI Studio를 통해 퍼블릭 프리뷰로 배포되고 있고, 일부 Workspace 고객을 대상으로 구글 Meet에서 프라이빗 프리뷰에 들어갔으며, 안드로이드와 iOS의 구글 번역 모바일 앱에는 전 세계에 출시됩니다.
Meet 입장에서 중요한 숫자는 전후 비교입니다. Meet의 음성 번역은 그동안 영어를 오가는 방향으로만 번역되는 5개 언어에 묶여 있었습니다. Gemini 3.5 Live Translate는 이를 70개가 넘는 언어와 2,000가지가 넘는 언어 쌍 조합으로 확장하고, 더 넓은 범위의 정식 제공은 2026년 후반으로 계획되어 있습니다. 베트남어 팀에게 영어를 축으로 삼는 5개 언어 체계는 사실상 없는 것이나 마찬가지였습니다. 2,000개 쌍은 완전히 다른 제품입니다.
구글이 이 모델의 자리를 좁게 잡고 있다는 점은 나쁜 신호가 아니라 좋은 신호입니다. Slator에 따르면 문서는 Live Translate를 Gemini의 더 넓은 Live Agent 기능과 대비시킵니다. 이 모델은 실시간 번역 파이프라인으로 동작하고, 오디오 입력만 받으며, 함수 호출과 검색 그라운딩, 도구, 시스템 지시문을 의도적으로 빼 놓았습니다. 어시스턴트가 아니라 통역사인 셈이죠. OpenAI가 GPT-Realtime-Translate를 설명할 때 그었던 것과 똑같은 구분입니다. 구글은 또 안드로이드에 「listening mode」를 추가해 번역된 오디오를 수화부로 흘려보냅니다. 회의에서 눈에 띄게 이어폰을 끼지 않고도 번역을 따라갈 수 있게 한 것이죠.
그래서 베트남어의 실시간 계층은 여러 방향에서 동시에, 빠르게 좋아지고 있습니다. 이제 다른 질문으로 넘어가죠.
기록의 경계선: 베트남어는 여기서 멈춘다
모든 플랫폼에는 선이 하나 있습니다. 한쪽에는 말이 오가는 순간에 그 말을 이해하도록 돕는 기능들이 있습니다. 다른 쪽에는 말을 다음 주에도 남아 있는 무언가로 바꿔 주는 기능들이 있습니다. 이 선을 기록의 경계선이라고 불러 보죠. 그리고 베트남어에게는, 그 선이 바로 지원이 사라지는 지점입니다.
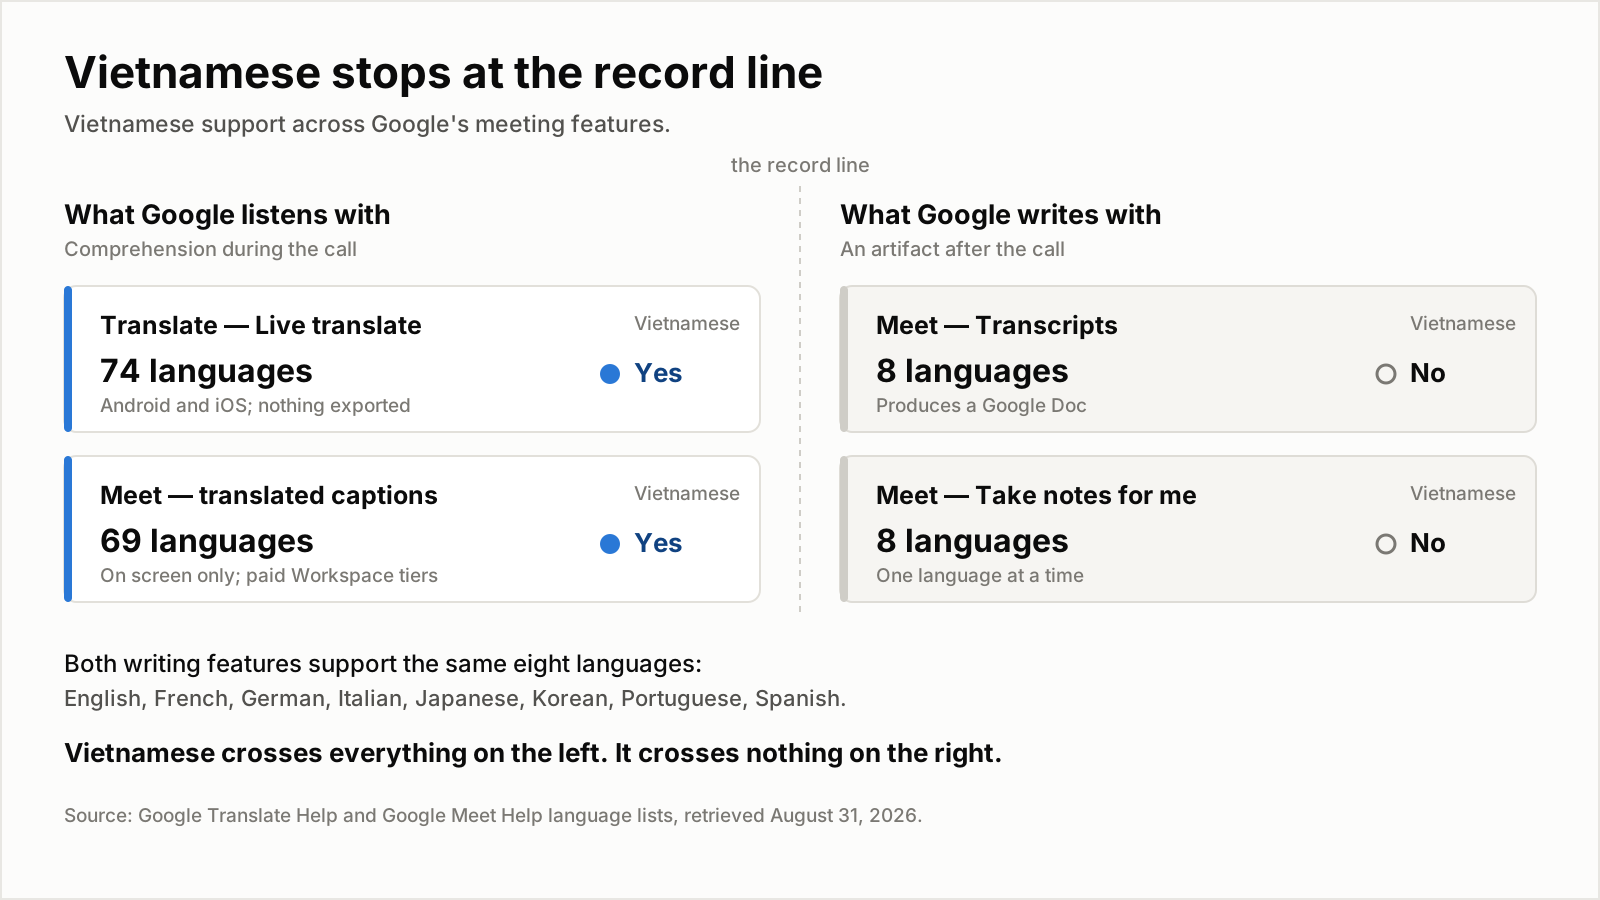
언어 수치는 2026년 8월 31일에 확인한 구글 도움말 페이지 네 곳에서 가져온 구글 자신의 숫자입니다. 베트남어는 듣는 기능 두 곳에는 모두 등장하고, 쓰는 기능 두 곳에는 모두 없습니다.
기능별 비교표를 보면 그 경계가 분명해집니다.
| 구글 기능 | 베트남어 지원 여부 | 언어 수 | 통화가 끝난 뒤 산출물이 남는가 |
|---|---|---|---|
| 구글 번역 — Live translate | 지원 | 74 | 남지 않음 |
| 구글 Meet — 번역 자막 | 지원 | 69 | 화면에만 표시. Record captions로 녹화하면 영상에 새겨짐 |
| 구글 Meet — Transcripts | 미지원 | 8 | 남음, 구글 문서 |
| 구글 Meet — 「Take notes for me」 | 미지원 | 8, 한 번에 하나 | 남음, 구글 문서 노트와 이메일 요약본 |
| 구글 Meet — Gemini 3.5 Live Translate | 순차 배포 중 | 현재 5, 프라이빗 프리뷰에서 70+ | 명시되지 않음 |
모든 행은 구글 도움말 페이지와 Slator의 2026년 6월 16일 보도에서 가져왔으며, 2026년 8월 31일에 확인했습니다.
Transcripts와 「Take notes for me」가 공유하는 8개 언어는 완전히 동일합니다. 영어, 프랑스어, 독일어, 이탈리아어, 일본어, 한국어, 포르투갈어, 스페인어. 같은 목록이 두 번 나온 것이고, 그 목록은 유럽과 동아시아의 큰 시장들입니다. 2024년 작업 후기에서 삼성이 직접 집계한 바로 대략 9,700만 명이 쓰는 베트남어는 그 바깥에, 태국어와 인도네시아어, 힌디어, 아랍어와 함께 놓여 있습니다.
이중언어 팀을 특히 정면으로 때리는 제약이 하나 더 있는데, 이건 지원 언어만으로 일하는 팀에게도 그대로 적용됩니다. 「Take notes for me」의 구글 도움말 페이지는 이 기능이 한 번에 한 가지 언어만 지원하며, 같은 회의에서 여러 언어를 말하는 경우는 현재 지원되지 않는다고 명시합니다. 베트남어와 영어를 오가는 베트남–미국 통화는 두 번 실격됩니다. 한 번은 베트남어라서, 또 한 번은 언어를 오가서요.
구글을 공정하게 보자면, 번역 자막도 제한적인 저장 경로는 있습니다. 회의를 녹화하면서 Record captions를 선택하면 자막이 클립에 삽입되고, 세션 중에는 번역 자막을 다시 살펴볼 수도 있습니다. 하지만 영상 파일에 박힌 자막은 검색 가능한 기록이 아닙니다. 픽셀을 검색할 수도, 이름을 고칠 수도, 그 내용으로 요약을 만들 수도 없습니다. Meet 번역 자막은 유료 Workspace 에디션인 Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter(2025년 6월 30일까지 제공), Google AI Pro for Education에서만 쓸 수 있습니다.
DeepL은 베트남어 자막은 보여 준다. 베트남어 음성을 받아쓰는 건 다른 등급이다
DeepL Voice는 또 다른 경로를 제공하지만, 문서에서는 음성 인식에 쓰이는 언어와 자막에 표시되는 언어를 구분합니다.
DeepL은 언어 지원을 두 목록으로 나눕니다. Spoken languages는 인식기가 받아들이는 언어입니다. Translation languages는 자막으로 표시할 수 있는 언어입니다. 베트남어는 번역 언어 목록에 들어 있고, 이 목록은 41개 언어에 이릅니다. 이제 반대쪽을 보시죠. DeepL 자체 모델이 받아쓰는 발화 언어는 18개입니다. 중국어(만다린), 체코어, 네덜란드어, 영어, 프랑스어, 독일어, 인도네시아어, 이탈리아어, 일본어, 한국어, 폴란드어, 포르투갈어, 루마니아어, 러시아어, 스페인어, 스웨덴어, 튀르키예어, 우크라이나어. 베트남어는 여기에 없습니다.
베트남어도 발화 언어로 쓸 수는 있습니다. 다만 서드파티 제공자인 Speechmatics가 받아쓰는 20개 언어의 두 번째 등급에서만 가능합니다. 여기에는 조건 세 가지가 따라붙는데, 모두 2026년 8월 31일에 확인한 DeepL 도움말 페이지에 문서화되어 있습니다.
- 팀 관리자가 조직의 관리자 계정에서 서드파티 처리를 먼저 활성화해야 합니다. 그 전에는 이 언어들이 아예 작동하지 않습니다.
- 자동 감지는 작동하지 않습니다. DeepL의 표현을 그대로 옮기면, 「서드파티 언어는 Auto-detect language로는 작동하지 않습니다. Spoken language로 직접 선택해야 합니다.」
- 참가자가 각자 자기 발화 언어를 고르게 하려면, 호스트가 회의를 DeepL Voice에 연결할 때 액세스 코드를 활성화해야 합니다.
어느 것도 불합리하지는 않습니다. DeepL은 Speechmatics가 무보존 계약 아래에서 운영되며 전사 데이터는 처리가 끝나는 즉시 서버에서 삭제된다고 밝히고 있습니다. 하지만 요구 조건을 쌓아 올리면 실무적 결론이 나옵니다. DeepL이 붙은 회의에 들어간 베트남어 화자는 관리자가 체크하지 않은 설정 하나 때문에 아예 전사되지 않을 수 있고, 시스템이 자기를 알아서 알아봐 줄 거라고 기대할 수도 없습니다. 한편 데이터 보존 태도는 오늘 오전에 저희가 썼던 것과 같습니다. DeepL의 FAQ는 회의 데이터가 「메모리에서 임시로 처리되며 통화가 끝나면 삭제된다」라고 말합니다.
삼성은 언급해 둘 만한 반례입니다. 베트남어는 Galaxy AI가 처음 출시한 16개 언어 안에 들어 있었고, 삼성 R&D 인스티튜트 베트남은 2024년 5월 23일에 그게 왜 어려웠는지에 대한 보기 드물게 솔직한 기록을 공개했습니다. 베트남어에는 서로 구별되는 여섯 개의 성조가 있습니다. 이 글이 든 예는 ma, mả, má — 귀신, 무덤, 어머니 — 가 오직 성조로만 갈린다는 것입니다. 이 연구소의 ASR 리드인 부이 응옥 뚱은 「약 20밀리초」 단위의 오디오 프레임을 구별해 일련의 프레임이 어떤 단어에 속하는지 판단하는 모델을 설명했습니다. 한국의 휴대폰 제조사가 베트남어 성조 모델링에 투자하는 동안 유럽의 번역 회사는 그것을 하청으로 넘긴다면, 그건 시장이 이 언어에 매기는 값에 대해 무언가를 말해 줍니다.
음성 인식 쪽 사정은 기록 작성 쪽보다 낫습니다. Deepgram의 Nova-3 문서에는 베트남어가 vi로 나옵니다(2026년 8월 31일 확인). 음성-텍스트 지원 범위에서 「지원」이라는 말이 무엇을 감추는지 분석한 글에서 다룬 58개 언어 중 하나입니다.
어떤 벤더도 베트남어 회의 음성의 오류율을 공개하지 않는다. 코퍼스가 그 이유를 설명한다
저희는 회의 환경에서의 베트남어 전사 품질에 붙일 숫자를 찾아 나섰습니다. 그런 숫자는 없었고, 그 이유가 숫자 자체보다 더 쓸모 있었습니다.
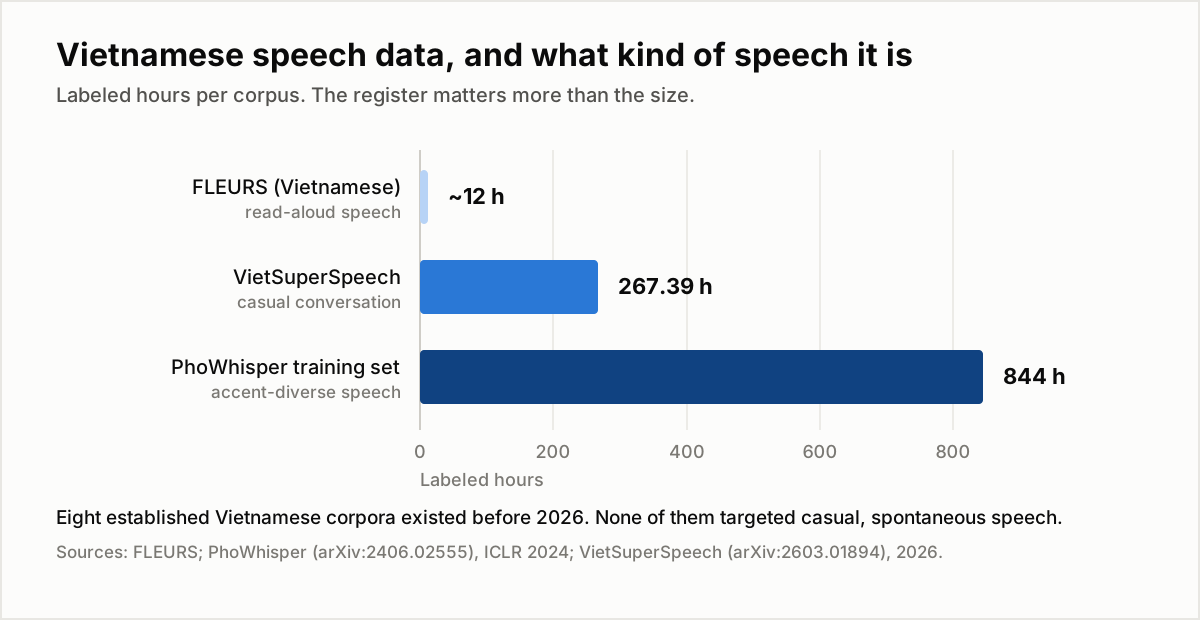
라벨링 시간이 전부는 아닙니다. 중요한 건 발화의 격식입니다. FLEURS는 낭독 음성이고, PhoWhisper의 학습 세트는 여러 억양에 걸쳐 있으며, VietSuperSpeech는 일상 대화를 겨냥해 만들어진 최초의 코퍼스입니다. 출처는 아래 목록에 날짜와 함께 정리해 두었습니다.
널리 인용되는 베트남어 벤치마크 FLEURS는 낭독 음성을 약 12시간 제공합니다. PhoWhisper는 ICLR 2024 Tiny Papers 트랙에서 발표됐으며, 억양 다양성을 기준으로 선정한 844시간 데이터셋으로 Whisper를 파인튜닝했습니다. 2025년 5월 23일 공개된 VietASR은 라벨 없는 오디오 70,000시간과 라벨링된 50시간을 사용했으며, 실제 환경 데이터에서 Whisper Large-v3와 상용 시스템보다 나은 성능을 냈다고 보고합니다.
그리고 핵심을 직접 말한 논문이 있습니다. 2026년에 공개된 VietSuperSpeech는 일상 대화체 베트남어 오디오–텍스트 쌍 52,023개, 총 267.39시간을 모았습니다. 학습 데이터는 240.67시간, 평가 데이터는 26.72시간이며 성조 부호가 완전히 표기된 문자 1,380만 자를 포함합니다. 저자들은 데이터셋이 해결하려는 간극을 이렇게 설명합니다.
「VLSP2020, VIET_BUD500, VietSpeech, FLEURS, VietMed, Sub-GigaSpeech2-Vi, viVoice, Sub-PhoAudioBook 같은 코퍼스들이 격식체 및 낭독 음성을 폭넓게 다루고 있지만, 대화형 AI 응용에 없어서는 안 될 일상적이고 즉흥적인 발화 격식을 특정해 겨냥한 코퍼스는 하나도 없다.」
이 데이터셋은 회의에서 흔한 발화 방식, 즉 끼어들기와 완곡한 표현, 베트남어 문장 속 영어 제품명, 미완성 생각을 겨냥합니다. 낭독 음성만으로는 시스템이 이런 대화를 얼마나 정확히 처리하는지 알 수 없습니다.
팀을 위한 실질적인 안전장치는 사람이 검토하고 고칠 수 있는 전사본입니다. 그러려면 선택한 회의 기능이 먼저 베트남어 전사본을 만들어야 합니다.
기록이 살아남는 베트남어–영어 회의를 진행하는 법
통화 전과 통화 중에 다음 여섯 가지를 확인하세요.
- 필요하다면 이해와 기록에 서로 다른 도구를 선택하세요. Google 번역이나 Meet 자막은 베트남어를 실시간으로 이해하는 데 쓸 수 있지만, 여기서 말하는 지속 가능한 베트남어 전사본은 어느 기능도 만들지 않습니다.
- 베트남어를 발화 언어로 명시적으로 지정하고, 자동 감지에 기대지 마세요. DeepL에서는 이게 필수입니다. 베트남어를 포함한 서드파티 언어는 자동 감지가 되지 않으니까요. 다른 곳에서도 여전히 이쪽이 낫습니다. 자동 감지는 세션 전체에서 문맥이 가장 부족한 처음 몇 초의 오디오만 듣고 추측을 확정해 버리기 때문입니다.
- 플랫폼의 언어 목록이 아니라 기록 기능의 언어 목록을 확인하세요. 이 글이 존재하는 이유인 함정은, 베트남어를 번역하는 플랫폼이 베트남어를 전사도 해 줄 거라고 가정하는 것입니다. 구글 Meet에서 69 대 8은 바로 그 두 가정 사이의 간극입니다.
- 코드 스위칭 문제를 통화 전에 미리 꺼내 놓으세요. 팀이 영어 제품명과 티켓 ID, 약어를 베트남어 문장에 섞어 쓴다면 — 그리고 모든 오프쇼어 엔지니어링 팀이 그렇게 합니다 — 기록 도구가 한 세션 안의 두 언어를 견디는지 확인하세요. Meet의 노트 작성 기능은 명시적으로 견디지 못합니다.
- 고유명사는 첫 5분 안에, 회의 중에 바로잡으세요. 베트남어 성조 부호와 영어 제품 코드명은 전사가 어김없이 무너지는 두 지점이고, 동시에 잘못된 한 줄이 그 위에 쌓이는 모든 요약에 가장 큰 피해를 주는 두 지점입니다. 회의 중에 고치면 몇 초면 끝납니다.
- 베트남어 원문과 영어 번역, 요약을 하나의 기록 안에 두세요. 세 개의 도구에 흩어진 세 개의 파일이 아니라요. 번역은 일방통행입니다. 내년에 더 좋은 모델로 베트남어에서 다시 번역할 수는 있지만, 영어에서 베트남어를 복원할 수는 결코 없습니다.
제품 사용법을 단계별로 살펴보고 싶다면, 6월에 쓴 이중언어 회의 녹음을 검토 가능한 AI 노트로 바꾸는 가이드를 참고하세요.
결론: 베트남어는 이해의 간극은 건넜지만 기록의 간극은 건너지 못했다
베트남어 지원은 실시간 자막, 통역 음성, 음성 인식으로 확대되어 팀이 대화를 따라갈 수 있는 선택지가 늘었습니다. 하지만 발표된 언어 지원이 곧 계정에서 사용할 수 있다는 뜻은 아닙니다. Meet의 Gemini 3.5 Live Translate 확장은 미리보기와 단계적 출시 상태이며, 현재 지원되는 언어 조합을 보편적으로 대체하지 않습니다. 회의 전에 필요한 기능과 계정, 베트남어 입력·출력 방향을 확인하세요.
움직이지 않은 것은 기록입니다. 오래 남는 산출물을 만들어 내는 구글의 두 기능은 둘이 합쳐 8개 언어를 지원하는데, 그것도 똑같은 8개이고, 베트남어는 어느 쪽에도 없습니다. DeepL은 베트남어로 자막을 달아 주지만, 베트남어를 받아쓰는 일은 관리자 토글 뒤에 있는 하청업체로 넘깁니다. 시장은 베트남어를 들을 가치가 있는 언어로는 인정했지만, 아직 받아 적을 가치가 있는 언어로는 인정하지 않았습니다.
그래서 벤더에게 물어야 할 질문은 베트남어를 지원하느냐가 아닙니다. 이제 거의 모두가 그렇다고 답하고, 거의 모두가 듣는 쪽 절반을 뜻합니다. 물어야 할 질문은 이겁니다. 통화가 끝난 뒤에도 베트남어를 지원하는 기능은 어느 것이고, 바로 그 기능의 언어 목록을 보여 주실 수 있습니까?
Telli.sh는 어디에 들어맞나: 기록 계층이 바로 저희가 만드는 계층입니다. Telli.sh는 회의를 실제로 말해진 언어 그대로 전사하고, 베트남어를 포함한 44개 대상 언어로 번역하며, 세 가지 산출물을 같은 노트 안에 함께 보관합니다. 베트남어 원문, 거기에 정렬된 번역, 그 위에서 생성된 요약이죠. 인터페이스 자체도 베트남어를 포함해 15개 언어로 제공되기 때문에, 다낭의 팀과 시드니의 고객이 같은 회의를 각자의 언어로 읽으면서도 수정 가능한 하나의 기록을 공유합니다.
출처
- Google Translate Help, "Hear live speech to speech translations with Live translate" (Android), 2026년 8월 31일 확인 — 베트남어를 포함한 74개 언어 목록, 네 가지 번역 모드, 마주 보기 모드, 백그라운드 유지.
- Google Translate Help, "Download languages to use offline" (Android), 2026년 8월 31일 확인 — 오프라인 언어 팩과 고품질 업그레이드.
- Google Meet Help, "Use translated captions in Google Meet", 2026년 8월 31일 확인 — 베트남어를 포함한 69개 언어 목록, 유료 Workspace 에디션, Record captions.
- Google Meet Help, "Use Transcripts with Google Meet", 2026년 8월 31일 확인 — 전사가 지원되는 8개 언어.
- Google Meet Help, "'Take notes for me' in Google Meet", 2026년 8월 31일 확인 — 똑같은 8개 언어, 그리고 한 번에 한 언어만 된다는 제약.
- Slator, "Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate", 2026년 6월 16일 — 6월 9일 발표, 70개 이상 언어, Meet가 5개 언어에서 2,000개 이상 언어 쌍으로 이동한 것, 그리고 listening mode.
- DeepL Help Center, "DeepL Voice languages", 2026년 8월 31일 확인 — DeepL이 직접 전사하는 발화 언어 18개, 베트남어를 포함한 서드파티 발화 언어 20개, 번역 언어 41개, 자동 감지 제약, 그리고 Speechmatics 무보존 계약.
- Samsung Newsroom, "The Learning Curve, Part 3: Taking AI Data From Good to Great", 2024년 5월 23일 — Galaxy AI 최초 16개 언어에 포함된 베트남어, 여섯 개의 성조, ma/mả/má 예시, 그리고 약 20ms 프레임 설명.
- Deepgram, Models & Languages Overview, 2026년 8월 31일 확인 — Nova-3 언어 목록의 베트남어(
vi). - Le, Nguyen and Nguyen, "PhoWhisper: Automatic Speech Recognition for Vietnamese", ICLR 2024 Tiny Papers — 억양 다양성을 갖춘 844시간 파인튜닝 세트.
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining", 2025년 5월 23일 — 라벨 없는 70,000시간, 라벨링된 50시간.
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset", 2026년 — 52,023개 쌍, 267.39시간, 그리고 여덟 개 코퍼스가 남긴 발화 격식의 공백.