Google tradurrà la tua riunione in vietnamita in tempo reale. Ma non ne metterà per iscritto una parola.
I sottotitoli tradotti di Google Meet coprono 69 lingue, vietnamita incluso, e la funzione Live translate di Google Translate ne copre 74. La funzione Transcripts di Meet e il suo prendi-appunti basato su Gemini supportano esattamente 8 lingue ciascuno, e il vietnamita non è in nessuna delle due liste. DeepL Voice può trascrivere il vietnamita parlato solo tramite un fornitore terzo che un amministratore deve abilitare e che non supporta il rilevamento automatico. Uno sguardo a ciò che la traduzione vocale in tempo reale offre davvero ai team vietnamiti nel 2026, e a ciò che non offre mai.
Cerca su Google la traduzione vocale in tempo reale in vietnamita e otterrai una risposta davvero buona. La funzione Live translate di Google Translate supporta 74 lingue, vietnamita compreso, sia su Android sia su iOS. Funziona con o senza auricolari, continua a lavorare quando blocchi lo schermo e offre una modalità faccia a faccia che divide il telefono a metà, così ogni interlocutore legge il proprio lato.
Funziona. Ma non è questa la parte interessante.
La parte interessante è ciò che succede sulla stessa piattaforma quattro ore dopo, quando vuoi sapere che cosa è stato deciso davvero. La funzione Transcripts di Google Meet — quella che produce un Google Doc destinato a durare — supporta esattamente otto lingue, e il vietnamita non è tra queste. Non è nemmeno tra le otto supportate da «Take notes for me» di Meet, la cui pagina di assistenza aggiunge che la funzione «supporta una lingua alla volta» e che «al momento non sono supportate più lingue parlate nella stessa riunione».
In breve
- Il vietnamita è supportato da tutte le superfici Google che ascoltano: Live translate (74 lingue), sottotitoli tradotti di Meet (69 lingue). Non è supportato da nessuna delle superfici Google che scrivono: Transcripts di Meet e il prendi-appunti Gemini di Meet, 8 lingue ciascuno.
- DeepL Voice può mostrare sottotitoli in vietnamita ma non può trascrivere il vietnamita parlato con i propri modelli: il vietnamita finisce in un livello di terze parti che un amministratore deve abilitare e che non supporta il rilevamento automatico.
- Questo articolo mappa esattamente dove si ferma il vietnamita su ogni piattaforma principale al 31 agosto 2026 e propone una procedura in sei passi per condurre una riunione vietnamita-inglese che lasci una traccia scritta.
Abbiamo formulato la versione generale di questa tesi stamattina, guardando che cosa succede quando la traduzione è eccellente ed è già sparita all'ora di cena. Questa è più specifica e, per i team vietnamiti, peggiore: il problema non è solo che gli strumenti in tempo reale dimenticano. È che le funzioni che ricordano saltano proprio il vietnamita.
Che cosa ti dà oggi davvero la «traduzione vocale in tempo reale» in vietnamita
Partiamo dai conti onesti, perché gli strumenti gratuiti di Google sono molto bravi nel lavoro per cui sono stati costruiti.
Live translate di Google Translate offre quattro modalità, secondo la pagina di assistenza per Android consultata il 31 agosto 2026: Ascolto (avvicina il telefono all'orecchio o usa gli auricolari per la traduzione in tempo reale di un'altra persona), Conversazione (le traduzioni vengono riprodotte ad alta voce e gli interlocutori si alternano), Solo testo (si legge, senza audio) e Impostazioni personalizzate. Esiste una modalità Faccia a faccia separata in cui lo schermo si divide e ciascun interlocutore vede, nella propria metà, sia la trascrizione sia la traduzione della propria lingua. Il microfono rileva automaticamente quando una lingua si ferma e comincia l'altra, così nessuno deve premere un pulsante tra una frase e l'altra.
Due dettagli meritano più credito di quanto ne ricevano di solito. Primo, la sessione sopravvive al multitasking: la documentazione di Google afferma che la traduzione «continua senza interruzioni quando cambi app, riduci a icona l'applicazione o quando lo schermo si blocca». Secondo, il vietnamita si può scaricare per l'uso offline, e i pacchetti scaricati possono essere aggiornati a una versione di qualità superiore dalla stessa schermata: cosa che conta in un Paese dove un sopralluogo in cantiere o un reparto di fabbrica non sono ambienti a connettività garantita.
Vale la pena dire con chiarezza un limite, perché coglie di sorpresa: questa è una funzione da telefono. La pagina di assistenza di Google per la versione web dice, in una sola frase: «Non puoi parlare e tradurre allo stesso tempo su Google Translate per il web». Se la tua riunione bilingue avviene su un portatile, Live translate non è nella stanza.
Ecco il punto: per una conversazione — un taxi, la visita a un fornitore, due parole in corridoio con un cliente di passaggio — questo è quasi un problema risolto, non costa nulla e lo consiglieremmo senza esitazione. Il fallimento non è nella conversazione. È nella riunione.
Gemini 3.5 Live Translate porta Meet da cinque lingue a più di settanta
Anche il quadro si muove in fretta, e si muove a favore di chi parla vietnamita.
Il 9 giugno 2026 Google ha annunciato Gemini 3.5 Live Translate, un modello di traduzione da voce a voce che copre più di 70 lingue. Come ha riportato Slator il 16 giugno 2026, viene distribuito tramite la Gemini Live API e Google AI Studio in anteprima pubblica, entra in anteprima privata in Google Meet per alcuni clienti Workspace e arriva a livello globale dentro l'app mobile di Google Translate su Android e iOS.
Il numero che conta per Meet è il confronto prima-dopo. La traduzione vocale in Meet era limitata a cinque lingue supportate, con traduzione solo da e verso l'inglese. Gemini 3.5 Live Translate porta il conto a più di 70 lingue e oltre 2.000 combinazioni di coppie linguistiche, con una disponibilità più ampia prevista nel corso del 2026. Per un team vietnamita, un sistema a cinque lingue imperniato sull'inglese era di fatto nessun sistema; 2.000 coppie sono un altro prodotto.
Google sta posizionando il modello in modo stretto, ed è un buon segno più che un cattivo segno. Secondo Slator, la documentazione contrappone Live Translate alle più ampie capacità Live Agent di Gemini: funziona come una pipeline di traduzione in tempo reale, accetta input solo audio e omette deliberatamente le chiamate di funzione, il grounding sulla ricerca, gli strumenti e le istruzioni di sistema. È un interprete, non un assistente: la stessa distinzione tracciata da OpenAI nel descrivere GPT-Realtime-Translate. Google ha anche aggiunto una «modalità ascolto» su Android che invia l'audio tradotto attraverso l'altoparlante auricolare, così puoi seguire una traduzione senza indossare auricolari visibili in riunione.
Quindi il livello in tempo reale per il vietnamita sta migliorando rapidamente e su più fronti insieme. Ora l'altra domanda.
La linea della traccia scritta: dove si ferma il vietnamita
Ogni piattaforma ha una linea. Da un lato ci sono le funzioni che ti aiutano a capire il parlato mentre accade. Dall'altro ci sono le funzioni che trasformano il parlato in qualcosa che avrai ancora la settimana prossima. Chiamiamola la linea della traccia scritta: e per il vietnamita è esattamente il punto in cui il supporto scompare.
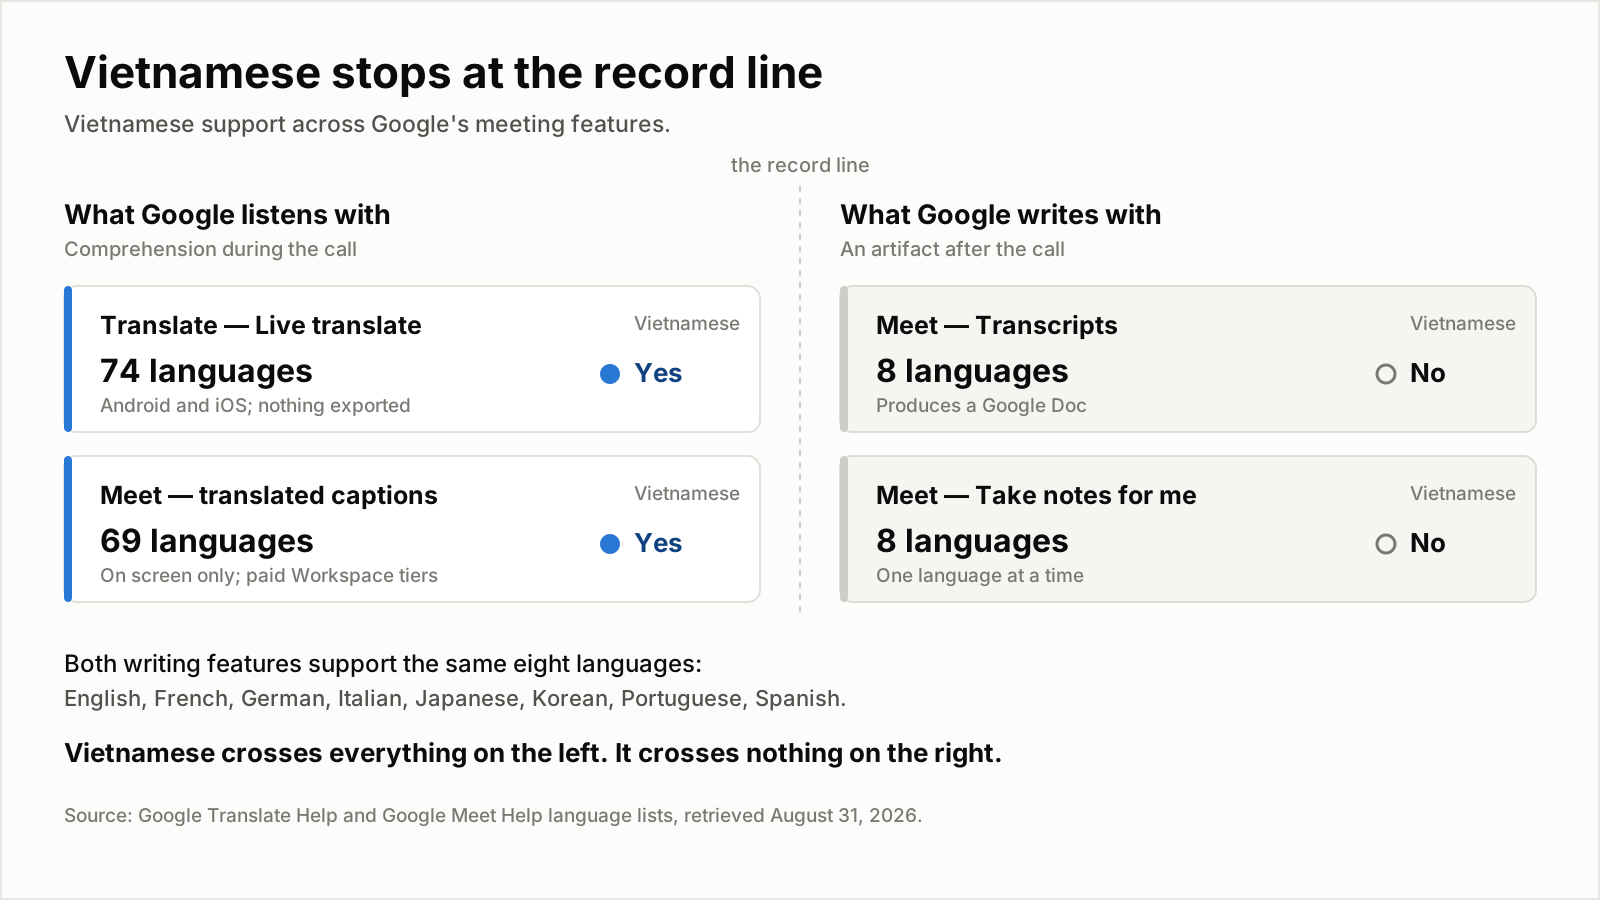
I conteggi delle lingue sono di Google stessa, tratti da quattro pagine di assistenza consultate il 31 agosto 2026. Il vietnamita compare in entrambe le funzioni di ascolto e in nessuna funzione di scrittura.
Ecco le stesse informazioni in forma di tabella, perché l'asimmetria è più facile da contestare quando è allineata.
| Funzione Google | Vietnamita supportato? | Lingue | Lascia qualcosa dopo la chiamata? |
|---|---|---|---|
| Google Translate — Live translate | Sì | 74 | No |
| Google Meet — sottotitoli tradotti | Sì | 69 | Solo a schermo; incorporati nel video se attivi Record captions |
| Google Meet — Transcripts | No | 8 | Sì, un Google Doc |
| Google Meet — «Take notes for me» | No | 8, una alla volta | Sì, note su Google Docs più un riepilogo via email |
| Google Meet — Gemini 3.5 Live Translate | In distribuzione | 5 oggi, oltre 70 in anteprima privata | Non indicato |
Tutte le righe provengono dalle pagine di assistenza di Google e dal report di Slator del 16 giugno 2026, consultati il 31 agosto 2026.
Le otto lingue condivise da Transcripts e «Take notes for me» sono identiche: inglese, francese, tedesco, italiano, giapponese, coreano, portoghese e spagnolo. È la stessa lista due volte, ed è una lista di grandi mercati europei e dell'Asia orientale. Il vietnamita — circa 97 milioni di parlanti, secondo il conteggio della stessa Samsung nel suo articolo del 2024 su questo lavoro — ne resta fuori, insieme a thailandese, indonesiano, hindi e arabo.
C'è un altro vincolo che colpisce in modo specifico i team bilingui, e vale anche per i team che lavorano interamente in lingue supportate. La pagina di assistenza di Google per «Take notes for me» afferma che la funzione supporta una lingua alla volta e che al momento non sono supportate più lingue parlate nella stessa riunione. Una call Vietnam-Stati Uniti che alterna vietnamita e inglese è squalificata due volte: una per il vietnamita e una per l'alternanza.
Per essere corretti con Google: i sottotitoli tradotti hanno effettivamente una via di persistenza. Se registri la riunione e selezioni Record captions, i sottotitoli vengono incorporati nel video. E durante la sessione puoi scorrere indietro nei sottotitoli tradotti. Ma dei sottotitoli impressi in un file video non sono una traccia consultabile: non puoi cercare dentro un pixel, non puoi correggere un nome e non puoi generarne un riepilogo. I sottotitoli tradotti in Meet sono inoltre riservati alle edizioni Workspace a pagamento: Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter (disponibile fino al 30 giugno 2025) e Google AI Pro for Education.
DeepL ti mostrerà sottotitoli in vietnamita. Trascrivere il vietnamita parlato è un altro livello.
DeepL Voice è la migliore alternativa occidentale, e la sua storia con il vietnamita è la più istruttiva di tutto l'articolo, perché DeepL documenta la distinzione meglio di chiunque altro.
DeepL divide il supporto linguistico in due elenchi. Le lingue parlate sono quelle che il riconoscitore accetta. Le lingue di traduzione sono quelle in cui i sottotitoli possono essere mostrati. Il vietnamita compare nell'elenco di traduzione, che arriva a 41 lingue. Ora guarda l'altro lato: i modelli di DeepL trascrivono 18 lingue parlate — cinese (mandarino), ceco, olandese, inglese, francese, tedesco, indonesiano, italiano, giapponese, coreano, polacco, portoghese, rumeno, russo, spagnolo, svedese, turco e ucraino. Il vietnamita non è tra queste.
Il vietnamita è disponibile come lingua parlata, ma solo in un secondo livello di 20 lingue trascritte da un fornitore terzo, Speechmatics. Con tre condizioni annesse, tutte documentate nella pagina di assistenza di DeepL consultata il 31 agosto 2026:
- Un amministratore del team deve abilitare l'elaborazione da parte di terzi nell'account di amministrazione dell'organizzazione prima che una qualsiasi di queste lingue funzioni.
- Il rilevamento automatico non funziona. Nelle parole di DeepL: «Le lingue di terze parti non funzionano con il rilevamento automatico della lingua: devono essere selezionate manualmente come lingua parlata».
- Perché i partecipanti possano scegliere la propria lingua parlata, l'organizzatore deve abilitare un codice di accesso al momento di collegare la riunione a DeepL Voice.
Niente di tutto ciò è irragionevole — DeepL precisa che Speechmatics opera con un accordo di retention zero, quindi i dati di trascrizione vengono eliminati dai loro server una volta elaborati. Ma somma i requisiti e ottieni il risultato pratico: chi parla vietnamita ed entra in una riunione dotata di DeepL è a una casella di amministrazione non spuntata dal non essere trascritto affatto, e non può contare sul fatto che il sistema se ne accorga da solo. Nel frattempo la politica di conservazione è la stessa di cui abbiamo scritto stamattina: le FAQ di DeepL dicono che i dati della riunione sono «elaborati temporaneamente in memoria ed eliminati al termine della chiamata».
Samsung è il controesempio che vale la pena citare. Il vietnamita è stato tra le prime 16 lingue rilasciate da Galaxy AI, e il Samsung R&D Institute Vietnam ha pubblicato il 23 maggio 2024 un resoconto insolitamente franco del perché sia stato difficile. Il vietnamita ha sei toni distinti; l'esempio dell'articolo è che ma, mả e má — fantasma, tomba e madre — differiscono solo per il tono. Bui Ngoc Tung, responsabile ASR dell'istituto, ha descritto un modello che distingue frame audio di «circa 20 millisecondi» per decidere a quale parola appartiene una sequenza di frame. Quando un produttore coreano di smartphone investe nella modellazione tonale del vietnamita e un'azienda europea di traduzione la gira a un subappaltatore, questo ti dice qualcosa su quanto il mercato prezzi questa lingua.
Sul lato dell'offerta di riconoscimento vocale il quadro è migliore rispetto a quello degli appunti automatici: Nova-3 di Deepgram elenca il vietnamita come vi nella sua documentazione su modelli e lingue, consultata il 31 agosto 2026 — una delle 58 lingue che abbiamo contato nella nostra analisi di ciò che la parola «supportato» nasconde nella copertura speech-to-text.
Nessun fornitore pubblica un tasso di errore per il vietnamita in riunione, e i corpora spiegano perché
Siamo andati a cercare un numero da dare alla qualità della trascrizione del vietnamita nelle riunioni. Non esiste, e il motivo è più utile di quanto sarebbe stato il numero.
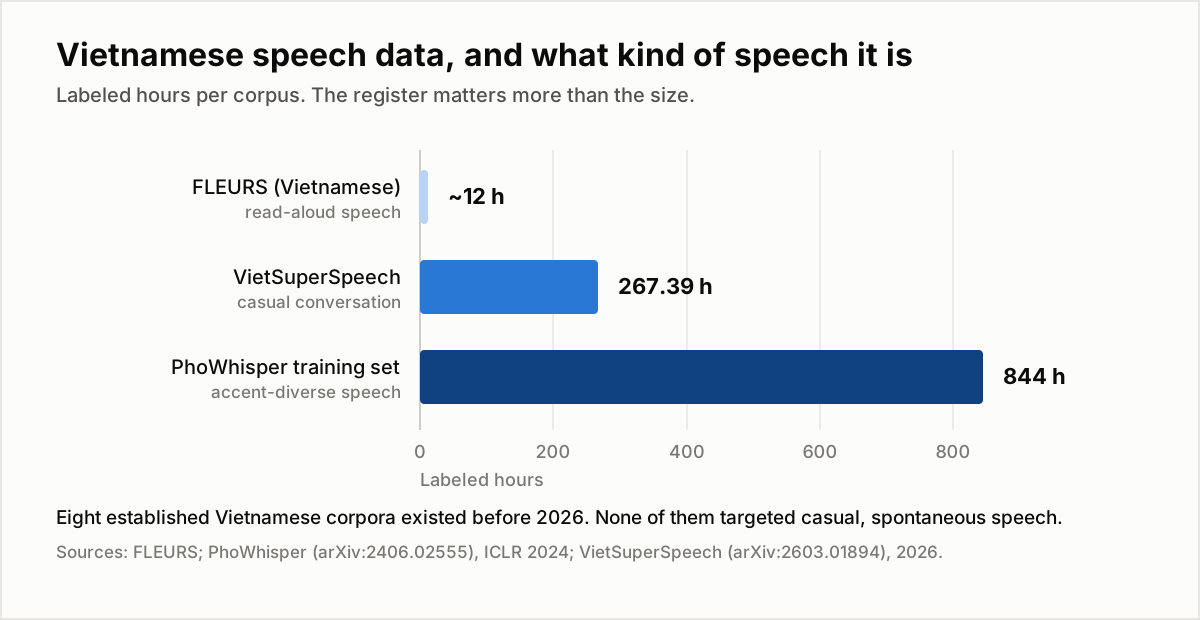
Le ore etichettate non sono tutta la storia: lo è il registro. FLEURS è parlato letto; il set di addestramento di PhoWhisper copre più accenti; VietSuperSpeech è il primo corpus costruito specificamente per la conversazione informale. Le fonti sono datate nell'elenco qui sotto.
Il benchmark che tutti citano per il vietnamita è FLEURS, che fornisce circa 12 ore di parlato letto ad alta voce per lingua. Il parlato letto non è il parlato di una riunione. PhoWhisper, presentato nel track Tiny Papers di ICLR 2024, ha effettuato il fine-tuning di Whisper su un dataset vietnamita di 844 ore scelto per la diversità degli accenti, ed è un passo concreto verso il realismo. VietASR, pubblicato il 23 maggio 2025, ha preso un'altra strada — pre-addestramento su 70.000 ore di audio non etichettato e fine-tuning su appena 50 ore etichettate — e dichiara di superare Whisper Large-v3 e i sistemi commerciali su dati reali.
Poi c'è il paper che dice ad alta voce quello che nessuno dice. VietSuperSpeech, rilasciato nel 2026, raccoglie 52.023 coppie audio-testo per un totale di 267,39 ore di vietnamita conversazionale informale, suddivise in 240,67 ore di addestramento e 26,72 ore di valutazione, per 13,8 milioni di caratteri completamente diacritizzati. La motivazione dichiarata è la frase da citare:
«Sebbene corpora come VLSP2020, VIET_BUD500, VietSpeech, FLEURS, VietMed, Sub-GigaSpeech2-Vi, viVoice e Sub-PhoAudioBook offrano un'ampia copertura del parlato formale e letto, nessuno prende specificamente di mira il registro informale e spontaneo indispensabile per le applicazioni di IA conversazionale.»
Otto corpora vietnamiti con un nome proprio e, fino a questo, nemmeno uno costruito per il modo in cui le persone parlano davvero in riunione: interrompendo, prendendo tempo, passando all'inglese per il nome del prodotto, lasciando le frasi a metà. Qualunque cifra di accuratezza un fornitore ti citi per il vietnamita è stata quasi certamente misurata su qualcuno che leggeva un copione.
La conseguenza operativa è semplice ed è sempre la stessa a cui arriviamo. Se non puoi verificare quanto sarà accurata la trascrizione della tua riunione, l'unica difesa è una trascrizione che una persona possa leggere e correggere. Il che richiede che una trascrizione esista, prima di tutto.
Come condurre una riunione vietnamita-inglese in modo che la traccia scritta sopravviva
Sei passi, nell'ordine in cui accadono. Ognuno affronta un guasto specifico documentato sopra.
- Decidi quale strumento si occupa della comprensione e quale della traccia scritta, e accetta che siano strumenti diversi. Questo è tutto l'articolo in una riga. Google Translate o i sottotitoli di Meet possono occuparsi oggi del primo compito per il vietnamita. Nessuno dei due si occupa del secondo.
- Imposta il vietnamita come lingua parlata in modo esplicito; non affidarti al rilevamento automatico. Su DeepL è obbligatorio: le lingue di terze parti, vietnamita incluso, non possono essere rilevate automaticamente. Ovunque altro resta comunque la scelta migliore, perché il rilevamento automatico si impegna in una supposizione nei primi secondi, sull'audio meno contestuale dell'intera sessione.
- Controlla l'elenco delle lingue della funzione che produce la traccia, non quello della piattaforma. La trappola che questo articolo esiste per descrivere è dare per scontato che una piattaforma che traduce il vietnamita lo trascriva anche. In Google Meet, 69 contro 8 è la distanza tra queste due supposizioni.
- Metti sul tavolo il problema del code-switching prima della call. Se il tuo team infila nomi di prodotto in inglese, ID di ticket e acronimi dentro frasi vietnamite — e ogni team di ingegneria offshore lo fa — verifica che lo strumento che produce la traccia tolleri due lingue in una sola sessione. Il prendi-appunti di Meet esplicitamente non lo fa.
- Correggi i nomi propri nei primi cinque minuti, dal vivo. I diacritici vietnamiti e i nomi in codice inglesi dei prodotti sono i due punti in cui la trascrizione si rompe con regolarità, e sono anche i due punti in cui una riga sbagliata fa più danni a qualsiasi riepilogo costruito sopra. Correggere durante la riunione costa pochi secondi.
- Tieni il testo originale vietnamita, la traduzione inglese e il riepilogo in un'unica traccia. Non tre file in tre strumenti. La traduzione è a senso unico: l'anno prossimo potrai ritradurre dal vietnamita con un modello migliore, ma non potrai mai recuperare il vietnamita dall'inglese.
Se quello che cerchi è il percorso guidato passo passo nel prodotto e non l'analisi di mercato, la nostra guida di giugno per i team vietnamiti spiega dall'inizio alla fine come trasformare la registrazione di una riunione bilingue in una nota AI rivedibile.
In conclusione: il vietnamita ha superato il divario della comprensione, non quello della traccia scritta
Per gran parte dell'ultimo decennio, la lamentela sul vietnamita nelle riunioni internazionali era che la tecnologia non lo capiva abbastanza bene. Nel 2026 quella lamentela è in larga parte scaduta. Tra le 74 lingue di Live translate, le 69 dei sottotitoli tradotti di Meet, le oltre 2.000 coppie linguistiche in arrivo su Meet tramite Gemini 3.5 Live Translate, il vietnamita in Nova-3 e Samsung che offre interpretazione vietnamita on-device dal 2024, la comprensione è risolta.
Ciò che non si è mosso è la traccia scritta. Le due funzioni di Google che producono un artefatto duraturo supportano otto lingue in tutto, le stesse otto, e il vietnamita non è in nessuna delle due. DeepL sottotitolerà in vietnamita ma indirizza la sua trascrizione a un subappaltatore dietro un interruttore da amministratore. Il mercato ha deciso che il vietnamita è una lingua che vale la pena ascoltare e non ancora una lingua che valga la pena mettere per iscritto.
Quindi la domanda da fare a un fornitore non è se supporta il vietnamita. Ormai lo dicono quasi tutti, e quasi tutti intendono la metà che ascolta. La domanda è: quali delle vostre funzioni supportano il vietnamita dopo la fine della call, e potete mostrarmi l'elenco delle lingue di quella specifica funzione?
Dove si colloca Telli.sh: il livello della traccia scritta è il livello che costruiamo noi. Telli.sh trascrive la riunione nella lingua in cui è stata effettivamente parlata, traduce in 44 lingue di destinazione tra cui il vietnamita e tiene tutti e tre gli artefatti nella stessa nota: il testo originale vietnamita, la traduzione allineata ad esso e il riepilogo generato sopra. L'interfaccia stessa è disponibile in 15 lingue, vietnamita incluso, così un team a Da Nang e un cliente a Sydney leggono la stessa riunione nella propria lingua e continuano a condividere un'unica traccia correggibile.
Avvia una nota di riunione tradotta in tempo reale
Fonti
- Assistenza di Google Translate, "Hear live speech to speech translations with Live translate" (Android), consultata il 31 agosto 2026 — l'elenco di 74 lingue con il vietnamita, le quattro modalità di traduzione, la modalità faccia a faccia e la continuazione in background.
- Assistenza di Google Translate, "Download languages to use offline" (Android), consultata il 31 agosto 2026 — i pacchetti offline e gli aggiornamenti a qualità superiore.
- Assistenza di Google Meet, "Use translated captions in Google Meet", consultata il 31 agosto 2026 — l'elenco di 69 lingue con il vietnamita, le edizioni Workspace a pagamento e Record captions.
- Assistenza di Google Meet, "Use Transcripts with Google Meet", consultata il 31 agosto 2026 — le otto lingue supportate per le trascrizioni.
- Assistenza di Google Meet, "'Take notes for me' in Google Meet", consultata il 31 agosto 2026 — le stesse otto lingue e il limite di una lingua alla volta.
- Slator, "Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate", 16 giugno 2026 — l'annuncio del 9 giugno, oltre 70 lingue, il passaggio di Meet da cinque lingue a più di 2.000 coppie e la modalità ascolto.
- Centro assistenza DeepL, "DeepL Voice languages", consultato il 31 agosto 2026 — le 18 lingue parlate trascritte da DeepL, le 20 lingue parlate di terze parti tra cui il vietnamita, le 41 lingue di traduzione, la restrizione sul rilevamento automatico e l'accordo di retention zero con Speechmatics.
- Samsung Newsroom, "The Learning Curve, Part 3: Taking AI Data From Good to Great", 23 maggio 2024 — il vietnamita tra le prime 16 lingue di Galaxy AI, i sei toni, l'esempio ma/mả/má e la descrizione dei frame da circa 20 ms.
- Deepgram, Models & Languages Overview, consultata il 31 agosto 2026 — il vietnamita (
vi) nell'elenco delle lingue di Nova-3. - Le, Nguyen e Nguyen, "PhoWhisper: Automatic Speech Recognition for Vietnamese", ICLR 2024 Tiny Papers — il set di fine-tuning di 844 ore con accenti diversificati.
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining", 23 maggio 2025 — 70.000 ore non etichettate, 50 ore etichettate.
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset", 2026 — 52.023 coppie, 267,39 ore e il vuoto di registro negli otto corpora.