Google traduira votre réunion en vietnamien en temps réel. Il n'en écrira pas un mot.
Les sous-titres traduits de Google Meet couvrent 69 langues, dont le vietnamien, et Live translate de Google Translate en couvre 74. La fonction Transcripts de Meet et son preneur de notes Gemini prennent en charge exactement 8 langues chacun, et le vietnamien ne figure ni dans l'une ni dans l'autre. DeepL Voice ne peut transcrire le vietnamien parlé que via un prestataire tiers, qu'un administrateur doit activer et qui interdit la détection automatique. Voici ce que la traduction vocale en direct apporte réellement aux équipes vietnamiennes en 2026 — et ce qu'elle ne leur apporte jamais.
Cherchez « traduction vocale en direct » en vietnamien sur Google et vous tombez sur une réponse franchement bonne. Live translate, dans Google Translate, prend en charge 74 langues, dont le vietnamien, sur Android comme sur iOS. La fonction marche avec ou sans écouteurs, continue quand l'écran se verrouille, et propose un mode face à face qui coupe le téléphone en deux pour que chaque locuteur lise son propre côté.
Ça marche. Ce n'est pas le plus intéressant.
Le plus intéressant arrive quatre heures plus tard, sur la même plateforme, quand vous voulez savoir ce qui a réellement été décidé. La fonction Transcripts de Google Meet — celle qui produit un Google Doc durable — prend en charge exactement huit langues, et le vietnamien n'en fait pas partie. Il ne fait pas non plus partie des huit langues de « Take notes for me » dans Meet, dont la page d'aide précise que la fonction « ne prend en charge qu'une langue à la fois » et que « plusieurs langues parlées dans une même réunion ne sont pas prises en charge actuellement ».
TL;DR
- Le vietnamien est pris en charge par toutes les surfaces Google qui écoutent : Live translate (74 langues), sous-titres traduits de Meet (69 langues). Il n'est pris en charge par aucune surface Google qui écrit : Meet Transcripts et le preneur de notes Gemini de Meet, 8 langues chacun.
- DeepL Voice peut afficher des sous-titres en vietnamien mais ne peut pas transcrire le vietnamien parlé avec ses propres modèles — le vietnamien relève d'un niveau tiers qu'un administrateur doit activer et qui exclut la détection automatique.
- La comparaison ci-dessous montre où le vietnamien est pris en charge sur chaque grande plateforme au 31 août 2026, puis présente six étapes pour mener une réunion vietnamien-anglais qui laisse une trace.
Le même problème touche d'autres langues, comme nous l'expliquons dans notre aperçu de la traduction qui disparaît après la conversation. Pour les équipes vietnamiennes, le problème est plus aigu : les fonctions conçues pour conserver une trace de la réunion n'incluent pas le vietnamien.
Ce que la « traduction vocale en direct » apporte réellement en vietnamien aujourd'hui
Commençons par un bilan honnête, car les outils gratuits de Google font très bien le travail pour lequel ils ont été conçus.
Live translate, dans Google Translate, propose quatre modes, d'après sa page d'aide Android consultée le 31 août 2026 : Listening (portez le téléphone à l'oreille ou utilisez des écouteurs pour traduire quelqu'un en temps réel), Conversation (les traductions sont lues à voix haute, les locuteurs parlent à tour de rôle), Text only (lecture seule, sans audio) et Custom settings. Il existe en outre un mode Face to face où l'écran se divise et où chaque locuteur voit, sur sa moitié, la transcription et la traduction de sa propre langue. Le micro détecte automatiquement le moment où une langue s'arrête et où l'autre commence, donc personne n'appuie sur un bouton entre deux phrases.
Deux détails méritent plus de crédit qu'on ne leur en donne d'ordinaire. D'abord, la session survit au multitâche : la documentation de Google indique que la traduction « se poursuit sans interruption lorsque vous changez d'application, réduisez l'application ou lorsque l'écran se verrouille ». Ensuite, le vietnamien se télécharge pour un usage hors ligne, et les packs téléchargés peuvent être mis à niveau vers une version de meilleure qualité depuis le même écran — ce qui compte dans un pays où une visite de site ou un atelier d'usine ne garantit pas la connectivité.
Une limite mérite d'être dite clairement, parce qu'elle surprend : c'est une fonction de téléphone. La page d'aide de Google pour la version web le dit en une phrase : « Vous ne pouvez pas parler et traduire en même temps sur Google Translate pour le web. » Si votre réunion bilingue se tient sur un ordinateur portable, Live translate n'est pas dans la pièce.
Pour un trajet en taxi, une visite chez un fournisseur ou une conversation dans un couloir avec un client de passage, Live translate est une option gratuite efficace. Le problème apparaît quand une réunion doit laisser une trace durable et consultable après la conversation.
Gemini 3.5 Live Translate fait passer Meet de cinq langues à plus de soixante-dix
La prise en charge de la traduction en direct par Google s'étend au-delà des fonctions téléphoniques et des sous-titres disponibles à la date de cet article.
Le 9 juin 2026, Google a annoncé Gemini 3.5 Live Translate, un modèle de traduction voix-à-voix couvrant plus de 70 langues. Comme l'a rapporté Slator le 16 juin 2026, il est déployé via l'API Gemini Live et Google AI Studio en préversion publique, entre en préversion privée dans Google Meet pour certains clients Workspace, et arrive mondialement dans l'application mobile Google Translate sur Android et iOS.
Le chiffre qui compte pour Meet, c'est l'avant-après. La traduction vocale dans Meet se limitait à cinq langues prises en charge, avec traduction uniquement depuis et vers l'anglais. Gemini 3.5 Live Translate porte cela à plus de 70 langues et plus de 2 000 combinaisons de paires de langues, avec une disponibilité élargie prévue plus tard en 2026. Pour une équipe vietnamienne, un système à cinq langues pivotant par l'anglais n'était pas un système ; 2 000 paires, c'est un autre produit.
Google positionne le modèle de façon étroite, et c'est plutôt bon signe. Selon Slator, la documentation oppose Live Translate aux capacités plus larges de Live Agent de Gemini : il fonctionne comme un pipeline de traduction en temps réel, n'accepte que de l'audio en entrée, et omet délibérément l'appel de fonctions, l'ancrage sur la recherche, les outils et les instructions système. C'est un interprète, pas un assistant — la même distinction qu'OpenAI a tracée en décrivant GPT-Realtime-Translate. Google a aussi ajouté sur Android un « mode d'écoute » qui diffuse l'audio traduit par l'écouteur, pour suivre une traduction sans porter d'écouteurs visibles en réunion.
La couche « direct » pour le vietnamien s'améliore donc vite et sur plusieurs fronts à la fois. Passons à l'autre question.
La ligne de la trace : où s'arrête le vietnamien
Chaque plateforme a une ligne. D'un côté, les fonctions qui vous aident à comprendre la parole au moment où elle se produit. De l'autre, celles qui transforment la parole en quelque chose que vous aurez encore la semaine prochaine. Appelons-la la ligne de la trace — et pour le vietnamien, c'est exactement là que la prise en charge disparaît.
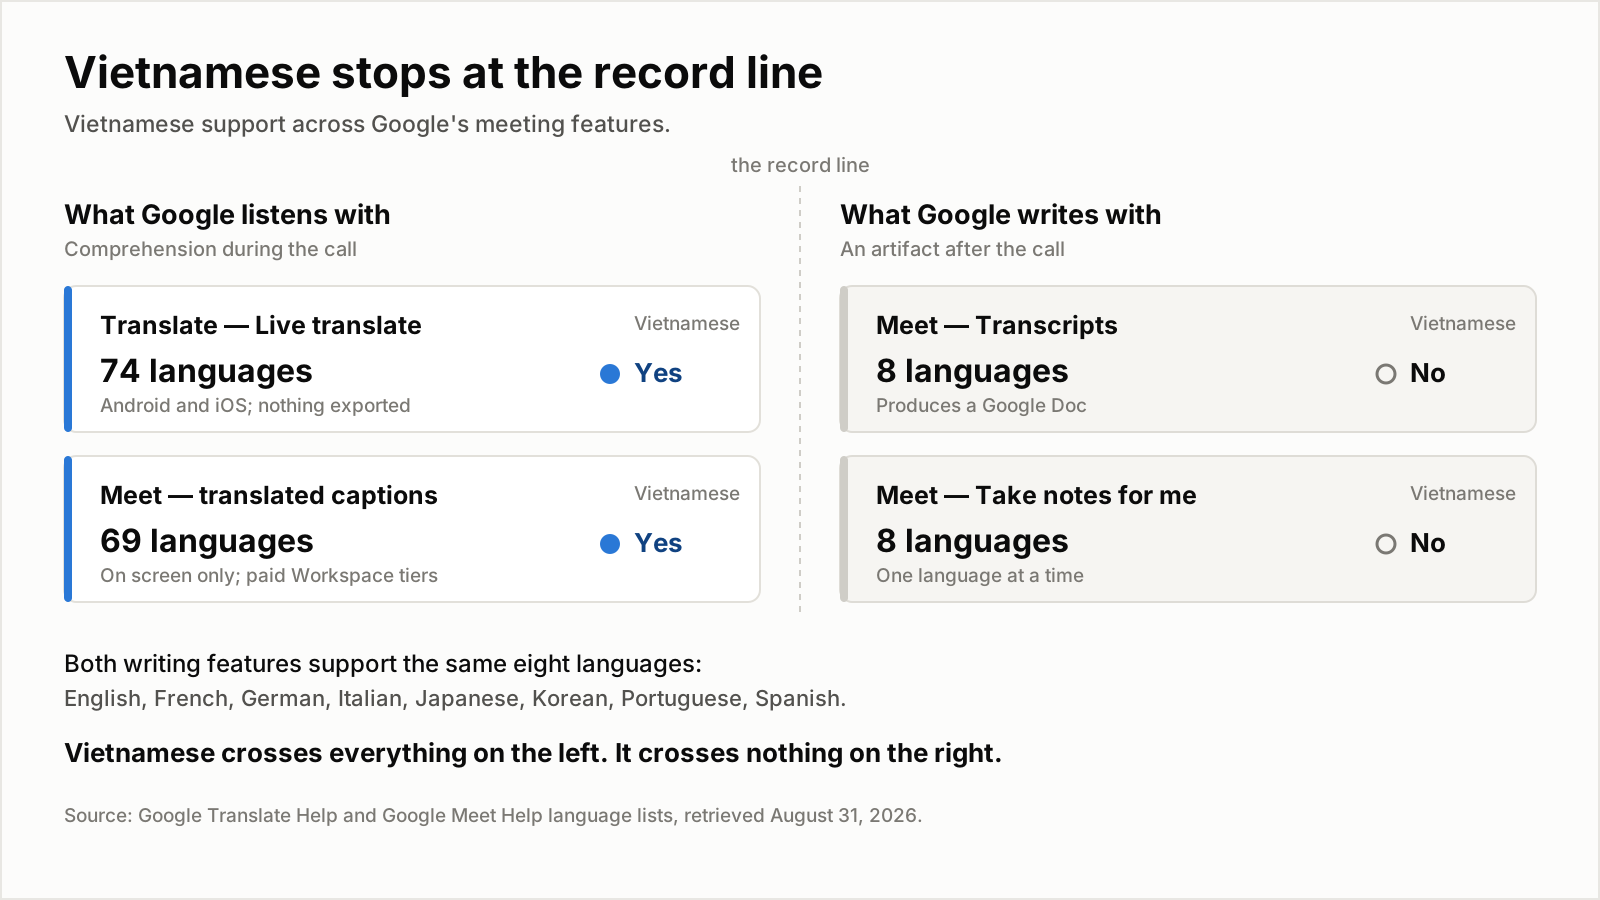
Les décomptes de langues viennent de Google, extraits de quatre pages d'aide consultées le 31 août 2026. Le vietnamien figure dans les deux fonctions d'écoute et dans aucune fonction d'écriture.
La comparaison fonction par fonction rend cette limite claire :
| Fonction Google | Vietnamien pris en charge ? | Langues | Laisse une trace après l'appel ? |
|---|---|---|---|
| Google Translate — Live translate | Oui | 74 | Non |
| Google Meet — sous-titres traduits | Oui | 69 | À l'écran seulement ; incrustés dans la vidéo si vous enregistrez les sous-titres |
| Google Meet — Transcripts | Non | 8 | Oui, un Google Doc |
| Google Meet — « Take notes for me » | Non | 8, une à la fois | Oui, des notes dans Google Docs plus un récapitulatif par e-mail |
| Google Meet — Gemini 3.5 Live Translate | En cours de déploiement | 5 aujourd'hui, 70+ en préversion privée | Non précisé |
Toutes les lignes proviennent des pages d'aide Google et du rapport Slator du 16 juin 2026, consultés le 31 août 2026.
Les huit langues communes à Transcripts et à « Take notes for me » sont identiques : anglais, français, allemand, italien, japonais, coréen, portugais et espagnol. C'est deux fois la même liste, et c'est une liste de grands marchés européens et est-asiatiques. Le vietnamien — environ 97 millions de locuteurs, selon le décompte de Samsung dans son article de 2024 — en est exclu, aux côtés du thaï, de l'indonésien, du hindi et de l'arabe.
Une contrainte de plus frappe spécifiquement les équipes bilingues, et elle s'applique même aux équipes travaillant entièrement dans des langues prises en charge. La page d'aide de Google sur « Take notes for me » indique que la fonction ne prend en charge qu'une langue à la fois et que plusieurs langues parlées dans une même réunion ne sont pas prises en charge actuellement. Un appel Vietnam-États-Unis qui alterne entre vietnamien et anglais est disqualifié deux fois : une fois pour le vietnamien, une fois pour l'alternance.
Les sous-titres traduits de Meet offrent une possibilité limitée de conservation : sélectionnez Record captions pour les intégrer à l'enregistrement ; vous pouvez aussi les revoir pendant la session. Toutefois, des sous-titres incrustés dans une vidéo ne constituent pas une transcription consultable et modifiable, et ne fournissent pas de texte à résumer. Les sous-titres traduits de Meet sont réservés aux éditions Workspace payantes : Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter (disponible jusqu'au 30 juin 2025) et Google AI Pro for Education.
DeepL vous affichera des sous-titres en vietnamien. Transcrire le vietnamien parlé relève d'un autre niveau.
DeepL Voice propose une autre option, mais sa documentation distingue la langue utilisée pour la reconnaissance vocale de celle affichée dans les sous-titres.
DeepL scinde la prise en charge des langues en deux listes. Les langues parlées sont celles que le moteur de reconnaissance accepte. Les langues de traduction sont celles dans lesquelles les sous-titres peuvent s'afficher. Le vietnamien figure dans la liste de traduction, qui compte 41 langues. Regardez maintenant l'autre côté : les modèles propres de DeepL transcrivent 18 langues parlées — chinois (mandarin), tchèque, néerlandais, anglais, français, allemand, indonésien, italien, japonais, coréen, polonais, portugais, roumain, russe, espagnol, suédois, turc et ukrainien. Le vietnamien n'en fait pas partie.
Le vietnamien est disponible comme langue parlée, mais seulement dans un second niveau de 20 langues transcrites par un prestataire tiers, Speechmatics. Trois conditions s'y attachent, toutes documentées sur la page d'aide de DeepL consultée le 31 août 2026 :
- Un administrateur d'équipe doit activer le traitement par un tiers dans le compte d'administration de l'organisation avant que l'une de ces langues ne fonctionne.
- La détection automatique ne fonctionne pas. Selon les mots de DeepL : « Les langues tierces ne fonctionnent pas avec Auto-detect language — elles doivent être sélectionnées manuellement comme Spoken language. »
- Pour laisser les participants choisir leur propre langue parlée, l'hôte doit activer un code d'accès au moment de connecter la réunion à DeepL Voice.
Rien de tout cela n'est déraisonnable — DeepL précise que Speechmatics opère sous un accord de rétention zéro, les données de transcription étant supprimées de leurs serveurs une fois traitées. Mais empilez les exigences et vous obtenez le résultat pratique : un locuteur vietnamien qui rejoint une réunion équipée de DeepL est à un réglage d'administration non coché de ne pas être transcrit du tout, et il ne peut pas compter sur le système pour le repérer automatiquement. Quant à la politique de conservation, c'est la même que celle dont nous parlions ce matin — la FAQ de DeepL indique que les données de réunion sont « traitées temporairement en mémoire et supprimées à la fin de l'appel ».
Samsung est le contre-exemple qu'il faut citer. Le vietnamien figurait parmi les 16 premières langues livrées par Galaxy AI, et Samsung R&D Institute Vietnam a publié le 23 mai 2024 un récit d'une franchise inhabituelle sur la difficulté de l'exercice. Le vietnamien compte six tons distincts ; l'exemple de l'article est que ma, mả et má — fantôme, tombe et mère — ne diffèrent que par le ton. Bui Ngoc Tung, responsable ASR de l'institut, décrit un modèle qui distingue des trames audio d'« environ 20 millisecondes » pour décider à quel mot appartient une série de trames. Quand un fabricant coréen de téléphones investit dans la modélisation tonale du vietnamien pendant qu'une société de traduction européenne la sous-traite, cela en dit long sur le prix que le marché attribue à cette langue.
Du côté de la reconnaissance vocale, la documentation de Nova-3 de Deepgram liste le vietnamien sous le code vi (consultée le 31 août 2026). C'est l'une des 58 langues évoquées dans notre analyse de ce que « pris en charge » dissimule en matière de couverture speech-to-text.
Aucun fournisseur ne publie de taux d'erreur sur le vietnamien en réunion, et les corpus expliquent pourquoi
Les scores de reconnaissance vocale publiés ne permettent pas encore aux équipes de savoir comment la transcription du vietnamien se comportera dans des réunions spontanées ; les corpus disponibles aident à comprendre cet écart.
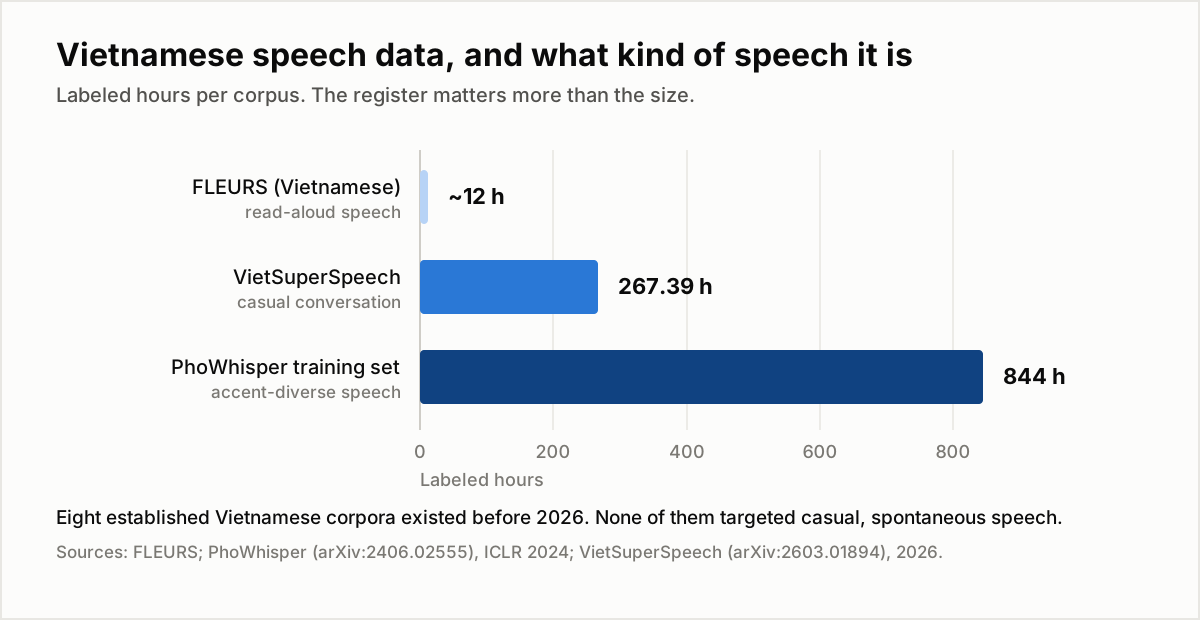
Les heures annotées ne racontent pas tout — le registre, si. FLEURS, c'est de la parole lue ; le corpus d'entraînement de PhoWhisper couvre plusieurs accents ; VietSuperSpeech est le premier corpus bâti spécifiquement pour la conversation informelle. Sources datées dans la liste ci-dessous.
FLEURS, benchmark vietnamien souvent cité, fournit environ 12 heures de parole lue. PhoWhisper, présenté dans la session Tiny Papers d'ICLR 2024, a affiné Whisper sur un jeu de données de 844 heures choisi pour la diversité des accents. VietASR, publié le 23 mai 2025, a utilisé 70 000 heures d'audio non annoté et 50 heures annotées ; ses auteurs affirment qu'il dépasse Whisper Large-v3 et des systèmes commerciaux sur des données réelles.
VietSuperSpeech, publié en 2026, rassemble 52 023 paires audio-texte totalisant 267,39 heures de vietnamien conversationnel informel : 240,67 heures d'entraînement et 26,72 heures d'évaluation, soit 13,8 millions de caractères entièrement diacrités. Ses auteurs décrivent ainsi le manque auquel répond ce jeu de données :
« Si des corpus tels que VLSP2020, VIET_BUD500, VietSpeech, FLEURS, VietMed, Sub-GigaSpeech2-Vi, viVoice et Sub-PhoAudioBook offrent une large couverture de la parole formelle et lue, aucun ne vise spécifiquement le registre informel et spontané indispensable aux applications d'IA conversationnelle. »
Ce jeu de données vise le registre courant des réunions : interruptions, hésitations, noms de produits anglais au milieu de phrases vietnamiennes et pensées inachevées. Un score obtenu sur de la parole lue ne permet pas à lui seul d'établir la précision d'un système dans ce type de conversation.
Pour les équipes, la protection pratique consiste à disposer d'une transcription qu'une personne peut relire et corriger. Encore faut-il que la fonction de réunion choisie crée d'abord une transcription en vietnamien.
Comment mener une réunion vietnamien-anglais dont la trace survit
Suivez ces six vérifications avant et pendant l'appel :
- Si nécessaire, choisissez des outils distincts pour comprendre et conserver une trace. Google Translate ou les sous-titres de Meet permettent de suivre une conversation en vietnamien en direct ; aucune de ces fonctions ne crée la transcription durable en vietnamien décrite ici.
- Réglez explicitement le vietnamien comme langue parlée ; ne comptez pas sur la détection automatique. Sur DeepL c'est obligatoire — les langues tierces, vietnamien compris, ne peuvent pas être détectées automatiquement. Partout ailleurs, cela reste le meilleur choix, car la détection automatique tranche dans les premières secondes, sur l'audio le moins contextuel de toute la session.
- Vérifiez la liste de langues de la fonction qui trace, pas celle de la plateforme. Le piège que ce billet existe pour décrire, c'est de supposer qu'une plateforme qui traduit le vietnamien le transcrit aussi. Dans Google Meet, 69 contre 8, c'est l'écart entre ces deux suppositions.
- Nommez le problème de l'alternance codique avant l'appel. Si votre équipe glisse des noms de produits anglais, des identifiants de tickets et des acronymes dans des phrases vietnamiennes — et toutes les équipes d'ingénierie offshore le font —, vérifiez que votre outil de trace tolère deux langues dans une même session. Le preneur de notes de Meet, explicitement, ne le fait pas.
- Corrigez les noms propres dans les cinq premières minutes, en direct. Les diacritiques vietnamiens et les noms de code de produits anglais sont les deux endroits où la transcription casse à coup sûr, et aussi les deux endroits où une ligne fausse fait le plus de dégâts à tout résumé bâti dessus. Corriger pendant la réunion coûte quelques secondes.
- Gardez le texte source vietnamien, la traduction anglaise et le résumé dans une seule trace. Pas trois fichiers dans trois outils. La traduction est à sens unique : vous pourrez retraduire depuis le vietnamien l'an prochain avec un meilleur modèle, mais vous ne récupérerez jamais le vietnamien depuis l'anglais.
Pour un guide pratique du produit, consultez notre article de juin sur la transformation d'un enregistrement de réunion bilingue en note IA relisible.
En résumé : le vietnamien a franchi le fossé de la compréhension, pas celui de la trace
Le vietnamien est désormais pris en charge dans les sous-titres en direct, l'audio interprété et la reconnaissance vocale. Les équipes ont ainsi davantage de moyens de suivre une conversation, mais une couverture annoncée ne garantit pas la disponibilité dans votre compte. L'extension de Gemini 3.5 Live Translate dans Meet est une préversion et un déploiement progressif, pas un remplacement universel des paires de langues actuellement prises en charge. Vérifiez la fonctionnalité, le compte et le sens de traduction dont vous avez besoin avant la réunion.
Ce qui n'a pas bougé, c'est la trace. Les deux fonctions Google qui produisent un artefact durable prennent en charge huit langues à elles deux, les mêmes huit, et le vietnamien n'est dans aucune. DeepL sous-titrera vers le vietnamien mais renvoie sa transcription à un sous-traitant, derrière un réglage d'administration. Le marché a décidé que le vietnamien est une langue qui vaut la peine d'être entendue et pas encore une langue qui vaut la peine d'être écrite.
La question à poser à un fournisseur n'est donc pas s'il prend en charge le vietnamien. Presque tous répondent oui désormais, et presque tous parlent de la moitié « écoute ». La question est : lesquelles de vos fonctions prennent en charge le vietnamien une fois l'appel terminé — et pouvez-vous me montrer la liste de langues de cette fonction précise ?
Où se situe Telli.sh : la couche de la trace est celle que nous construisons. Telli.sh transcrit la réunion dans la langue réellement parlée, traduit vers 44 langues cibles dont le vietnamien, et conserve les trois artefacts dans la même note — le texte source vietnamien, la traduction alignée dessus, et le résumé généré par-dessus. L'interface elle-même existe en 15 langues, vietnamien inclus, si bien qu'une équipe à Da Nang et un client à Sydney lisent la même réunion chacun dans sa langue tout en partageant une seule trace corrigeable.
Démarrer une note de réunion traduite en direct
Sources
- Google Translate Help, "Hear live speech to speech translations with Live translate" (Android), consulté le 31 août 2026 — la liste des 74 langues dont le vietnamien, les quatre modes de traduction, le mode face à face et la poursuite en arrière-plan.
- Google Translate Help, "Download languages to use offline" (Android), consulté le 31 août 2026 — les packs hors ligne et les mises à niveau vers une meilleure qualité.
- Google Meet Help, "Use translated captions in Google Meet", consulté le 31 août 2026 — la liste des 69 langues dont le vietnamien, les éditions Workspace payantes et Record captions.
- Google Meet Help, "Use Transcripts with Google Meet", consulté le 31 août 2026 — les huit langues de transcription prises en charge.
- Google Meet Help, "'Take notes for me' in Google Meet", consulté le 31 août 2026 — les mêmes huit langues, et la limite d'une seule langue à la fois.
- Slator, "Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate", 16 juin 2026 — l'annonce du 9 juin, les 70+ langues, le passage de Meet de cinq langues à 2 000+ paires, et le mode d'écoute.
- DeepL Help Center, "DeepL Voice languages", consulté le 31 août 2026 — les 18 langues parlées transcrites par DeepL, les 20 langues parlées tierces dont le vietnamien, les 41 langues de traduction, la restriction sur la détection automatique, et l'accord de rétention zéro avec Speechmatics.
- Samsung Newsroom, "The Learning Curve, Part 3: Taking AI Data From Good to Great", 23 mai 2024 — le vietnamien parmi les 16 premières langues de Galaxy AI, les six tons, l'exemple ma/mả/má et la description des trames d'environ 20 ms.
- Deepgram, Models & Languages Overview, consulté le 31 août 2026 — le vietnamien (
vi) dans la liste de langues de Nova-3. - Le, Nguyen et Nguyen, "PhoWhisper: Automatic Speech Recognition for Vietnamese", ICLR 2024 Tiny Papers — le jeu d'affinage de 844 heures à accents variés.
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining", 23 mai 2025 — 70 000 heures non annotées, 50 heures annotées.
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset", 2026 — 52 023 paires, 267,39 heures, et l'écart de registre sur huit corpus.