Google traducirá tu reunión en vietnamita en tiempo real. No escribirá ni una palabra de ella.
Los subtítulos traducidos de Google Meet cubren 69 idiomas, el vietnamita incluido, y la función Live translate de Google Translate cubre 74. La función Transcripts de Meet y su tomador de notas con Gemini admiten exactamente 8 idiomas cada uno, y el vietnamita no está en ninguno de los dos. DeepL Voice solo puede transcribir vietnamita hablado a través de un proveedor externo que un administrador tiene que habilitar y que no admite la detección automática. Un repaso de lo que la traducción de voz en directo le da realmente a los equipos vietnamitas en 2026, y de lo que nunca les da.
Busca traducción de voz en directo en Google en vietnamita y aterrizarás en una respuesta genuinamente buena. La función Live translate de Google Translate admite 74 idiomas, el vietnamita entre ellos, tanto en Android como en iOS. Funciona con auriculares o sin ellos, sigue trabajando cuando bloqueas la pantalla y ofrece un modo cara a cara que parte el teléfono por la mitad para que cada interlocutor lea su propio lado.
Funciona. Esa no es la parte interesante.
La parte interesante es lo que pasa en esa misma plataforma cuatro horas después, cuando quieres saber qué se acordó en realidad. La función Transcripts de Google Meet —la que produce un Google Doc duradero— admite exactamente ocho idiomas, y el vietnamita no es uno de ellos. Tampoco es uno de los ocho que admite «Take notes for me» de Meet, cuya propia página de ayuda añade que la función «admite un idioma cada vez» y que «actualmente no se admiten varios idiomas hablados en la misma reunión».
En resumen
- El vietnamita está admitido en todas las superficies de Google que escuchan: Live translate (74 idiomas), subtítulos traducidos de Meet (69 idiomas). No lo está en ninguna de las superficies de Google que escriben: Transcripts de Meet y el tomador de notas con Gemini de Meet, 8 idiomas cada uno.
- DeepL Voice puede mostrar subtítulos en vietnamita, pero no puede transcribir vietnamita hablado con sus propios modelos: el vietnamita queda en un nivel de terceros que un administrador debe habilitar y que no admite la detección automática.
- Este artículo traza exactamente dónde se detiene el vietnamita en cada plataforma importante a 31 de agosto de 2026, y ofrece un procedimiento de seis pasos para llevar una reunión vietnamita-inglés que deje constancia escrita.
Hicimos la versión general de este argumento esta misma mañana, mirando qué pasa cuando la traducción es excelente y ha desaparecido para la hora de cenar. Esta es más específica y, para los equipos vietnamitas, peor: el problema no es solo que las herramientas en directo olviden. Es que las funciones que recuerdan se saltan el vietnamita de forma específica.
Qué te da hoy realmente la «traducción de voz en directo» en vietnamita
Empecemos por las cuentas honestas, porque las herramientas gratuitas de Google son muy buenas en el trabajo para el que están construidas.
Live translate de Google Translate ofrece cuatro modos, según su página de ayuda para Android consultada el 31 de agosto de 2026: Escuchar (acércate el teléfono al oído o usa auriculares para traducir en tiempo real a otra persona), Conversación (las traducciones suenan en voz alta y los interlocutores se turnan), Solo texto (leer, sin audio) y Configuración personalizada. Hay un modo Cara a cara aparte en el que la pantalla se divide y cada interlocutor ve, en su mitad, tanto la transcripción como la traducción de su propio idioma. El micrófono detecta automáticamente cuándo se detiene un idioma y empieza el otro, así que nadie tiene que pulsar un botón entre frases.
Dos detalles merecen más reconocimiento del que suelen recibir. Primero, la sesión sobrevive a la multitarea: la documentación de Google afirma que la traducción «continúa sin interrupciones cuando cambias de aplicación, minimizas la aplicación o cuando se bloquea la pantalla». Segundo, el vietnamita se puede descargar para uso sin conexión, y los paquetes descargados pueden actualizarse a una versión de mayor calidad desde esa misma pantalla, algo que importa en un país donde una visita a obra o una planta de fábrica no son entornos con conectividad garantizada.
Vale la pena decir una limitación con toda claridad, porque sorprende a la gente: esto es una función de móvil. La propia página de ayuda de Google para la versión web dice, en una sola frase: «No puedes hablar y traducir al mismo tiempo en Google Translate para la web». Si tu reunión bilingüe ocurre en un portátil, Live translate no está en la sala.
Aquí está el fondo del asunto: para una conversación —un taxi, la visita a un proveedor, una charla de pasillo con un cliente que está de paso— esto está cerca de ser un problema resuelto, no cuesta nada y lo recomendaríamos sin dudar. El fallo no está en la conversación. Está en la reunión.
Gemini 3.5 Live Translate lleva a Meet de cinco idiomas a más de setenta
El panorama también se mueve rápido, y se mueve a favor de los hablantes de vietnamita.
El 9 de junio de 2026, Google anunció Gemini 3.5 Live Translate, un modelo de traducción de voz a voz que cubre más de 70 idiomas. Según informó Slator el 16 de junio de 2026, se está desplegando a través de la Gemini Live API y Google AI Studio en versión preliminar pública, entrando en versión preliminar privada en Google Meet para determinados clientes de Workspace y lanzándose globalmente dentro de la aplicación móvil de Google Translate en Android y iOS.
La cifra que importa para Meet es la del antes y el después. La traducción de voz en Meet estaba limitada a cinco idiomas admitidos, con traducción únicamente desde y hacia el inglés. Gemini 3.5 Live Translate lo amplía a más de 70 idiomas y más de 2.000 combinaciones de pares de idiomas, con una disponibilidad más amplia prevista para más adelante en 2026. Para un equipo vietnamita, un sistema de cinco idiomas con pivote en inglés era, en la práctica, ningún sistema; 2.000 pares son otro producto.
Google está posicionando el modelo de forma estrecha, lo cual es buena señal y no mala. Según Slator, la documentación contrasta Live Translate con las capacidades más amplias de Live Agent de Gemini: funciona como una canalización de traducción en tiempo real, acepta entrada solo de audio y omite deliberadamente las llamadas a funciones, el anclaje en búsqueda, las herramientas y las instrucciones de sistema. Es un intérprete, no un asistente: la misma distinción que trazó OpenAI al describir GPT-Realtime-Translate. Google también añadió un «modo de escucha» en Android que transmite el audio traducido por el auricular, de modo que puedes seguir una traducción sin llevar auriculares visibles en una reunión.
Así que la capa en directo para el vietnamita está mejorando deprisa y desde varios frentes a la vez. Ahora, la otra pregunta.
La línea del registro: dónde se detiene el vietnamita
Toda plataforma tiene una línea. A un lado están las funciones que te ayudan a entender el habla mientras ocurre. Al otro están las funciones que convierten el habla en algo que todavía tendrás la semana que viene. Llamémosla la línea del registro, y para el vietnamita es exactamente donde desaparece el soporte.
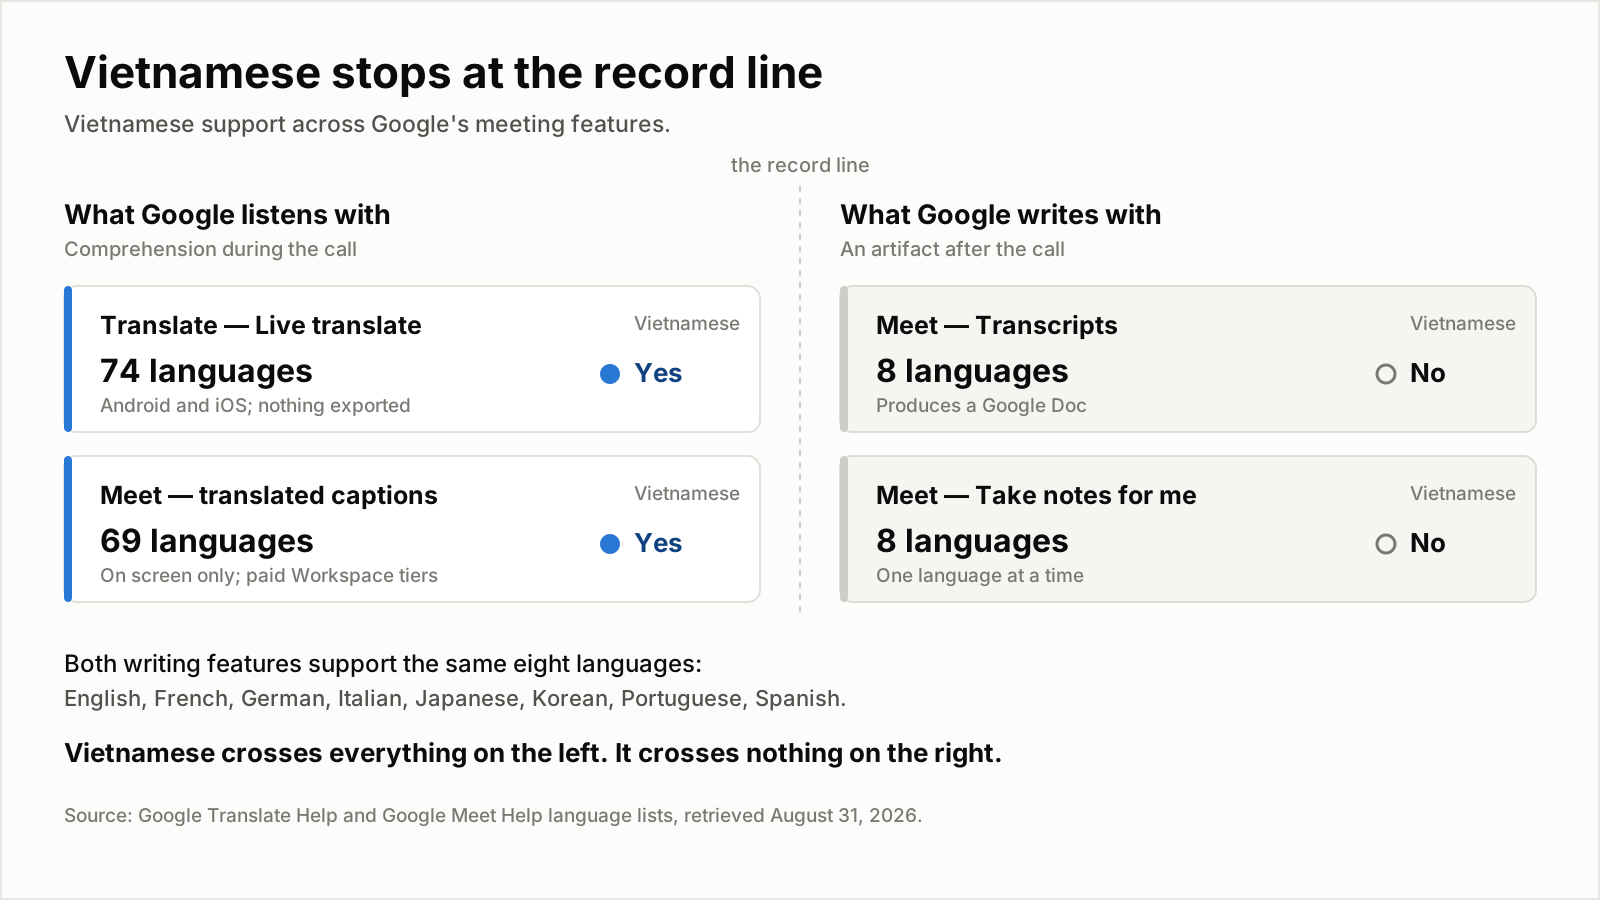
Los recuentos de idiomas son de la propia Google, tomados de cuatro páginas de ayuda consultadas el 31 de agosto de 2026. El vietnamita aparece en ambas funciones de escucha y en ninguna función de escritura.
Aquí está la misma información en forma de tabla, porque la asimetría es más fácil de rebatir cuando está alineada.
| Función de Google | ¿Admite vietnamita? | Idiomas | ¿Deja algo tras la llamada? |
|---|---|---|---|
| Google Translate — Live translate | Sí | 74 | No |
| Google Meet — subtítulos traducidos | Sí | 69 | Solo en pantalla; incrustados en el vídeo si activas Record captions |
| Google Meet — Transcripts | No | 8 | Sí, un Google Doc |
| Google Meet — «Take notes for me» | No | 8, de uno en uno | Sí, notas en Google Docs más un resumen por correo |
| Google Meet — Gemini 3.5 Live Translate | En despliegue | 5 hoy, más de 70 en versión preliminar privada | No se indica |
Todas las filas proceden de páginas de ayuda de Google y del informe de Slator del 16 de junio de 2026, consultados el 31 de agosto de 2026.
Los ocho idiomas que comparten Transcripts y «Take notes for me» son idénticos: inglés, francés, alemán, italiano, japonés, coreano, portugués y español. Es la misma lista dos veces, y es una lista de grandes mercados europeos y de Asia Oriental. El vietnamita —unos 97 millones de hablantes, según el propio recuento de Samsung en su artículo de 2024 sobre el trabajo— queda fuera, junto al tailandés, el indonesio, el hindi y el árabe.
Hay una restricción más que golpea específicamente a los equipos bilingües, y se aplica incluso a equipos que trabajan enteramente en idiomas admitidos. La página de ayuda de Google para «Take notes for me» afirma que la función admite un idioma cada vez y que actualmente no se admiten varios idiomas hablados en la misma reunión. Una llamada Vietnam-Estados Unidos que alterna entre vietnamita e inglés queda descalificada por partida doble: una vez por el vietnamita y otra por la alternancia.
Para ser justos con Google: los subtítulos traducidos sí tienen una vía de persistencia. Si grabas la reunión y seleccionas Record captions, los subtítulos quedan incrustados en el vídeo. Y durante la sesión puedes desplazarte hacia atrás por los subtítulos traducidos. Pero unos subtítulos quemados en un archivo de vídeo no son un registro consultable: no puedes buscar dentro de un píxel, no puedes corregir un nombre y no puedes generar un resumen a partir de él. Los subtítulos traducidos en Meet también están restringidos a las ediciones de pago de Workspace: Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter (disponible hasta el 30 de junio de 2025) y Google AI Pro for Education.
DeepL te mostrará subtítulos en vietnamita. Transcribir vietnamita hablado es otro nivel.
DeepL Voice es la alternativa occidental más sólida, y su historia con el vietnamita es la más instructiva de todo este artículo, porque DeepL documenta la distinción mejor que nadie.
DeepL divide el soporte de idiomas en dos listas. Los idiomas hablados son los que acepta el reconocedor. Los idiomas de traducción son aquellos en los que se pueden mostrar los subtítulos. El vietnamita aparece en la lista de traducción, que llega a 41 idiomas. Ahora mira el otro lado: los modelos propios de DeepL transcriben 18 idiomas hablados: chino (mandarín), checo, neerlandés, inglés, francés, alemán, indonesio, italiano, japonés, coreano, polaco, portugués, rumano, ruso, español, sueco, turco y ucraniano. El vietnamita no está entre ellos.
El vietnamita está disponible como idioma hablado, pero solo en un segundo nivel de 20 idiomas transcritos por un proveedor externo, Speechmatics. Vienen con tres condiciones, todas documentadas en la página de ayuda de DeepL consultada el 31 de agosto de 2026:
- Un administrador del equipo debe habilitar el procesamiento por terceros en la cuenta de administración de la organización antes de que ninguno de estos idiomas funcione siquiera.
- La detección automática no funciona. En palabras de DeepL: «Los idiomas de terceros no funcionan con la detección automática de idioma: hay que seleccionarlos manualmente como idioma hablado».
- Para que los participantes elijan su propio idioma hablado, el anfitrión debe habilitar un código de acceso al conectar la reunión con DeepL Voice.
Nada de eso es irrazonable —DeepL señala que Speechmatics opera bajo un acuerdo de retención cero, de modo que los datos de transcripción se eliminan de sus servidores una vez procesados—. Pero apila los requisitos y obtienes el resultado práctico: un hablante de vietnamita que se une a una reunión equipada con DeepL está a un ajuste de administrador sin marcar de no ser transcrito en absoluto, y no puede confiar en que el sistema lo detecte automáticamente. Mientras tanto, la postura sobre retención es la misma sobre la que escribimos esta mañana: las preguntas frecuentes de DeepL dicen que los datos de la reunión se «procesan temporalmente en memoria y se eliminan cuando termina la llamada».
Samsung es el contraejemplo que merece mencionarse. El vietnamita estuvo entre los primeros 16 idiomas con los que se lanzó Galaxy AI, y el Samsung R&D Institute Vietnam publicó el 23 de mayo de 2024 un relato inusualmente franco de por qué fue difícil. El vietnamita tiene seis tonos distintos; el ejemplo del artículo es que ma, mả y má —fantasma, tumba y madre— se diferencian solo por el tono. Bui Ngoc Tung, responsable de ASR del instituto, describió un modelo que diferencia fotogramas de audio de «unos 20 milisegundos» para decidir a qué palabra pertenece una serie de fotogramas. Cuando un fabricante coreano de móviles invierte en modelado tonal del vietnamita y una empresa europea de traducción lo deriva a un subcontratista, eso te dice algo sobre cómo valora el mercado este idioma.
Del lado de la oferta en reconocimiento de voz, el panorama es mejor que en el de la toma de notas: Nova-3 de Deepgram incluye el vietnamita como vi en su documentación de modelos e idiomas, consultada el 31 de agosto de 2026, uno de los 58 idiomas que contamos en nuestro análisis de lo que esconde la palabra «admitido» en la cobertura de voz a texto.
Ningún proveedor publica una tasa de error para el vietnamita en reuniones, y los corpus explican por qué
Salimos a buscar una cifra que poner a la calidad de la transcripción del vietnamita en reuniones. No existe, y el motivo es más útil de lo que habría sido la cifra.
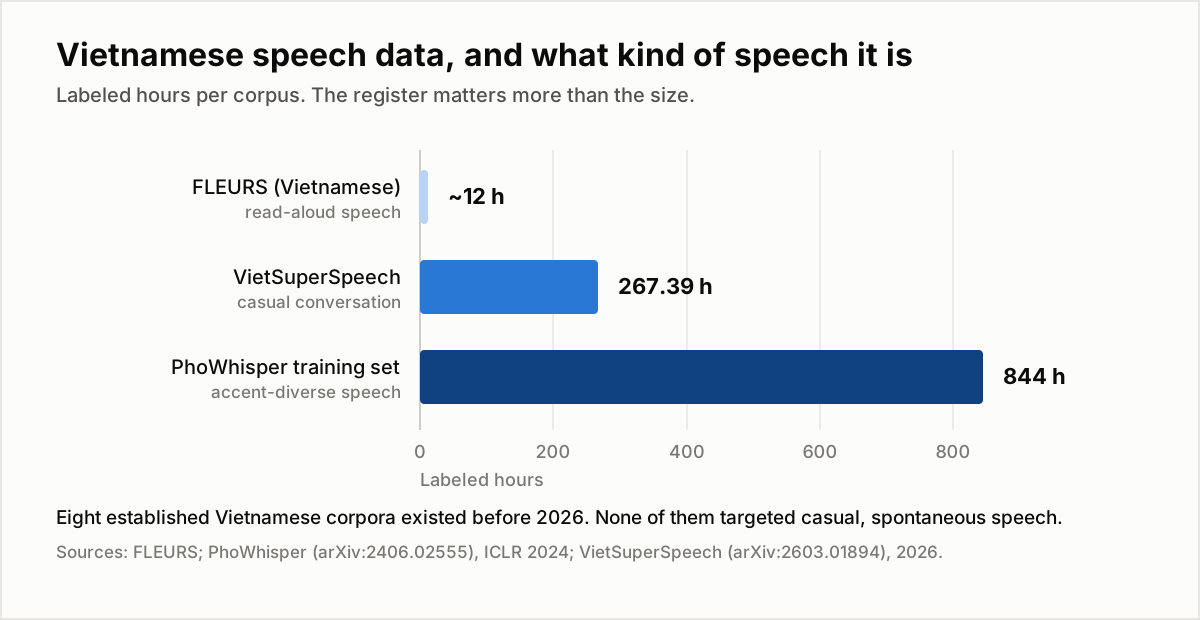
Las horas etiquetadas no son toda la historia: el registro sí. FLEURS es habla leída; el conjunto de entrenamiento de PhoWhisper abarca varios acentos; VietSuperSpeech es el primer corpus construido específicamente para la conversación informal. Las fuentes están fechadas en la lista de abajo.
El punto de referencia que todo el mundo cita para el vietnamita es FLEURS, que aporta unas 12 horas de habla leída en voz alta por idioma. El habla leída no es el habla de una reunión. PhoWhisper, presentado en el track Tiny Papers de ICLR 2024, ajustó Whisper sobre un conjunto de datos vietnamita de 844 horas elegido por su diversidad de acentos, lo que es un paso real hacia el realismo. VietASR, publicado el 23 de mayo de 2025, tomó otro camino —preentrenamiento con 70.000 horas de audio sin etiquetar y ajuste con solo 50 horas etiquetadas— y afirma superar a Whisper Large-v3 y a sistemas comerciales con datos del mundo real.
Y luego está el artículo que dice en voz alta lo que nadie dice. VietSuperSpeech, publicado en 2026, reúne 52.023 pares de audio y texto que suman 267,39 horas de vietnamita conversacional informal, divididas en 240,67 horas de entrenamiento y 26,72 horas de evaluación, con 13,8 millones de caracteres completamente diacritizados. Su motivación declarada es la frase que hay que citar:
«Aunque corpus como VLSP2020, VIET_BUD500, VietSpeech, FLEURS, VietMed, Sub-GigaSpeech2-Vi, viVoice y Sub-PhoAudioBook ofrecen una amplia cobertura del habla formal y leída, ninguno se dirige específicamente al registro informal y espontáneo que resulta indispensable para las aplicaciones de IA conversacional.»
Ocho corpus vietnamitas con nombre propio y, hasta este, ni uno solo construido para la forma en que la gente habla de verdad en una reunión: interrumpiendo, matizando, cambiando al inglés para decir el nombre del producto, dejando frases a medias. Sea cual sea la cifra de precisión que un proveedor te dé para el vietnamita, casi con toda seguridad se midió con alguien leyendo un guion.
La consecuencia operativa es sencilla y es la misma a la que llegamos una y otra vez. Si no puedes consultar cuán precisa será la transcripción de tu reunión, la única defensa es una transcripción que una persona pueda leer y corregir. Lo cual exige que exista una transcripción, para empezar.
Cómo llevar una reunión vietnamita-inglés para que sobreviva el registro
Seis pasos, en el orden en que ocurren. Cada uno de ellos aborda un fallo concreto documentado más arriba.
- Decide qué herramienta se encarga de la comprensión y cuál del registro, y acepta que son herramientas distintas. Este es el artículo entero en una línea. Google Translate o los subtítulos de Meet pueden encargarse hoy del primer trabajo en vietnamita. Ninguno se encarga del segundo.
- Establece el vietnamita como idioma hablado de forma explícita; no confíes en la detección automática. En DeepL esto es obligatorio: los idiomas de terceros, el vietnamita incluido, no pueden detectarse automáticamente. En todos los demás sitios sigue siendo la mejor opción, porque la detección automática se compromete con una conjetura en los primeros segundos, sobre el audio menos contextual de toda la sesión.
- Consulta la lista de idiomas de la función de registro, no la de la plataforma. La trampa que este artículo existe para describir es dar por hecho que una plataforma que traduce el vietnamita también lo transcribe. En Google Meet, 69 frente a 8 es la distancia entre esas dos suposiciones.
- Pon nombre al problema de la alternancia de idiomas antes de la llamada. Si tu equipo cuela nombres de producto en inglés, identificadores de tickets y siglas dentro de frases en vietnamita —y todo equipo de ingeniería deslocalizado lo hace—, verifica que tu herramienta de registro tolere dos idiomas en una misma sesión. El tomador de notas de Meet explícitamente no lo hace.
- Corrige los nombres propios en los primeros cinco minutos, en directo. Los diacríticos vietnamitas y los nombres en clave de producto en inglés son los dos puntos donde la transcripción falla de forma fiable, y también los dos puntos donde una línea equivocada hace más daño a cualquier resumen construido encima. Corregir durante la reunión cuesta segundos.
- Guarda el texto original en vietnamita, la traducción al inglés y el resumen en un mismo registro. No tres archivos en tres herramientas. La traducción es de ida: puedes volver a traducir desde el vietnamita el año que viene con un modelo mejor, pero nunca podrás recuperar el vietnamita a partir del inglés.
Si lo que quieres es el recorrido paso a paso por el producto y no el análisis del mercado, nuestra guía de junio para equipos vietnamitas explica de principio a fin cómo convertir la grabación de una reunión bilingüe en una nota de IA revisable.
La conclusión: el vietnamita ha cruzado la brecha de la comprensión, pero no la del registro
Durante la mayor parte de la última década, la queja sobre el vietnamita en las reuniones internacionales era que la tecnología no lo entendía lo bastante bien. En 2026 esa queja ha caducado en gran medida. Entre los 74 idiomas de Live translate, los 69 de los subtítulos traducidos de Meet, los más de 2.000 pares de idiomas que llegan a Meet vía Gemini 3.5 Live Translate, el vietnamita en Nova-3 y Samsung ofreciendo interpretación de vietnamita en el dispositivo desde 2024, la comprensión está resuelta.
Lo que no se ha movido es el registro. Las dos funciones de Google que producen un artefacto duradero admiten ocho idiomas entre las dos, los mismos ocho, y el vietnamita no está en ninguna. DeepL subtitulará al vietnamita, pero deriva su transcripción a un subcontratista tras un interruptor de administrador. El mercado ha decidido que el vietnamita es un idioma que merece la pena escuchar y todavía no un idioma que merezca la pena poner por escrito.
Así que la pregunta que hay que hacerle a un proveedor no es si admite vietnamita. Casi todos dicen ya que sí, y casi todos se refieren a la mitad que escucha. La pregunta es: ¿cuáles de vuestras funciones admiten vietnamita después de que termine la llamada, y podéis enseñarme la lista de idiomas de esa función concreta?
Dónde encaja Telli.sh: la capa del registro es la capa que construimos. Telli.sh transcribe la reunión en el idioma en que se habló realmente, traduce a 44 idiomas de destino, el vietnamita incluido, y mantiene los tres artefactos en la misma nota: el texto original en vietnamita, la traducción alineada con él y el resumen generado encima. La propia interfaz está disponible en 15 idiomas, el vietnamita entre ellos, de modo que un equipo en Da Nang y un cliente en Sídney leen la misma reunión en su propio idioma y siguen compartiendo un único registro corregible.
Empieza una nota de reunión traducida en directo
Fuentes
- Ayuda de Google Translate, "Hear live speech to speech translations with Live translate" (Android), consultada el 31 de agosto de 2026 — la lista de 74 idiomas con el vietnamita incluido, los cuatro modos de traducción, el modo cara a cara y la continuación en segundo plano.
- Ayuda de Google Translate, "Download languages to use offline" (Android), consultada el 31 de agosto de 2026 — paquetes sin conexión y actualizaciones a mayor calidad.
- Ayuda de Google Meet, "Use translated captions in Google Meet", consultada el 31 de agosto de 2026 — la lista de 69 idiomas con el vietnamita incluido, las ediciones de pago de Workspace y Record captions.
- Ayuda de Google Meet, "Use Transcripts with Google Meet", consultada el 31 de agosto de 2026 — los ocho idiomas admitidos para transcripciones.
- Ayuda de Google Meet, "'Take notes for me' in Google Meet", consultada el 31 de agosto de 2026 — los mismos ocho idiomas y la limitación de un solo idioma cada vez.
- Slator, "Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate", 16 de junio de 2026 — el anuncio del 9 de junio, más de 70 idiomas, el salto de Meet de cinco idiomas a más de 2.000 pares y el modo de escucha.
- Centro de ayuda de DeepL, "DeepL Voice languages", consultado el 31 de agosto de 2026 — los 18 idiomas hablados transcritos por DeepL, los 20 idiomas hablados de terceros con el vietnamita incluido, los 41 idiomas de traducción, la restricción de la detección automática y el acuerdo de retención cero con Speechmatics.
- Samsung Newsroom, "The Learning Curve, Part 3: Taking AI Data From Good to Great", 23 de mayo de 2024 — el vietnamita entre los primeros 16 idiomas de Galaxy AI, los seis tonos, el ejemplo ma/mả/má y la descripción de los fotogramas de unos 20 ms.
- Deepgram, Models & Languages Overview, consultada el 31 de agosto de 2026 — el vietnamita (
vi) en la lista de idiomas de Nova-3. - Le, Nguyen y Nguyen, "PhoWhisper: Automatic Speech Recognition for Vietnamese", ICLR 2024 Tiny Papers — el conjunto de ajuste de 844 horas con diversidad de acentos.
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining", 23 de mayo de 2025 — 70.000 horas sin etiquetar, 50 horas etiquetadas.
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset", 2026 — 52.023 pares, 267,39 horas y el vacío de registro en ocho corpus.