연속 통역은 회의를 두 배로 늘린다. 실시간 번역기는 회의를 잊어버린다. 2026년 태국 팀이 실제로 저울질하는 선택지.
방콕 에이전시들은 연속 통역을 시간당 3,000바트부터, 동시통역을 5,000바트부터 공시하고, 연속 통역은 회의가 굴러가는 시간을 대략 두 배로 늘립니다. 구글 번역의 Live translate는 태국어를 포함해 74개 언어를, 구글 Meet의 번역 자막은 태국어를 포함해 69개 언어를 지원합니다. 반면 Meet의 Transcripts와 Gemini 노트 작성 기능은 각각 8개 언어뿐이고, 태국어는 어느 쪽에도 없습니다. Deepgram의 Nova-3는 태국어를 th와 th-TH로 전사하면서도 10개 언어짜리 코드 스위칭 모드에서는 제외하는데, 하필 그것이 당신의 회의를 이루는 태국어–영어 혼용 문장입니다. 태국 팀을 위한 회의 번역 선택지 총정리.
방콕 에이전시를 통해 연속 통역사를 예약하면 공시된 시작 요금은 시간당 3,000바트입니다. 동시통역은 5,000바트부터죠. Sawadee Translations가 직접 게시한 수치이고, 2026년 9월 1일에 확인했습니다. 그런데 비싼 부분은 시급이 아닙니다.
비싼 것은 시계입니다. 연속 통역에서는 화자가 한 단락을 말하고 — Acolad의 2026년 4월 24일 해설은 일반적인 단락 길이를 1분에서 5분으로 잡습니다 — 거기서 멈추면 통역사가 그 내용을 다른 언어로 한 번 더 전달합니다. Acolad의 표현을 그대로 옮기면 이렇습니다. 「연속 통역 세션은 모든 발언이 두 번 전달되기 때문에 소요 시간이 대략 두 배가 된다.」 90분짜리 분기 리뷰는 3시간짜리 분기 리뷰가 되고, 당신은 그 3시간 전부에 대해 통역사에게 비용을 지불합니다.
그러는 동안 구글은 같은 일의 어떤 버전을 태국인 팀원의 휴대폰에서, 공짜로, 지금 당장 해 줍니다.
TL;DR
- 태국어는 모든 듣기 테스트를 통과하고 모든 쓰기 테스트에서 탈락한다. 구글 번역의 Live translate는 태국어를 포함해 74개 언어를 나열하고, 구글 Meet의 번역 자막은 태국어를 포함해 69개를 나열합니다. 반면 구글 Meet의 Transcripts와 「Take notes for me」 노트 작성 기능은 각각 정확히 8개 언어 — 서로 똑같은 8개 — 만 지원하고, 태국어는 어느 목록에도 없습니다.
- 구체적인 실패 지점은 태국어–영어 혼용 문장이다. Deepgram의 Nova-3는 태국어를
th와th-TH로 전사하지만,multi코드 스위칭 모드는 정확히 10개 언어만 다루고 태국어는 그 안에 없습니다. Meet의 노트 작성 기능은 아예 「한 번에 한 가지 언어만 지원한다」라고 못 박아 두었습니다. - 어떤 회의에는 여전히 사람 통역사가 정답입니다. 이 글은 그 경계선이 어디인지 분명히 그립니다. 그리고 기록이 남는 태국어–영어 회의를 진행하는 7단계 절차를 제시하고, 공시된 태국어 통역 요금과 공개된 태국어 음성 인식 오류율을 나란히 놓습니다.
이 글은 시리즈의 태국 편입니다. 어제는 같은 회계를 베트남에 대해 돌렸고 거의 똑같은 모양을 발견했습니다 — 구글은 당신의 베트남어 회의를 실시간으로 번역하지만 단 한 글자도 적어 두지 않는다. 이 주장의 범용 버전은 번역이 훌륭했는데 저녁이면 사라져 있을 때 무슨 일이 벌어지는지를 다룬 글에 있습니다. 태국은 한 가지 중요한 지점에서 다르고, 그게 아래의 코드 스위칭 섹션입니다.
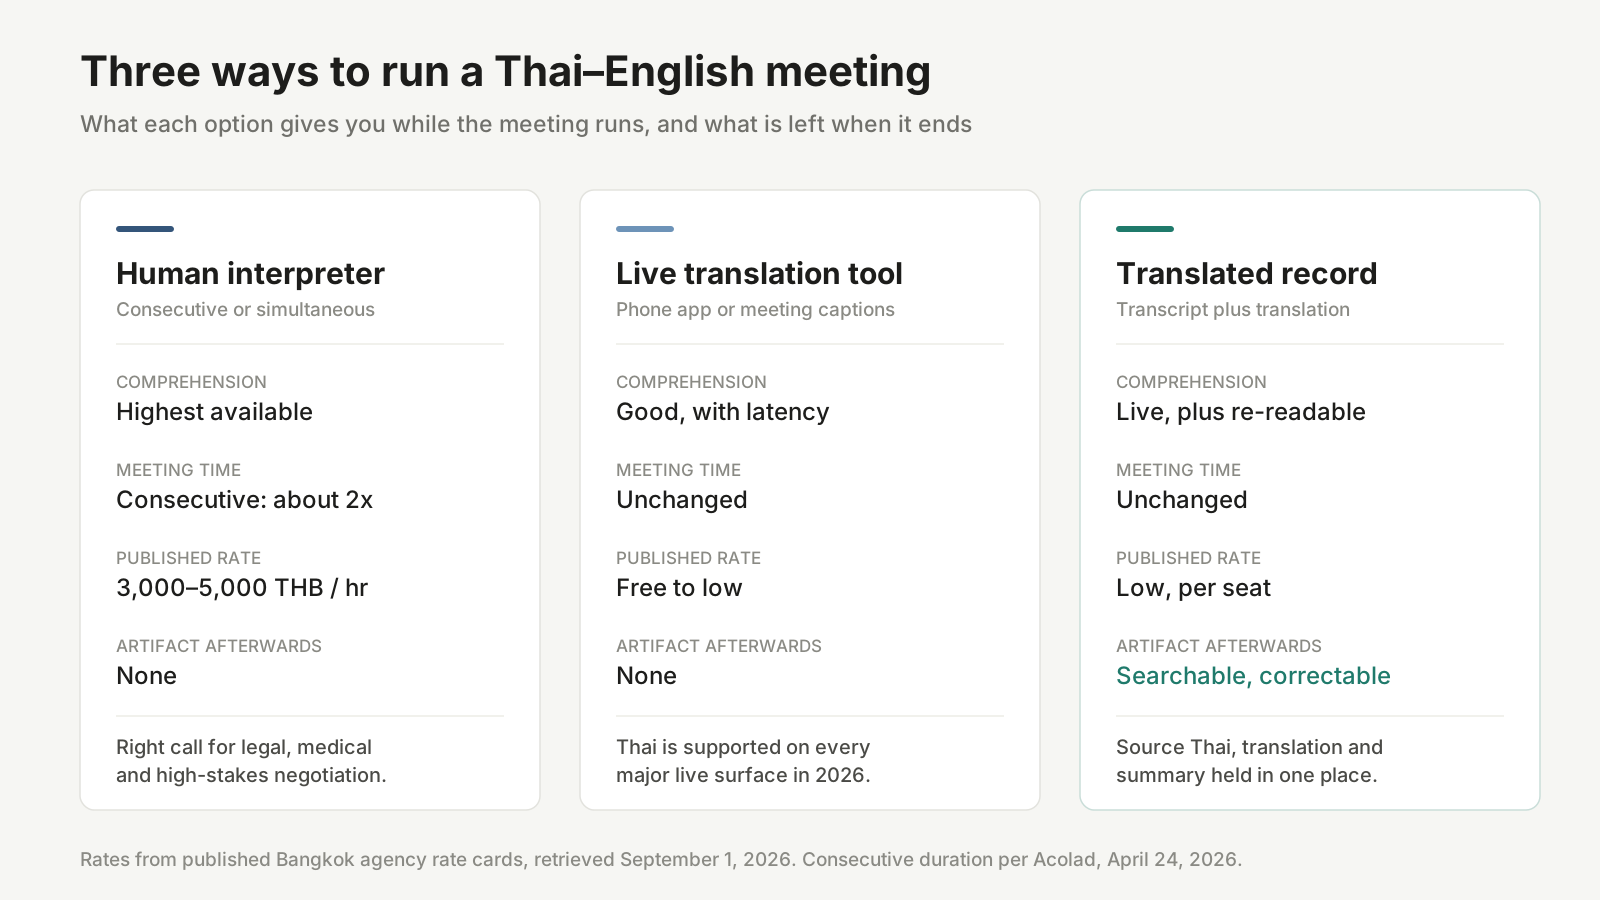
세 가지 선택지를 나란히 놓은 그림. 요금은 2026년 9월 1일에 확인한 방콕 에이전시들의 공개 요금표에서 가져왔습니다.
แปลต่อเนื่อง와 แปลพร้อม은 서로 다른 상품이고, 태국 검색자들은 앞쪽을 찾는다
어휘부터 시작하죠. 태국의 검색 데이터가 이 구분에 대해 유난히 정확하기 때문입니다. 태국 사람들은 회의를 처리해야 할 때 구글에 「번역」이라고 치지 않습니다. การประชุมแปลต่อเนื่อง — 직역하면 「연속 통역 회의」 — 라고 칩니다. 막연한 바람이 아니라 특정한 전문 모드를 콕 집어 요청하는 검색어죠.
연속 통역(แปลต่อเนื่อง)은 통역사가 기다린다는 뜻입니다. 화자가 한 단락을 말하고 멈추면, 통역사가 그것을 옮깁니다. Acolad에 따르면 부스도, 수신기도, 송신기도 필요 없습니다. 메모지 한 권이 기술 요구사항의 전부입니다. 그래서 양자 회의, 법정 증언, 진료 상담, 현장 방문, 공장 라운드의 기본값이 됩니다. Sawadee Translations는 대부분의 법적 절차와 대사관 면접이 연속 통역을 쓴다고 적으면서 이유를 이렇게 답니다. 「속도보다 정확성이 중요하고, 이 형식은 멈춤을 허용하기 때문이다.」
동시통역(แปลพร้อม)은 통역사가 기다리지 않는다는 뜻입니다. 화자가 아직 말하는 중에, 몇 초 지연을 두고 번역이 전달됩니다. 비용이 더 드는 데는 구조적인 이유가 있습니다. Elite Asia의 정리에 따르면 표준 장비 구성은 방음 통역 부스, 포켓 수신기, 헤드폰, 중앙 제어 장치, 다채널 송신기, 마이크가 달린 통역사 데스크입니다. 게다가 동시통역사는 관례적으로 2인 1조로 일하며 20~30분마다 교대합니다. 그 인지 부하는 혼자서 한 세션을 버텨 낼 수 있는 종류가 아니니까요.
여기서부터가 대부분의 비교 기사가 묻어 버리는 지점입니다. 두 모드의 진짜 비용 차이는 요금 차이가 아닙니다. 연속 통역은 시간당으로는 싸고 회의당으로는 비쌉니다. 아무도 가격을 매기지 않는 유일한 자원, 즉 캘린더를 잡아먹기 때문이죠. 이걸 통역된 한 시간이라고 불러 봅시다. 안건으로는 60분인데 모두의 하루에서는 120분을 점유하는 시간 말입니다.
태국어 통역사의 실제 비용, 공개된 요금표로 확인하기
태국어 통역 요금표는 진짜로 공개되어 있습니다. 이 업계 사정을 감안하면 드문 일이죠. 방콕의 두 업체가 직접 인용 가능한 숫자를 게시해 두었습니다.
| 제공사 | 방식 | 공시 시작 요금 | 단위 |
|---|---|---|---|
| Sawadee Translations | 연속 통역 | 3,000바트부터 | 시간당 |
| Sawadee Translations | 동시통역 | 5,000바트부터 | 시간당 |
| Y LINK (Personnel Consultant) | 연속 통역, 온라인 | 2,000바트부터 | 60분당 |
| Y LINK (Personnel Consultant) | 동시통역, 온라인 | 3,000바트부터 | 60분당 |
| Y LINK (Personnel Consultant) | 컨퍼런스 / 비즈니스 미팅, 현장 Class A | 6,000바트부터 | 반일(4시간) |
| Y LINK (Personnel Consultant) | 컨퍼런스 / 비즈니스 미팅, 현장 Class A | 9,600바트부터 | 종일(8시간) |
| Y LINK (Personnel Consultant) | 동시통역 또는 위스퍼링, 현장 Class A | 14,400바트부터 | 반일(4시간) |
| Y LINK (Personnel Consultant) | 동시통역 또는 위스퍼링, 현장 Class A | 21,600바트부터 | 종일(8시간) |
두 요금표 모두 2026년 9월 1일 확인. Y LINK의 일본어–태국어–영어 파견 페이지는 일본어·태국어·영어 사이의 통역이 「하루 14,400바트부터 시작한다」라고도 적고 있습니다.
작은 글씨를 읽어야 합니다. 통역된 한 시간이 돈으로 드러나는 자리가 바로 거기니까요. Y LINK는 반일을 「12시를 넘기지 않는」 4시간으로, 종일을 통역사의 1시간 점심시간을 제외한 8시간으로 정의합니다. 초과 근무는 태국 노동법에 따라 계산됩니다. 일 계약 금액을 8로 나누고 1.5를 곱한 뒤 15분 단위로 청구하죠. 취소 위약 사다리는 가파릅니다. 영업일 기준 2일 이내면 요금의 100%, 37일이면 80%, 814일이면 50%, 15~30일이면 20%입니다.
그러니까 연속 통역 때문에 두 배로 늘어난 회의가 90분 초과했다면, 그 대가는 90분이 아닙니다. 이미 사 놓은 하루 위에 시간당 요율의 1.5배가 얹히고, 거기에 그 방에 있던 모든 사람이 오후 하나를 잃는 하류 비용이 더해집니다.
이 계산이 통역사를 나쁜 선택으로 만들지는 않습니다. 다만 통역사를 「고민해서 사는 물건」으로 만듭니다. 이 글의 나머지도 정확히 그렇게 다룹니다.
이제 모든 무료 도구가 태국어를 말하고, 평판보다 낫다
시장의 반대편도 공정하게 들어 볼 가치가 있습니다. 실시간 번역의 태국어 지원은 대부분의 팀이 눈치채기도 전에 듬성듬성한 상태에서 촘촘한 상태로 넘어갔거든요.
구글 번역의 Live translate는 74개 언어를 나열하고, 태국어도 그중 하나입니다. 안드로이드와 iOS에서 이어폰이 있든 없든 작동하고, Listening, Conversation, Text-only, Custom 모드를 제공하며, 화면을 반으로 갈라 각 화자가 자기 쪽을 읽는 마주 보기 모드도 있습니다. 이때 마이크가 어느 언어가 말해지고 있는지 자동으로 감지합니다. 구글 문서는 번역이 「앱을 전환하거나, 애플리케이션을 최소화하거나, 화면이 잠겨도 끊김 없이 계속된다」라고 명시합니다. 태국어는 오프라인용으로 내려받을 수도 있는데, 라용의 현장 방문이나 통신 상태를 약속받을 수 없는 협력사 감사에서는 이게 중요합니다.
구글 Meet의 번역 자막은 태국어를 포함해 69개 언어를 지원합니다. 유료 등급 기능이며 Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter(2025년 6월 30일까지 제공), 그리고 Google AI Pro for Education에서 쓸 수 있습니다.
삼성의 Live translate와 Interpreter는 갤럭시 기기에서 태국어를 지원합니다. 삼성 지원 페이지가 나열한 20개 기본 언어 중 하나로, 베트남어·인도네시아어·힌디어와 나란히 있죠. 같은 페이지에는 두 번 읽을 만한 단서 조항이 붙어 있습니다. 「한 번에 한 사람만 Live Translate를 사용해야 하며, 그렇지 않으면 번역 오류가 발생합니다. 선택된 언어가 실제로 말해지는 언어와 다르면 대화가 잘못 번역될 수 있습니다.」
많은 회의 도구의 엔진 계층인 Deepgram의 Nova-3는 태국어를 th와 th-TH로 올려 두었습니다. 2026년 9월 1일 기준 Deepgram의 Models & Languages Overview에서 서로 다른 기본 언어 코드를 세면 58개가 나오고, 태국어는 Nova-3 표와 더 오래된 Nova-2 표 양쪽에 들어 있습니다.
이건 진짜로 돌아가고, 돈이 들어간, 작동하는 태국어 실시간 번역 계층입니다. 당신의 문제가 공장 바닥에서의 협력사 대화라면, 거의 해결된 문제이고 비용도 들지 않습니다. 저희 솔직한 견해는 이렇습니다. 두 사람이 주고받는 대화에서 이해만이 목적이라면, 무료 도구를 쓰고 청구서는 건너뛰세요.
태국어는 모든 듣기 목록을 통과하고 모든 쓰기 목록에서 탈락한다
이제 비대칭 이야기입니다. 이 글이 존재하는 이유죠.
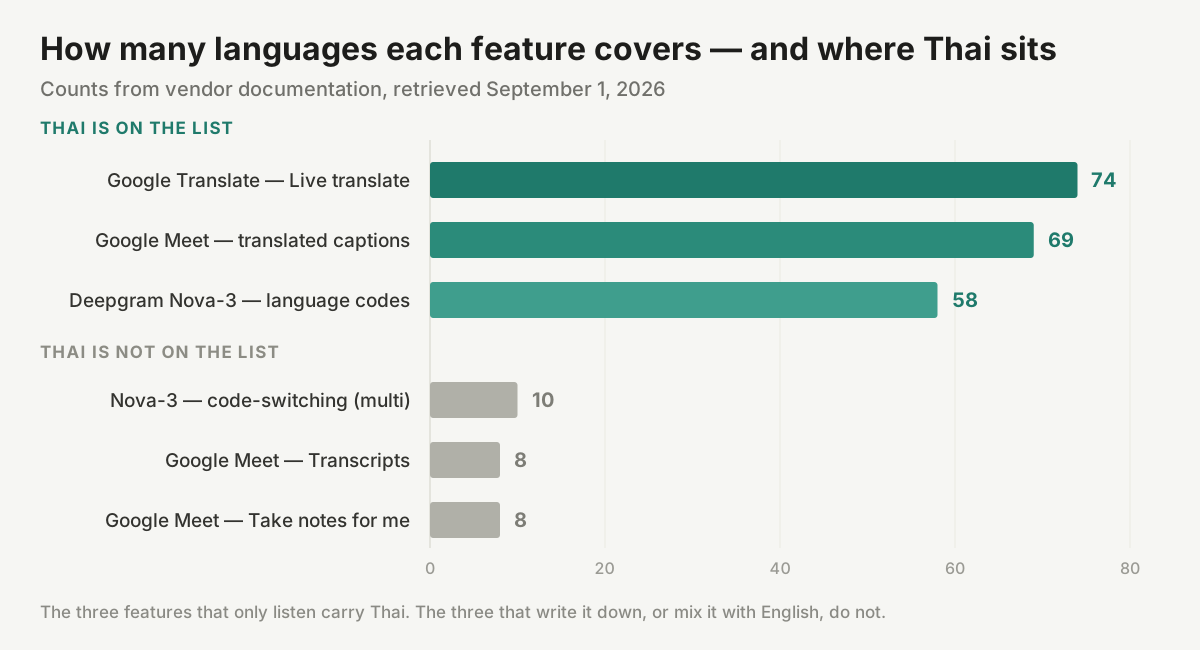
2026년 9월 1일에 확인한 각 벤더 문서 기준 수치. 듣기만 하는 기능은 태국어를 품고 있고, 쓰는 기능이나 태국어와 영어를 섞는 기능은 그렇지 않습니다.
오래 남는 구글 문서를 만들어 주는 기능인 구글 Meet의 Transcripts는 정확히 8개 언어에서만 제공됩니다. 영어, 프랑스어, 독일어, 이탈리아어, 일본어, 한국어, 포르투갈어, 스페인어입니다. 노트를 구글 문서에 정리하고 주최자에게 요약 메일을 보내 주는 Gemini 기반 노트 작성 기능 구글 Meet의 「Take notes for me」 역시 정확히 똑같은 8개 언어에서 제공됩니다. 태국어는 두 목록 어디에도 없습니다. 두 번 없습니다.
| 기능 | 태국어 지원 | 언어 수 | 통화 후 산출물이 남나 |
|---|---|---|---|
| 구글 번역 — Live translate | 예 | 74 | 아니요 |
| 구글 Meet — 번역 자막 | 예 | 69 | 화면에만; 자막을 녹화하면 영상에 구워짐 |
| Deepgram Nova-3 — 전사 | 예 (th, th-TH) | 기본 코드 58 | 예, 그 위에 만들어진 제품이 보관한다면 |
Deepgram Nova-3 — multi 코드 스위칭 | 아니요 | 10 | 해당 없음 |
| 구글 Meet — Transcripts | 아니요 | 8 | 예, 구글 문서 |
| 구글 Meet — 「Take notes for me」 | 아니요 | 8, 한 번에 하나 | 예, 문서 노트와 요약 메일 |
모든 행은 2026년 9월 1일에 확인한 벤더 문서 기준입니다.
Meet의 번역 자막에도 보존 경로가 하나 있고, 그건 인정해야 합니다. 회의를 녹화하면서 Record captions를 선택하면 자막이 영상 파일 안에 삽입됩니다. 하지만 구워진 자막은 어떤 쓸모 있는 의미에서도 기록이 아닙니다. 픽셀은 검색할 수 없고, 잘못 들린 협력사 이름을 그 안에서 고칠 수도 없으며, 거기서 요약을 뽑아낼 수도 없습니다. 그건 전사본의 사진일 뿐입니다.
도구가 정확히 부러지는 지점은 태국어–영어 혼용 문장이다
태국을 베트남 사례와 다르게 만드는 대목이 여기 있습니다. 문서만큼이나 직설적으로 말할 가치가 있죠.
Deepgram의 multi 코드 스위칭 모드 — 하나의 오디오 스트림 안에 같은 문장에서 두 언어가 들어 있어도 되게 해 주는 설정 — 는 정확히 열 개 언어를 다룹니다. 영어, 스페인어, 프랑스어, 독일어, 힌디어, 러시아어, 포르투갈어, 일본어, 이탈리아어, 네덜란드어. 태국어는 단일 언어로는 완전히 지원되는데도 그 안에 없습니다. 그러니까 Nova-3는 태국어 회의를 전사하고, 영어 회의도 전사하지만, 당신의 운영 리드가 「QC 리포트에서 배치 이슈가 잡혀서 선적을 15일로 미뤘습니다」에 해당하는 말을 하면서 QC report, batch, 그리고 날짜만 영어로 말하는 그 문장은 전사하도록 만들어지지 않았습니다.
태국에서 그 문장은 예외적인 사례가 아닙니다. 외국계 모회사를 둔 태국 사무실의 중앙값 문장입니다.
구글의 노트 작성 기능은 같은 한계를 더 평범한 말로 문서화합니다. 도움말 페이지는 이 기능이 「한 번에 한 가지 언어를 지원한다」라고, 그리고 「같은 회의에서 여러 언어를 말하는 경우는 현재 지원되지 않는다」라고 적습니다. 그래서 태국어와 영어를 오가는 방콕–도쿄 통화는 두 번 자격 미달입니다. 한 번은 태국어가 그 8개에 없어서, 또 한 번은 지원되는 언어들 사이에서조차 전환이 지원되지 않아서.
DeepL은 같은 문제의 세 번째 변주를 더합니다. DeepL Voice는 언어 지원을 발화 언어(인식기가 받아들이는 것)와 번역 언어(자막으로 표시될 수 있는 것)로 나눕니다. DeepL 자체 모델은 18개 발화 언어를 전사하고, 태국어는 그중에 없습니다. 태국어는 서드파티 제공자인 Speechmatics가 전사하는 20개 언어의 2군에 놓여 있고, 세 가지 조건이 붙습니다. 모두 2026년 9월 1일에 확인한 DeepL 도움말 페이지에 적혀 있는 내용입니다.
- 팀 관리자가 조직 관리자 계정에서 서드파티 데이터 처리를 먼저 켜야 이 언어들이 아예 작동하기 시작합니다.
- 자동 감지가 작동하지 않습니다. DeepL의 정확한 표현은 이렇습니다. 「서드파티 언어는 자동 언어 감지와 함께 작동하지 않습니다. 발화 언어로 수동 선택해야 합니다.」
- 참가자가 자기 발화 언어를 직접 고르게 하려면, 호스트가 액세스 코드를 켜야 합니다. 회의를 DeepL Voice에 연결할 때 설정하는 항목이죠.
DeepL은 이 구조에 대해 솔직합니다. Speechmatics는 무보존 계약 아래에서 운영되므로 전사 데이터는 처리 후 그들 서버에서 삭제됩니다. 세 조건 각각도 그 자체로는 부당하지 않습니다. 하지만 쌓아 놓으면 구체적인 결과가 나옵니다. DeepL이 붙은 회의에 들어온 태국어 화자는 관리자 설정 하나를 안 켠 것만으로 아예 전사되지 않는 상태가 되고, 시스템이 자기를 자동으로 알아봐 주리라고 기대할 수도 없습니다.
태국어 회의 정확도 수치를 내놓는 벤더는 없다. 태국의 한 연구팀이 원본 수치를 냈다.
저희는 태국어 회의 음성에 대한 벤더 공개 단어 오류율을 찾아 나섰습니다. 그런 건 없습니다. 대신 존재하는 것이 더 낫습니다. 대본을 읽는 사람이 아니라 실제 태국어 비즈니스 오디오에서 측정됐기 때문입니다.
Amity의 AI 연구팀은 2025년 8월 14일 백서를 공개하면서 두 개의 자체 데이터셋에서 태국어 음성 인식 파인튜닝을 문서화했습니다. 615개 구간의 콜센터 세트와 422개 구간의 보험 세트입니다. 이 둘 위에서 네 개 시스템을 벤치마크했죠.
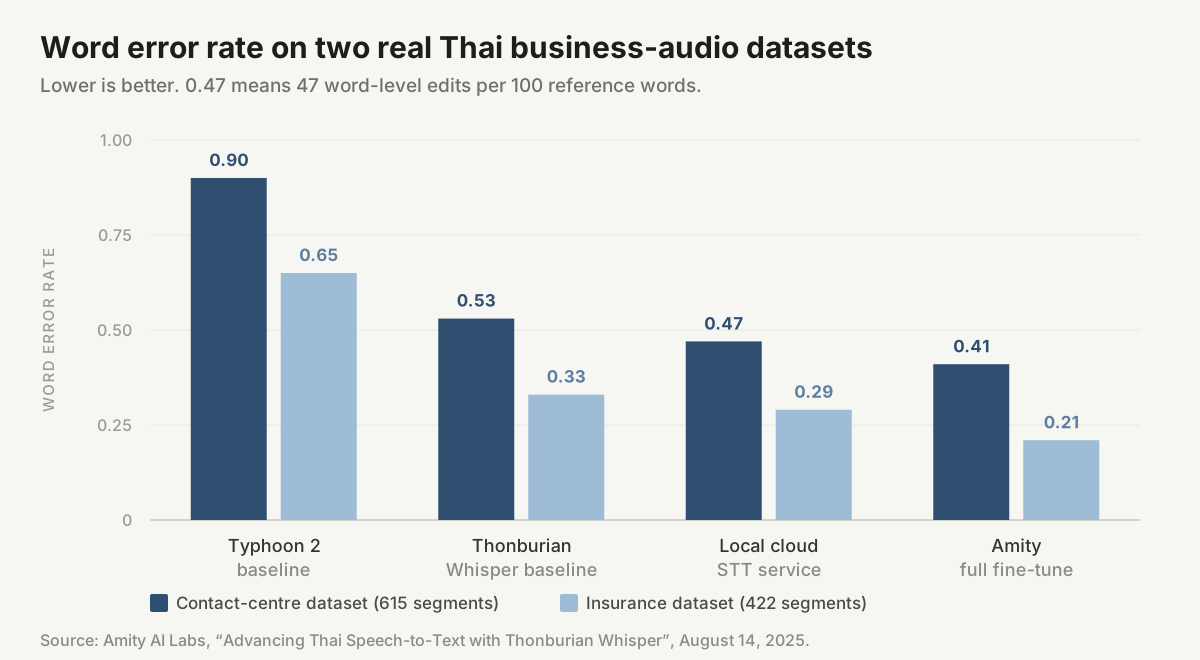
Amity의 2025년 8월 14일 백서에 실린 단어 오류율. 실제 태국어 비즈니스 오디오에서 기성 시스템들은 0.29에서 0.90 사이에 떨어집니다.
숫자가 곧 논증입니다. Typhoon 2는 콜센터 세트에서 WER 0.90을, 보험 세트에서 0.65를 기록했습니다. 그 자체로 Whisper의 태국어 특화 파인튜닝인 Thonburian Whisper는 0.53과 0.33이었습니다. 상용 로컬 클라우드 음성 인식 서비스는 0.47과 0.29였습니다. Amity 자신의 풀 파인튜닝은 0.41과 0.21에 도달했습니다.
단어 오류율 0.47은 대략 두 단어 중 하나를 손봐야 한다는 뜻입니다. 배경 소음과 전화 대역폭이 얹힌, 연습되지 않은 태국어 비즈니스 발화에 범용 시스템이 하는 일이 그겁니다. 「태국어 99% 정확도」를 주장하는 마케팅 페이지를 저 표 옆에 놓고 읽으면, 그 마케팅 페이지에 대해 뭔가를 알게 됩니다.
화자 분리도 같은 이야기를 합니다. Amity는 태국어 특화 적응 없이 표준 pyannote.audio 파이프라인을 자사 보험 오디오에 적용했을 때 화자 분리 오류율(DER)이 31.3%로 나왔다고 보고합니다. 주된 오류는 「겹치는 화자와 코드 스위칭 화자를 구분하는 데」 있었습니다. 프런트엔드를 적응시키자 같은 평가 세트에서 DER이 8.13%까지 떨어졌습니다. 코드 스위칭이 다시 등장합니다. 이번에는 화자 귀속 문제로서 말이죠. 화자가 발화 도중 언어를 바꾸는 순간, 기계는 누가 말했는지를 놓칩니다.
태국어의 구조적 특성 두 가지가 이 문제를 영어에서보다 어렵게 만듭니다. 첫째, 태국 문자는 띄어쓰기로 단어 경계를 표시하지 않습니다. 그래서 단어 분절은 Chormai, Prasertsom, Rutherford의 2019년 11월 16일 AttaCut 논문의 표현대로 「태국어 자연어 처리의 근본적인 전처리 단계」입니다. 인식기는 그 단어가 무엇이었는지 판단하기 전에 한 단어가 어디서 끝나는지를 먼저 정해야 하고, 그 모호함은 태국어 NLP가 서로 벤치마크를 겨루는 분절기들의 하위 문헌을 통째로 거느릴 만큼 실재합니다. 둘째, 태국어는 성조 언어입니다. 의미가 음높이 곡선에 실리기 때문에, 성조를 잘못 들은 시스템은 살짝 틀린 단어를 돌려주지 않습니다. 아예 무관한 단어를 돌려줍니다.
여기서 나오는 운영상의 결론은 「음성 인식을 쓰지 마라」가 아닙니다. 1차 태국어 전사본에는 오류가 들어 있다고 전제하고, 사람이 그것을 보고 고칠 수 있는 워크플로를 사라 입니다. 그러려면 우선 전사본이 존재해야 하고, 편집 가능해야 하며, 내일도 그 자리에 있어야 합니다.
기록이 살아남도록 태국어–영어 회의를 진행하는 법
일곱 단계, 실제로 일어나는 순서대로입니다. 각 단계는 위에서 문서화한 특정 실패에 대응합니다.
- 도구를 정하기 전에 걸린 것이 무엇인지부터 정하세요. 문장 하나가 틀렸을 때 법적·의학적·계약적 노출이 생긴다면 사람 통역사를 쓰세요. 그리고 계속 읽으세요. 아래의 기록 관련 단계들은 그 회의에도 그대로 적용되니까요. 통역사는 그 방을 책임집니다. 통역사를 쓴다고 해서 회의가 끝난 뒤 문서가 생기지는 않습니다.
- 이해라는 일과 기록이라는 일을 분리하고, 둘이 서로 다른 도구라는 걸 받아들이세요. 오늘날 태국어 이해는 구글 번역이나 Meet 자막이 처리합니다. 어느 쪽도 오래 남는 태국어 기록을 만들지 않습니다. 하나의 도구로 둘 다 하려는 시도가, 팀이 결국 둘 다 못 갖게 되는 경로입니다.
- 통역된 한 시간을 정직하게 예산에 넣으세요. 연속 통역을 예약하고 있다면 안건 길이의 두 배를 잡고 참가자들에게 진짜 종료 시각을 알리세요. 6,000바트짜리 4시간 반일은 두 시간짜리 안건을 감당하는 것이지 네 시간짜리 안건을 감당하는 게 아닙니다.
- 태국어를 발화 언어로 명시적으로 설정하고, 자동 감지에 절대 의존하지 마세요. DeepL Voice에서는 이게 필수입니다. 태국어는 서드파티 언어이고 자동 감지가 적용되지 않으니까요. 다른 곳에서도 여전히 이쪽이 낫습니다. 자동 감지는 세션 전체에서 맥락이 가장 적은 오디오, 즉 처음 몇 초에 추측을 확정해 버리기 때문입니다.
- 플랫폼이 아니라, 실제로 글을 쓰는 그 기능의 언어 목록을 확인하세요. 이 글 전체가 설명하려는 함정이 바로 이겁니다. 구글 Meet는 태국어를 지원합니다. 구글 Meet의 전사본은 지원하지 않습니다. 69 대 8이 그 두 문장 사이의 거리입니다.
- 통화 전에 코드 스위칭 문제를 소리 내어 선언하세요. 팀이 영어 제품명, 티켓 ID, 부품 번호를 태국어 문장에 섞어 넣는다면 — 외국계 모회사를 둔 태국 팀은 전부 그렇게 합니다 — 기록 도구가 한 세션에서 두 언어를 견디는지 확인하세요. Nova-3의
multi모드에는 태국어가 없고, Meet의 노트 작성 기능은 혼합 언어 회의를 대놓고 거부합니다. - 이름과 숫자는 처음 5분 안에, 실시간으로 고치세요. 태국어 고유명사와 영어 제품 코드명은 전사가 어김없이 실패하는 두 곳이자, 한 줄이 틀렸을 때 그 위에 쌓아 올린 어떤 요약에도 가장 큰 피해를 주는 두 곳입니다. 회의 중에 고치면 몇 초입니다. 다음 주에 요약을 고치려 들면 말싸움 한 판입니다.
시장 분석 말고 7단계의 워크플로 버전이 궁금하다면, 6월에 쓴 가이드가 태국어 회의를 검토 가능한 액션 아이템으로 바꾸는 과정을 처음부터 끝까지 짚습니다. 그리고 실시간 회의 번역 솔루션 페이지는 실시간 계층과 기록 계층이 어떻게 연결되는지를 다룹니다.
그래도 사람을 써야 하는 때를 그대로 말한다
도구가 모든 방에서 이긴다고 우기지 않겠습니다. 그러니 저희가 실제로 긋는 경계선을 여기 적습니다.
번역이 틀렸을 때 정정으로 되돌릴 수 없는 결과가 따라오는 자리에서는 전문 통역사를 쓰세요. 법원과 중재 절차, 이민·대사관 면접, 진료 상담, 이사회 수준의 M&A 협상, 규제 감사, 그리고 상대방이 나중에 당신이 한 말을 인용할 모든 대화가 여기 들어갑니다. 방이 커서 휴대폰 화면이 전달 수단이 되지 못할 때도 사람을 쓰세요. 어휘의 정확성만큼 문화적 중재가 중요할 때도 마찬가지입니다. 태국어의 비즈니스 화법에는 위계와 체면이 직역으로는 평평해지는 방식으로 실려 있고, 좋은 통역사는 그것을 실시간으로 관리하고 있습니다.
도구를 쓰세요. 회의가 내부용이고, 반복되고, 운영성이고, 3주 전 예약과 다섯 자리 바트 청구서가 필요했다면 아예 열리지도 않았을 회의라면 말이죠. 그게 회의의 대다수이고, 기록이 가장 중요한 구간이기도 합니다. 애초에 아무도 회의록을 쓸 생각이 없었던 자리니까요.
통역사와 기록은 서로 경쟁하는 구매가 아니다
여기까지 온 대부분의 글은 이 선택을 양자택일로 제시하는데, 그 프레이밍이 틀렸습니다. 더 날카로운 입장은 통역사 더하기 기록 어시스턴트입니다. 전문가를 반드시 써야 하는 고위험 회의에서도 기계는 자기 자리값을 합니다. 옆에서 조용히 돌아가며, 통역사가 하러 온 일이 아닌 세 가지 일을 하죠.
하나, 참조용 기록. 통역사의 산출물은 말해지고 사라집니다. 전사 계층은 원어 오디오를 텍스트로 보존하고 그 옆에 기계 번역을 붙여 둡니다. 그래서 3주 뒤 쟁점이 생겼을 때 영어 버전에 대한 누군가의 기억이 아니라 태국어로 실제 무엇이 말해졌는지를 대조할 수 있습니다. 이게 가장 중요한 곳은 바로 통역사를 쓸 만한 자리들입니다. 나중에 그 회의를 당신 앞에 인용해 올 사람이 있는 자리이기 때문이죠.
둘, 방 안 사람들을 위한 어시스턴트. 통역사 본인도 포함해서요. 연속 통역은 시간 압박을 받으면 압축됩니다. 그리고 가장 먼저 떨어져 나가는 것은 문법적 무게는 없는데 운영상의 무게는 전부 지고 있는 디테일입니다. 부품 번호, 날짜, 퍼센트, 회사 이름, 낯선 기술 용어 같은 것들이죠. 이건 통역사에 대한 비판이 아니라 그 과업의 문서화된 형태입니다. 검토 가능한 실시간 전사본이 있다면 그 숫자가 담긴 문장이 지나간 뒤에도 숫자는 화면에 남고, 「15일」을 잘못 들은 것 같다고 생각한 참가자는 끼어드는 대신 확인할 수 있습니다.
셋, 회의 이후의 계층. 통역사는 회의록을 쓰지 않습니다. 그건 그들의 일이 아니고, 부탁해서도 안 됩니다. 요약, 액션 아이템, 검색 가능한 결정 기록은 통역사가 떠난 뒤에 벌어지는 일이고, 오늘날 그것은 방에서 가장 직급이 낮은 사람이 손으로 하거나 아예 하지 않은 채로 남습니다.
다만 위계는 정직하게 유지해야 합니다. 이 관계는 한 방향으로만 흐르니까요. 기계의 산출물은 보조하고 보관합니다. 방 안의 전문가를 뒤엎지 않습니다. 법적·의학적 상황에서 전사본과 통역사가 어긋나면, 권위는 통역사에게 있고 전사본은 확인하러 가는 대상입니다. 기록은 동등한 지위의 제2 의견이 아니라 참조할 증거로 다루세요.
이 카테고리가 애초에 태국에 존재하는 이유를 설명해 주는 맥락이 하나 더 있습니다. EF의 2025년 영어 능력 지수에서 태국은 세계 평균 488점 대비 402점을 받아 116위에 올랐고, 말하기 하위 점수는 377이었습니다. 방법론을 어떻게 평가하든 방향만큼은 논쟁거리가 아닙니다. 태국의 대외 비즈니스 회의 상당수가 최소한 한쪽은 힘겨워하는 언어로 진행됩니다. 그 방에 있는 모두는 아드레날린이 가라앉은 뒤에 무엇이 합의됐는지를 자기 언어로 다시 읽을 수 있어야 합니다.
결론: 태국은 이해를 해결하고 기억을 건너뛰었다
10년 동안 국제 비즈니스에서 태국어에 대한 불만은 기술이 태국어를 알아듣지 못한다는 것이었습니다. 2026년에 그 불만은 대체로 만료됐습니다. 태국어는 Live translate의 74개 안에, Meet의 69개 안에, Nova-3의 58개 안에, 삼성의 Interpreter 안에, DeepL의 자막 언어 안에 있습니다. 이해는 처리됐고, 대개 무료입니다.
움직이지 않은 것은 기록입니다. 오래 남는 산출물을 만드는 두 개의 구글 기능은 둘이 합쳐 8개 언어를 지원하고 — 서로 똑같은 8개 — 태국어는 어느 쪽에도 없습니다. 한 문장 안에서 두 언어를 섞으라고 만들어진 유일한 모드는 10개를 다루고, 태국어는 거기에도 없습니다. 실제 비즈니스 오디오에서 공개된 태국어 단어 오류율은 0.21에서 0.90까지 벌어지는데, 그 차이는 전적으로 누군가 모델을 태국어에 맞춰 손봤느냐에 달려 있습니다. 그리고 이해 문제를 그 무엇보다 잘 푸는 사람 통역사는, 회의 전체를 머릿속에 담은 채로 방을 나갑니다.
그러니 벤더에게 던질 질문은 「태국어를 지원하나요」가 아닙니다. 이제 거의 전부가 그렇다고 답하고, 거의 전부가 듣기 쪽 절반을 뜻합니다. 진짜 질문은 이겁니다. 통화가 끝난 뒤에도 태국어를 지원하는 기능은 어느 것이고, 중간에 영어가 섞인 태국어 문장을 견디는 기능은 어느 것이며, 바로 그 기능들의 언어 목록을 보여 주실 수 있습니까?
Telli.sh는 어디에 들어맞나: 기록 계층이 바로 저희가 만드는 계층입니다. Telli.sh는 회의를 실제로 말해진 언어 그대로 전사하고, 태국어를 포함한 44개 대상 언어로 번역하며, 세 가지 산출물을 같은 노트 안에 함께 보관합니다. 태국어 원문, 거기에 정렬된 번역, 그 위에서 생성된 요약이죠. 이름이 잘못 나왔을 때 셋 다 편집할 수 있습니다. 인터페이스 자체도 태국어를 포함해 15개 언어로 제공되기 때문에, 방콕의 팀과 오사카의 고객이 같은 회의를 각자의 언어로 읽으면서도 수정 가능한 하나의 기록을 공유합니다.
출처
- Sawadee Translations, Interpreting Services, 2026년 9월 1일 확인 — 연속 통역 시간당 3,000바트부터, 동시통역 시간당 5,000바트부터, 그리고 대부분의 법적 절차와 대사관 면접이 연속 통역을 쓴다는 서술.
- Y LINK / Personnel Consultant, Interpretation (Japanese, English, Thai, Chinese), 2026년 9월 1일 확인 — 현장 반일·종일 요금표, 온라인 동시통역 60분당 3,000바트와 연속 통역 60분당 2,000바트, 반일/종일 정의, 태국 노동법 초과 근무 산식, 그리고 취소 위약 사다리.
- Acolad, "Simultaneous vs Consecutive Interpreting: Which One Do You Need?", 2026년 4월 24일 — 1~5분 단락 길이, 그리고 「연속 통역 세션은 모든 발언이 두 번 전달되기 때문에 소요 시간이 대략 두 배가 된다」.
- Elite Asia, "Simultaneous vs. Consecutive Interpretation: How to Choose for Your Event", 2026년 9월 1일 확인 — 각 모드의 장비 구성 정리.
- Google Translate Help, "Hear live speech to speech translations with Live translate", 2026년 9월 1일 확인 — 태국어를 포함한 74개 언어 목록, 네 가지 모드, 마주 보기 모드, 백그라운드 유지.
- Google Meet Help, "Use translated captions in Google Meet", 2026년 9월 1일 확인 — 태국어를 포함한 69개 언어 목록, 유료 Workspace 에디션, Record captions.
- Google Meet Help, "Use Transcripts with Google Meet", 2026년 9월 1일 확인 — 전사가 지원되는 8개 언어.
- Google Meet Help, "'Take notes for me' in Google Meet", 2026년 9월 1일 확인 — 똑같은 8개 언어, 그리고 「한 번에 한 가지 언어만 지원한다」.
- Samsung, Call assist: Live translate calls on your Galaxy phone, 2026년 9월 1일 확인 — 지원 언어 목록의 태국어, 그리고 한 번에 한 사람만 쓰라는 단서.
- Deepgram, Models & Languages Overview, 2026년 9월 1일 확인 — Nova-3와 Nova-2 표의 태국어
th,th-TH, 서로 다른 기본 언어 코드 58개, 그리고 10개 언어짜리multi코드 스위칭 목록. - DeepL Help Center, "DeepL Voice languages", 2026년 9월 1일 확인 — DeepL이 직접 전사하는 발화 언어 18개, 태국어를 포함한 서드파티 발화 언어 20개, 관리자 토글, 자동 감지 제약, 액세스 코드 요건, 그리고 Speechmatics 무보존 계약.
- Amity AI Labs, "Advancing Thai Speech-to-Text with Thonburian Whisper", 2025년 8월 14일 — 615개 구간의 콜센터 데이터셋과 422개 구간의 보험 데이터셋, WER 표, 그리고 화자 분리 오류율 31.3% → 8.13% 결과.
- Chormai, Prasertsom and Rutherford, "AttaCut: A Fast and Accurate Neural Thai Word Segmenter", 2019년 11월 16일 제출 — 태국어 NLP의 근본적인 전처리 단계로서의 단어 분절.
- EF Education First, EF English Proficiency Index — Thailand, 2025년판, 2026년 9월 1일 확인 — 세계 116위, 세계 평균 488점 대비 402점, 말하기 하위 점수 377.