Nova-3 dodała w tym miesiącu 58. język. Tylko 10 z nich działa w jednym zdaniu.
4 sierpnia 2026 Deepgram dodał do Nova-3 pendżabski i nepalski; 7 sierpnia doszedł ormiański oraz ulepszone modele dla tamilskiego, indonezyjskiego i białoruskiego. Dziewięć miesięcy temu model obejmował 31 języków — dziś dokumentacja wymienia 58. Ale przełączanie kodów działa dokładnie w 10, a sierpniowy changelog pokazuje, że indonezyjski poprawiono tylko w trybie wsadowym, a białoruski tylko w strumieniowym. Przyglądamy się tempu poszerzania obsługi języków w rozpoznawaniu mowy — i temu, co naprawdę ukrywa słowo „obsługiwany”.
4 sierpnia 2026 roku Deepgram dodał pendżabski i nepalski do swojego modelu rozpoznawania mowy Nova-3. Trzy dni później doszedł ormiański, a wraz z nim ulepszone modele jednojęzyczne dla tamilskiego, indonezyjskiego i białoruskiego.
Dwa wpisy w changelogu, jedenaście linijek tekstu razem, zero komunikatów prasowych. A dla każdego, kto prowadzi spotkania w tych językach, to najważniejsza rzecz, jaka wydarzyła się w rozpoznawaniu mowy w tym miesiącu.
Wzorzec stojący za tymi wpisami jest wart więcej niż same wpisy. W grudniu 2025 roku własne release notes Deepgrama podawały dla Nova-3 31 języków. Policzenie odrębnych bazowych kodów językowych w dokumencie Models & Languages Overview dzisiaj, 31 sierpnia 2026 roku, daje 58. W takim tempie porusza się cała branża — i po cichu zmieniło to, czego powinieneś oczekiwać od transkrypcji.
Ten wpis robi trzy rzeczy. Podpiera tę ekspansję liczbami i datami ze źródeł pierwotnych. Wyjaśnia, dlaczego sama liczba języków z nagłówka jest niemal bezużyteczna — i jakie trzy pytania trzeba zadać zamiast niej. Oraz pokazuje konkretnie, co sierpniowe dodatki zmieniają na spotkaniu, na którym w sali siedzą osoby mówiące po pendżabsku, nepalsku, ormiańsku, tamilsku lub indonezyjsku.
TL;DR:
- 58 kontra 31. Dokumentacja Nova-3 wymieniała 31 języków 10 grudnia 2025 roku i 58 odrębnych bazowych kodów językowych 31 sierpnia 2026 roku — 39 języków dodanych w dziewięciu datowanych wpisach changelogu.
- Zasięg to nie jedna liczba. Tryb przełączania kodów
language=multiw Deepgramie obejmuje dokładnie 10 języków (angielski, hiszpański, francuski, niemiecki, hindi, rosyjski, portugalski, japoński, włoski, niderlandzki). Pozostałych 48 działa wyłącznie po jednym języku naraz.- Tryb wsadowy i strumieniowy to osobne produkty. Wydanie z 7 sierpnia poprawiło tamilski w obu, indonezyjski tylko wsadowo, a białoruski tylko strumieniowo. Ten sam wpis w changelogu, trzy różne skutki.
- Model jednojęzyczny nadal wygrywa. Dla 48 z 58 języków Nova-3 dedykowany model jest nie tylko lepszy od trybu wielojęzycznego — jest jedyną istniejącą opcją.
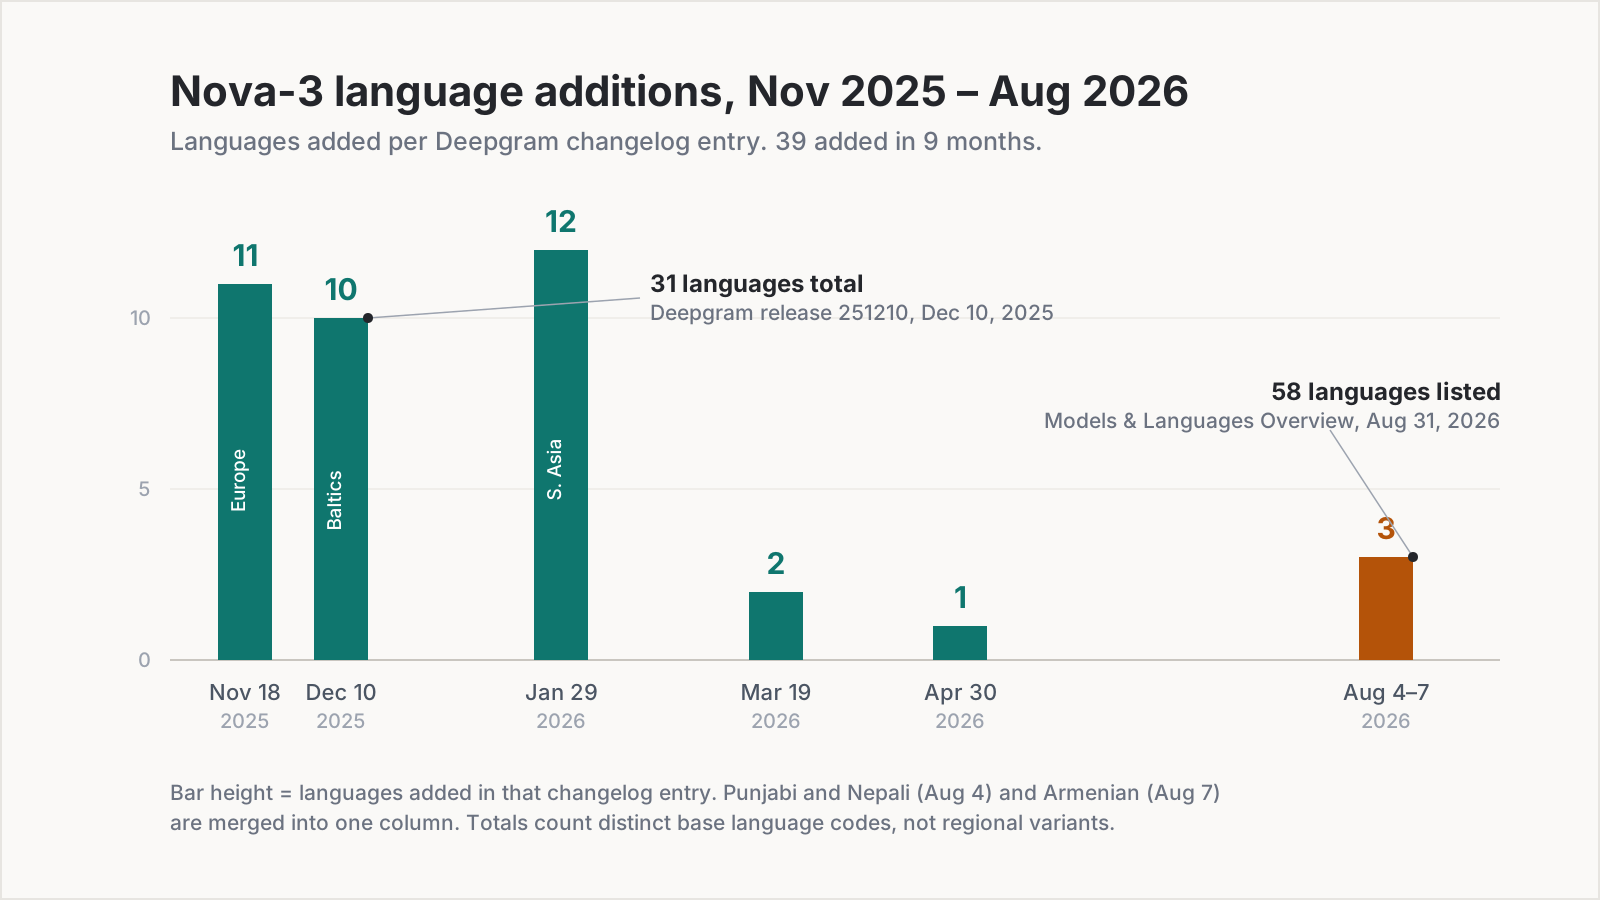
Wykres: Telli.sh, na podstawie wpisów changelogu Deepgrama z okresu od 18 listopada 2025 do 10 sierpnia 2026 oraz dokumentu Models & Languages Overview pobranego 31 sierpnia 2026.
Trzydzieści jeden języków w grudniu, pięćdziesiąt osiem w sierpniu
Dostawcy rozpoznawania mowy rzadko ogłaszają zasięg językowy tak, jak ogłaszają dokładność. Informacja pojawia się w release notes, po kilka języków naraz, a efekt skumulowany łatwo przeoczyć, jeśli nie cofniesz się i wszystkiego nie zsumujesz. Zrobiliśmy to za ciebie.
Wydanie Deepgrama 251118 z 18 listopada 2025 roku rozszerzyło jednojęzyczną obsługę Nova-3 o 11 nowych języków — bułgarski, czeski, fiński, hindi, węgierski, japoński, koreański, polski, rosyjski, ukraiński i wietnamski. Wydanie 251210, trzy tygodnie później, 10 grudnia 2025 roku, dołożyło kolejne 10 z południa Europy, krajów bałtyckich i Azji Południowo-Wschodniej: grecki, rumuński, słowacki, kataloński, litewski, łotewski, estoński, flamandzki, szwajcarski niemiecki i malajski. To właśnie w tych release notes znajduje się najbardziej użyteczne zdanie całej tej historii: „Nova-3 obsługuje teraz łącznie 31 języków”.
Potem kolejne języki pojawiały się bez przerwy. Wydanie 260129 z 29 stycznia 2026 roku dodało 12 następnych, w tym białoruski, bengalski, bośniacki i chorwacki. Wydanie 260319 z 19 marca 2026 roku przyniosło tajski i kantoński. Wydanie 260430 z 30 kwietnia 2026 roku dołożyło gudżarati. A potem sierpień: pendżabski i nepalski 4 dnia miesiąca, ormiański 7 dnia.
Zsumuj udokumentowane dodatki od 18 listopada 2025 do 10 sierpnia 2026, a wyjdzie ci 39 języków w niecałe dziewięć miesięcy. To mniej więcej jeden nowy język co siedem dni, nieprzerwanie, u jednego dostawcy.
Jest tu jeszcze jeden szczegół wart uwagi, bo mówi coś o tym, jak te wydania faktycznie do ciebie docierają. Changelog chmurowy datuje dodanie pendżabskiego i nepalskiego na 4 sierpnia 2026 roku. Wydanie self-hosted, które pakuje te same modele — 260812 — nosi datę 12 sierpnia. Osiem dni opóźnienia między hostowanym API a obrazem kontenera. Jeśli uruchamiasz Deepgrama na własnym sprzęcie, „obsługiwany” przyszło do ciebie ponad tydzień później niż do wszystkich innych.
„Obsługiwany” to nie jedna rzecz — to trzy pytania
Teraz część, którą liczby z nagłówków skutecznie zasłaniają. Kiedy dostawca mówi, że język jest obsługiwany, to jedno słowo wykonuje co najmniej trzy różne zadania — i te zadania nieustannie się rozjeżdżają.
Czy możesz go używać w czasie rzeczywistym, czy dopiero po fakcie? Transkrypcja wsadowa i strumieniowa działają na różnych modelach o różnych ograniczeniach. Model strumieniowy musi zdecydować się na słowo, zanim usłyszy koniec zdania; model wsadowy dostaje całe nagranie. Dostawcy wypuszczają je osobno i wcale nie zawsze razem.
Jak dobry jest ten model naprawdę? „Obsługiwany” mówi ci, że kod zostanie przyjęty, a nie że wynik nadaje się na posiedzenie zarządu. Język dodany w zeszłym miesiącu i język po czterech rundach ulepszeń trafiają do tej samej komórki tabeli.
Czy da się go mieszać z innym językiem? Tego prawie nikt nie sprawdza, dopóki się nie wywali. Transkrybowanie spotkania, na którym wszyscy mówią po nepalsku, to zupełnie inny problem techniczny niż transkrybowanie spotkania, na którym ludzie przeskakują między nepalskim a angielskim w środku zdania — a ten drugi problem rozwiązano dla znacznie mniejszej liczby języków.
Sierpniowy changelog to najczystsza ilustracja pierwszego pytania, jaką widzieliśmy od roku. Wpis z 7 sierpnia poprawił cztery rzeczy i nie poprawił ich jednakowo.
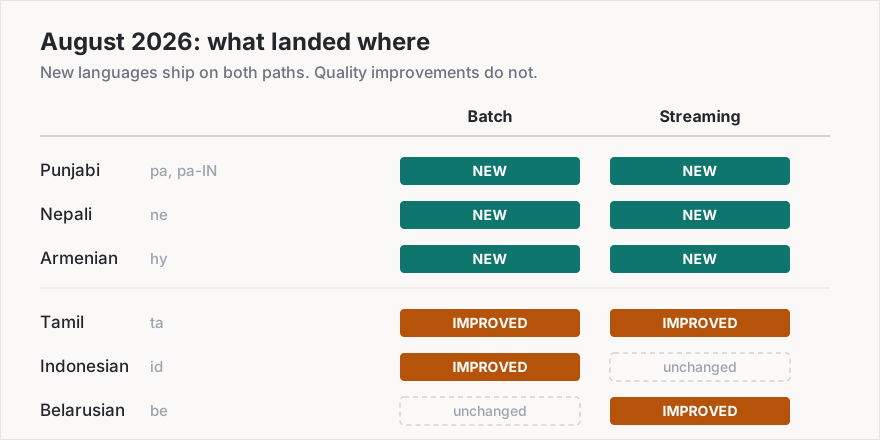
Wykres: Telli.sh, na podstawie wpisów changelogu Deepgrama z 4 i 7 sierpnia 2026.
Pendżabski, nepalski i ormiański weszły obiema ścieżkami — Deepgram stwierdza wprost, że „modele wsadowe i strumieniowe są dostępne dla tych języków”. Tamilski dostał ulepszony model zarówno wsadowy, jak i strumieniowy. Indonezyjski dostał ulepszony model wsadowy i nic nowego dla strumieniowego. Białoruski dostał ulepszony model strumieniowy i nic nowego dla wsadowego.
Jeśli transkrybujesz nagrane wywiady po indonezyjsku, 7 sierpnia był dla ciebie dobrym dniem. Jeśli prowadzisz indonezyjskie spotkania na żywo, 7 sierpnia nie zmienił nic. Oba fakty mieszczą się w jednej liście punktowanej w jednym wpisie changelogu i żadne streszczenie tego wpisu nie powie ci, który z nich dotyczy właśnie ciebie.
Ta asymetria to nie niechlujstwo. Odzwierciedla fakt, że to naprawdę są różne modele, z różnym treningiem i różnym budżetem na walidację — i jest to najmocniejszy pojedynczy argument za czytaniem changelogów dostawców na poziomie pojedynczego języka, a nie nagłówka.
Klif zasięgu: 58 języków, 10 rozmów
Teraz trzecie pytanie — a to właśnie tam mieszka najciekawsza luka.
Wielojęzyczny tryb przełączania kodów Deepgrama włącza się jednym parametrem, language=multi, i pozwala jednemu żądaniu obsłużyć mówców przeskakujących między językami w środku zdania. Jest naprawdę użyteczny i jest dostępny w Nova-2, Nova-3 oraz Flux Multilingual. Jest też znacznie węższy niż katalog jednojęzyczny.
W Nova-3 language=multi obejmuje dokładnie dziesięć języków: angielski, hiszpański, francuski, niemiecki, hindi, rosyjski, portugalski, japoński, włoski i niderlandzki. W Nova-2 ten sam parametr obejmuje dwa — hiszpański i angielski.
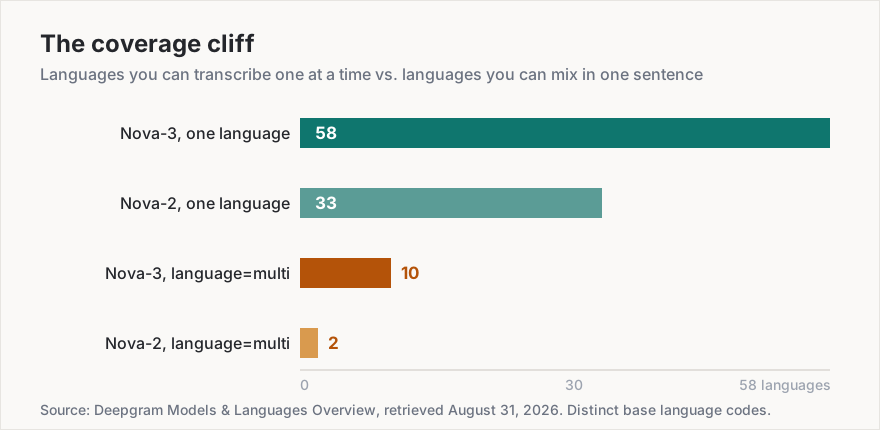
Wykres: Telli.sh, na podstawie dokumentu Deepgram Models & Languages Overview pobranego 31 sierpnia 2026. Zliczono odrębne bazowe kody językowe, z pominięciem wariantów regionalnych i pisma.
Nazwijmy to klifem zasięgu: różnicą między językiem, który dostawca wymienia na liście, a językiem, w którym obsłużone zostanie twoje prawdziwe, pogmatwane, w połowie angielskie spotkanie. Na szczycie klifu stoi pięćdziesiąt osiem języków. Upadek przeżywa dziesięć.
Dla 48 języków po niewłaściwej stronie — pendżabskiego, nepalskiego, ormiańskiego, tamilskiego, bengalskiego, tajskiego, koreańskiego, wietnamskiego, malajskiego i całej reszty — dedykowany model jednojęzyczny nie jest po prostu lepszym wyborem. Jest jedynym wyborem. Nie ma ścieżki z przełączaniem kodów, z którą można by go porównać.
I tu jest sedno, wbrew intuicji podpowiadającej, że tryb wielojęzyczny jest po prostu bardziej zaawansowany: dla większości języków świata to model jednojęzyczny jest opcją zaawansowaną, a nie awaryjną. Dedykowany model jest trenowany na fonetyce jednego języka, na rozkładzie słownictwa jednego języka, na liczebnikach i datach jednego języka. Model wielojęzyczny musi utrzymać dziesięć takich układów w napięciu i rozstrzygać, słowo po słowie, który z nich właśnie słyszy. Kiedy wiesz, że spotkanie jest po tamilsku, powiedzenie tego silnikowi nie jest ograniczeniem, które akceptujesz — to najdokładniejsza konfiguracja, jaka jest dla ciebie dostępna.
language=multi (przełączanie kodów) | Dedykowany model językowy | |
|---|---|---|
| Zasięg językowy Nova-3 | 10 języków | 58 języków |
| Zasięg językowy Nova-2 | 2 języki (hiszpański + angielski) | 33 języki |
| Obsługa zmiany języka w środku zdania | Tak | Nie — mowa w obcym języku pogarsza wynik |
| Dokładność dla jednego znanego języka | Niższa; model rozstrzyga między kandydatami | Wyższa; model jest wyspecjalizowany |
| Keyterm prompting | Tak w Nova-3 Multi, do 500 tokenów (~100 słów), od 10 grudnia 2025 | Tak |
| Zalecane ustawienie strumieniowe | endpointing=100 według przewodnika Deepgrama | Domyślny endpointing |
| Dostępny dla pendżabskiego, nepalskiego, ormiańskiego, tamilskiego | Nie | Tak |
Praktyczny wniosek z tej tabeli: jeśli twoje spotkanie faktycznie miesza angielski i hiszpański zdanie po zdaniu, użyj multi i pogódź się z kompromisem w dokładności. Jeśli twoje spotkanie jest po tamilsku z okazjonalnymi angielskimi zapożyczeniami — a właśnie tym są w praktyce niemal wszystkie „wielojęzyczne” spotkania — ustaw language=ta i pozwól dedykowanemu modelowi wykonać swoją pracę.
Kto realnie dostaje lepsze spotkanie w tym miesiącu
Dość architektury. Sześć języków zmieniło status w sierpniu 2026 roku, a za każdym kodem stoi populacja, która dotąd transkrybowała spotkania źle albo wcale.
| Język | Kod | Mówiący | Co zmieniło się w sierpniu 2026 |
|---|---|---|---|
| Pendżabski | pa, pa-IN | ~125 mln | Nowy w Nova-3, tryb wsadowy i strumieniowy (4 sierpnia) |
| Nepalski | ne | ~16 mln | Nowy w Nova-3, tryb wsadowy i strumieniowy (4 sierpnia) |
| Ormiański | hy | ~6,7 mln | Nowy w Nova-3, tryb wsadowy i strumieniowy (7 sierpnia) |
| Tamilski | ta | ~75 mln rodzimych użytkowników | Ulepszony model, tryb wsadowy i strumieniowy (7 sierpnia) |
| Indonezyjski | id | ~199 mln łącznie z drugim językiem | Ulepszony model tylko wsadowy (7 sierpnia) |
| Białoruski | be | ~7,6 mln | Ulepszony model tylko strumieniowy (7 sierpnia) |
Dane o liczbie mówiących: statystyki Ethnologue zagregowane w Wikidanych (właściwość P1098), pobrane 31 sierpnia 2026. Zaokrąglone.
To mniej więcej 430 milionów ludzi, których język w ciągu jednego tygodnia dostał wymiernie lepsze rozpoznawanie mowy — a około 148 milionów z nich, użytkownicy pendżabskiego, nepalskiego i ormiańskiego, przeszło od braku jakiejkolwiek pełnoprawnej opcji w Nova-3 do posiadania jej w obu trybach naraz.
Zastanów się, co to znaczy w sali. Standup zespołu inżynierskiego z Ćandigarhu, dotąd prowadzony w drugim języku dla wygody narzędzi albo w ogóle nietranskrybowany, produkuje teraz transkrypcję w czasie rzeczywistym. Terenowa odprawa organizacji pozarządowej z Katmandu staje się przeszukiwalnym zapisem zamiast czyichś odręcznych notatek. Ormiańskie zeznanie procesowe można transkrybować na żywo, zamiast wysyłać je do ręcznego przepisania po stawce za minutę.
Jest tu efekt drugiego rzędu, który znaczy więcej niż sama transkrypcja. Gdy mowa w danym języku staje się maszynowo czytelna w czasie rzeczywistym, cała reszta odblokowuje się naraz: tłumaczenie na żywo dla zdalnych uczestników, automatyczne podsumowania, wyciągnięte zadania do wykonania, wyszukiwanie w rocznym archiwum spotkań. Rozpoznawanie mowy jest wąskim gardłem. Każdy język, który je pokona, dziedziczy cały pipeline zbudowany dla angielskiego.
Jeśli pracujesz w zespole, w którym ktoś nawykowo przechodzi na angielski, bo „narzędzie nie ogarnia naszego języka”, to jest ta aktualizacja, która kończy ten konkretny kompromis.
Jak wybrać ustawienie języka dla wielojęzycznego spotkania
Ulepszenia silnika pomogą tylko wtedy, gdy poprawnie skonfigurujesz sesję, a domyślne ustawienia są dla zespołów wielojęzycznych często po prostu złe. Pięć kroków, po kolei:
- Ustal, czy spotkanie ma jeden dominujący język, czy naprawdę miesza. Okazjonalne angielskie zapożyczenia w tamilskim spotkaniu to jeden język. Naprzemienne całe zdania po hiszpańsku i angielsku to dwa. Tylko ten drugi przypadek wymaga przełączania kodów.
- Jeśli to jeden język, ustaw go jawnie. Użyj
model=nova-3z konkretnym kodem —language=padla pendżabskiego,language=nedla nepalskiego,language=hydla ormiańskiego. Nie zostawiaj automatycznego wykrywania; znasz odpowiedź, a przekazanie jej modelowi nic nie kosztuje. - Jeśli naprawdę miesza, sprawdź języki na liście dziesięciu. Ustaw
language=multitylko wtedy, gdy każdy język obecny w sali znajduje się wśród: angielski, hiszpański, francuski, niemiecki, hindi, rosyjski, portugalski, japoński, włoski, niderlandzki. Jeśli któregoś tam nie ma,multici nie pomoże, a model języka dominującego jest najlepszą dostępną opcją. - Dla sesji na żywo z
multiustawendpointing=100. Własny przewodnik Deepgrama po przełączaniu kodów zaleca 100 ms właśnie dla tego scenariusza, wbrew wyższej wartości domyślnej. Dłuższy endpointing sprawia, że fraza w przełączonym języku zostaje wchłonięta przez niewłaściwy segment. - Zweryfikuj tryb wsadowy i strumieniowy osobno, zanim cokolwiek obiecasz. Jak pokazał 7 sierpnia, ulepszenie jednego nie jest ulepszeniem drugiego. Przepuść tę samą 10-minutową próbkę obiema ścieżkami i porównaj, zamiast zakładać, że wpis w changelogu dotyczy twojej ścieżki.
Inny wycinek tego tematu omawialiśmy w czerwcu — Deepgram's mid-year update on adaptive live sessions and diarization, łącznie z kontrolką UpdateListen, która pozwala działającej sesji zmienić podpowiedzi językowe bez ponownego łączenia. Krok 2 powyżej i ta funkcja dobrze się składają: ustaw język jawnie na starcie i skoryguj go w trakcie spotkania, jeśli sala faktycznie się przestawi.
Konkluzja: zasięg przestał być liczbą, a stał się macierzą
Odruch przy porównywaniu silników mowy to szukanie największej liczby. Tokenizer Whispera od OpenAI deklaruje 100 tokenów językowych od 2022 roku — niemal dwa razy więcej niż 58 w Nova-3 — i to porównanie nie mówi ci prawie nic, bo Whisper nie ma natywnej ścieżki strumieniowej, a zadeklarowany token to nie zwalidowany model produkcyjny. Nova-3 wymienia mniej języków, ale je dostarcza: język po języku, tryb po trybie, z datowanym dowodem.
Liczba opisująca realny zasięg silnika nie jest zliczeniem. Jest macierzą: język × tryb × poziom jakości. Pięćdziesiąt osiem języków po jednym naraz. Dziesięć z nich mieszalnych. Jeden język poprawiony wsadowo, ale nie strumieniowo, drugi strumieniowo, ale nie wsadowo — w tym samym wydaniu, tego samego dnia.
Pytanie, z którym warto iść na kolejną ocenę dostawcy, nie brzmi więc „ile języków obsługujecie”. Brzmi: dla mojego języka, na mojej ścieżce, na jaki dzień?
Gdzie w tym wszystkim jest Telli.sh: wszystko powyższe to szczegóły warstwy silnika i uważamy, że większość zespołów w ogóle nie powinna musieć ich znać. Telli.sh siedzi nad tą warstwą i podejmuje decyzje z powyższej listy za ciebie — wybiera dedykowany model, gdy spotkanie ma jeden język, utrzymuje przesyłane pliki i sesje na żywo na właściwych ścieżkach oraz przejmuje ulepszenia silnika, takie jak sierpniowe, w tygodniu ich wydania, a nie przy twojej następnej migracji. Na transkrypcji uruchamiamy tłumaczenie na żywo na 44 języki docelowe i interfejs w 15 językach, więc osoba, która dołącza do twojego pendżabskiego standupu z Warszawy, czyta go po polsku na bieżąco.
Rozpocznij notatkę ze spotkania z tłumaczeniem na żywo
Źródła
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — pendżabski (
pa,pa-IN) i nepalski (ne), dostępne zarówno wsadowo, jak i strumieniowo - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — nowy ormiański (
hy); ulepszone modele wsadowe dla tamilskiego i indonezyjskiego; ulepszone modele strumieniowe dla tamilskiego i białoruskiego - Deepgram Models & Languages Overview — pełne tabele języków Nova-3 i Nova-2 oraz lista języków
multi, pobrane 31 sierpnia 2026 - Deepgram Multilingual Codeswitching guide — użycie
language=multii zalecenieendpointing=100, pobrane 31 sierpnia 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — „Nova-3 obsługuje teraz łącznie 31 języków”; wielojęzyczny keyterm prompting do 500 tokenów
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 nowych języków oraz model wykrywania 36 języków
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 nowych języków Nova-3, w tym białoruski, bengalski, bośniacki i chorwacki
- Deepgram Self-Hosted release 260319, March 19, 2026 — tajski i kantoński
- Deepgram Self-Hosted release 260430, April 30, 2026 — gudżarati
- Deepgram Self-Hosted release 260812, August 12, 2026 — self-hostowany pakiet z nepalskim i pendżabskim, osiem dni po wpisie chmurowym
- OpenAI Whisper tokenizer language table — 100 zadeklarowanych tokenów językowych, pobrane 31 sierpnia 2026
- Wikidata property P1098 (number of speakers) — liczby mówiących z Ethnologue dla
pa,ne,hy,ta,id,be, pobrane 31 sierpnia 2026 - Our June 2026 coverage of Deepgram's live-session and diarization updates </content>