Nova-3가 이번 달 58번째 언어를 추가했습니다. 그중 한 문장 안에서 섞이는 건 10개뿐입니다.
2026년 8월 4일 Deepgram은 Nova-3에 펀자브어와 네팔어를 추가했고, 8월 7일에는 아르메니아어를 추가하면서 타밀어, 인도네시아어, 벨라루스어 모델을 개선했습니다. 9개월 전 이 모델이 다루던 언어는 31개였는데, 오늘 문서에 적힌 숫자는 58개입니다. 하지만 코드 스위칭이 되는 언어는 정확히 10개뿐이고, 8월 체인지로그 자체가 인도네시아어는 배치에서만, 벨라루스어는 스트리밍에서만 개선됐다고 적고 있습니다. 음성 인식 언어 커버리지가 늘어나는 속도와, 「지원」이라는 단어가 실제로 감추고 있는 것을 들여다봅니다.
2026년 8월 4일, Deepgram이 자사 음성 인식 모델 Nova-3에 펀자브어와 네팔어를 추가했습니다. 사흘 뒤에는 아르메니아어를 추가하고, 타밀어와 인도네시아어, 벨라루스어의 단일 언어 모델을 개선했습니다.
체인지로그 두 건, 둘을 합쳐 열한 줄. 보도자료도 없었습니다. 그런데 그 언어들로 회의를 하는 사람에게는 이번 달 음성 인식 분야에서 벌어진 가장 중요한 사건입니다.
정작 값어치가 큰 건 항목 자체가 아니라 그 뒤에 있는 패턴입니다. 2025년 12월, Deepgram의 릴리스 노트는 Nova-3의 언어 수를 31개로 못 박았습니다. 그리고 오늘, 2026년 8월 31일 기준으로 Deepgram의 Models & Languages Overview에서 서로 다른 기본 언어 코드를 세어 보면 58개가 나옵니다. 업계 전체가 움직이는 속도가 이 정도이고, 이 속도는 여러분이 전사 결과에 기대해야 할 기준을 조용히 바꿔 놓았습니다.
이 글은 세 가지를 합니다. 먼저 1차 자료를 근거로 그 확장에 숫자와 날짜를 붙입니다. 다음으로 언어 개수라는 헤드라인 숫자가 그 자체로는 왜 거의 쓸모가 없는지, 대신 어떤 세 가지 질문을 던져야 하는지 설명합니다. 마지막으로 펀자브어, 네팔어, 아르메니아어, 타밀어, 인도네시아어 화자가 앉아 있는 회의실에서 8월의 추가분이 구체적으로 무엇을 바꾸는지 따져 봅니다.
TL;DR:
- 58 대 31. Nova-3 문서는 2025년 12월 10일에 총 31개 언어를, 2026년 8월 31일에는 서로 다른 기본 언어 코드 58개를 올려 두고 있습니다. 날짜가 찍힌 체인지로그 아홉 건에 걸쳐 39개 언어가 추가된 셈입니다.
- 커버리지는 숫자 하나가 아닙니다. Deepgram의
language=multi코드 스위칭 모드가 다루는 언어는 정확히 10개입니다(영어, 스페인어, 프랑스어, 독일어, 힌디어, 러시아어, 포르투갈어, 일본어, 이탈리아어, 네덜란드어). 나머지 48개는 한 번에 한 언어만 가능합니다.- 배치와 스트리밍은 별개의 제품입니다. 8월 7일 릴리스는 타밀어를 양쪽 모두에서, 인도네시아어를 배치에서만, 벨라루스어를 스트리밍에서만 개선했습니다. 같은 체인지로그 항목 하나에 서로 다른 결과가 세 개 들어 있습니다.
- 여전히 단일 언어 모델이 이깁니다. Nova-3의 58개 언어 중 48개에서는 전용 모델이 다국어 모드보다 더 나은 정도가 아니라, 존재하는 유일한 선택지입니다.
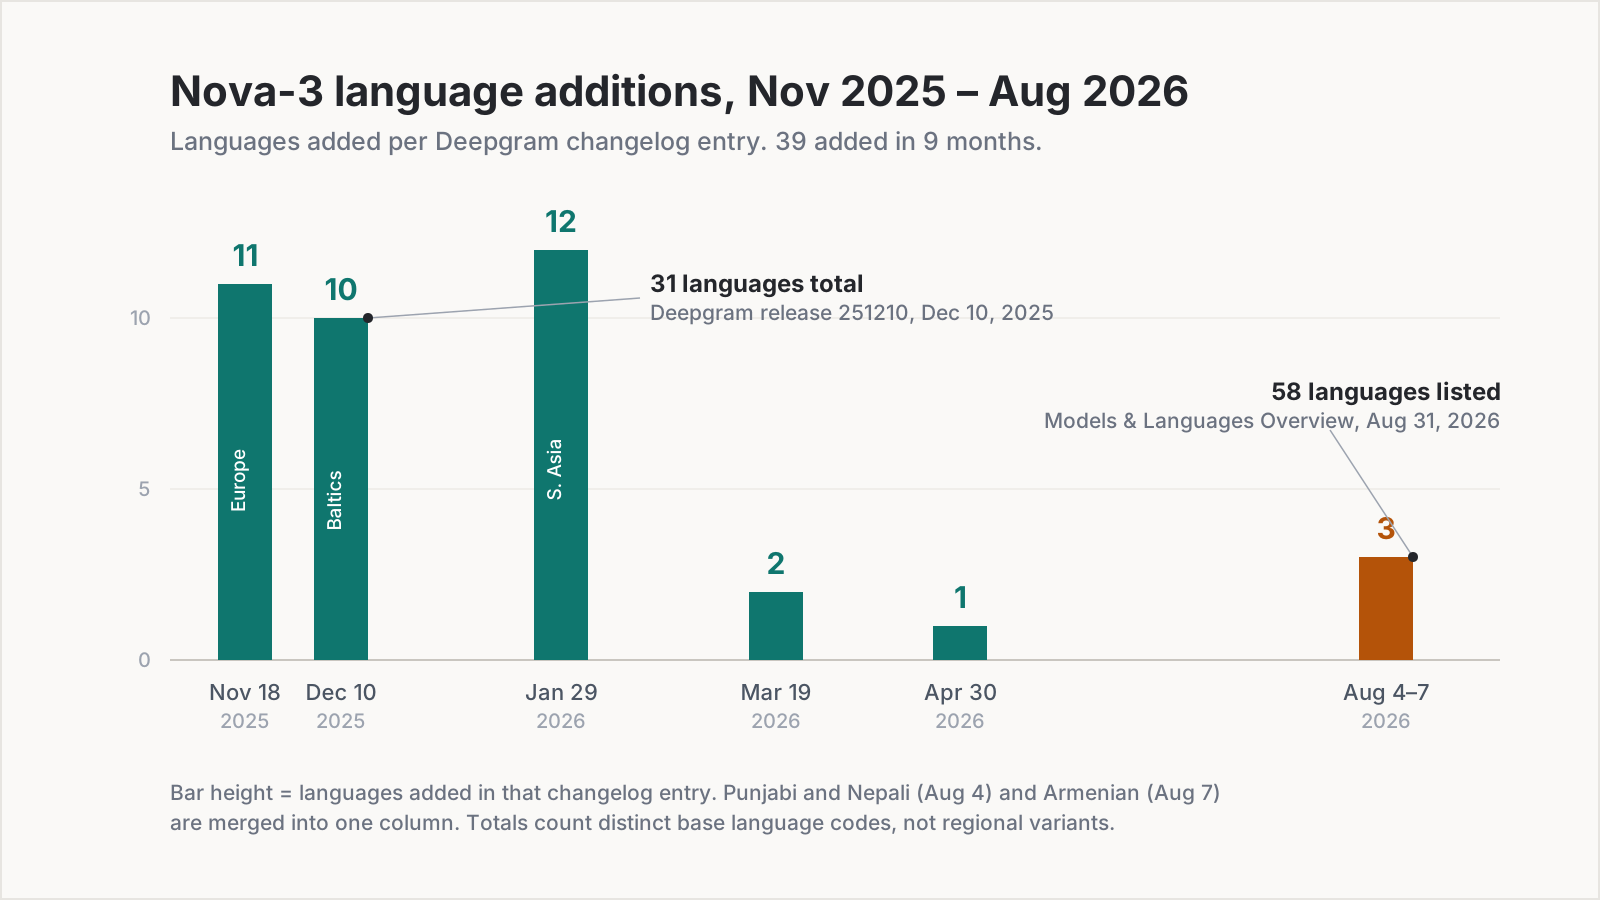
차트: Telli.sh. 2025년 11월 18일부터 2026년 8월 10일까지의 Deepgram 체인지로그 항목과 2026년 8월 31일에 조회한 Models & Languages Overview를 바탕으로 제작.
12월엔 31개, 8월엔 58개다
음성 인식 업체는 언어 커버리지를 정확도만큼 요란하게 알리지 않습니다. 릴리스 노트에 한 번에 몇 개씩 조용히 얹힐 뿐이라, 되짚어 가며 직접 더해 보지 않으면 누적 효과를 놓치기 쉽습니다. 그래서 저희가 더해 봤습니다.
2025년 11월 18일 자 릴리스 251118은 Nova-3 단일 언어 지원에 11개 언어를 얹었습니다. 불가리아어, 체코어, 핀란드어, 힌디어, 헝가리어, 일본어, 한국어, 폴란드어, 러시아어, 우크라이나어, 베트남어입니다. 3주 뒤인 2025년 12월 10일의 릴리스 251210은 남유럽과 발트, 동남아시아에 걸쳐 10개를 더 추가했습니다. 그리스어, 루마니아어, 슬로바키아어, 카탈루냐어, 리투아니아어, 라트비아어, 에스토니아어, 플람스어, 스위스 독일어, 말레이어입니다. 이 릴리스 노트에는 이 이야기 전체를 통틀어 가장 유용한 한 문장이 들어 있습니다. 「Nova-3는 이제 총 31개 언어를 지원합니다.」
그 뒤로도 추가는 멈추지 않았습니다. 2026년 1월 29일 자 릴리스 260129는 벨라루스어, 벵골어, 보스니아어, 크로아티아어를 포함해 12개를 더했습니다. 2026년 3월 19일 자 릴리스 260319는 태국어와 광둥어를 가져왔습니다. 2026년 4월 30일 자 릴리스 260430은 구자라트어를 추가했습니다. 그리고 8월입니다. 4일에 펀자브어와 네팔어, 7일에 아르메니아어였습니다.
2025년 11월 18일부터 2026년 8월 10일까지 문서로 확인되는 추가분을 합치면 9개월이 채 안 되는 기간에 39개 언어입니다. 한 업체가 대략 이레에 하나씩, 꾸준히 새 언어를 붙여 온 셈입니다.
여기서 눈여겨볼 디테일이 하나 있습니다. 이 릴리스들이 실제로 여러분에게 도달하는 방식을 알려 주기 때문입니다. 클라우드 체인지로그는 펀자브어와 네팔어 추가를 2026년 8월 4일로 기록합니다. 같은 모델을 묶은 셀프 호스팅 릴리스 260812는 8월 12일 자입니다. 호스팅 API와 컨테이너 이미지 사이에 여드레의 시차가 있는 것입니다. Deepgram을 자체 하드웨어에서 돌린다면 「지원」이라는 상태는 남들보다 일주일 넘게 늦게 도착했습니다.
「지원」은 하나가 아니라 세 개의 질문이다
이제 헤드라인 숫자가 가리고 있는 부분입니다. 업체가 어떤 언어를 지원한다고 말할 때, 그 한 단어는 적어도 세 가지 일을 동시에 하고 있고, 이 셋은 수시로 따로 놉니다.
실시간으로 쓸 수 있나요, 아니면 사후에만 되나요? 배치 전사와 스트리밍 전사는 제약 조건이 다른 서로 다른 모델로 돌아갑니다. 스트리밍 모델은 문장 끝을 듣기도 전에 단어를 확정해야 하지만, 배치 모델은 녹음 전체를 받습니다. 업체는 이 둘을 따로 출시하며, 항상 같이 내보내지도 않습니다.
모델은 실제로 얼마나 좋나요? 「지원」은 그 코드가 거부당하지 않는다는 뜻이지, 결과물이 이사회 회의에 쓸 만하다는 뜻이 아닙니다. 지난달에 추가된 언어와 네 차례 개선을 거친 언어가 표에서는 같은 칸에 나란히 적혀 있습니다.
다른 언어와 섞어 쓸 수 있나요? 깨지기 전까지는 거의 아무도 확인하지 않는 항목이 이겁니다. 모두가 네팔어로 말하는 회의를 전사하는 것과, 사람들이 한 문장 안에서 네팔어와 영어를 오가는 회의를 전사하는 것은 기술적으로 다른 문제입니다. 그리고 두 번째 문제가 풀린 언어는 훨씬 적습니다.
8월 체인지로그 자체가 첫 번째 질문에 대해 저희가 1년 사이에 본 가장 깔끔한 사례입니다. 8월 7일 항목은 네 가지를 개선했는데, 균일하게 개선하지 않았습니다.
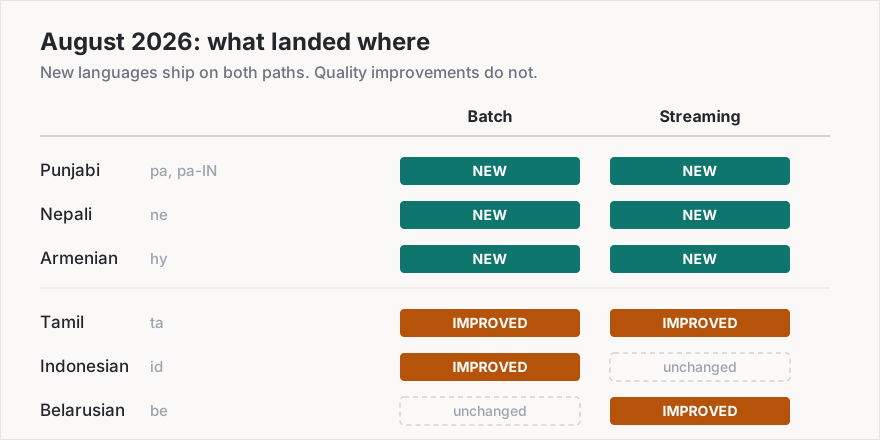
차트: Telli.sh. 2026년 8월 4일과 8월 7일 자 Deepgram 체인지로그 항목 기준.
펀자브어와 네팔어, 아르메니아어는 두 경로로 함께 들어왔습니다. Deepgram은 「이 언어들에 대해 배치와 스트리밍 모델이 모두 제공된다」고 분명히 적어 두었습니다. 타밀어는 배치와 스트리밍 양쪽에서 개선된 모델을 받았습니다. 인도네시아어는 개선된 배치 모델을 받았고 스트리밍 쪽에는 새 것이 없습니다. 벨라루스어는 개선된 스트리밍 모델을 받았고 배치 쪽에는 새 것이 없습니다.
녹음된 인도네시아어 인터뷰를 전사하는 사람이라면 8월 7일은 좋은 날이었습니다. 인도네시아어로 실시간 회의를 돌리는 사람이라면 8월 7일에 바뀐 건 아무것도 없습니다. 이 두 사실은 체인지로그 항목 하나의 불릿 목록 안에 함께 들어 있고, 그 항목을 요약한 어떤 글도 둘 중 어느 쪽이 여러분 이야기인지는 알려 주지 않습니다.
이 비대칭은 부주의의 결과가 아닙니다. 이것들이 학습과 검증 예산이 각각 다른, 정말로 별개의 모델이라는 사실을 반영합니다. 그리고 업체 체인지로그를 헤드라인이 아니라 개별 언어 단위로 읽어야 하는 가장 강력한 근거이기도 합니다.
커버리지 절벽: 언어는 58개, 대화는 10개다
이제 세 번째 질문입니다. 흥미로운 간극이 사는 곳이 여기입니다.
Deepgram의 다국어 코드 스위칭 모드는 language=multi라는 파라미터 하나로 켜지고, 요청 하나로 화자가 문장 안에서 언어를 옮겨 다니는 상황을 처리해 줍니다. 정말로 유용하고, Nova-2와 Nova-3, Flux Multilingual에서 쓸 수 있습니다. 그리고 단일 언어 카탈로그보다 훨씬 좁습니다.
Nova-3에서 language=multi가 다루는 언어는 정확히 열 개입니다. 영어, 스페인어, 프랑스어, 독일어, 힌디어, 러시아어, 포르투갈어, 일본어, 이탈리아어, 네덜란드어입니다. Nova-2에서는 같은 파라미터가 두 개, 스페인어와 영어만 다룹니다.
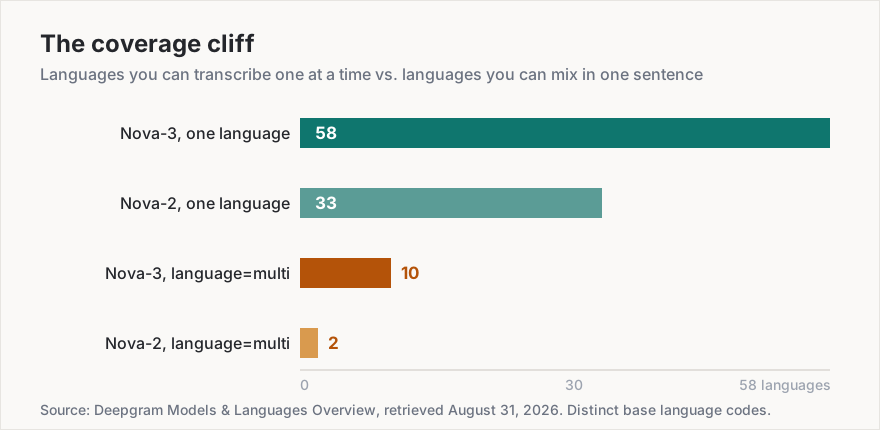
차트: Telli.sh. 2026년 8월 31일에 조회한 Deepgram Models & Languages Overview 기준. 지역 및 문자 변종을 제외한 서로 다른 기본 언어 코드 수.
이걸 커버리지 절벽이라고 불러 봅시다. 업체가 목록에 올린 언어와, 영어가 절반쯤 섞인 여러분의 실제 회의가 처리되는 언어 사이의 낙차입니다. 58개 언어가 절벽 위에 서 있습니다. 그중 떨어지고도 살아남는 건 10개입니다.
절벽 반대편에 남은 48개 언어, 그러니까 펀자브어, 네팔어, 아르메니아어, 타밀어, 벵골어, 태국어, 한국어, 베트남어, 말레이어 같은 언어들에게 전용 단일 언어 모델은 더 나은 선택지 정도가 아닙니다. 유일한 선택지입니다. 비교할 코드 스위칭 경로 자체가 없습니다.
여기서 핵심을 말하겠습니다. 다국어 모드가 언제나 더 뛰어나다는 직관과는 정반대입니다. 세계 대부분의 언어에서 단일 언어 모델은 차선책이 아니라 가장 고급 옵션입니다. 전용 모델은 한 언어의 음운, 한 언어의 어휘 분포, 한 언어의 숫자와 날짜 표현만을 학습합니다. 반면 다국어 모델은 열 개를 동시에 긴장 상태로 붙들고 단어 단위로 지금 들리는 게 어느 언어인지 판정해야 합니다. 회의가 타밀어로 진행된다는 걸 알고 있을 때 엔진에 그렇게 알려 주는 것은 감수해야 할 제약이 아니라, 여러분이 쓸 수 있는 가장 정확한 설정입니다.
language=multi (코드 스위칭) | 전용 언어 모델 | |
|---|---|---|
| Nova-3 언어 커버리지 | 10개 언어 | 58개 언어 |
| Nova-2 언어 커버리지 | 2개 언어(스페인어 + 영어) | 33개 언어 |
| 문장 중간 언어 전환 처리 | 가능 | 불가 — 다른 언어 발화는 품질이 떨어짐 |
| 언어가 하나로 정해진 경우의 정확도 | 낮음. 모델이 후보 사이에서 중재함 | 높음. 모델이 해당 언어에 특화됨 |
| 키텀 프롬프팅 | Nova-3 Multi에서 가능. 최대 500토큰(약 100단어), 2025년 12월 10일부터 | 가능 |
| 권장 스트리밍 설정 | Deepgram 가이드 기준 endpointing=100 | 기본 엔드포인팅 |
| 펀자브어, 네팔어, 아르메니아어, 타밀어 지원 | 없음 | 있음 |
이 표를 실무적으로 읽으면 이렇습니다. 회의가 진짜로 영어와 스페인어를 문장 단위로 오간다면 multi를 쓰고 정확도 손해를 감수하세요. 회의가 타밀어이고 영어 외래어가 가끔 섞이는 정도라면, 즉 대부분의 「다국어」 회의가 실제로 그런 모습이라면, language=ta를 설정하고 전용 모델이 제 일을 하게 두세요.
이번 달에 회의가 실제로 나아지는 쪽은 따로 있다
구조 이야기는 이쯤 하겠습니다. 2026년 8월에 상태가 바뀐 언어는 여섯 개이고, 코드 하나하나 뒤에는 그동안 회의록을 형편없이 남겨 왔거나 아예 남기지 못했던 인구가 있습니다.
| 언어 | 코드 | 화자 수 | 2026년 8월에 바뀐 것 |
|---|---|---|---|
| 펀자브어 | pa, pa-IN | 약 1억 2,500만 명 | Nova-3 신규, 배치와 스트리밍 모두(8월 4일) |
| 네팔어 | ne | 약 1,600만 명 | Nova-3 신규, 배치와 스트리밍 모두(8월 4일) |
| 아르메니아어 | hy | 약 670만 명 | Nova-3 신규, 배치와 스트리밍 모두(8월 7일) |
| 타밀어 | ta | 모어 화자 약 7,500만 명 | 모델 개선, 배치와 스트리밍 모두(8월 7일) |
| 인도네시아어 | id | 제2언어 포함 약 1억 9,900만 명 | 배치 모델만 개선(8월 7일) |
| 벨라루스어 | be | 약 760만 명 | 스트리밍 모델만 개선(8월 7일) |
화자 수: Wikidata 속성 P1098로 집계된 Ethnologue 수치, 2026년 8월 31일 조회. 반올림한 값.
단 한 주 사이에 약 4억 3,000만 명의 언어가 눈에 띄게 나은 음성 인식을 갖게 됐다는 뜻입니다. 그중 약 1억 4,800만 명, 즉 펀자브어와 네팔어, 아르메니아어 화자는 Nova-3에서 제대로 된 선택지가 아예 없던 상태에서 배치와 스트리밍 양쪽 모두를 가진 상태로 넘어왔습니다.
이게 회의실 안에서 무슨 뜻인지 생각해 보시죠. 찬디가르 엔지니어링 팀의 스탠드업은 지금까지 도구를 위해 제2언어로 진행되거나 아예 기록이 남지 않았지만, 이제 실시간 전사본을 만들어 냅니다. 카트만두 NGO의 현장 보고는 누군가의 손글씨 메모 대신 검색 가능한 기록이 됩니다. 아르메니아어 법정 진술은 분당 요금을 내고 수기 전사를 맡기는 대신 실시간으로 받아 적힐 수 있습니다.
전사본 자체보다 더 중요한 2차 효과도 있습니다. 어떤 언어의 음성이 실시간으로 기계가 읽을 수 있는 상태가 되는 순간, 그 아래에 딸린 모든 것이 한꺼번에 열립니다. 원격 참가자를 위한 실시간 번역, 자동 요약, 액션 아이템 추출, 1년치 회의 전체 검색까지 말입니다. 음성 인식은 병목 단계입니다. 이 단계를 통과한 언어는 영어를 위해 만들어진 파이프라인 전체를 그대로 물려받습니다.
「우리 언어는 도구가 지원을 안 해서」라는 이유로 습관처럼 영어로 갈아타는 동료가 있는 팀이라면, 이번 업데이트가 바로 그 타협을 끝내는 업데이트입니다.
다국어 회의에서 언어 설정은 이렇게 고른다
엔진이 좋아져도 세션을 제대로 설정해야 효과를 봅니다. 그리고 기본값은 다국어 팀에게 틀린 경우가 잦습니다. 순서대로 다섯 단계입니다.
- 회의에 지배적인 언어가 하나인지, 아니면 정말로 섞이는지부터 판정하세요. 타밀어 회의에 영어 외래어가 가끔 섞이는 건 한 언어입니다. 스페인어와 영어 문장을 번갈아 쓰는 건 두 언어입니다. 코드 스위칭이 필요한 건 두 번째 경우뿐입니다.
- 언어가 하나라면 그 언어를 명시적으로 지정하세요.
model=nova-3에 구체적인 코드를 함께 쓰면 됩니다. 펀자브어는language=pa, 네팔어는language=ne, 아르메니아어는language=hy입니다. 자동 감지에 맡기지 마세요. 답을 이미 알고 있고, 모델에 알려 주는 데 드는 비용은 없습니다. - 정말로 섞인다면 해당 언어가 10개 목록에 있는지 확인하세요. 회의실의 모든 언어가 영어, 스페인어, 프랑스어, 독일어, 힌디어, 러시아어, 포르투갈어, 일본어, 이탈리아어, 네덜란드어 안에 들어갈 때만
language=multi를 켜세요. 하나라도 빠지면multi는 도움이 되지 않고, 지배적인 언어의 모델이 최선의 선택지입니다. multi로 라이브 세션을 돌린다면endpointing=100을 설정하세요. Deepgram의 코드 스위칭 가이드는 기본값보다 짧은 100밀리초를 코드 스위칭 전용으로 권장합니다. 엔드포인팅이 길면 전환된 언어의 구절이 엉뚱한 세그먼트에 흡수됩니다.- 약속하기 전에 배치와 스트리밍을 따로 검증하세요. 8월 7일이 보여 준 대로, 한쪽의 개선이 다른 쪽의 개선은 아닙니다. 체인지로그 항목이 내 경로에도 적용된다고 가정하지 말고, 같은 10분짜리 샘플을 두 경로에 모두 통과시켜 비교해 보세요.
이 주제의 다른 단면은 6월에 다뤘습니다. Deepgram's mid-year update on adaptive live sessions and diarization에서 실행 중인 세션이 재연결 없이 언어 힌트를 바꿀 수 있게 해 주는 UpdateListen 컨트롤을 함께 다뤘습니다. 위의 2단계와 이 기능은 잘 맞물립니다. 시작할 때 언어를 명시해 두고, 회의실 분위기가 실제로 바뀌면 도중에 조정하면 됩니다.
결론: 커버리지는 숫자이길 그만두고 매트릭스가 됐다
음성 엔진을 비교할 때 본능적으로 하는 일은 가장 큰 숫자를 찾는 것입니다. OpenAI Whisper의 토크나이저는 2022년부터 100개의 언어 토큰을 선언해 왔고, 이는 Nova-3의 58개의 거의 두 배입니다. 그런데 그 비교는 거의 아무것도 알려 주지 않습니다. Whisper에는 네이티브 스트리밍 경로가 없고, 선언된 토큰은 검증된 프로덕션 모델이 아니기 때문입니다. Nova-3는 더 적은 언어를 올려놓지만, 언어별로, 모드별로, 날짜가 찍힌 증거와 함께 실제로 출시합니다.
엔진의 진짜 커버리지를 설명하는 수치는 개수가 아닙니다. 언어 × 모드 × 품질 등급으로 이뤄진 매트릭스입니다. 한 번에 하나씩 쓸 수 있는 58개 언어. 그중 섞어 쓸 수 있는 10개. 그리고 같은 릴리스, 같은 날짜에 배치에서만 개선된 언어 하나와 스트리밍에서만 개선된 언어 하나.
그러니 다음 업체 평가 자리에 들고 가야 할 질문은 「언어를 몇 개나 지원하나요」가 아닙니다. 내 언어를, 내 경로에서, 어느 날짜 기준으로 지원하나요? 입니다.
Telli.sh는 여기에 들어갑니다: 위의 모든 내용은 엔진 계층의 디테일이고, 저희는 대부분의 팀이 이걸 알 필요가 없어야 한다고 생각합니다. Telli.sh는 그 계층 위에 앉아서 앞의 번호 목록에 나온 선택을 대신 해 줍니다. 회의가 한 언어일 때 전용 모델을 고르고, 파일 업로드와 라이브 세션을 각자의 올바른 경로에 유지하고, 8월 같은 엔진 개선을 다음 마이그레이션 때가 아니라 출시된 그 주에 물려받습니다. 그리고 전사본 위에서 44개 대상 언어로 실시간 번역을 돌리고 15개 언어 인터페이스를 제공하므로, 바르샤바에서 여러분의 펀자브어 스탠드업에 접속한 사람은 그 자리에서 폴란드어로 읽습니다.
출처
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — 펀자브어(
pa,pa-IN)와 네팔어(ne), 배치와 스트리밍 모두 제공 - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — 아르메니아어(
hy) 신규. 타밀어와 인도네시아어의 배치 모델 개선, 타밀어와 벨라루스어의 스트리밍 모델 개선 - Deepgram Models & Languages Overview — Nova-3와 Nova-2 전체 언어 표 및
multi언어 목록, 2026년 8월 31일 조회 - Deepgram Multilingual Codeswitching guide —
language=multi사용법과endpointing=100권장 설정, 2026년 8월 31일 조회 - Deepgram Self-Hosted release 251210, December 10, 2025 — 「Nova-3는 이제 총 31개 언어를 지원합니다」, 최대 500토큰의 다국어 키텀 프롬프팅
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11개 신규 언어와 36개 언어 감지 모델
- Deepgram Self-Hosted release 260129, January 29, 2026 — 벨라루스어, 벵골어, 보스니아어, 크로아티아어를 포함한 Nova-3 신규 12개 언어
- Deepgram Self-Hosted release 260319, March 19, 2026 — 태국어와 광둥어
- Deepgram Self-Hosted release 260430, April 30, 2026 — 구자라트어
- Deepgram Self-Hosted release 260812, August 12, 2026 — 클라우드 항목보다 여드레 늦은, 네팔어와 펀자브어의 셀프 호스팅 번들
- OpenAI Whisper tokenizer language table — 선언된 언어 토큰 100개, 2026년 8월 31일 조회
- Wikidata property P1098 (number of speakers) —
pa,ne,hy,ta,id,be의 Ethnologue 기반 화자 수, 2026년 8월 31일 조회 - Our June 2026 coverage of Deepgram's live-session and diarization updates