Файл на 16,5 ГБ теперь обходит лучшую закрытую модель февраля
Три года назад лучшая модель, которую можно было скачать, уступала GPT-4 37 баллов на HumanEval и требовала двух видеокарт. На прошлой неделе открытая модель на 27 млрд параметров набрала 52,0 в индексе интеллекта Artificial Analysis против 44,9 у Claude Opus 4.6 Max — за одну девятую цены и из файла в 16,5 ГБ. Сравнение «до и после» с таблицами бенчмарков, кривой цен и разбором того, что значит отставание догоняющих, сократившееся до 162 дней.
Кто-то на Hacker News запускает языковую модель уровня переднего края на видеокарте с 16 ГБ памяти — 50–60 токенов в секунду, окно контекста 128 000 токенов. Это Qwen3.8-27B, выпущенная 14 августа 2026 года. В индексе интеллекта Artificial Analysis она набирает 52,0 — больше, чем Claude Opus 4.6 Max, ещё в феврале лучшая проприетарная модель на рынке, у которой 44,9.
В 2023 году это предложение было бы фантастикой. И не из приятных.
Этот текст — сравнение «до и после». Не репортаж о релизе, его мы уже писали, а сопоставление через три года: какие баллы лучшая скачиваемая модель набирала против переднего края тогда и сейчас, сколько стоило купить определённый уровень интеллекта тогда и сейчас, какое железо нужно было иметь, чтобы запустить всё это самому. У каждой цифры ниже есть источник и дата. Тенденция, которую они описывают, — одна из самых по-настоящему оптимистичных вещей, происходящих сегодня в софте.
Кратко:
- Разрыв закрылся, и это можно датировать. В июле 2023 года лучшая открытая модель уступала GPT-4 17,5 балла на MMLU и 37,1 балла на HumanEval. В августе 2026 года открытая модель на 27 млрд параметров обыгрывает февральский проприетарный флагман в 15 из 19 бенчмарков, которые публикуют обе стороны, и в независимом сводном индексе.
- Цена упала примерно в 208 раз за 23 месяца — измерение Epoch AI при фиксированном пороге качества. Открытая 27B стоит сегодня 1,09 доллара за миллион токенов в смешанном тарифе против 10,00 у Opus 4.6 Max, и ноль за токен, если запускать самому.
- Это не передний край, и мы прямо об этом говорим. Claude Opus 5 Max набирает 63,1, GPT-5.6 Sol Max — 60,9. В рассуждениях на широких знаниях 27B заметно уступает Opus 4.6: 30,8 против 40,0 на HLE.
Фото: Steve Jurvetson, Викисклад, CC BY 2.0. Межсоединения Cray Y-MP, около 1988 года. Серьёзные вычисления когда-то были комнатой, в которую входили.
Как на самом деле выглядело «до»
Переведём часы на 18 июля 2023 года — день, когда Meta опубликовала Llama 2. Это была лучшая свободно скачиваемая модель в мире, и её собственная статья без прикрас напечатала таблицу результатов против закрытого переднего края.
Llama 2 70B набрала 68,9 на MMLU против 86,4 у GPT-4. На GSM8K — 56,8 против 92,0. На HumanEval, бенчмарке по коду, — 29,9 против 67,0, меньше половины. Итог самой статьи: «Между Llama 2 70B и GPT-4, а также PaLM-2-L, по-прежнему сохраняется значительный разрыв в качестве». Это флагман открытых весов в 2023 году, его собственными словами.
Теперь железо. Четырёхбитная сборка сообщества от TheBloke — то, как люди на самом деле запускали Llama 2 70B, — была файлом на 41,4 ГБ, опубликованным 4 сентября 2023 года. Чтобы получить приемлемую скорость, требовались две видеокарты по 24 ГБ или Mac с 64 ГБ. В обычный ноутбук помещалась Llama 2 13B: файл на 7,9 ГБ, 54,8 на MMLU, на 31,6 балла ниже GPT-4 и почти бесполезная за пределами демонстраций.
Итак, выбор 2023 года выглядел так: платить лаборатории переднего края либо запускать заметно худшее на железе, которого у большинства не было. Именно поэтому аргумент «просто возьми API» побеждал так убедительно два года подряд. Он был верным.
Тот же вопрос в августе 2026 года
Alibaba выпустила Qwen3.8-27B 14 августа 2026 года под лицензией Apache 2.0 и напечатала на карточке модели прямое сравнение с Claude Opus 4.6 Max. Мы пересчитали все строки, где обе модели приводят число.
Qwen3.8-27B выигрывает 15 из этих 19 строк и проигрывает 4. Среди побед — SWE-bench Pro (61,7 против 53,4), следование инструкциям на IFBench (79,5 против 62,5), спортивное программирование на LiveCodeBench v6 (90,3 против 88,8), управление компьютером на OSWorld-Verified (84,3 против 72,7), мобильные агентские задачи на AndroidWorld (81,9 против 62,0) и длинный ряд мультимодальных бенчмарков, где отрывы совсем не близкие: 90,0 против 65,5 на MathVision, 83,7 против 66,0 на анализе графиков в CharXiv, 65,5 против 40,8 на телесном рассуждении в ERQA.
Четыре поражения важнее пятнадцати побед, потому что показывают, чего модель на 27 млрд параметров всё ещё не умеет. Она проигрывает на Terminal Bench 2.1 (73,0 против 78,2), на генерации кода уровня репозитория в NL2Repo-Bench (42,3 против 47,6), немного — на GPQA Diamond (89,2 против 91,3) и сильно — на HLE, бенчмарке широкого междисциплинарного рассуждения: 30,8 против 40,0. Последняя цифра и есть форма всего ограничения. Знания мира не сжать в файл на 16,5 ГБ; а вот огромный объём умений — вполне.
Одна строка заслуживает звёздочки: результат 79,0 против 63,8 получен на QwenSWEBench, бенчмарке, который построила сама Qwen. Прогон вендора на собственном бенчмарке — самое слабое доказательство в любой карточке модели, и мы на него не опираемся.
Независимая таблица говорит то же самое
Таблица вендора остаётся таблицей вендора, поэтому вот третья сторона. Artificial Analysis, которая проводит собственные замеры, а не перепечатывает чужие, уже протестировала 27B. На 21 августа 2026 года она даёт Qwen3.8-27B индекс интеллекта 52,0 — первое место среди 135 моделей в классе открытых весов от 4 до 40 млрд параметров, против 44,9 у Claude Opus 4.6 Max. Это 7,1 балла в пользу открытой модели, измеренные стороной без интереса в исходе, спустя 190 дней после выхода Opus 4.6.
Проследите это сравнение назад во времени — вот и вся история. В июле 2023 года лучшая открытая модель до 40 млрд параметров набирала по тому же индексу 2,6. В июле 2024-го — 7,4. В марте 2025-го — 13,4. В феврале 2026-го — 34,6. На прошлой неделе — 52,0.
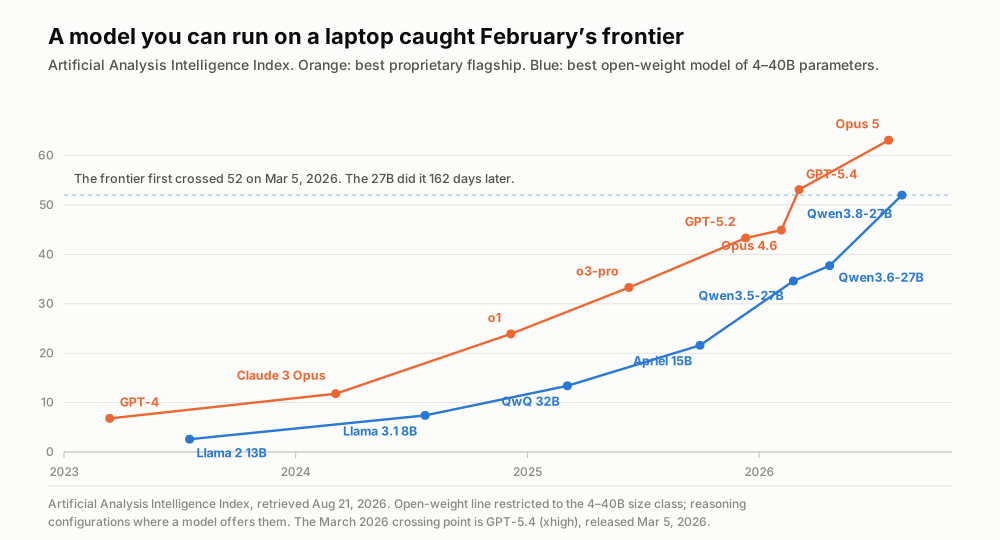
Обе линии растут; интересна горизонтальная дистанция между ними. Индекс интеллекта Artificial Analysis, данные на 21 августа 2026 года.
Вот цифра, которая заслуживает названия. Передний край впервые перешагнул индекс 52 пятого марта 2026 года, когда GPT-5.4 при максимальном усилии рассуждения набрала 53,1. Модель, достаточно маленькая для персональной машины, дошла туда 14 августа — на 162 дня позже. Назовём это отставанием догоняющих: время между появлением способности на переднем крае и её появлением на вашем собственном железе.
Раньше это отставание было куда больше. Llama 3.1 8B понадобилось 260 дней, чтобы выйти на уровень GPT-4 Turbo. GLM-4.7-Flash потребовалось 410 дней, чтобы сравняться с o1. Три последних релиза «ноутбучного» размера дали 201, 155 и 162 дня. Передний край не замедляется — Opus 5 Max сегодня на 63,1, — но догоняющая кромка сокращает дистанцию примерно вдвое быстрее, чем два года назад.
Цена не снизилась — она обвалилась
Способности — это половина сравнения. Вторая половина — счёт.
Epoch AI опубликовала самое чистое измерение этого в марте 2025 года, и метод стоит понять: зафиксировать балл бенчмарка, а затем отслеживать во времени самую дешёвую модель, которая его достигает. Зафиксируйте порог на уровне 86 баллов GPT-4 по MMLU — и лестница выглядит так: 37,50 доллара за миллион токенов в марте 2023-го, 15,00 в ноябре 2023-го, 7,50 в мае 2024-го, 2,19 позже в том же месяце и 0,18 в феврале 2025-го. Балл тот же. В 208 раз дешевле за 23 месяца.
Главный вывод Epoch в том, что темп сильно зависит от задачи: от 9 до 900 раз в год в зависимости от того, какую способность фиксировать. Цена качества уровня GPT-4 на научных вопросах докторского уровня падала примерно в 40 раз в год. Направление же не менялось ни разу.
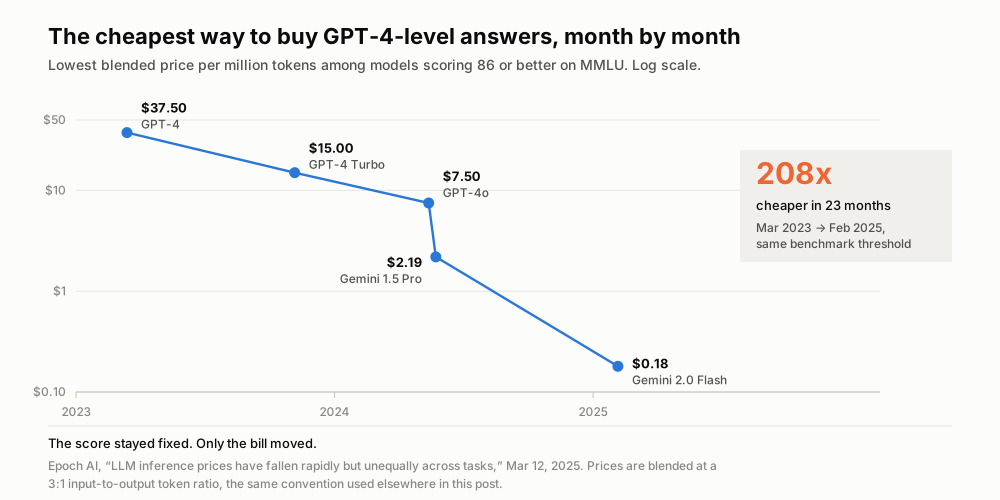
В каждой точке этой линии балл бенчмарка одинаков. Epoch AI, 12 марта 2025 года.
Продолжите ряд сегодняшними ценами — движение не прекращается. В каталоге OpenRouter на 21 августа 2026 года Qwen3.8-27B стоит 0,45 доллара за миллион входных токенов и 3,20 за миллион выходных; Claude Opus 4.6 — 5,00 и 25,00. В смешанном виде по принятому у Epoch соотношению 3:1 это 1,09 против 10,00 доллара — открытая модель в 9,1 раза дешевле и на 7,1 балла индекса лучше закрытого флагмана полугодовой давности.
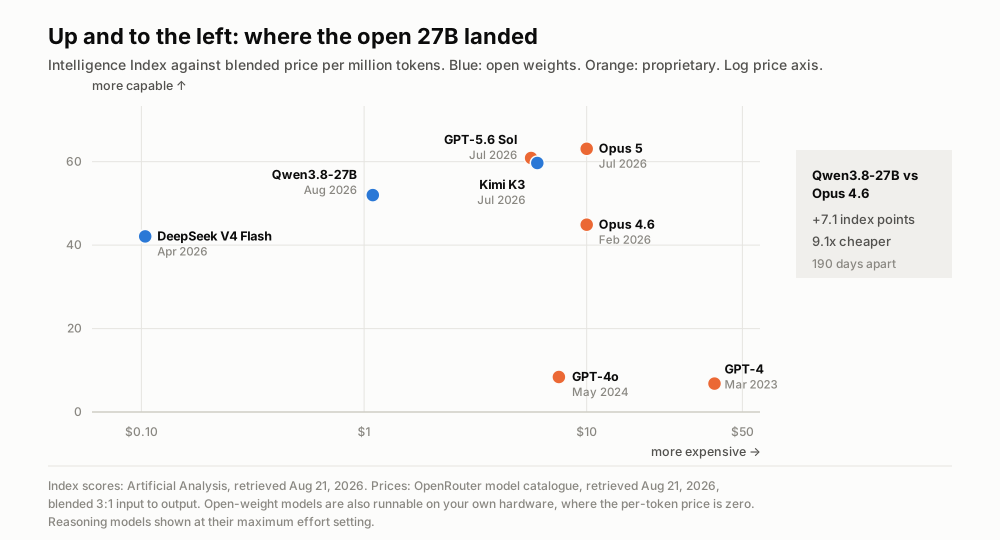
Все значимые модели смещаются в верхний левый угол. Баллы — Artificial Analysis, цены — OpenRouter, данные на 21 августа 2026 года.
И есть вариант, у которого цены за токен нет вовсе. Запустите 27B на собственной RTX 4090 с теми примерно 48 токенами в секунду, о которых сообщали пользователи в обсуждении релиза, примите номинальные 450 ватт карты — и при средней цене электроэнергии для домохозяйств США 18,44 цента за киловатт-час (EIA, май 2026) электричество обойдётся примерно в 0,48 доллара за миллион выходных токенов: до учёта самой карты и после того, как вы перестали оплачивать чью-либо маржу. Это расчётная оценка с открыто указанными допущениями, а не заявление производителя.
«До» и «после», по строке на каждое
| Июль 2023 | Август 2026 | |
|---|---|---|
| Лучшая скачиваемая модель | Llama 2 70B (Meta, 18 июля 2023) | Qwen3.8-27B (Alibaba, 14 августа 2026) |
| Параметры | 70 млрд | 27 млрд |
| Стандартная 4-битная сборка сообщества | 41,4 ГБ | 16,5 ГБ |
| Наименьшая пригодная сборка | 7,9 ГБ (13B, MMLU 54,8) | 9,8 ГБ (2 бита, контекст 128K на карте 16 ГБ) |
| Реалистичное железо | две GPU по 24 ГБ или Mac на 64 ГБ | одна потребительская GPU на 16 ГБ |
| Модель переднего края того времени | GPT-4 (14 марта 2023) | Claude Opus 4.6 Max (5 февраля 2026) |
| Результат против неё | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | побеждает в 15 из 19 опубликованных бенчмарков, +7,1 балла индекса |
| Смешанная цена этой модели переднего края | 37,50 $ за миллион токенов | 10,00 $ за миллион токенов |
| Смешанная цена открытой модели | в масштабе не предлагалась | 1,09 $ за миллион токенов |
| Лицензия | Llama 2 Community License | Apache 2.0 |
Источники по каждой ячейке — в конце. Строка, к которой мы возвращаемся снова и снова, предпоследняя: цена самого переднего края упала за три года в 3,75 раза, а открытая альтернатива появилась под ней, примерно на десятой части этого уровня. Произошло и то и другое. Меняет то, кто вообще может строить, именно второе.
Что по-прежнему неверно
Восторги вокруг этого релиза обгоняют доказательства в четырёх конкретных местах. Отметим их.
Это не передний край. По тому же индексу Claude Opus 5 Max набирает 63,1, а GPT-5.6 Sol Max — 60,9, оба заметно выше 52,0. Если ваша работа зависит от самого сложного доступного рассуждения, передний край остаётся другим продуктом — и остаётся закрытым.
Для своего размера модель недешёвая. Сама сводка Artificial Analysis называет Qwen3.8-27B «особенно дорогой по сравнению с другими моделями открытых весов схожего размера»: медиана в её классе — 0,05 доллара за миллион входных токенов против 0,43 у Qwen. Вы платите за способности, а не за параметры.
Модель многословна, а многословие — это счёт. При прогоне индекса интеллекта 27B сгенерировала 160 миллионов выходных токенов при медиане в 45 миллионов. Один пользователь дал ей запрос из двух слов на Mac mini с 64 ГБ и наблюдал за размышлением 17 минут 12 секунд. Рассуждающие модели выставляют счёт в реальном времени, даже когда токены бесплатны.
И баллы бенчмарков принадлежат модели в полной точности. Двухбитная сборка на 9,8 ГБ, которая влезает в вашу видеокарту, — не та модель, что набрала 52,0. Сильное квантование стоит точности, особенно на длинных контекстах. Любое утверждение «работает на ноутбуке», включая наше, идёт с этой звёздочкой.
Почему отставание должно продолжать сокращаться
Дальше — наша позиция, и переход мы отмечаем явно: всё выше было измерением, дальше идёт вывод из него.
Механизм, который тянет отставание вниз, не загадочен. Методы дообучения, опубликованные на переднем крае, воспроизводятся в открытых лабораториях за месяцы. Управление усилием рассуждения, полтора года назад бывшее проприетарным приёмом, сегодня поставляется как документированный параметр в карточке этой модели. Квантование сообществом заканчивается раньше, чем перестаёт меняться документация самой лаборатории. Ни у одной из этих трёх петель обратной связи нет причин замедляться, а две из них ускоряются по мере роста числа участников.
Поэтому разумное ожидание для следующего поколения — не то, что открытые модели обгонят передний край. А то, что 162 дня продолжат сжиматься, пока абсолютные способности растут на обоих концах. Тогда интересный порог — уже не «могут ли открытые модели победить», а «насколько свежим должен быть передний край, чтобы разница перестала значить что-то для моей задачи». Для расшифровки встреч, перевода, резюмирования и большей части работы с документами этот порог пройден давно. Для передовых исследований и самой сложной агентской инженерии — нет.
Это заметно лучший мир, чем в 2023 году, и об этом стоит сказать прямо. Стоимость того, чтобы дать компьютеру грамотное понимание языка, упала за три года на два порядка и продолжает падать. Больше всего выигрывают те, кого раньше отсекала цена: разработчики-одиночки, команды в странах, где 10 долларов за миллион токенов — не погрешность округления, исследователи с грантом вместо бюджета и все, чьи данные по юридическим причинам должны оставаться на своей машине.
Итог: передний край перестал быть местом и стал датой
Старый вопрос звучал так: к какой лаборатории у вас есть доступ. Новый — на сколько месяцев позади переднего края вы готовы быть, если это стоит в девять раз дешевле и работает на вашем собственном железе.
Для всё большего числа задач честный ответ такой: примерно пять месяцев, и срок сокращается.
Где здесь Telli.sh: всё сказанное выше и есть причина, по которой мы строим на открытых моделях, а не вокруг одного поставщика. В Telli.sh уже используется открытая модель Qwen на этапе резюмирования, поэтому каждый шаг вниз по этой кривой приходит к вам как лучшая расшифровка встречи, а не как объявление о повышении цен. Наша работа — та часть, которую не даст ни одна загрузка: надёжно записать час аудио, различить говорящих, переводить вживую на 15 языков и превратить всё это в заметки, которые будут находиться поиском и через месяцы.
Источники
- Карточка модели Qwen3.8-27B и таблицы бенчмарков, Hugging Face — цифры прямого сравнения с Opus 4.6 Max, данные на 21 августа 2026 года
- Artificial Analysis: анализ интеллекта, производительности и цены Qwen3.8 27B — индекс интеллекта 52,0, цена и многословность, данные на 21 августа 2026 года
- Artificial Analysis: страница модели Claude Opus 4.6 — индекс интеллекта 44,9 при максимальном усилии рассуждения, данные на 21 августа 2026 года
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 марта 2025 года — ценовая лестница при фиксированном пороге и диапазон от 9 до 900 раз в год
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 июля 2023 года — таблица 4, Llama 2 70B против GPT-4
- Список файлов TheBloke/Llama-2-70B-Chat-GGUF — сборка Q4_K_M на 41,4 ГБ, опубликована 4 сентября 2023 года
- Список файлов unsloth/Qwen3.8-27B-GGUF — сборки на 16,5 ГБ и 9,8 ГБ, счётчики загрузок на 21 августа 2026 года
- Каталог моделей OpenRouter — цены за токен для Qwen3.8-27B, Claude Opus 4.6 и Claude Opus 5, данные на 21 августа 2026 года
- Обсуждение выхода Qwen3.8-27B на Hacker News, 14 августа 2026 года — сообщения о пропускной способности на картах 16 и 24 ГБ
- Управление энергетической информации США, Electric Power Monthly, таблица 5.3 — 18,44 цента за киловатт-час в среднем для домохозяйств, май 2026 года
- Наш прежний материал о выходе открытых весов Qwen3.8 и о более широкой волне открытых весов
- Страница фотографии Cray Y-MP на Викискладе
