Qwen3.8-27B open weights: размеры, Q4_K_M и реальная скорость на 4090 и Mac
Qwen3.8-27B выходит под Apache 2.0. GGUF Q4_K_M весит 17,1 ГБ и помещается в ноутбук с 32 ГБ; FP8 — 30,9 ГБ. Замеры: 48 токенов/с на RTX 4090 и 12,75 на Mac mini M4 Pro.
3 августа аккаунт Qwen компании Alibaba написал, что открытые веса выйдут «на следующей неделе». Именно такие фразы индустрия ИИ научила всех слушать с дисконтом. Двенадцать дней спустя дисконтировать нечего: веса Qwen3.8-Max на 2,4 триллиона параметров появились на Hugging Face 12 августа, а младшая модель — Qwen3.8-27B под обычной лицензией Apache 2.0 — вышла 14-го.
Дальше началось самое интересное. В тот же час, когда Qwen дописывала карточку 27B, три разные команды из сообщества уже перевели её в форматы, запускающиеся на обычном персональном компьютере. Ещё через два дня эти конверсии перевалили за миллион загрузок.
Новость — именно это число, а не таблица бенчмарков. Модель на 27 миллиардов параметров из одной из ведущих лабораторий ИИ прошла путь от «анонсирована» до «работает примерно на миллионе рабочих столов» примерно за 48 часов. Этот текст простым языком объясняет, что это значит на практике: что вышло и под какой лицензией, что нужно, чтобы запустить 27B на уже имеющемся железе, как далеко всё ушло за три года и то, что обычно пропускают, — чего локальная 27B по-прежнему не умеет.
Коротко:
- Обещание выполнено. Qwen3.8-Max (2,4 трлн всего / 95 млрд активных) вышла 12 августа, Qwen3.8-27B — 14-го. Обе доступны для реальной загрузки, а не как хостируемое превью.
- Лицензии разные, и эта разница весит больше, чем баллы. 27B выходит под Apache 2.0: без порогов и оговорок, коммерческое использование свободно и бесплатно. У Qwen3.8-Max собственная лицензия с триггером по выручке для бизнесов «модель как услуга».
- Кто что сможет запустить, решает размер: Max — это 4892 ГБ загрузки; 27B, сжатая до 4 бит, весит 17,1 ГБ и помещается на машину с 32 ГБ памяти. Сборки сообщества в 4 битах за два дня превысили 1,07 миллиона загрузок.
Изображение: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Запускать модель передовой лаборатории самому — значит, что машина и её обслуживание тоже становятся вашими.
У обещания была дата, и дата выдержала
4 августа мы разбирали сам анонс и писали, что ожидание измеряется «следующей неделей», а не «когда-нибудь». Дальше тогдашние факты не позволяли зайти. Развязка вышла чистой.
Qwen3.8-2.4T-A95B, продаваемая как Qwen3.8-Max, появилась вместе с файлом лицензии 12 августа. Qwen3.8-27B и оптимизированный вариант FP8 пришли 14-го. Обе даты попадают в окно, на которое указывала «следующая неделя». В отрасли, где анонсированные модели регулярно так и не выходят, соблюдение устного дедлайна девятидневной давности само по себе заслуживает упоминания.
Реакция была мгновенной и большой. Ветка на Hacker News про 27B за сутки собрала 1351 балл и 769 комментариев. За считаные часы практики выкладывали рабочие конфигурации запуска под конкретное железо: кто-то поделился настройками и для NVIDIA DGX Spark, и для потребительской видеокарты RTX 4090. Два года назад отрасль встречала открытые релизы иначе — тогда заставить новую архитектуру просто заработать было проектом на выходные.
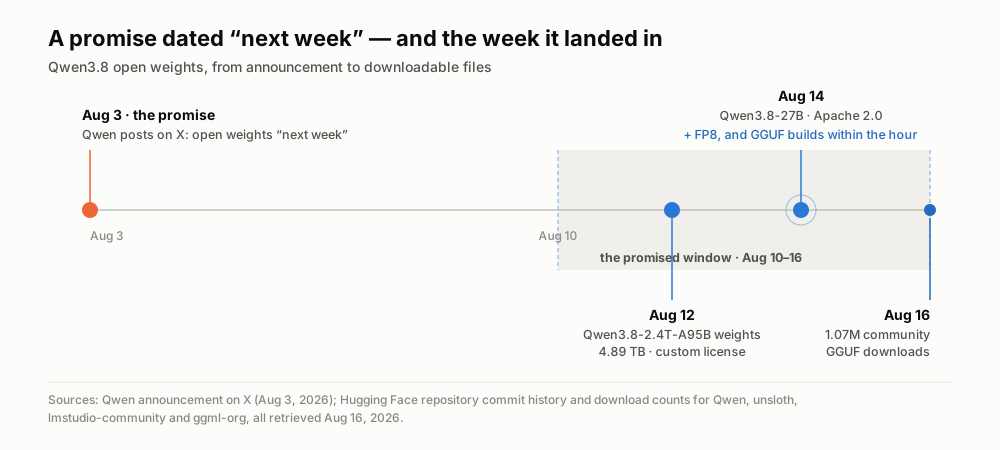
Обещание с датой и две поставки, уложившиеся в него. Даты — из истории коммитов репозиториев Hugging Face, получено 16 августа 2026 года.
Пять терминов, повёрнутых к вопросу «смогу ли я это запустить»
Если вы пришли из наших прошлых материалов, вы уже знаете, что такое открытые веса: лаборатория публикует огромную сетку выученных чисел, из которых состоит готовая модель, и вы можете её скачать, запустить на своём железе и строить на ней продукт, не платя за каждый запрос. Здесь нас занимает следующий вопрос, целиком практический: во сколько запуск обходится в железе?
Параметры — это те самые выученные числа, и их количество задаёт сырой размер модели. Прикидка жестоко проста: в той точности, в которой обучают лаборатории, каждый миллиард параметров — это примерно 2 ГБ на диске, и примерно столько же памяти нужно, чтобы держать модель во время работы. Значит, модель на 27 миллиардов параметров — это загрузка на 55 ГБ. Модель на 2,4 триллиона — почти 5 терабайт. Поэтому одна из них про ноутбук, а другая — про дата-центр.
Квантизация закрывает этот разрыв, и это самая полезная идея для тех, кто хочет запускать модели дома. Обычно параметры хранятся с точностью 16 бит. Квантизация округляет их до меньшего числа бит — 8, 4, иногда 2, — и файл сжимается примерно в той же пропорции. Четырёхбитная квантизация превращает те 55 ГБ примерно в 17 ГБ. Вы теряете немного точности и получаете возможность вообще это запустить. GGUF — просто формат файла, в котором такие сжатые версии распространяются; его читают llama.cpp, Ollama и LM Studio. Когда видите «Q4_K_M», читайте это как «четырёхбитная сборка, которой пользуется большинство».
Плотная модель против смеси экспертов решает, насколько быстро всё пойдёт, когда модель уже поместилась. Qwen3.8-27B плотная: все 27 миллиардов параметров срабатывают на каждом слове. Qwen3.8-Max — модель со смесью экспертов: 2,4 триллиона параметров всего, но маршрутизатор выбирает лишь около 95 миллиардов на токен из 512 специализированных подсетей. Общее число говорит о счёте за хранение, активное — о счёте за вычисления. У этого различия есть очень острое практическое следствие, к которому мы вернёмся.
Контекстное окно — это сколько модель способна удерживать за раз. 27B нативно обрабатывает 262 144 токена — стопку часовых стенограмм совещаний — и растягивается до миллиона правкой конфигурации.
Лицензию нужно читать первой
Вот главный вывод текста, и он противоречит допущению, что у одного семейства моделей одно семейство условий.
Qwen3.8-27B выходит под Apache 2.0. Это самый разрешительный край шкалы: используйте, изменяйте, дообучайте, встраивайте в коммерческий продукт, стройте на этом бизнес — ничего не должны и никого не спрашиваете. Ни порогов по выручке, ни требования показывать название в интерфейсе, ни ограничений по сфере применения.
Qwen3.8-Max — нет. Она выходит под собственной «Qwen3.8-Max License», которая начинается как MIT, а затем добавляет два условия. Если ваш продукт переваливает за 100 миллионов активных пользователей в месяц или 20 миллионов долларов месячной выручки, вы обязаны показывать название модели в интерфейсе. А если вы ведёте бизнес «модель как услуга» или «ИИ-ассистент для работы» с выручкой свыше 50 миллионов долларов за любые двенадцать месяцев подряд, вам нужно отдельное соглашение с Qwen до любого коммерческого использования.
Для одиночного разработчика или компании, использующей модель внутри себя, ничто из этого не кусается. Но это та же самая звёздочка, которую мы отметили, когда Kimi K3 вышла под собственной лицензией вместо MIT, и урок повторяется: «открытые веса» и «открытая лицензия» — два разных вопроса, и лаборатория может ответить на них по-разному для двух моделей, выпущенных с разницей в два дня. Читайте лицензию, прежде чем влюбляться в баллы.
| Модель | Всего параметров | Активных на токен | Размер загрузки | Лицензия | Реальная площадка |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2,4 трлн | 95 млрд | 4892 ГБ | Собственная, порог выручки | Кластер ускорителей |
| Qwen3.8-Max, FP8 | 2,4 трлн | 95 млрд | 2496 ГБ | Собственная, порог выручки | Кластер ускорителей |
| Qwen3.8-27B | 27 млрд, плотная | 27 млрд | 55,6 ГБ | Apache 2.0 | Рабочая станция с несколькими GPU |
| Qwen3.8-27B, FP8 | 27 млрд, плотная | 27 млрд | 30,9 ГБ | Apache 2.0 | Одна топовая видеокарта |
| Qwen3.8-27B, Q4_K_M GGUF | 27 млрд, плотная | 27 млрд | 17,1 ГБ | Apache 2.0 | Ноутбук с 32 ГБ или 4090 |
Что на самом деле нужно, чтобы запустить 27B
Честный ответ: меньше, чем вы думаете, и больше, чем намекают заголовки.
Нижняя ступень — одна команда. 27B есть в библиотеке Ollama: ollama run qwen3.8 подтягивает сборку на 18 ГБ с контекстным окном 256K и вводом изображений, всего вариантов двенадцать, включая версию под чипы Apple. LM Studio, который даёт окно чата вместо терминала, выложил свою сборку через считаные минуты после релиза. Ни то, ни другое не требует понимать предыдущий раздел.
Затем в дело вступает реальность в виде токенов в секунду. Замеры, которые практики выкладывали в ветке релиза, легли примерно туда, куда предсказывает железо. На RTX 4090 с четырёхбитной сборкой кто-то намерил около 48 токенов в секунду — заметно быстрее, чем вы читаете. На Mac mini M4 Pro с 64 ГБ памяти другой получил 12,75 токена в секунду: пользоваться можно, но вы наблюдаете, как он печатает. А на ноутбуке с AMD 7840U и обычными 64 ГБ DDR5 та же четырёхбитная сборка выдала около 4 токенов в секунду — технически работает, практически это пакетная задача, которую запускают и уходят.
Именно последняя цифра показывает, зачем нужно различие «плотная против экспертов». Тот же человек на том же ноутбуке замерил более старую модель со смесью экспертов, номинально более крупную, — около 20 токенов в секунду. В пять раз быстрее меньшей плотной модели, потому что на каждое слово срабатывает лишь часть параметров. Если вы подбираете что-то для запуска на процессоре, сравнивать надо по активным параметрам, а не по общим. Это самый контринтуитивный и самый полезный урок локального ИИ.
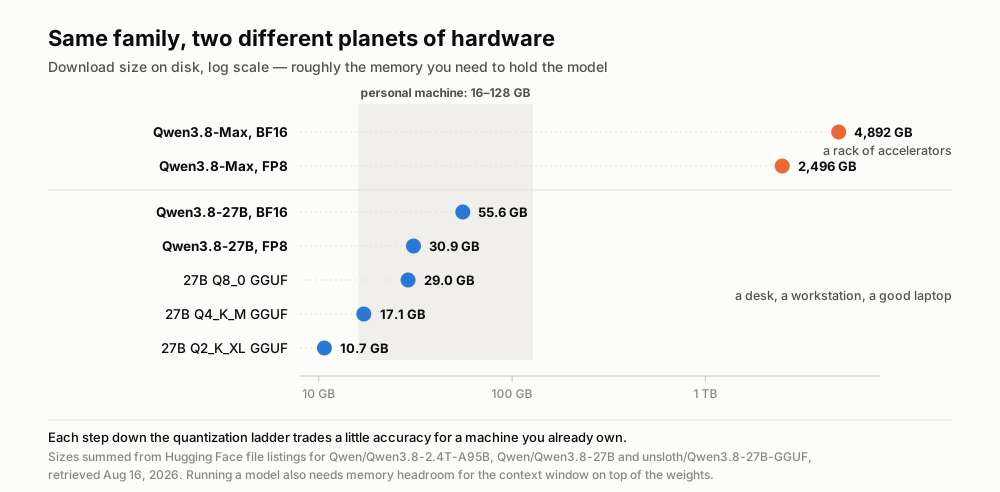
Два представителя одного семейства моделей, различающиеся по размеру загрузки в 290 раз. Размеры просуммированы по спискам файлов Hugging Face, получено 16 августа 2026 года.
Три года назад для этого нужны были утечка и выходные
Чтобы оценить скачок, поставьте его рядом с точкой отсчёта локальных моделей.
В феврале 2023 года Meta выдала веса первой LLaMA только одобренным исследователям. Примерно через неделю они утекли, и вся любительская сцена локальных моделей выросла на файле, которого у людей быть не должно было. 10 марта 2023 года разработчик опубликовал llama.cpp — небольшую программу на C++, чей коронный номер состоял в запуске модели на 7 миллиардов параметров на MacBook. У этого репозитория сегодня 124 тысячи звёзд, и он предок практически всех сегодняшних инструментов «запустить локально».
Сравните два дня релиза. 2023-й: утёкшая 7B, лицензии по сути нет, неделя усилий сообщества, чтобы это заработало, и модель скорее интересная, чем полезная. 2026-й: 27B от передовой лаборатории, намеренно опубликованная под Apache 2.0, с вводом изображений и видео, контекстным окном 262K, а сборки сообщества были готовы раньше, чем документация самой лаборатории перестала меняться. Первый коммит конверсии unsloth пришёлся на 14:56 UTC 14 августа — на четыре минуты раньше последнего обновления карточки со стороны Qwen.
Цифры распространения говорят то же самое резче. К 16 августа четырёхбитные сборки сообщества набрали 867 963 загрузки у одного издателя, 171 518 у второго и 34 520 у третьего: 1,07 миллиона за два дня. Официальные репозитории 27B самой Qwen добавляют ещё 215 тысяч. Qwen3.8-Max, куда более способная модель, остаётся на 17 126 по обоим своим репозиториям.
Перечитайте это соотношение. Модель фронтирного масштаба получила около 1,6 % того внимания, что досталось модели ноутбучного масштаба. Рынок пошёл и взял не способности. Он взял охват.
Чего локальная 27B по-прежнему не умеет
Теперь поправка, потому что энтузиазм обгоняет доказательства предсказуемым образом.
Собственная таблица Alibaba ставит 27B впереди Opus 4.6 Max по ряду метрик агентного программирования и следования инструкциям — 61,7 против 53,4 на SWE-bench Pro, 79,5 против 62,5 на IFBench — и позади по другим, включая 30,8 против 40,0 на HLE, проверяющем широкие знания. Все эти числа заявлены самим производителем. На момент написания у Artificial Analysis, независимого оценщика, на который мы опираемся, вообще нет записи о 27B; зато Qwen3.8-Max стоит там на 10-м месте из 188 моделей с показателем интеллекта 58 — отличный результат, и это другая модель.
Практики оказались резче таблицы. Самое поддержанное возражение в ветке, от человека, назвавшего себя давним пользователем открытых моделей, было прямым: в реальной работе они не обыгрывают лучшие хостируемые модели; они «достаточно хороши» для множества задач и запускаются на доступном железе — это другое и куда более скромное утверждение. Другой комментарий сформулировал потолок физически: нельзя сжать всё человеческое знание в файл на 30 ГБ, поэтому маленькие модели остаются сравнительно слабыми в припоминании малоизвестных фактов, как бы остры они ни становились в коде или работе с инструментами.
Ещё два ограничения проявляются только в эксплуатации. Квантизация не бесплатна: сильно сжатая модель склонна терять нить на длинном контексте и может сваливаться в циклы повторов — поэтому тем, у кого хватает памяти, советуют полную точность. И это поколение Qwen по умолчанию думает подолгу: пользователь дал 27B на Mac mini с 64 ГБ два слова «svg owl» и наблюдал, как она за 17 минут 12 секунд сгенерировала 21 769 токенов рассуждений, прежде чем ответить. Сова получилась хорошая. Получился и счёт в реальном времени, который не выставил бы ни один хостируемый API.
И есть статья, которую никто не считает: эксплуатация теперь ваша. Обновления модели, выбор квантизации, запас памяти, версии драйверов, вентилятор в корпусе. Тот хостируемый API, которого вы избегали, был ещё и командой людей, поддерживавших что-то в рабочем состоянии.
Итог: ров сместился ниже по стеку
Вот суть, и она крупнее одного релиза.
Передовая лаборатория опубликовала способную 27B в четверг. К субботе больше миллиона копий сжатых сообществом версий лежали на машинах у людей, до неё была одна команда в Ollama, и строить на ней бизнес было юридически свободно. Какое бы преимущество эта модель ни представляла, оно стало доступно всем конкурентам одновременно примерно за два дня. Назовём это двухдневным рвом: преимущество модели с периодом полураспада около 48 часов.
Это не прогноз. Это измерение, снятое на этой неделе, на этом релизе.
И оно переопределяет, что значит строить ИИ-продукт. Когда слой модели становится товаром, который любой заменяет за полдня, модель перестаёт быть тем, в чём вы конкурируете. Выживает всё, что вокруг неё: надёжность, когда сервер инференса падает в три часа ночи; конвейеры данных, которые захватывают, чистят и достают нужный контекст; оценка, которая говорит, работает ли это на ваших данных, а не на данных бенчмарка; интерфейс, которым человек и правда будет пользоваться; и договорённости о доверии — приватность, сроки хранения, кто что видит, — от которых зависит, доверит ли вам кто-нибудь свои записи совещаний.
Ничто из этого не становится товаром за два дня. Ни у чего из этого нет кнопки «Скачать».
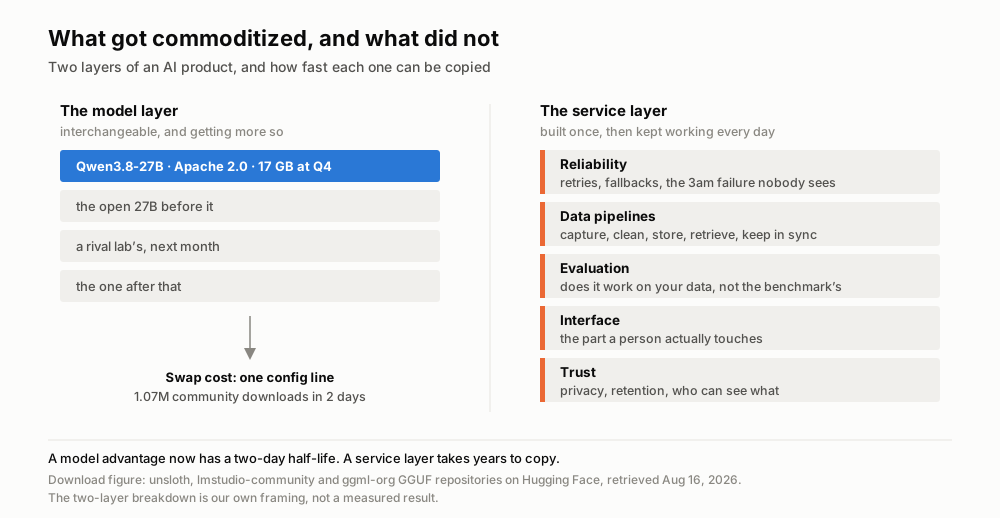
Слой, подешевевший на этой неделе, и слой, который не подешевел. Цифры загрузок с Hugging Face, получено 16 августа 2026 года; деление на два слоя — наша рамка.
Так что правильная реакция на приход отличной открытой модели на ноутбуки — не «модельные компании победили» и не «продуктовые проиграли». Она в том, что интересная работа переехала этажом ниже по стеку — туда, где её гораздо труднее скопировать и гораздо скучнее выносить в заголовок.
Где здесь Telli.sh. Мы строим ровно этот сервисный слой, поверх открытых моделей. Telli.sh уже использует открытую модель Qwen в тракте суммаризации, а значит, каждый скачок качества открытых моделей — включая нынешний — напрямую попадает в расшифровку, перевод и резюме совещаний без изменения цены с вашей стороны. Наше время уходит на ту часть, которая не приезжает внутри файла GGUF: надёжно захватить звук, не перепутать говорящих, превратить 60-минутную запись в заметки, которые вы найдёте спустя месяцы, и внятно ответить, где живут ваши данные.
Источники
- Карточка модели и лицензия Qwen3.8-27B, Hugging Face
- Карточка модели и лицензия Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: квантизованные сборки и счётчики загрузок
- Qwen3.8 в библиотеке моделей Ollama
- Обсуждение выхода Qwen3.8-27B на Hacker News (14 августа 2026 года)
- Страница модели Qwen3.8 Max на Artificial Analysis
- Анонс открытых весов от Qwen (@Alibaba_Qwen) в X (3 августа 2026 года)
- Репозиторий llama.cpp, создан 10 марта 2023 года
- Страница изображения на Wikimedia Commons
