Трёхнедельный рывок открытых весов из Китая: Kimi K3, Qwen3.8-Max и поворот, способный всё оборвать
За три недели крупнейшие AI-лаборатории Китая выпустили или анонсировали открытые модели фронтирного уровня — Kimi K3, Qwen3.8-Max и DeepSeek V4 в общем доступе. Понятный разбор простыми словами: что представляет собой каждая модель, что действительно вышло, а что пока лишь обещание, и почему Пекин может теперь ограничить волну, которую сам же и запустил.
С 16 по 26 июля три крупнейшие AI-лаборатории Китая выложили на стол открытые модели фронтирного уровня. Moonshot AI анонсировала Kimi K3 16 июля и выложила веса 26 июля. Alibaba представила Qwen3.8-Max 19 июля на WAIC в Шанхае. Линейка V4 от DeepSeek достигла общего доступа (GA) около 20 июля. Три лаборатории, примерно три недели.
Закономерность трудно не заметить, и это не та, на которой китайская сцена открытых моделей построила свою репутацию. Эти лаборатории были известны маленькими, быстрыми, дешёвыми моделями, которые били выше своей весовой категории. Нынешняя волна — ставка противоположная: системы с триллионами параметров, выпущенные или обещанные как открытые веса.
Это честный разбор той волны: что действительно вышло, что пока лишь превью или обещание, и поворот, пришедший вместе с ней, — то самое правительство, что сделало эти релизы возможными, теперь взвешивает, не ограничить ли их. Мы сведём жаргон к минимуму и остальное будем пояснять по ходу, чтобы вы могли следить за историей, даже если «открытые веса» и «mixture-of-experts» для вас в новинку. Если вы читали наш июльский обзор, это продолжение, и одна из его недосказанностей разрешилась.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Сначала — пять понятий, без которых картина не сложится
Если вы новичок в этом уголке ИИ, пять терминов несут на себе большую часть истории, и им стоит уделить минуту простыми словами, прежде чем переходить к моделям.
«Открытые веса» (open weights) — это и есть вся причина, почему эта волна важна. Веса модели — это огромная сетка чисел, которую она выучила во время обучения, фактически готовый мозг. Когда лаборатория публикует веса, вы можете скачать этот файл, запустить модель на своём железе, донастроить её и строить на ней продукты, ни у кого не спрашивая разрешения и не платя за каждый запрос. Альтернатива — закрытая модель, как большинство коммерческих чат-ботов, где веса заперты на серверах вендора, а вы арендуете доступ через платный API. Открытые веса превращают модель из услуги, которую вы арендуете, в вещь, копией которой вы владеете, — и именно эта разница заставляет целую индустрию прислушиваться, когда выходит хорошая модель.
«Параметры» — это те самые выученные числа, и их количество — грубый ориентир того, сколько модель может в себе удержать. Модель «на 2,8 триллиона параметров» имеет их 2,8 триллиона. Больше не значит автоматически лучше, но на фронтире это обычно означает больше простора для рассуждения — и, что не менее важно, больше железа, чтобы её запустить. Тут и появляется «mixture-of-experts» (MoE). Вместо того чтобы зажигать все параметры на каждое слово, MoE-модель разбита на множество специализированных подсетей — экспертов, и маршрутизатор выбирает лишь горстку на каждый токен. Так что когда вы видите «всего 2,8 триллиона, активных 104 миллиарда», это значит, что модель огромна, но в любой момент работают лишь около 104 миллиардов параметров — как больница с тысячами специалистов, где каждого пациента смотрят только несколько профильных. Общее число намекает, насколько модель способна; активное — сколько стоит её обслуживать. Этот разрыв — самое полезное одно число для оценки стоимости.
«Окно контекста» — это сколько текста модель может держать в уме одновременно, считается в токенах, а токен — это примерно три четверти слова. Окно в миллион токенов — не абстрактная спецификация: это несколько длинных романов или десятки часовых расшифровок совещаний за один проход. Это разница между тем, чтобы обобщить одно письмо, и тем, чтобы рассуждать над целым кварталом писем.
Наконец, лицензия — и это та часть, которую практикам стоит читать первой, до бенчмарков. Лицензия — это юридический мелкий шрифт, определяющий, что вам можно делать с весами. MIT — золотой стандарт: используйте, меняйте, встраивайте в коммерческий продукт — вы ничего не должны. Собственная лицензия может выглядеть открытой, но вырезать именно тот сценарий, что вы задумали, — например, взимать плату, когда построенный на ней бизнес вырастет. Две модели могут обе быть «открытыми весами» и при этом различаться как небо и земля в том, что разрешено юридически. Поэтому окупается прочесть эту строку, прежде чем влюбляться в оценку. С этими пятью понятиями в руках волна читается ясно.
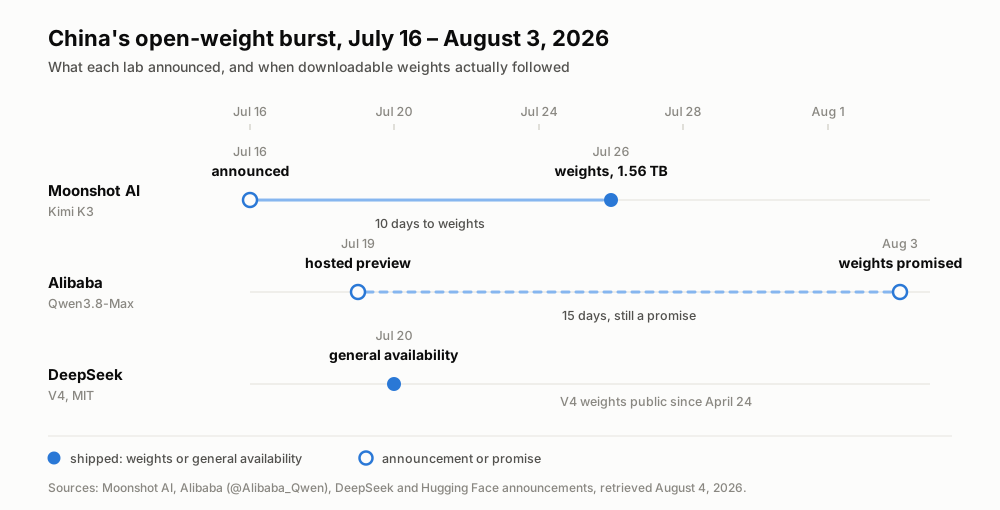
Три лаборатории, три недели — и только два из этих пяти моментов действительно отдали веса в чужие руки. Даты по официальным анонсам лабораторий, проверено 4 августа 2026 года.
Реально вышла именно Kimi K3
Начнём с Moonshot AI — пекинской лаборатории, стоящей за ассистентом Kimi, которая за минувший год заработала репутацию на крупных и способных открытых моделях. Когда мы писали о Kimi K3 в июле, веса были лишь обещанием — Moonshot говорила «до 27 июля». Они пришли 26 июля: 1,56 терабайта в 96 шардах на Hugging Face, под moonshotai/Kimi-K3. Вот это и есть новость. Анонс — это пресс-релиз; скачиваемые веса — факт, на котором можно строить.
Простыми словами, K3 — одна из крупнейших когда-либо выпущенных открытых моделей: система mixture-of-experts на 2,8 триллиона параметров всего и около 104 миллиардов активных на токен, маршрутизирующая примерно 16 из 896 экспертов через механизм, который Moonshot называет Kimi Delta Attention, с окном контекста в один миллион токенов и заявленным приростом эффективности масштабирования около 2,5x по сравнению с предшественником K2. Если снять со спецификации язык таблиц: она очень большая, для своего размера сравнительно недорога в запуске, потому что на токен зажигается лишь часть, и способна проглотить целиком вход размером с книгу.
Эти числа также говорят, кто на самом деле будет её запускать. 1,56 терабайта в 96 шардах — не загрузка на ноутбук; это артефакт датацентрового класса, которому только для загрузки нужен кластер топовых ускорителей. На практике почти никто из частных лиц не станет хостить K3 сам — до неё будут добираться через провайдеров, у которых уже есть железо, и этот рынок появился в первый же день: Together AI и Modal подняли хостируемые эндпоинты Kimi K3 в тот момент, когда веса приземлились. Именно так любопытный читатель пробует её сегодня — не скачивая 1,56 ТБ, а обращаясь к одному из этих эндпоинтов или используя приложение Kimi. «Открытость» здесь означает, что веса публичны и любой с подходящим железом может их обслуживать, что как раз и держит цены конкурентными; это не значит, что вы лично запустите её на своём столе.
Хороша ли она? По единственному независимому числу, которому мы доверяем в этот раз, — да. В рейтинге Artificial Analysis она заняла 4-е место из 189 моделей — позади Claude Fable 5 и двух конфигураций GPT-5.6 «Sol», впереди Opus 4.8 и GPT-5.5. Для открытой модели, которую можно скачать, уже само нахождение в такой компании — это история.
Затем прочитайте лицензию, потому что именно здесь у «открытости» появляется звёздочка. Kimi K3 — не MIT. Она выходит под собственной «Kimi K3 License», не одобренной OSI, с пунктом о пороге выручки: запускать K3 как движок крупного бизнеса Model-as-a-Service можно лишь по отдельному соглашению с Moonshot. Для одиночного разработчика или обычной компании, использующей её внутри, это ничего не меняет. Но для тех, кто строит размещённый продукт в большом масштабе, «открытые веса» и «открытая лицензия» — два разных вопроса, и здесь однозначное «да» только у первого.
Qwen3.8-Max — это превью, а не загрузка
Qwen — это семейство моделей Alibaba, а её команда — среди самых плодовитых в мире по выпуску открытых моделей; именно эта история и делает новейшую модель запутанной. Представленная 19 июля на WAIC в Шанхае, Qwen3.8-Max — самый громкий заголовок волны и одновременно самый мягкий. Это разреженная MoE на 2,4 триллиона параметров — число активных не раскрыто — и первая Qwen за пределами триллиона параметров, ставшая мультимодальной: она принимает на вход не только текст, но и изображения, видео и документы.
Вот подвох, который новичку надо разжевать: несмотря на фанфары, скачать её нельзя. Сейчас она существует только как «размещённое превью» — qwen3.8-max-preview, доступное через собственный сервис Alibaba (её Token Plan и инструмент Qoder) примерно за 10% от стандартной цены. Размещённое превью означает, что Alibaba запускает модель на своих серверах и даёт вам её вызывать; это модель арендованного API, а не модель, копией которой вы владеете. Называть это сегодня релизом открытых весов преждевременно.
Эта картина изменилась 3 августа. Официальный аккаунт Qwen в X, @Alibaba_Qwen, написал, что открытые веса Qwen3.8-Max выйдут «на следующей неделе» — и что меньшая Qwen3.8-27B тоже станет открытой. Так что 27B — не слух, что бы ни намекала прежняя болтовня: это зафиксированное обязательство собственного аккаунта Alibaba. И размер — это главное. Там, где Max на 2,4 триллиона параметров, как и K3, под силу лишь датацентру, 27B достаточно мала, чтобы её обслуживать на одной мощной машине — тот класс, который частное лицо или небольшая команда действительно может хостить сами. Это по-настоящему смягчает картину «обещали без конкретики»: теперь есть и размер, и примерный срок.
Впрочем, честные оговорки остаются в силе. «Следующая неделя» — это направление, а не дата отгрузки, и на момент написания, 4 августа, в организации Qwen на Hugging Face ничего не появилось — новейшие модели там от июня. Лицензия на открытые веса тоже не опубликована, а первые читатели условий превью отметили возможные региональные ограничения — неподтверждённые, пока не выйдет настоящая лицензия, — ровно тот урок «сначала лицензия» из вводной части. Утверждение Alibaba, что модель «уступает только Fable 5», остаётся собственной оценкой без сторонних цифр, так что считайте это маркетинговой формулировкой вендора, пока кто-то вне Alibaba не измерит. Если хотите попробовать модель сегодня, размещённое превью — единственная дверь, но впервые ожидание скачиваемых весов измеряется в «следующей неделе», а не в «когда-нибудь».
DeepSeek V4 тихо вышла в общий доступ
DeepSeek — это лаборатория, чья модель R1 помогла запустить нынешнюю гонку открытых моделей в начале 2025 года, и, верная себе, здесь она объявляла меньше всех, а выдала самое пригодное к работе. Её линейка V4, выпущенная ещё 24 апреля, — та, которую можно внедрить проще всего, потому что она выходит под лицензией, которую вводная часть отметила как золотой стандарт.
V4 идёт в двух размерах, оба под MIT. V4-Pro — флагман на 1,6 триллиона всего и 49 миллиардов активных параметров; V4-Flash — лёгкая на 284 миллиарда всего и 13 миллиардов активных. Вспомните, что означает активное число: V4-Flash зажигает всего 13 миллиардов параметров на токен, что делает её дешёвой и быстрой в обслуживании, и это и есть тот бюджетный выбор для высокообъёмной работы — той самой нагрузки «расшифровать и обобщить», где цена за токен решает всё. У обеих окно контекста в один миллион токенов, и они могут выдать до 384K токенов вывода в одном ответе — достаточно, чтобы набросать длинный отчёт, а не только абзац. Около 20 июля V4 достигла общего доступа с повременной тарификацией, что и втянуло весенний релиз в те же три недели, что K3 и Qwen.
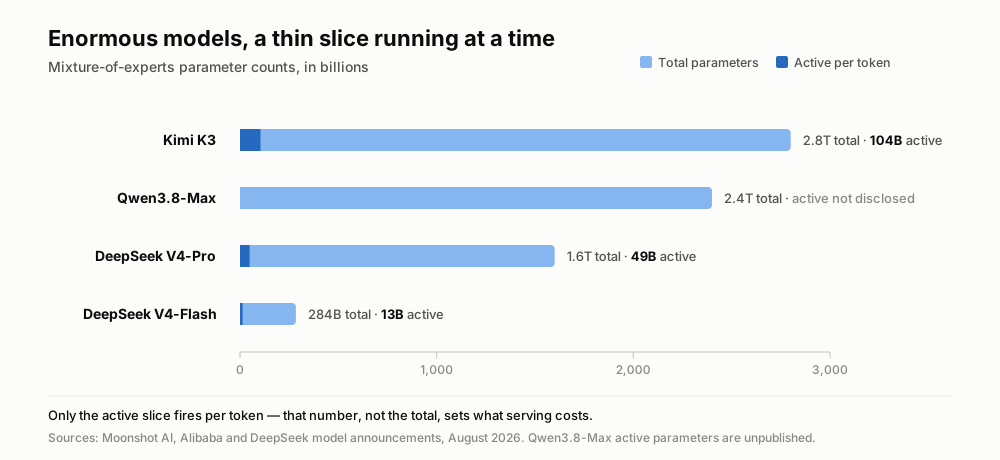
Светлая полоса — размер модели, тёмный обрубок — то, что реально включается на каждом токене. Alibaba не раскрыла активные параметры Qwen3.8-Max.
Поскольку это MIT, V4 — та, на которой внедренец может строить с наименьшим числом юристов: возьмите веса (или используйте хостируемого провайдера), запустите, выпускайте коммерчески — ничего не должны и никого не спрашиваете. И чтобы прояснить с номерами версий, раз уж слухи их обожают, — нет ни R2, ни V5, ни V4.1. Есть только семейство V4, дозревающее до того, на что команды могут опереться.
Разрыв сокращается быстрее, чем признают рейтинги
Если отступить на шаг, наклон важнее отдельных релизов. По оценке Nathan Lambert, расстояние между лучшими открытыми и лучшими закрытыми моделями сжалось примерно с шести-девяти месяцев до трёх-пяти — «открытые модели не были так близки к фронтиру со времён DeepSeek R1». Проще говоря: свободно скачиваемые модели теперь всего на несколько месяцев позади лучших моделей, которые можно арендовать за деньги, тогда как год назад они отставали на комфортный круг.
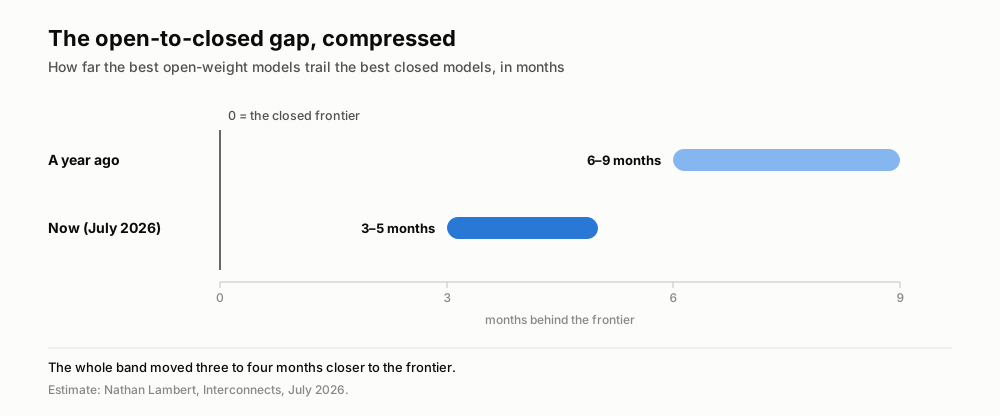
Оценка Лэмберта, нарисованная в масштабе: открытый лагерь не просто приблизился — сузился весь диапазон.
Данные об использовании указывают в ту же сторону. На OpenRouter — маркетплейсе, распределяющем запросы между многими моделями, — доля токенов у моделей американского происхождения упала примерно с 70% в июне 2025 года до примерно 30% год спустя, тогда как модели китайского происхождения теперь регулярно берут отметку выше 30%. Во многом дело в цене: китайские открытые модели обычно дешевле на 60–90% за токен, и хостинг появился сразу, как ясно показали те эндпоинты K3 в день нулевого релиза.
Более тихая перемена — про масштаб. Бренд китайской открытой модели был «маленький, быстрый, дешёвый». K3 на 2,8 триллиона параметров и Qwen3.8-Max на 2,4 триллиона — прямая противоположность: ставка на то, что идти вширь в открытом теперь стоит того. GLM-5.2 от Z.ai, выпущенная 16 июня под MIT и возглавляющая категорию открытых весов в Artificial Analysis Index с показателем 51, — то же послание от четвёртой лаборатории.
Поворот: правительство, сделавшее это возможным, может это ограничить
Затем ветер переменился. Около 22–25 июля Financial Times и Reuters сообщили, что Министерство коммерции Китая взвешивает экспортный контроль над AI-моделями — включая открытые LLM, — и что Alibaba, ByteDance и Z.ai якобы участвуют в обсуждениях. Обсуждаемая схема — многоуровневая: уведомительный порядок для более слабых моделей, проверка безопасности для более сильных и возможный запрет на открытую публикацию самых способных. Пока ничего не стало законом. Но направление показательно: волна, возможно, достигает пика ровно в тот момент, когда её собственное правительство начинает трактовать эти модели как стратегический экспорт, а не как открытый вклад.
Итог: когда открытое становится стратегическим активом
Удобная версия гласит «Китай догнал». Более точная гласит, что открытые веса стали стратегическим активом так быстро, что правительство теперь хочет держать руку на кране. За три недели открытые модели сократили отставание от фронтира с двух-трёх кварталов до одного — и из маленьких и дешёвых превратились в одни из крупнейших моделей, когда-либо опубликованных в любой форме. Открытый фронтир не просто сдвинулся. Он сдвинулся туда, откуда его создатели, возможно, не будут вольны продолжать поставки.
Для команд, строящих на этих моделях, практический вывод не изменился и стал чуть острее. Telli.sh уже использует открытую модель Qwen3 в слое суммаризации, так что каждый выигрыш в качестве и цене открытых моделей напрямую перетекает в расшифровку встреч, перевод и резюме. Новая строка — снабжение: если китайские правила экспорта примут ту форму, на которую указывают сообщения, вопрос о том, какие открытые модели останутся свободно скачиваемыми, — то, за чем стоит следить, а не считать данностью. Улучшение моделей, питающих этот слой, — тренд; а откуда этим моделям позволено приходить — то, с чего не стоит спускать глаз.
Источники
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
