Um arquivo de 16,5 GB já supera o melhor modelo fechado de fevereiro
Há três anos, o melhor modelo que dava para baixar perdia por 37 pontos para o GPT-4 no HumanEval e exigia duas placas de vídeo. Na semana passada, um modelo aberto de 27B marcou 52,0 no índice de inteligência da Artificial Analysis, contra 44,9 do Claude Opus 4.6 Max — por um nono do preço, a partir de um arquivo de 16,5 GB. Um antes e depois com as tabelas de benchmarks, a curva de preços e o que significa a defasagem de alcance ter caído para 162 dias.
Alguém no Hacker News está rodando um modelo de linguagem de primeira linha numa placa de vídeo de 16 GB, a 50 ou 60 tokens por segundo, com janela de contexto de 128.000 tokens. O modelo é o Qwen3.8-27B, lançado em 14 de agosto de 2026. No índice de inteligência da Artificial Analysis ele marca 52,0 — acima do Claude Opus 4.6 Max, que até fevereiro era o melhor modelo proprietário do mercado e fica em 44,9.
Em 2023, essa frase seria ficção científica. E não do tipo divertido.
Este texto é o antes e depois. Não a cobertura do lançamento — essa nós já escrevemos —, mas a comparação ao longo de três anos: quanto o melhor modelo baixável marcava contra a fronteira antes e agora, quanto custava comprar certo nível de inteligência antes e agora, e que hardware era preciso ter para rodar por conta própria. Cada número abaixo tem fonte e data. A tendência que eles desenham é uma das coisas mais genuinamente otimistas que estão acontecendo hoje no software.
Resumo:
- A distância fechou, e dá para datar. Em julho de 2023 o melhor modelo aberto perdia por 17,5 pontos no MMLU e 37,1 no HumanEval para o GPT-4. Em agosto de 2026, um 27B aberto vence a nau capitânia proprietária de fevereiro em 15 dos 19 benchmarks que os dois publicam, e também num índice composto independente.
- O preço caiu cerca de 208 vezes em 23 meses, na medição da Epoch AI com limiar de capacidade fixo. O 27B aberto custa hoje US$ 1,09 por milhão de tokens em tarifa mista, contra US$ 10,00 do Opus 4.6 Max — e zero por token se você rodar em casa.
- Não é a fronteira, e nós dizemos isso. O Claude Opus 5 Max marca 63,1 e o GPT-5.6 Sol Max, 60,9. Em raciocínio de conhecimento amplo o 27B perde com folga para o Opus 4.6: 30,8 contra 40,0 no HLE.
Imagem: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. A interconexão de um Cray Y-MP, por volta de 1988. Computação séria já foi uma sala em que se entrava.
Como era de fato o «antes»
Ponha o relógio em 18 de julho de 2023, o dia em que a Meta publicou o Llama 2. Era o melhor modelo livremente baixável do mundo, e o próprio artigo imprimiu o placar contra a fronteira fechada sem rodeios.
O Llama 2 70B marcou 68,9 no MMLU contra 86,4 do GPT-4. No GSM8K, 56,8 contra 92,0. No HumanEval, o benchmark de programação, 29,9 contra 67,0 — menos da metade. O resumo do próprio artigo diz: «Ainda há uma grande diferença de desempenho entre o Llama 2 70B e o GPT-4 e o PaLM-2-L». Essa é a nau capitânia dos pesos abertos em 2023, nas palavras dela mesma.
Agora o hardware. A build comunitária de 4 bits do TheBloke — o jeito como as pessoas de fato rodavam o Llama 2 70B — era um arquivo de 41,4 GB, publicado em 4 de setembro de 2023. Para rodar em velocidade utilizável, eram necessárias duas placas de 24 GB ou um Mac de 64 GB. O modelo que realmente cabia num notebook comum era o Llama 2 13B: arquivo de 7,9 GB, 54,8 no MMLU, 31,6 pontos atrás do GPT-4 e útil para pouco além de demonstração.
Ou seja, o acordo de 2023 era: pagar um laboratório de fronteira, ou rodar algo visivelmente pior num hardware que a maioria não tinha. É exatamente por isso que o argumento «use logo a API» venceu de forma tão categórica por dois anos. Ele estava certo.
Agora a mesma pergunta em agosto de 2026
A Alibaba publicou o Qwen3.8-27B em 14 de agosto de 2026 sob Apache 2.0 e imprimiu no cartão do modelo uma comparação direta com o Claude Opus 4.6 Max. Contamos todas as linhas em que os dois modelos informam um número.
O Qwen3.8-27B vence 15 dessas 19 linhas e perde 4. Entre as vitórias estão SWE-bench Pro (61,7 contra 53,4), obediência a instruções no IFBench (79,5 contra 62,5), programação competitiva no LiveCodeBench v6 (90,3 contra 88,8), uso de computador no OSWorld-Verified (84,3 contra 72,7), tarefas de agente móvel no AndroidWorld (81,9 contra 62,0) e uma sequência longa de benchmarks multimodais em que as margens não são apertadas: 90,0 contra 65,5 no MathVision, 83,7 contra 66,0 na análise de gráficos do CharXiv, 65,5 contra 40,8 no raciocínio corporificado do ERQA.
As quatro derrotas importam mais que as vitórias, porque dizem o que um modelo de 27 bilhões de parâmetros ainda não consegue fazer. Ele perde no Terminal Bench 2.1 (73,0 contra 78,2), na geração de código em escala de repositório no NL2Repo-Bench (42,3 contra 47,6), por pouco no GPQA Diamond (89,2 contra 91,3) e com clareza no HLE, o benchmark de raciocínio multidisciplinar amplo: 30,8 contra 40,0. Esse último é a forma exata da limitação inteira. Não dá para comprimir o conhecimento do mundo num arquivo de 16,5 GB; dá para comprimir uma quantidade enorme de habilidade.
Uma linha merece asterisco: o 79,0 contra 63,8 vem do QwenSWEBench, um benchmark construído pela própria Qwen. Resultado de fornecedor no benchmark do próprio fornecedor é a evidência mais fraca de qualquer cartão de modelo, e não contamos com ele.
O placar independente diz o mesmo
Tabela de fornecedor é tabela de fornecedor, então vamos a um terceiro. A Artificial Analysis, que roda as próprias avaliações em vez de reimprimir números alheios, já mediu o 27B. Em 21 de agosto de 2026 ela atribui ao Qwen3.8-27B um índice de inteligência de 52,0, primeiro lugar entre 135 modelos na classe de pesos abertos de 4 a 40 bilhões de parâmetros, contra 44,9 do Claude Opus 4.6 Max. São 7,1 pontos a favor do modelo aberto, medidos por quem não tem interesse no resultado, 190 dias depois do lançamento do Opus 4.6.
Siga essa comparação para trás no tempo e é aí que está a história. Em julho de 2023, o melhor modelo aberto abaixo de 40 bilhões de parâmetros marcava 2,6 no mesmo índice. Em julho de 2024, 7,4. Em março de 2025, 13,4. Em fevereiro de 2026, 34,6. Semana passada, 52,0.
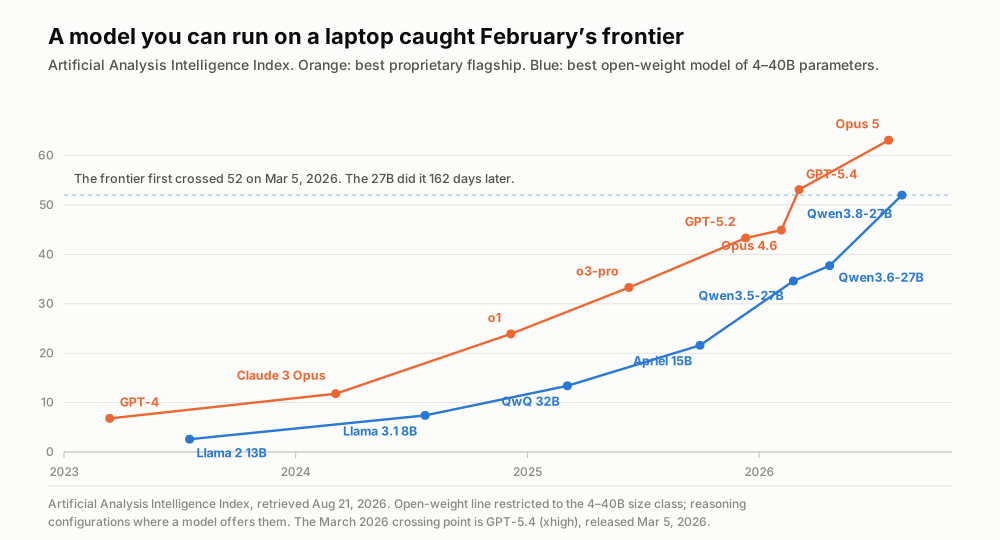
As duas linhas sobem; a grandeza interessante é a distância horizontal entre elas. Índice de inteligência da Artificial Analysis, consultado em 21 de agosto de 2026.
Eis o número que merece um nome. A fronteira cruzou o índice 52 pela primeira vez em 5 de março de 2026, quando o GPT-5.4 marcou 53,1 no esforço máximo de raciocínio. Um modelo pequeno o bastante para rodar numa máquina pessoal chegou lá em 14 de agosto — 162 dias depois. Vamos chamar isso de defasagem de alcance: o tempo entre uma capacidade aparecer na fronteira e aparecer no seu próprio hardware.
Essa defasagem já foi bem maior. O Llama 3.1 8B levou 260 dias para chegar a um nível que o GPT-4 Turbo já havia atingido. O GLM-4.7-Flash levou 410 dias para igualar o o1. Os três últimos lançamentos de porte de notebook ficaram em 201, 155 e 162 dias. A fronteira não está desacelerando — o Opus 5 Max está hoje em 63,1 —, mas a borda que persegue está encurtando cerca de duas vezes mais rápido do que há dois anos.
O preço não caiu: desabou
Capacidade é metade do antes e depois. A outra metade é a fatura.
A Epoch AI publicou a medição mais limpa disso em março de 2025, e vale entender o método: fixa-se uma nota de benchmark e acompanha-se, ao longo do tempo, qual é o modelo mais barato que a atinge. Fixe o limiar nos 86 pontos do GPT-4 no MMLU e a escada fica assim: US$ 37,50 por milhão de tokens em março de 2023, US$ 15,00 em novembro de 2023, US$ 7,50 em maio de 2024, US$ 2,19 ainda no mesmo mês e US$ 0,18 em fevereiro de 2025. Mesma nota. 208 vezes mais barato em 23 meses.
A conclusão central da Epoch é que o ritmo varia enormemente conforme a tarefa — entre 9 e 900 vezes por ano, dependendo de qual capacidade se fixa —, com o preço do desempenho de nível GPT-4 em questões científicas de doutorado caindo cerca de 40 vezes por ano. A direção é que nunca varia.
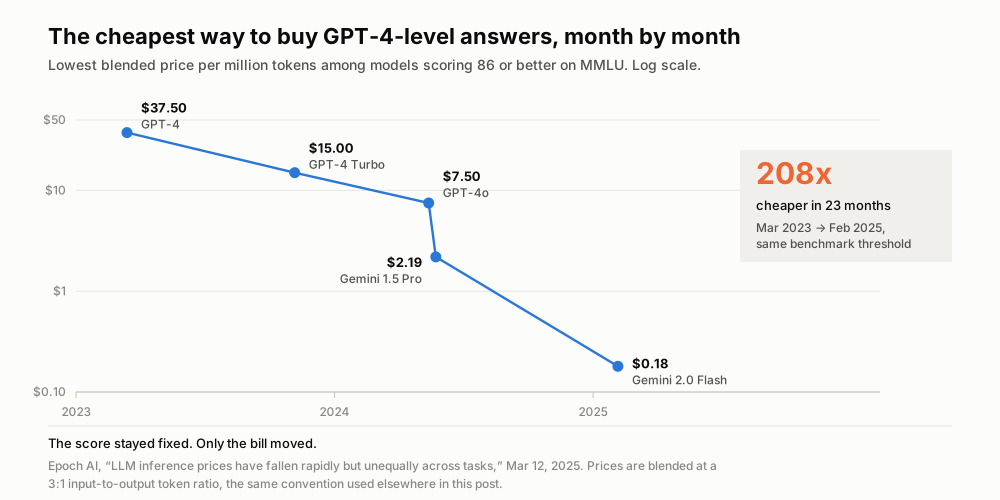
A nota do benchmark é constante em cada ponto desta linha. Epoch AI, 12 de março de 2025.
Estenda a série até os preços de hoje e o movimento continua. No catálogo da OpenRouter em 21 de agosto de 2026, o Qwen3.8-27B custa US$ 0,45 por milhão de tokens de entrada e US$ 3,20 por milhão de saída; o Claude Opus 4.6 custa US$ 5,00 e US$ 25,00. Misturados na proporção 3 para 1 usada pela Epoch, dá US$ 1,09 contra US$ 10,00 — o modelo aberto é 9,1 vezes mais barato e 7,1 pontos de índice melhor que a nau capitânia fechada de seis meses atrás.
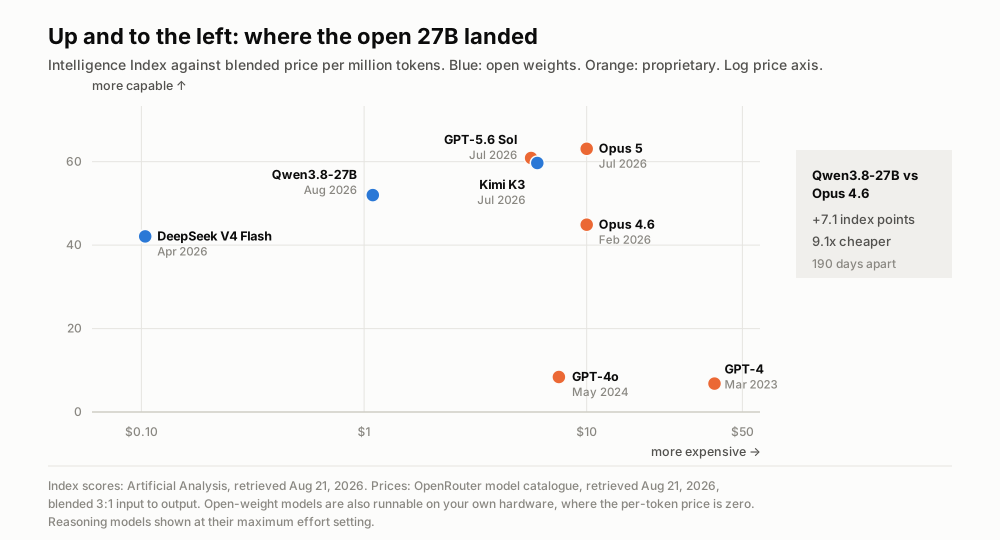
Todo modelo que importa está migrando para o canto superior esquerdo. Notas da Artificial Analysis, preços da OpenRouter, ambos consultados em 21 de agosto de 2026.
E existe ainda a opção que não tem preço por token nenhum. Rode o 27B na sua própria RTX 4090 nos cerca de 48 tokens por segundo relatados por usuários na discussão do lançamento, assuma os 450 watts nominais da placa e, ao preço médio residencial de eletricidade nos Estados Unidos de 18,44 centavos por quilowatt-hora (EIA, maio de 2026), a energia sai por cerca de US$ 0,48 por milhão de tokens de saída — antes de contar a placa, e depois de parar de contar a margem de quem quer que seja. É uma estimativa calculada com as premissas na mesa, não uma alegação de fornecedor.
O antes e o depois, linha a linha
| Julho de 2023 | Agosto de 2026 | |
|---|---|---|
| Melhor modelo baixável | Llama 2 70B (Meta, 18 de julho de 2023) | Qwen3.8-27B (Alibaba, 14 de agosto de 2026) |
| Parâmetros | 70 bilhões | 27 bilhões |
| Build comunitária padrão de 4 bits | 41,4 GB | 16,5 GB |
| Menor build utilizável | 7,9 GB (13B, MMLU 54,8) | 9,8 GB (2 bits, contexto de 128K numa placa de 16 GB) |
| Hardware realista | duas GPUs de 24 GB ou um Mac de 64 GB | uma GPU de consumo de 16 GB |
| Modelo de fronteira da época | GPT-4 (14 de março de 2023) | Claude Opus 4.6 Max (5 de fevereiro de 2026) |
| Resultado contra ele | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | vence 15 dos 19 benchmarks publicados, +7,1 pontos de índice |
| Preço misto desse modelo de fronteira | US$ 37,50 por milhão de tokens | US$ 10,00 por milhão de tokens |
| Preço misto do modelo aberto | sem oferta em escala | US$ 1,09 por milhão de tokens |
| Licença | Llama 2 Community License | Apache 2.0 |
As fontes de cada célula estão no fim. A linha à qual sempre voltamos é a penúltima: o preço da própria fronteira caiu 3,75 vezes em três anos, enquanto a alternativa aberta apareceu abaixo dela, em torno de um décimo desse valor. As duas coisas aconteceram. A segunda é a que muda quem consegue construir.
O que ainda não é verdade
O entusiasmo em torno deste lançamento passa na frente das evidências em quatro pontos específicos. Vamos marcá-los.
Não é a fronteira. No mesmo índice, o Claude Opus 5 Max marca 63,1 e o GPT-5.6 Sol Max, 60,9, bem acima de 52,0. Se o seu trabalho depende do raciocínio mais difícil disponível, a fronteira continua sendo outro produto, e continua fechada.
Não é barato para o tamanho. O próprio resumo da Artificial Analysis chama o Qwen3.8-27B de «particularmente caro em comparação com outros modelos de pesos abertos de tamanho semelhante»: a mediana da classe é US$ 0,05 por milhão de tokens de entrada, contra US$ 0,43 do Qwen. Você está pagando por capacidade, não por parâmetros.
Ele é prolixo, e prolixidade é conta. Ao rodar a avaliação do índice de inteligência, o 27B gerou 160 milhões de tokens de saída, contra uma mediana de 45 milhões. Um usuário deu a ele um prompt de duas palavras num Mac mini de 64 GB e o viu pensar por 17 minutos e 12 segundos. Modelos de raciocínio cobram em tempo de relógio mesmo quando os tokens são grátis.
E as notas de benchmark pertencem ao modelo em precisão total. A build de 2 bits e 9,8 GB que cabe na sua placa de vídeo não é o modelo que tirou 52,0. Quantização pesada custa exatidão, sobretudo em contextos longos. Toda afirmação do tipo «roda num notebook», inclusive a nossa, carrega esse asterisco.
Por que a defasagem deve continuar encolhendo
Daqui em diante é a nossa leitura, e marcamos a virada com clareza: tudo acima é medição; o que vem a seguir é inferência a partir dela.
O mecanismo que empurra a defasagem para baixo não é misterioso. As técnicas de pós-treinamento publicadas na fronteira são reproduzidas em laboratórios abertos em questão de meses. O controle de esforço de raciocínio, que há um ano e meio era truque proprietário, aparece hoje como parâmetro documentado neste cartão de modelo. A quantização comunitária termina antes de a documentação do laboratório original parar de mudar. Nenhum desses três laços de realimentação tem motivo para desacelerar, e dois deles ficam mais rápidos quanto mais gente participa.
Logo, a expectativa razoável para a próxima geração não é que os modelos abertos ultrapassem a fronteira. É que esses 162 dias continuem comprimindo enquanto a capacidade absoluta sobe nas duas pontas. Aí o limiar interessante deixa de ser «modelos abertos conseguem ganhar?» e passa a ser «quão recente a fronteira precisa ser para a diferença parar de importar na minha tarefa?». Para transcrição de reuniões, tradução, resumo e a maior parte do trabalho com documentos, esse limiar foi cruzado há um bom tempo. Para pesquisa de ponta e a engenharia agêntica mais difícil, não.
É um mundo bem melhor que o de 2023, e vale dizer isso sem rodeios. O custo de dar a um computador uma compreensão competente da linguagem caiu duas ordens de grandeza em três anos e continua caindo. Quem mais ganha são os que estavam de fora por preço: desenvolvedores solo, times em países onde US$ 10 por milhão de tokens não é erro de arredondamento, pesquisadores com bolsa em vez de orçamento, e todo mundo que precisa manter os dados na própria máquina por razões legais.
Conclusão: a fronteira deixou de ser um lugar e virou uma data
A pergunta antiga era a qual laboratório você tem acesso. A nova é quantos meses atrás da fronteira você aceita ficar, sabendo que custa um nono e roda num hardware que já é seu.
Para um número crescente de tarefas, a resposta honesta é: uns cinco meses, e caindo.
Onde a Telli.sh entra: tudo acima é o motivo de construirmos sobre modelos abertos em vez de em torno de um único fornecedor. A Telli.sh já usa um modelo Qwen aberto no caminho de resumo, então cada degrau descido nesta curva chega como ata de reunião melhor, e não como aviso de reajuste. Nosso trabalho está na parte que download nenhum entrega: capturar uma hora de áudio sem falhar, manter os participantes separados, traduzir ao vivo em 15 idiomas e transformar tudo isso em notas que ainda dá para buscar meses depois.
Começar uma nota de IA ao vivo
Fontes
- Cartão do modelo Qwen3.8-27B e tabelas de benchmarks, Hugging Face — números do confronto direto com o Opus 4.6 Max, consultado em 21 de agosto de 2026
- Artificial Analysis: análise de inteligência, desempenho e preço do Qwen3.8 27B — índice de inteligência 52,0, preço e verbosidade, consultado em 21 de agosto de 2026
- Artificial Analysis: página do modelo Claude Opus 4.6 — índice de inteligência 44,9 no esforço máximo de raciocínio, consultado em 21 de agosto de 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 de março de 2025 — escada de preços com limiar fixo e faixa de 9 a 900 vezes ao ano
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 de julho de 2023 — tabela 4, Llama 2 70B contra GPT-4
- Lista de arquivos de TheBloke/Llama-2-70B-Chat-GGUF — build Q4_K_M de 41,4 GB, publicada em 4 de setembro de 2023
- Lista de arquivos de unsloth/Qwen3.8-27B-GGUF — builds de 16,5 GB e 9,8 GB, downloads consultados em 21 de agosto de 2026
- Catálogo de modelos da OpenRouter — preços por token de Qwen3.8-27B, Claude Opus 4.6 e Claude Opus 5, consultado em 21 de agosto de 2026
- Discussão no Hacker News sobre o lançamento do Qwen3.8-27B, 14 de agosto de 2026 — relatos de throughput em placas de 16 e 24 GB
- Administração de Informação Energética dos EUA, Electric Power Monthly, tabela 5.3 — 18,44 centavos por quilowatt-hora na média residencial, maio de 2026
- Nossa cobertura anterior do lançamento dos pesos abertos do Qwen3.8 e da onda mais ampla de pesos abertos
- Página da Wikimedia Commons da fotografia do Cray Y-MP
