Qwen3.8-27B open weights: tamanhos, Q4_K_M e velocidades reais na 4090 e no Mac
O Qwen3.8-27B sai sob licença Apache 2.0. O GGUF Q4_K_M tem 17,1 GB e cabe num notebook de 32 GB; o FP8 tem 30,9 GB. Medido: 48 tokens/s numa RTX 4090 e 12,75 num Mac mini M4 Pro.
Em 3 de agosto, a conta Qwen da Alibaba disse que os pesos abertos sairiam «na semana que vem». É exatamente o tipo de frase que o setor de IA ensinou todo mundo a ouvir com desconto. Doze dias depois, não sobrou nada para descontar: os pesos do Qwen3.8-Max, de 2,4 trilhões de parâmetros, apareceram no Hugging Face em 12 de agosto, e o pequeno — Qwen3.8-27B, sob uma licença Apache 2.0 sem firulas — veio em 14.
Aí aconteceu a parte interessante. Dentro da mesma hora em que a Qwen terminou de publicar o cartão do 27B, três grupos diferentes da comunidade já o haviam convertido para formatos que rodam num computador pessoal. Dois dias depois, essas conversões passavam de um milhão de downloads.
Esse número é a notícia, não a tabela de benchmarks. Um modelo de 27 bilhões de parâmetros de um dos principais laboratórios de IA do mundo foi de «anunciado» a «rodando em cerca de um milhão de mesas» em aproximadamente 48 horas. Este texto explica em linguagem simples o que isso significa na prática: o que saiu e sob qual licença, o que é preciso para rodar o 27B no hardware que você já tem, quanto se avançou em três anos e a parte que quase ninguém conta — o que um 27B local ainda não consegue fazer.
Resumo:
- A promessa foi cumprida. O Qwen3.8-Max (2,4 tri no total / 95 bi ativos) chegou em 12 de agosto; o Qwen3.8-27B, em 14. Ambos são downloads de verdade, não prévias hospedadas.
- As licenças são diferentes, e essa diferença pesa mais do que as notas. O 27B é Apache 2.0: sem limiares, sem cláusulas, uso comercial livre e sem dever nada. O Qwen3.8-Max sai com licença própria, com gatilho de receita para negócios de modelo como serviço.
- O tamanho decide quem roda o quê: o Max são 4.892 GB de download; o 27B comprimido para 4 bits ocupa 17,1 GB e cabe numa máquina de 32 GB. As versões comunitárias em 4 bits passaram de 1,07 milhão de downloads em dois dias.
Imagem: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Rodar por conta própria o modelo de um laboratório de ponta significa que a máquina — e a manutenção dela — passa a ser sua.
A promessa veio com data, e a data se cumpriu
Em 4 de agosto cobrimos o anúncio e escrevemos que a espera se media em «semana que vem», não em «algum dia». Era o limite do que as evidências permitiam na época. A coisa se resolveu de forma limpa.
O Qwen3.8-2.4T-A95B — vendido como Qwen3.8-Max — apareceu com seu arquivo de licença em 12 de agosto. O Qwen3.8-27B e uma variante FP8 otimizada chegaram em 14. Ambas as datas caem dentro da janela que «semana que vem» apontava. Num setor em que modelos anunciados frequentemente nunca saem, um laboratório cumprir um prazo verbal de nove dias atrás já merece registro.
A recepção foi imediata e grande. A thread do Hacker News sobre o 27B juntou 1.351 pontos e 769 comentários em um dia. Em questão de horas, profissionais publicavam configurações de deploy funcionais para hardware específico; alguém compartilhou os ajustes tanto para um NVIDIA DGX Spark quanto para uma placa de vídeo de consumo RTX 4090. Não era assim que o setor tratava lançamentos abertos dois anos atrás, quando fazer uma arquitetura nova rodar já era um projeto de fim de semana.
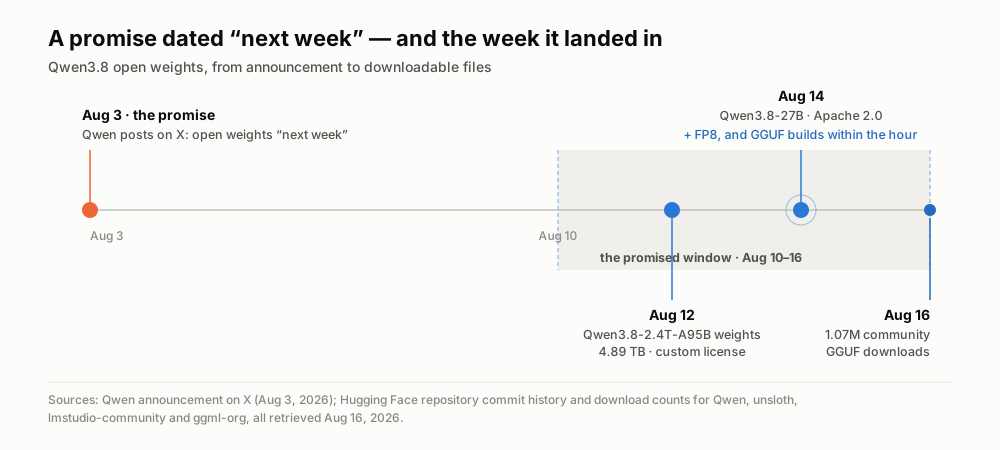
Uma promessa com data e as duas entregas que caíram dentro dela. Datas do histórico de commits dos repositórios do Hugging Face, consultado em 16 de agosto de 2026.
Cinco termos, focados na pergunta «consigo rodar isso?»
Se você chegou pelos nossos textos anteriores, já sabe o que são pesos abertos: o laboratório publica a enorme grade de números aprendidos que forma o modelo pronto, e você pode baixá-la, rodar no seu hardware e construir em cima sem pagar por requisição. Aqui interessa a pergunta seguinte, inteiramente prática: quanto custa rodar, em hardware?
Parâmetros são esses números aprendidos, e a quantidade deles define o tamanho bruto do modelo. A regra de bolso é brutalmente simples: na precisão em que os laboratórios treinam, cada bilhão de parâmetros ocupa cerca de 2 GB em disco, e você precisa de aproximadamente essa memória para segurar o modelo enquanto ele roda. Então um modelo de 27 bilhões de parâmetros é um download de 55 GB. Um de 2,4 trilhões beira os 5 TB. É por isso que um é assunto de notebook e o outro, de data center.
Quantização é o que fecha essa distância, e é a ideia mais útil para quem quer rodar modelos em casa. Os parâmetros normalmente são guardados com 16 bits de precisão. A quantização os arredonda para menos bits — 8, 4, às vezes 2 — e o arquivo encolhe mais ou menos na mesma proporção. A quantização de 4 bits transforma aqueles 55 GB em cerca de 17 GB. Você perde um pouco de precisão e ganha a capacidade de rodar a coisa. GGUF é simplesmente o formato de arquivo em que essas versões comprimidas circulam; é o que ferramentas como llama.cpp, Ollama e LM Studio leem. Quando vir «Q4_K_M», leia como «a versão de 4 bits que a maioria usa».
Denso versus mistura de especialistas decide a velocidade depois que o modelo cabe. O Qwen3.8-27B é denso: todos os 27 bilhões de parâmetros disparam a cada palavra produzida. O Qwen3.8-Max é de mistura de especialistas — 2,4 trilhões de parâmetros no total, mas um roteador seleciona apenas cerca de 95 bilhões por token, distribuídos por 512 sub-redes especializadas. O total informa a conta de armazenamento; o número ativo informa a conta de processamento. Essa distinção tem uma ponta prática bem afiada, e voltaremos a ela.
Janela de contexto é quanto o modelo consegue considerar de uma vez. O 27B trabalha nativamente com 262.144 tokens — uma pilha de transcrições de reuniões de uma hora — e pode ser esticado até um milhão com uma mudança de configuração.
A licença é a primeira coisa a ler
Aqui está o achado que sustenta o resto, e ele contraria a suposição de que uma família de modelos compartilhe uma família de termos.
O Qwen3.8-27B é Apache 2.0. É a ponta permissiva do espectro: use, modifique, ajuste, coloque num produto comercial, monte um negócio em cima, sem dever nada e sem pedir a ninguém. Sem limiares de receita, sem obrigação de exibir o nome na interface, sem exclusões de uso.
O Qwen3.8-Max não. Ele sai sob uma «Qwen3.8-Max License» própria, que começa parecida com a MIT e então anexa duas condições. Se o seu produto passar de 100 milhões de usuários ativos mensais ou de 20 milhões de dólares de receita mensal, você precisa exibir o nome do modelo na interface. E se você opera um negócio de modelo como serviço ou de assistente de trabalho com IA cuja receita ultrapasse 50 milhões de dólares em doze meses consecutivos, precisa de um acordo separado com a Qwen antes de qualquer uso comercial.
Para um desenvolvedor solo ou uma empresa usando internamente, nada disso morde. Mas é o mesmo asterisco que apontamos quando o Kimi K3 saiu com licença própria em vez de MIT, e a lição se repete: «pesos abertos» e «licença aberta» são duas perguntas distintas, e um laboratório pode respondê-las de formas diferentes para dois modelos lançados com dois dias de intervalo. Leia a licença antes de se apaixonar por uma nota.
| Modelo | Parâmetros totais | Ativos por token | Tamanho do download | Licença | Ambiente realista |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2,4 tri | 95 bi | 4.892 GB | Própria, gatilho de receita | Um cluster de aceleradores |
| Qwen3.8-Max, FP8 | 2,4 tri | 95 bi | 2.496 GB | Própria, gatilho de receita | Um cluster de aceleradores |
| Qwen3.8-27B | 27 bi, denso | 27 bi | 55,6 GB | Apache 2.0 | Estação de trabalho multi-GPU |
| Qwen3.8-27B, FP8 | 27 bi, denso | 27 bi | 30,9 GB | Apache 2.0 | Uma GPU de ponta |
| Qwen3.8-27B, Q4_K_M GGUF | 27 bi, denso | 27 bi | 17,1 GB | Apache 2.0 | Um notebook de 32 GB ou uma 4090 |
O que rodar o 27B realmente exige
A resposta honesta: menos do que você imagina, e mais do que as manchetes insinuam.
O degrau mais baixo é um único comando. O 27B está na biblioteca do Ollama; ollama run qwen3.8 baixa uma versão de 18 GB com janela de contexto de 256K e entrada de imagens, entre doze variantes, incluindo uma ajustada para chips Apple. O LM Studio, que dá uma janela de chat em vez de um terminal, colocou sua versão no ar poucos minutos depois do lançamento. Nenhum dos dois exige que você tenha entendido a seção anterior.
Depois a realidade se impõe na forma de tokens por segundo. As medições que profissionais publicaram na thread do lançamento caíram mais ou menos onde o hardware previa. Numa RTX 4090 rodando a versão de 4 bits, alguém mediu cerca de 48 tokens por segundo — confortavelmente mais rápido do que você lê. Num Mac mini M4 Pro com 64 GB de memória, outro obteve 12,75 tokens por segundo: dá para usar, mas você o vê digitando. E num notebook com AMD 7840U e 64 GB de DDR5 comum, a mesma versão de 4 bits rendeu cerca de 4 tokens por segundo — tecnicamente roda, na prática é um processo em lote que você dispara e deixa quieto.
Esse último número é justamente onde a distinção denso/especialistas mostra o seu valor. A mesma pessoa mediu, no mesmo notebook, um modelo de mistura de especialistas mais antigo e nominalmente maior a cerca de 20 tokens por segundo — cinco vezes mais rápido que o modelo denso menor, porque só uma fração dos parâmetros dispara a cada palavra. Se você procura algo para rodar em CPU, o número pelo qual comparar são os parâmetros ativos, não os totais. É a lição menos intuitiva e mais útil da IA local.
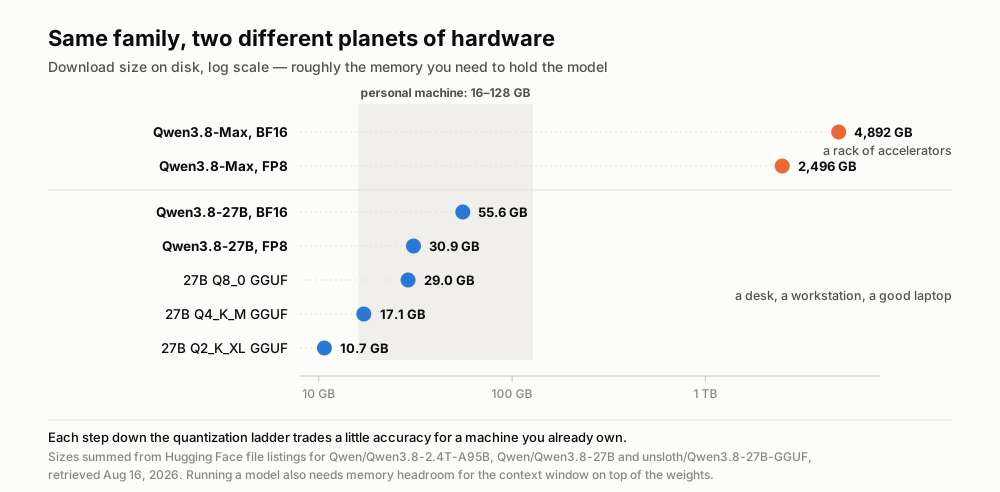
Dois membros da mesma família de modelos, separados por um fator de 290 no tamanho do download. Tamanhos somados a partir das listas de arquivos do Hugging Face, consultadas em 16 de agosto de 2026.
Três anos atrás isso exigia um vazamento e um fim de semana
Para ver o tamanho do salto, coloque-o ao lado do ponto de partida dos modelos locais.
Em fevereiro de 2023, a Meta liberou os pesos do LLaMA original apenas para pesquisadores aprovados. Eles vazaram em cerca de uma semana, e toda a cena amadora de modelos locais foi construída sobre um arquivo que ninguém deveria ter. Em 10 de março de 2023, um desenvolvedor publicou o llama.cpp, um pequeno programa em C++ cujo truque era rodar o modelo de 7 bilhões de parâmetros num MacBook. Esse repositório tem hoje 124 mil estrelas e é o ancestral de praticamente toda ferramenta de «rodar localmente» em uso atualmente.
Compare os dois dias de lançamento. Em 2023: um 7B vazado, sem licença digna do nome, uma semana de esforço da comunidade para fazê-lo rodar e um modelo mais interessante do que útil. Em 2026: um 27B de um laboratório de ponta, publicado deliberadamente sob Apache 2.0, com entrada de imagem e vídeo, janela de contexto de 262K, e versões da comunidade prontas antes que a documentação do próprio laboratório parasse de mudar. O primeiro commit da conversão da unsloth foi às 14h56 UTC de 14 de agosto — quatro minutos antes da última atualização do cartão pela Qwen.
Os números de adoção dizem o mesmo de forma mais seca. Em 16 de agosto, as versões comunitárias de 4 bits do 27B somavam 867.963 downloads num publicador, 171.518 num segundo e 34.520 num terceiro: 1,07 milhão em dois dias. Os repositórios oficiais da Qwen para o 27B acrescentam outros 215 mil. O Qwen3.8-Max, modelo muito mais capaz, está em 17.126 somando seus dois repositórios.
Releia essa proporção. O modelo de escala de fronteira recebeu cerca de 1,6% da atenção que foi para o de escala de notebook. O que o mercado foi buscar não foi capacidade. Foi alcance.
O que um 27B local ainda não consegue fazer
Agora a correção, porque o entusiasmo ultrapassa as evidências de maneiras previsíveis.
A própria tabela da Alibaba coloca o 27B à frente do Opus 4.6 Max em várias medidas de programação agêntica e aderência a instruções — 61,7 contra 53,4 no SWE-bench Pro, 79,5 contra 62,5 no IFBench — e atrás em outras, incluindo 30,8 contra 40,0 no HLE, que mede conhecimento amplo. Todos esses números são reportados pelo próprio fabricante. Enquanto escrevemos, a Artificial Analysis, o avaliador independente em que nos apoiamos, não tem sequer uma entrada para o 27B; ela classifica o Qwen3.8-Max em 10º entre 188 modelos com nota de inteligência 58, o que é excelente e é outro modelo.
Os profissionais foram mais afiados que a planilha. A objeção mais votada da thread, de alguém que se descreveu como usuário antigo de modelos abertos, foi direta: estes não superam os melhores modelos hospedados no uso real; são «bons o bastante» para muitas tarefas e rodam em hardware acessível — uma afirmação diferente e mais modesta. Outro comentário colocou o teto em termos físicos: não dá para comprimir todo o conhecimento humano num arquivo de 30 GB, então modelos pequenos continuam comparativamente fracos para lembrar fatos obscuros, por mais afiados que fiquem em código ou uso de ferramentas.
Há mais dois limites que só aparecem quando você roda. A quantização não é de graça: um modelo muito comprimido tende a perder o fio em contextos longos e pode cair em laços de repetição — por isso quem tem memória sobrando é aconselhado a usar a versão em precisão total. E esta geração do Qwen pensa muito por padrão: um usuário deu ao 27B, num Mac mini de 64 GB, as duas palavras «svg owl» e o viu gerar 21.769 tokens de raciocínio ao longo de 17 minutos e 12 segundos antes de responder. A coruja ficou boa. Também saiu uma conta em tempo de relógio que nenhuma API hospedada teria cobrado.
E há o item que ninguém contabiliza: a operação agora é sua. Atualizações de modelo, escolha de quantização, folga de memória, versões de driver, a ventoinha da máquina. Aquela API hospedada que você estava evitando também era um time de gente mantendo algo de pé.
Conclusão: o fosso desceu na pilha
Aqui está o ponto, e ele é maior do que um lançamento.
Um laboratório de ponta publicou um 27B competente numa quinta-feira. No sábado, mais de um milhão de cópias de versões comprimidas pela comunidade estavam nas máquinas das pessoas, ele estava a um comando de distância no Ollama e era legalmente livre construir um negócio em cima. Qualquer que seja a vantagem que esse modelo representa, ela levou cerca de dois dias para ficar disponível a todos os concorrentes ao mesmo tempo. Chamemos isso de fosso de dois dias: uma vantagem de modelo cuja meia-vida agora gira em torno de 48 horas.
Isso não é previsão. É uma medição, feita esta semana, neste lançamento.
E ela redefine o que significa construir um produto de IA. Quando a camada do modelo é uma commodity que qualquer um troca numa tarde, o modelo deixa de ser aquilo em que você compete. O que sobrevive é tudo que o envolve: confiabilidade quando o servidor de inferência cai às três da manhã, pipelines de dados que capturam, limpam e recuperam o contexto certo, avaliação que diz se funciona nos seus dados e não nos de um benchmark, uma interface que alguém realmente vai usar, e os arranjos de confiança — privacidade, retenção, quem pode ver o quê — que decidem se alguém vai entregar suas gravações de reunião a você.
Nada disso vira commodity em dois dias. Nada disso tem botão de download.
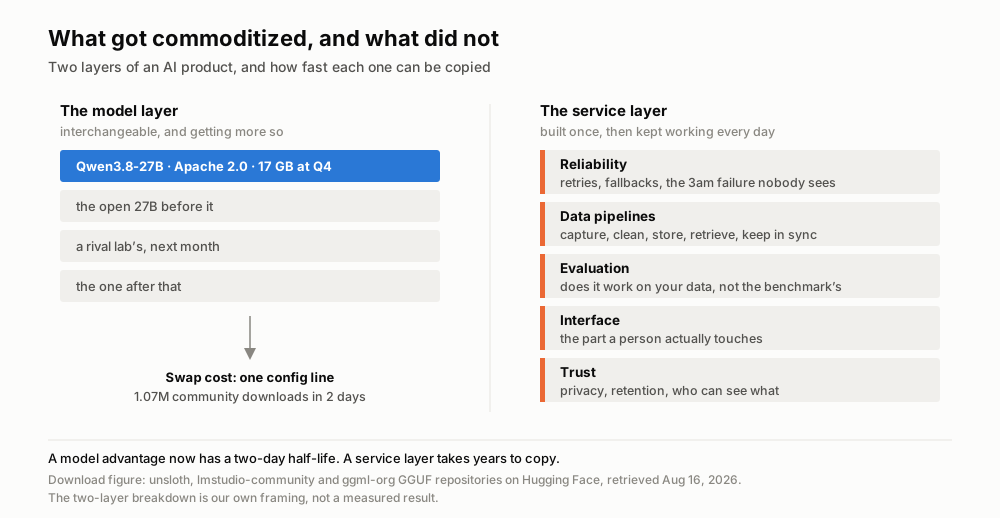
A camada que ficou barata esta semana e a que não ficou. Números de download do Hugging Face, consultados em 16 de agosto de 2026; a divisão em duas camadas é nossa.
Então a reação correta a um ótimo modelo aberto chegando aos notebooks não é «as empresas de modelo venceram» nem «as empresas de produto perderam». É que o trabalho interessante desceu um andar na pilha, para onde é muito mais difícil de copiar e muito menos divertido de virar manchete.
Onde a Telli.sh entra: construímos exatamente essa camada de serviço, sobre modelos abertos. A Telli.sh já usa um modelo Qwen aberto no caminho de resumo, o que significa que cada salto de qualidade dos modelos abertos — incluindo este — chega direto à transcrição, à tradução e aos resumos de reunião, sem mudança de preço do seu lado. Nosso tempo vai para a parte que não chega dentro de um arquivo GGUF: capturar áudio de forma confiável, não confundir quem falou, transformar uma gravação de 60 minutos em notas que você encontra meses depois e ser claro sobre onde seus dados ficam.
Começar uma nota com IA ao vivo
Fontes
- Cartão do modelo e licença do Qwen3.8-27B, Hugging Face
- Cartão do modelo e licença do Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: versões quantizadas e contagem de downloads
- Qwen3.8 na biblioteca de modelos do Ollama
- Discussão no Hacker News sobre o lançamento do Qwen3.8-27B (14 de agosto de 2026)
- Página do modelo Qwen3.8 Max na Artificial Analysis
- Anúncio dos pesos abertos da Qwen (@Alibaba_Qwen) no X (3 de agosto de 2026)
- Repositório llama.cpp, criado em 10 de março de 2023
- Página da imagem no Wikimedia Commons
