A corrida chinesa de pesos abertos em três semanas: Kimi K3, Qwen3.8-Max e a reviravolta que pode encerrar tudo
Em três semanas, os maiores laboratórios de IA da China lançaram ou anteciparam modelos de pesos abertos de fronteira — Kimi K3, Qwen3.8-Max e o DeepSeek V4 em disponibilidade geral. Um guia em linguagem simples: o que é cada modelo, o que de fato saiu e o que ainda é promessa, e por que Pequim pode agora restringir a onda que ele mesmo provocou.
Entre 16 e 26 de julho, três dos maiores laboratórios de IA da China colocaram na mesa modelos abertos de nível de fronteira. A Moonshot AI anunciou o Kimi K3 em 16 de julho e publicou os pesos em 26 de julho. A Alibaba apresentou o Qwen3.8-Max em 19 de julho, na WAIC de Xangai. A linha V4 da DeepSeek chegou à disponibilidade geral (GA) por volta de 20 de julho. Três laboratórios, cerca de três semanas.
O padrão é difícil de não notar, e não é aquele com que a cena chinesa de modelos abertos construiu sua reputação. Esses laboratórios eram conhecidos por modelos pequenos, rápidos e baratos, que batiam acima da própria categoria. Esta onda é a aposta contrária: sistemas com trilhões de parâmetros lançados, ou prometidos, como pesos abertos.
Esta é uma leitura honesta dessa onda: o que de fato saiu, o que ainda é prévia ou promessa, e a reviravolta que veio junto — o mesmo governo que tornou esses lançamentos possíveis avalia agora se deve restringi-los. Vamos manter o jargão no mínimo e explicar o resto no caminho, para você acompanhar a história mesmo que «pesos abertos» e «mixture-of-experts» sejam novidade. Se você leu nosso apanhado de julho, esta é a continuação, e uma de suas pontas soltas se resolveu.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Primeiro, as cinco ideias que fazem tudo se encaixar
Se você é novo neste canto da IA, cinco termos carregam a maior parte da história, e vale um minuto em linguagem simples antes de chegarmos aos modelos.
«Pesos abertos» (open weights) é toda a razão pela qual esta onda importa. Os pesos de um modelo são a enorme grade de números que ele aprendeu durante o treino — na prática, o cérebro pronto. Quando um laboratório libera os pesos, você pode baixar esse arquivo, rodar o modelo no seu próprio hardware, ajustá-lo e construir produtos sobre ele sem pedir permissão a ninguém nem pagar por requisição. A alternativa é um modelo fechado, como a maioria dos chatbots comerciais, em que os pesos ficam trancados nos servidores do fornecedor e você aluga o acesso por uma API paga. Pesos abertos transformam um modelo de um serviço que você aluga em algo do qual você tem uma cópia, e é essa diferença que faz uma indústria inteira prestar atenção quando um bom modelo aparece.
«Parâmetros» são esses números aprendidos, e a quantidade deles é o indicador aproximado de quanto um modelo consegue conter. Um modelo de «2,8 trilhões de parâmetros» tem 2,8 trilhões deles. Maior não é automaticamente melhor, mas na fronteira costuma significar mais espaço para raciocinar — e, tão importante quanto, mais hardware para rodar. É aí que entra o «mixture-of-experts» (MoE). Em vez de acionar todos os parâmetros para cada palavra, um modelo MoE é dividido em muitas sub-redes especializadas chamadas especialistas, e um roteador escolhe apenas um punhado para cada token. Então, quando você vê «2,8 trilhões no total, 104 bilhões ativos», significa que o modelo é enorme, mas só cerca de 104 bilhões de parâmetros trabalham a cada instante — como um hospital com milhares de especialistas em que cada paciente é visto só pelos poucos pertinentes. O total insinua o quão capaz ele pode ser; o número ativo diz o quanto custa servi-lo. Essa diferença é o número mais útil para julgar o custo.
Uma «janela de contexto» é quanto texto o modelo consegue manter em mente de uma vez, contado em tokens — e um token equivale a cerca de três quartos de uma palavra. Uma janela de um milhão de tokens não é uma especificação abstrata: são vários romances longos, ou dezenas de transcrições de reuniões de uma hora, em uma única passada. É a diferença entre resumir um único e-mail e raciocinar sobre um trimestre inteiro deles.
Por fim, a licença — e esta é a parte que profissionais deveriam ler primeiro, antes dos benchmarks. A licença é a letra miúda jurídica que diz o que você pode fazer com os pesos. MIT é o padrão-ouro: use, modifique, coloque num produto comercial, não deve nada. Uma licença própria pode parecer aberta e ao mesmo tempo recortar justamente o uso que você tinha em mente — por exemplo, cobrando de você assim que o negócio que você montou sobre ela crescer. Dois modelos podem ambos ser «pesos abertos» e estar a mundos de distância no que você pode legalmente fazer. Por isso compensa ler esta linha antes de se apaixonar por uma pontuação. Com essas cinco ideias em mãos, a onda se lê com clareza.
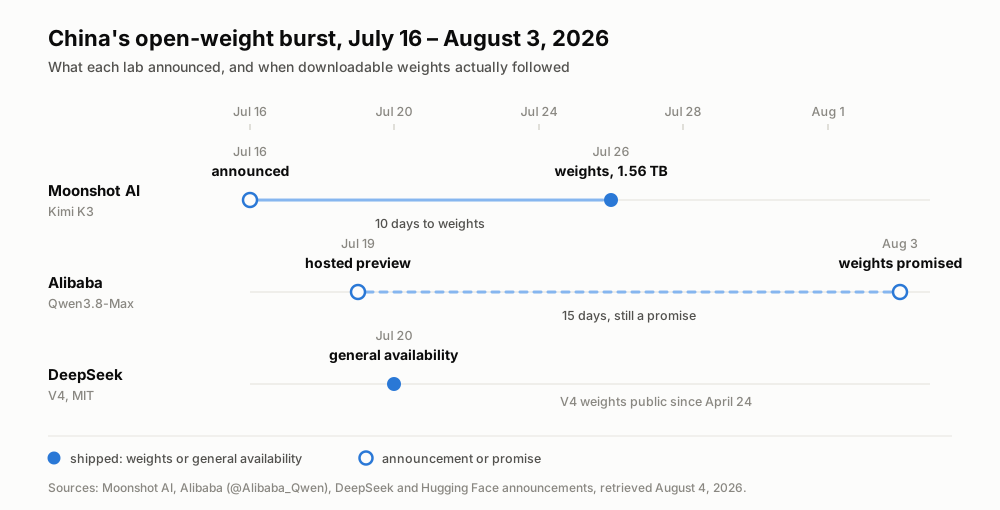
Três laboratórios, três semanas — e destes cinco momentos apenas dois colocaram pesos nas mãos de alguém. Datas dos anúncios de cada laboratório, consultadas em 4 de agosto de 2026.
O Kimi K3 é o que realmente saiu
Comece pela Moonshot AI, o laboratório de Pequim por trás do assistente Kimi, que passou o último ano construindo reputação com modelos abertos grandes e capazes. Quando escrevemos sobre o Kimi K3 em julho, os pesos eram apenas uma promessa — a Moonshot havia dito «até 27 de julho». Eles chegaram em 26 de julho: 1,56 terabyte em 96 fragmentos no Hugging Face, sob moonshotai/Kimi-K3. Essa é a notícia. Um anúncio é um comunicado à imprensa; pesos que dá para baixar são um fato sobre o qual se pode construir.
Em termos simples, o K3 é um dos maiores modelos abertos já publicados — um sistema mixture-of-experts com 2,8 trilhões de parâmetros no total e cerca de 104 bilhões ativos por token, roteando aproximadamente 16 de 896 especialistas por um mecanismo que a Moonshot chama de Kimi Delta Attention, com uma janela de contexto de um milhão de tokens e um ganho de eficiência de escala relatado de cerca de 2,5x em relação ao antecessor, o K2. Traduzindo da ficha técnica: ele é muito grande, relativamente econômico de rodar para o seu tamanho porque só uma fatia é acionada por token, e capaz de engolir de uma vez entradas do tamanho de um livro.
Esses números também dizem quem de fato vai rodá-lo. 1,56 terabyte em 96 fragmentos não é um download de notebook; é um artefato de classe data center que precisa de um cluster de aceleradores de ponta só para carregar. Na prática, quase nenhum indivíduo vai hospedar o K3 por conta própria — vai alcançá-lo por provedores que já têm o hardware, e esse mercado chegou no primeiro dia: Together AI e Modal subiram endpoints hospedados do Kimi K3 no instante em que os pesos caíram. É assim, também, que um leitor curioso o experimenta hoje — não baixando 1,56 TB, mas chamando um desses endpoints hospedados ou usando o app do Kimi. «Aberto» aqui significa que os pesos são públicos e qualquer um com o hardware pode servi-los, que é justamente o que mantém a concorrência de preços; não significa que você vai rodá-lo pessoalmente na sua mesa.
Ele é bom? Pelo único número independente em que confiamos nesta rodada, sim. No ranking da Artificial Analysis, ficou em 4º entre 189 modelos — atrás do Claude Fable 5 e de duas configurações GPT-5.6 «Sol», à frente do Opus 4.8 e do GPT-5.5. Para um modelo aberto que você pode baixar, estar nessa companhia já é a história.
Depois leia a licença, porque é aqui que «aberto» ganha um asterisco. O Kimi K3 não é MIT. Ele sai sob uma licença própria, a «Kimi K3 License», não aprovada pela OSI e com uma cláusula de limite de receita: rodar o K3 como motor de um grande negócio de Model-as-a-Service exige um acordo separado com a Moonshot. Para um desenvolvedor solo, ou uma empresa comum que o usa internamente, isso não muda nada. Mas para quem constrói um produto hospedado em larga escala, «pesos abertos» e «licença aberta» são duas perguntas diferentes — e aqui só a primeira é um sim inequívoco.
O Qwen3.8-Max é uma prévia, não um download
Qwen é a família de modelos da Alibaba, e sua equipe está entre as que mais publicam modelos abertos no mundo — é justamente esse histórico que torna o mais recente confuso. Apresentado em 19 de julho na WAIC de Xangai, o Qwen3.8-Max é a maior manchete da onda, e também a mais mole. É um MoE esparso de 2,4 trilhões de parâmetros — parâmetros ativos não divulgados — e o primeiro Qwen acima de um trilhão de parâmetros a ser multimodal, ou seja, a receber como entrada não só texto, mas imagens, vídeo e documentos.
Aqui está a pegadinha que um iniciante precisa que soletrem: apesar do estardalhaço, você não pode baixá-lo. Neste momento ele existe só como «prévia hospedada» — qwen3.8-max-preview, acessível pelo próprio serviço da Alibaba (o Token Plan e a ferramenta Qoder) a cerca de 10% do preço padrão. Uma prévia hospedada significa que a Alibaba roda o modelo nos servidores dela e deixa você chamá-lo; é o modelo de API alugada, não o de ter uma cópia. Chamá-lo hoje de lançamento de pesos abertos é prematuro.
Esse quadro mudou em 3 de agosto. A conta oficial da Qwen no X, @Alibaba_Qwen, publicou que os pesos abertos do Qwen3.8-Max chegariam «na semana que vem» — e que um Qwen3.8-27B menor também passaria a pesos abertos. Então o 27B não é boato, seja lá o que a conversa anterior sugeria: é um compromisso registrado, pela própria conta da Alibaba. E o tamanho é o ponto. Enquanto o Max de 2,4 trilhões de parâmetros, como o K3, é algo que só um data center roda, um 27B é pequeno o bastante para ser servido em uma única máquina de ponta — o patamar que um indivíduo ou um time pequeno consegue de fato auto-hospedar. Isso de fato suaviza a imagem do «prometido sem especificações»: agora há um tamanho e um prazo aproximado.
Ainda assim, as ressalvas honestas continuam de pé. «Na semana que vem» é uma direção, não uma data de entrega, e no momento em que escrevemos, 4 de agosto, nada apareceu na organização Qwen no Hugging Face — seus modelos mais recentes lá são de junho. A licença de pesos abertos também não foi publicada, e os primeiros leitores dos termos da prévia apontaram possíveis restrições regionais, não confirmadas até a licença real aparecer — exatamente a lição do «licença primeiro» do bê-á-bá. A afirmação da Alibaba de que o modelo é «superado apenas pelo Fable 5» segue sendo um dado da própria empresa sem números de terceiros, então trate-a como o slogan de marketing de um fornecedor até que alguém fora da Alibaba o meça. Se você quer experimentar o modelo hoje, a prévia hospedada é a única porta — mas, pela primeira vez, a espera por pesos baixáveis se mede em «na semana que vem», não em «algum dia».
O DeepSeek V4 chegou à disponibilidade geral em silêncio
A DeepSeek é o laboratório cujo modelo R1 ajudou a dar a largada da atual corrida de modelos abertos no início de 2025 e, fiel ao seu estilo, aqui foi a que menos anunciou enquanto entregava o mais utilizável. Sua linha V4, lançada lá em 24 de abril, é a que se pode adotar de forma mais direta, porque vem sob a licença que o bê-á-bá apontou como padrão-ouro.
O V4 vem em dois tamanhos, ambos com licença MIT. O V4-Pro é o carro-chefe, com 1,6 trilhão no total e 49 bilhões de parâmetros ativos; o V4-Flash é o leve, com 284 bilhões no total e 13 bilhões ativos. Lembre o que o número ativo significa: o V4-Flash aciona apenas 13 bilhões de parâmetros por token, o que o torna barato e rápido de servir, e é isso que faz dele a escolha econômica para trabalho de alto volume — aquele tipo de carga de transcrever e resumir em que o custo por token decide tudo. Ambos trazem uma janela de contexto de um milhão de tokens e podem produzir até 384K tokens de saída em uma única resposta, o bastante para rascunhar um relatório longo, não só um parágrafo. Por volta de 20 de julho, o V4 chegou à disponibilidade geral com preço por tempo, o que trouxe um lançamento de primavera para o mesmo recorte de três semanas de K3 e Qwen.
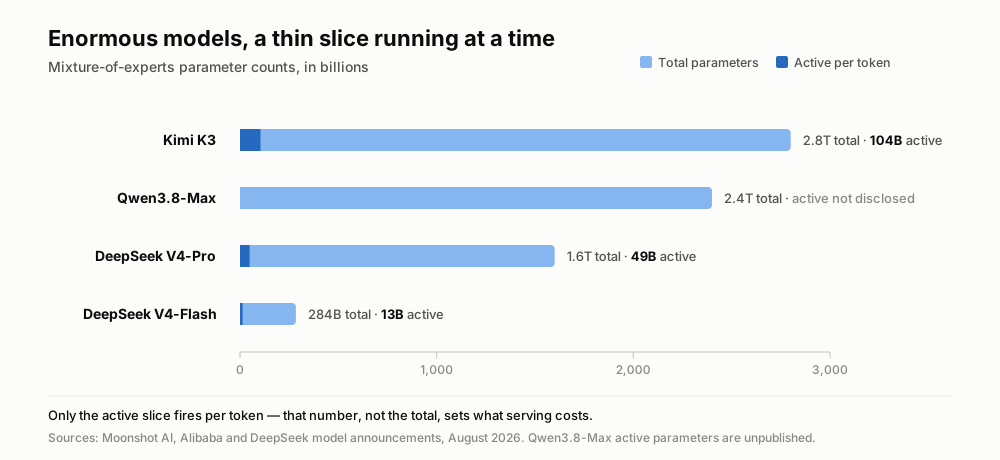
A barra clara é o tamanho do modelo; o trecho escuro é o que realmente liga a cada token. A Alibaba não divulgou os parâmetros ativos do Qwen3.8-Max.
Por ser MIT, o V4 é aquele em que um adotante pode construir com o menor número de advogados: pegue os pesos (ou use um provedor hospedado), rode, lance comercialmente, não deve nada e não pede permissão a ninguém. E, para ser claro sobre os números de versão, já que a rumorologia os adora — não há R2, nem V5, nem V4.1. Há apenas a família V4 amadurecendo em algo de que as equipes podem depender.
A distância diminui mais rápido do que os rankings admitem
Dando um passo atrás, a inclinação importa mais do que os lançamentos individuais. A leitura de Nathan Lambert é que a distância entre os melhores modelos abertos e os melhores fechados encolheu de cerca de seis a nove meses para três a cinco — «o mais perto que os modelos abertos já estiveram da fronteira desde o DeepSeek R1». Dito de forma simples: os modelos de livre download estão agora só alguns meses atrás dos melhores modelos que dá para alugar, onde um ano atrás iam uma volta confortável atrás.
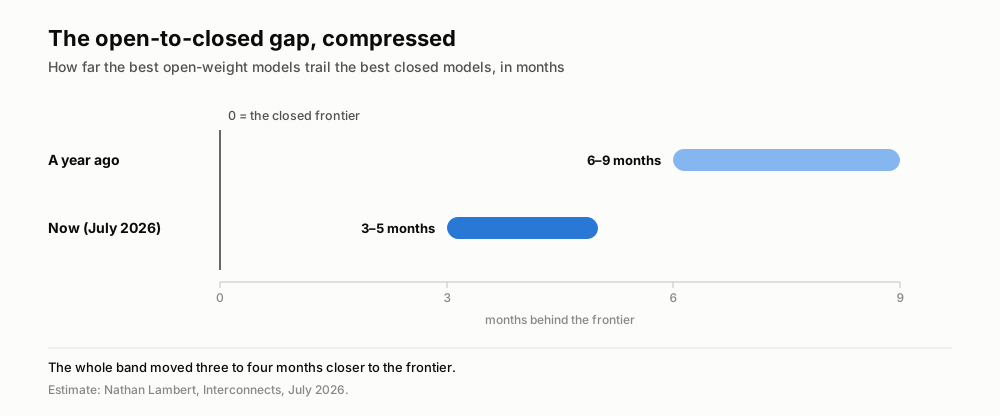
A estimativa de Lambert desenhada em escala: o campo aberto não só chegou mais perto, a faixa inteira se estreitou.
Os dados de uso apontam na mesma direção. No OpenRouter, um mercado que distribui as requisições entre muitos modelos, a fatia de tokens dos modelos de origem norte-americana caiu de cerca de 70% em junho de 2025 para cerca de 30% um ano depois, enquanto os modelos de origem chinesa já passam regularmente de 30%. O preço explica boa parte: modelos abertos chineses costumam custar de 60% a 90% menos por token, e a hospedagem apareceu na hora, como deixaram claro aqueles endpoints do K3 no dia zero.
A mudança mais silenciosa é sobre escala. A marca do modelo aberto chinês era pequeno, rápido e barato. O K3 com 2,8 trilhões de parâmetros e o Qwen3.8-Max com 2,4 trilhões são exatamente o oposto — uma aposta de que ir grande no aberto agora vale a pena. O GLM-5.2 da Z.ai, lançado em 16 de junho sob MIT e no topo da categoria de pesos abertos do Artificial Analysis Index com 51, é a mesma mensagem vinda de um quarto laboratório.
A reviravolta: o governo que tornou isso possível pode restringir
Então o vento mudou. Por volta de 22 a 25 de julho, o Financial Times e a Reuters relataram que o Ministério do Comércio da China avalia controles de exportação sobre modelos de IA — incluindo LLMs de pesos abertos —, com Alibaba, ByteDance e Z.ai supostamente na conversa. O arcabouço em discussão é escalonado: uma obrigação de registro para os modelos mais fracos, uma revisão de segurança para os mais fortes e uma possível proibição de publicar abertamente os mais capazes. Nada ainda é lei. Mas a direção é marcante: a onda talvez esteja atingindo o pico exatamente quando seu próprio governo começa a tratar esses modelos como exportações estratégicas, e não como contribuições abertas.
Em resumo: quando o aberto vira um ativo estratégico
A narrativa cômoda diz «a China alcançou». A mais precisa diz que os pesos abertos viraram um ativo estratégico rápido o bastante para que um governo agora queira a mão na torneira. Em três semanas, os modelos abertos passaram de dois ou três trimestres atrás da fronteira para apenas um — e de pequenos e baratos para estar entre os maiores modelos já publicados, em qualquer forma. A fronteira aberta não só se moveu. Moveu-se para um lugar de onde seus criadores talvez não sejam livres para continuar entregando.
Para as equipes que constroem sobre esses modelos, a conclusão prática não muda e fica um pouco mais afiada. A Telli.sh já roda um modelo aberto, o Qwen3, em sua camada de resumo, de modo que cada avanço em qualidade e preço dos modelos abertos flui direto para transcrição, tradução e resumos de reuniões. O item novo é o suprimento: se as regras de exportação da China se firmarem como sugerem as reportagens, quais modelos abertos seguirão livremente baixáveis é algo a acompanhar, não a presumir. Que os modelos que alimentam essa camada melhorem é a tendência; de onde esses modelos têm permissão para vir é o ponto a não perder de vista.
Começar uma nota de IA ao vivo
Fontes
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
