Un fichier de 16,5 Go dépasse désormais le meilleur modèle fermé de février
Il y a trois ans, le meilleur modèle téléchargeable perdait de 37 points face à GPT-4 sur HumanEval et exigeait deux cartes graphiques. La semaine dernière, un modèle ouvert de 27 milliards de paramètres a obtenu 52,0 à l'indice d'intelligence d'Artificial Analysis, contre 44,9 pour Claude Opus 4.6 Max — à un neuvième du prix, depuis un fichier de 16,5 Go. Un avant-après avec les tableaux de benchmarks, la courbe des prix et ce que signifie un délai de rattrapage tombé à 162 jours.
Quelqu'un, sur Hacker News, fait tourner un modèle de langage de tout premier plan sur une carte graphique de 16 Go, à 50 ou 60 jetons par seconde, avec une fenêtre de contexte de 128 000 jetons. Le modèle s'appelle Qwen3.8-27B, publié le 14 août 2026. À l'indice d'intelligence d'Artificial Analysis, il obtient 52,0 — davantage que Claude Opus 4.6 Max, encore en février le meilleur modèle propriétaire du marché, qui plafonne à 44,9.
En 2023, cette phrase aurait relevé de la science-fiction, et pas de la version amusante.
Ce billet est l'avant-après. Pas la couverture de la sortie — nous l'avons déjà écrite — mais la comparaison sur trois ans : ce que le meilleur modèle téléchargeable obtenait face à la frontière hier et aujourd'hui, ce que coûtait un certain niveau d'intelligence hier et aujourd'hui, et quel matériel il fallait posséder pour l'exécuter soi-même. Chaque chiffre ci-dessous a une source et une date. La tendance qu'ils dessinent compte parmi les nouvelles les plus franchement optimistes du logiciel aujourd'hui.
En bref :
- L'écart s'est refermé, et l'on peut le dater. En juillet 2023, le meilleur modèle ouvert perdait 17,5 points sur MMLU et 37,1 points sur HumanEval face à GPT-4. En août 2026, un 27B ouvert bat le vaisseau amiral propriétaire de février sur 15 des 19 benchmarks que les deux publient, ainsi que sur un indice composite indépendant.
- Le prix a chuté d'environ 208 fois en 23 mois, mesuré par Epoch AI à seuil de performance constant. Le 27B ouvert coûte aujourd'hui 1,09 dollar par million de jetons en tarif mixte, contre 10,00 dollars pour Opus 4.6 Max — et zéro par jeton si vous l'exécutez vous-même.
- Ce n'est pas la frontière, et nous le disons. Claude Opus 5 Max obtient 63,1 et GPT-5.6 Sol Max 60,9. Sur le raisonnement de culture générale, le 27B perd largement face à Opus 4.6 : 30,8 contre 40,0 sur HLE.
Image : Steve Jurvetson, Wikimedia Commons, CC BY 2.0. L'interconnexion d'un Cray Y-MP, vers 1988. Le calcul sérieux était autrefois une pièce dans laquelle on entrait.
À quoi ressemblait vraiment l'« avant »
Remettons l'horloge au 18 juillet 2023, jour de publication de Llama 2 par Meta. C'était le meilleur modèle librement téléchargeable au monde, et son propre article imprimait le tableau des scores face à la frontière fermée sans détour.
Llama 2 70B obtenait 68,9 sur MMLU contre 86,4 pour GPT-4. Sur GSM8K, 56,8 contre 92,0. Sur HumanEval, le benchmark de code, 29,9 contre 67,0 — moins de la moitié. Le résumé de l'article lui-même : « Il subsiste un large écart de performance entre Llama 2 70B et GPT-4 ainsi que PaLM-2-L. » Voilà le vaisseau amiral des poids ouverts en 2023, dans ses propres mots.
Passons au matériel. La version communautaire 4 bits de TheBloke — la façon dont on exécutait réellement Llama 2 70B — pesait 41,4 Go et a été publiée le 4 septembre 2023. Pour une vitesse utilisable, il fallait deux cartes graphiques de 24 Go ou un Mac de 64 Go. Le modèle qui tenait vraiment sur un ordinateur portable ordinaire, c'était Llama 2 13B : un fichier de 7,9 Go, 54,8 sur MMLU, soit 31,6 points derrière GPT-4, et bon à pas grand-chose au-delà de la démonstration.
Le marché de 2023 se résumait donc à ceci : payer un laboratoire de frontière, ou exécuter quelque chose de visiblement moins bon sur du matériel que la plupart des gens ne possédaient pas. C'est exactement pourquoi l'argument « prends simplement l'API » a gagné si nettement pendant deux ans. Il était juste.
Posons la même question en août 2026
Alibaba a publié Qwen3.8-27B le 14 août 2026 sous licence Apache 2.0, en imprimant sur la fiche du modèle une comparaison directe avec Claude Opus 4.6 Max. Nous avons compté chaque ligne où les deux modèles annoncent un chiffre.
Qwen3.8-27B remporte 15 de ces 19 lignes et en perd 4. Parmi les victoires : SWE-bench Pro (61,7 contre 53,4), le suivi d'instructions sur IFBench (79,5 contre 62,5), la programmation compétitive sur LiveCodeBench v6 (90,3 contre 88,8), le pilotage d'ordinateur sur OSWorld-Verified (84,3 contre 72,7), les tâches d'agent mobile sur AndroidWorld (81,9 contre 62,0), puis une longue série de benchmarks multimodaux où les écarts n'ont rien de serré : 90,0 contre 65,5 sur MathVision, 83,7 contre 66,0 sur l'analyse de graphiques dans CharXiv, 65,5 contre 40,8 sur le raisonnement incarné d'ERQA.
Les quatre défaites comptent davantage que les victoires, car elles disent ce qu'un modèle de 27 milliards de paramètres ne sait toujours pas faire. Il perd sur Terminal Bench 2.1 (73,0 contre 78,2), sur la génération de code à l'échelle du dépôt dans NL2Repo-Bench (42,3 contre 47,6), de peu sur GPQA Diamond (89,2 contre 91,3), et nettement sur HLE, le benchmark de raisonnement pluridisciplinaire : 30,8 contre 40,0. Ce dernier chiffre donne la forme de toute la limite. On ne comprime pas la connaissance du monde dans un fichier de 16,5 Go ; on y comprime en revanche une quantité considérable de savoir-faire.
Une ligne mérite un astérisque : le 79,0 contre 63,8 provient de QwenSWEBench, un benchmark construit par Qwen. Les résultats d'un éditeur sur son propre benchmark constituent la preuve la plus faible de toute fiche de modèle, et nous ne comptons pas dessus.
Le tableau indépendant dit la même chose
Un tableau d'éditeur reste un tableau d'éditeur ; voici donc un tiers. Artificial Analysis, qui mène ses propres évaluations plutôt que de recopier celles des autres, a désormais mesuré le 27B. Au 21 août 2026, il lui attribue un indice d'intelligence de 52,0, soit le premier rang sur 135 modèles dans la catégorie des poids ouverts de 4 à 40 milliards de paramètres, contre 44,9 pour Claude Opus 4.6 Max. Sept virgule un points d'avance pour le modèle ouvert, mesurés par une partie sans intérêt dans l'affaire, 190 jours après la sortie d'Opus 4.6.
Remontez cette comparaison dans le temps et c'est là que se trouve l'histoire. En juillet 2023, le meilleur modèle ouvert sous 40 milliards de paramètres obtenait 2,6 sur le même indice. En juillet 2024, 7,4. En mars 2025, 13,4. En février 2026, 34,6. La semaine dernière, 52,0.
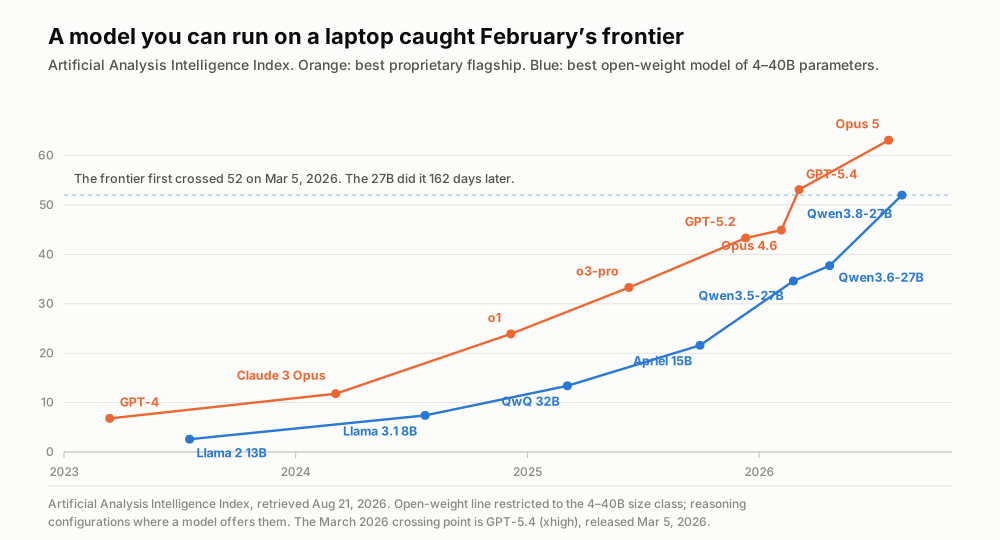
Les deux courbes montent ; la quantité intéressante est la distance horizontale entre elles. Indice d'intelligence d'Artificial Analysis, consulté le 21 août 2026.
Voici le chiffre qui mérite un nom. La frontière a franchi l'indice 52 pour la première fois le 5 mars 2026, quand GPT-5.4 a obtenu 53,1 à son effort de raisonnement maximal. Un modèle assez petit pour tourner sur une machine personnelle y est arrivé le 14 août — 162 jours plus tard. Appelons cela le délai de rattrapage : le temps entre l'apparition d'une capacité à la frontière et son apparition sur votre propre matériel.
Ce délai était bien plus long. Llama 3.1 8B a mis 260 jours pour atteindre un niveau que GPT-4 Turbo avait touché. GLM-4.7-Flash a mis 410 jours pour égaler o1. Les trois dernières sorties de format portable affichent 201, 155 et 162 jours. La frontière ne ralentit pas — Opus 5 Max se situe aujourd'hui à 63,1 — mais le peloton se rapproche environ deux fois plus vite qu'il y a deux ans.
Le prix n'a pas baissé, il s'est effondré
La capacité, c'est la moitié de l'avant-après. L'autre moitié, c'est la facture.
Epoch AI en a publié la mesure la plus propre en mars 2025, et la méthode mérite d'être comprise : on fixe un score de benchmark, puis on suit dans le temps le modèle le moins cher qui l'atteint. Fixez le seuil aux 86 points de GPT-4 sur MMLU et l'échelle donne 37,50 dollars par million de jetons en mars 2023, 15,00 en novembre 2023, 7,50 en mai 2024, 2,19 plus tard le même mois, et 0,18 en février 2025. Score identique. 208 fois moins cher en 23 mois.
La conclusion centrale d'Epoch est que le rythme varie énormément selon la tâche — entre 9 et 900 fois par an selon la capacité retenue —, le prix d'une performance de niveau GPT-4 sur des questions scientifiques de niveau doctoral chutant d'environ 40 fois par an. La direction, elle, ne varie jamais.
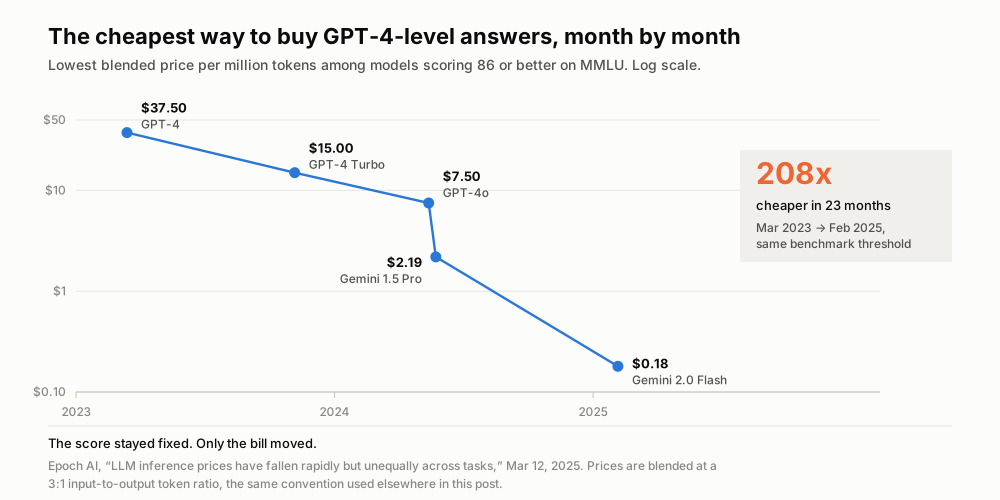
Le score de benchmark est constant en chaque point de cette courbe. Epoch AI, 12 mars 2025.
Prolongez la série jusqu'aux prix actuels et le mouvement continue. Au catalogue OpenRouter du 21 août 2026, Qwen3.8-27B coûte 0,45 dollar par million de jetons d'entrée et 3,20 par million de jetons de sortie ; Claude Opus 4.6 coûte 5,00 et 25,00. Mixés selon le rapport 3 pour 1 retenu par Epoch, cela donne 1,09 contre 10,00 dollars — le modèle ouvert est 9,1 fois moins cher et supérieur de 7,1 points d'indice au vaisseau amiral fermé d'il y a six mois.
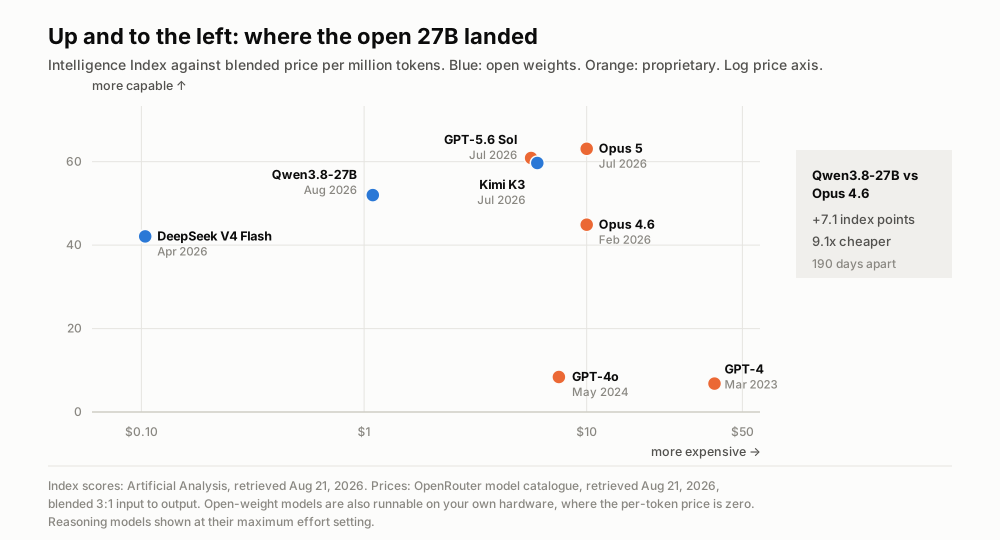
Tous les modèles qui comptent migrent vers le coin supérieur gauche. Scores d'Artificial Analysis, prix d'OpenRouter, consultés le 21 août 2026.
Reste l'option qui n'a aucun prix au jeton. Faites tourner le 27B sur votre propre RTX 4090 aux quelque 48 jetons par seconde rapportés par les praticiens dans le fil de discussion, retenez les 450 watts nominaux de la carte, et au prix moyen de l'électricité résidentielle américaine de 18,44 cents le kilowattheure (EIA, mai 2026), l'électricité revient à environ 0,48 dollar par million de jetons de sortie — avant de compter la carte, et après avoir cessé de compter la marge de qui que ce soit. C'est une estimation calculée dont les hypothèses sont posées sur la table, pas une affirmation d'éditeur.
L'avant et l'après, ligne par ligne
| Juillet 2023 | Août 2026 | |
|---|---|---|
| Meilleur modèle téléchargeable | Llama 2 70B (Meta, 18 juillet 2023) | Qwen3.8-27B (Alibaba, 14 août 2026) |
| Paramètres | 70 milliards | 27 milliards |
| Version communautaire 4 bits standard | 41,4 Go | 16,5 Go |
| Plus petite version utilisable | 7,9 Go (13B, MMLU 54,8) | 9,8 Go (2 bits, contexte de 128K sur une carte de 16 Go) |
| Matériel réaliste | deux GPU de 24 Go ou un Mac de 64 Go | un GPU grand public de 16 Go |
| Modèle de frontière de l'époque | GPT-4 (14 mars 2023) | Claude Opus 4.6 Max (5 février 2026) |
| Résultat face à lui | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | 15 victoires sur 19 benchmarks publiés, +7,1 points d'indice |
| Prix mixte de ce modèle de frontière | 37,50 $ par million de jetons | 10,00 $ par million de jetons |
| Prix mixte du modèle ouvert | pas d'offre à grande échelle | 1,09 $ par million de jetons |
| Licence | Llama 2 Community License | Apache 2.0 |
Les sources de chaque case figurent à la fin. La ligne sur laquelle nous revenons sans cesse est l'avant-dernière : le prix de la frontière elle-même a été divisé par 3,75 en trois ans, tandis que l'alternative ouverte est apparue en dessous, à environ un dixième de ce niveau. Les deux choses ont eu lieu. C'est la seconde qui change qui a le droit de construire.
Ce qui reste faux
L'enthousiasme autour de cette sortie dépasse les preuves sur quatre points précis. Marquons-les.
Ce n'est pas la frontière. Sur le même indice, Claude Opus 5 Max obtient 63,1 et GPT-5.6 Sol Max 60,9, bien au-dessus de 52,0. Si votre travail dépend du raisonnement le plus difficile disponible, la frontière reste un autre produit, et elle reste fermée.
Ce n'est pas bon marché pour sa taille. Le résumé d'Artificial Analysis qualifie lui-même Qwen3.8-27B de « particulièrement cher comparé aux autres modèles à poids ouverts de taille similaire » : la médiane de sa catégorie est de 0,05 dollar par million de jetons d'entrée, contre 0,43 pour Qwen. Vous payez la capacité, pas les paramètres.
Il est bavard, et la loquacité est une facture. Pour l'évaluation de l'indice d'intelligence, le 27B a produit 160 millions de jetons de sortie, contre une médiane de 45 millions. Un utilisateur lui a soumis deux mots sur un Mac mini de 64 Go et l'a regardé réfléchir pendant 17 minutes et 12 secondes. Les modèles de raisonnement facturent en temps réel même quand les jetons sont gratuits.
Enfin, les scores de benchmark appartiennent au modèle en pleine précision. La version 2 bits de 9,8 Go qui tient dans votre carte graphique n'est pas celle qui a obtenu 52,0. Une quantification agressive coûte en exactitude, surtout sur les contextes longs. Toute affirmation du type « ça tourne sur un portable », la nôtre incluse, porte cet astérisque.
Pourquoi le délai devrait continuer de se réduire
Voici notre position, et nous marquons clairement la bascule : tout ce qui précède est mesure, ce qui suit en est l'inférence.
Le mécanisme qui fait baisser le délai de rattrapage n'a rien de mystérieux. Les techniques de post-entraînement publiées à la frontière sont reproduites en quelques mois dans les laboratoires ouverts. Le contrôle de l'effort de raisonnement, astuce propriétaire il y a dix-huit mois, figure aujourd'hui comme paramètre documenté sur cette fiche de modèle. La quantification communautaire est terminée avant que la documentation du laboratoire d'origine ne se stabilise. Aucune de ces trois boucles de rétroaction n'a de raison de ralentir, et deux d'entre elles accélèrent à mesure que le nombre de participants augmente.
L'attente raisonnable pour la génération suivante n'est donc pas que les modèles ouverts dépassent la frontière. C'est que ce délai de 162 jours continue de se comprimer pendant que la capacité absolue monte aux deux extrémités. Le seuil intéressant n'est alors plus « les modèles ouverts peuvent-ils gagner » mais « à quel point la frontière doit-elle être récente pour que la différence cesse de compter dans mon travail ». Pour la transcription de réunions, la traduction, la synthèse et l'essentiel du travail documentaire, ce seuil est franchi depuis un moment. Pour la recherche de pointe et l'ingénierie agentique la plus difficile, non.
C'est un monde bien meilleur que celui de 2023, et cela vaut la peine de le dire clairement. Le coût pour donner à une machine une compréhension compétente du langage a chuté de deux ordres de grandeur en trois ans, et il continue de chuter. Ceux qui en profitent le plus sont ceux que le prix excluait : développeurs solitaires, équipes dans des pays où 10 dollars par million de jetons n'est pas une erreur d'arrondi, chercheurs dotés d'une subvention plutôt que d'un budget, et quiconque doit garder ses données sur sa propre machine pour des raisons légales.
L'essentiel : la frontière a cessé d'être un lieu pour devenir une date
L'ancienne question était : à quel laboratoire avez-vous accès ? La nouvelle est : combien de mois de retard sur la frontière acceptez-vous, sachant que cela coûte neuf fois moins cher et tourne sur du matériel qui vous appartient ?
Pour un nombre croissant de tâches, la réponse honnête est : environ cinq mois, et ça diminue.
Ce que fait Telli.sh : tout ce qui précède explique pourquoi nous bâtissons sur des modèles ouverts plutôt qu'autour d'un fournisseur unique. Telli.sh utilise déjà un modèle Qwen ouvert dans sa chaîne de synthèse : chaque pas descendu sur cette courbe arrive donc sous forme de meilleurs comptes rendus, et non d'une annonce tarifaire. Notre travail porte sur ce qu'aucun téléchargement ne donne : capter une heure d'audio sans décrocher, distinguer les intervenants, traduire en direct dans 15 langues, et transformer tout cela en notes encore consultables des mois plus tard.
Démarrer une note IA en direct
Sources
- Fiche du modèle Qwen3.8-27B et tableaux de benchmarks, Hugging Face — chiffres du face-à-face avec Opus 4.6 Max, consulté le 21 août 2026
- Artificial Analysis : analyse d'intelligence, de performance et de prix de Qwen3.8 27B — indice d'intelligence 52,0, prix et verbosité, consulté le 21 août 2026
- Artificial Analysis : page du modèle Claude Opus 4.6 — indice d'intelligence 44,9 à effort de raisonnement maximal, consulté le 21 août 2026
- Epoch AI, « LLM inference prices have fallen rapidly but unequally across tasks », 12 mars 2025 — échelle de prix à seuil fixe et fourchette de 9 à 900 fois par an
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 juillet 2023 — tableau 4, Llama 2 70B face à GPT-4
- Liste des fichiers de TheBloke/Llama-2-70B-Chat-GGUF — version Q4_K_M de 41,4 Go, publiée le 4 septembre 2023
- Liste des fichiers de unsloth/Qwen3.8-27B-GGUF — versions de 16,5 Go et 9,8 Go, décomptes de téléchargements consultés le 21 août 2026
- Catalogue de modèles OpenRouter — prix au jeton pour Qwen3.8-27B, Claude Opus 4.6 et Claude Opus 5, consulté le 21 août 2026
- Discussion Hacker News sur la sortie de Qwen3.8-27B, 14 août 2026 — mesures de débit rapportées sur cartes de 16 et 24 Go
- US Energy Information Administration, Electric Power Monthly, tableau 5.3 — 18,44 cents le kilowattheure en moyenne résidentielle, mai 2026
- Notre couverture précédente de la sortie des poids ouverts de Qwen3.8 et de la vague plus large des poids ouverts
- Page Wikimedia Commons de la photographie du Cray Y-MP
