Qwen3.8-27B open weights : tailles, Q4_K_M et vitesses réelles 4090/Mac
Qwen3.8-27B est publié sous licence Apache 2.0. Le GGUF Q4_K_M pèse 17,1 Go et tient sur un portable de 32 Go ; le FP8 fait 30,9 Go. Mesuré : 48 tokens/s sur RTX 4090, 12,75 sur Mac mini M4 Pro.
Le 3 août, le compte Qwen d'Alibaba annonçait les poids ouverts pour « la semaine prochaine ». C'est exactement le genre de phrase que le secteur de l'IA a appris à tout le monde à écouter avec une décote. Douze jours plus tard, il n'y a plus rien à décoter : les poids de Qwen3.8-Max, 2 400 milliards de paramètres, sont apparus sur Hugging Face le 12 août, et le petit modèle — Qwen3.8-27B, sous une simple licence Apache 2.0 — a suivi le 14 août.
C'est ensuite que les choses sont devenues intéressantes. Dans l'heure même où Qwen achevait de publier la fiche du 27B, trois groupes communautaires distincts l'avaient déjà converti dans des formats exécutables sur un ordinateur personnel. Deux jours plus tard, ces conversions dépassaient le million de téléchargements.
C'est ce chiffre qui fait l'actualité, pas le tableau de benchmarks. Un modèle de 27 milliards de paramètres issu d'un des meilleurs laboratoires d'IA du monde est passé d'« annoncé » à « tournant sur environ un million de bureaux » en 48 heures. Cet article explique en langage clair ce que cela signifie concrètement : ce qui est sorti et sous quelle licence, ce qu'il faut pour faire tourner le 27B sur du matériel que vous possédez déjà, le chemin parcouru en trois ans, et la partie que la plupart des articles évitent — ce qu'un 27B local ne sait toujours pas faire.
L'essentiel :
- La promesse a été tenue. Qwen3.8-Max (2 400 Md au total / 95 Md actifs) est arrivé le 12 août, Qwen3.8-27B le 14 août. Les deux sont réellement téléchargeables, ce ne sont pas des aperçus hébergés.
- Les licences diffèrent, et cette différence compte davantage que les scores. Le 27B est sous Apache 2.0 : aucun seuil, aucune clause, usage commercial libre et sans contrepartie. Qwen3.8-Max sort sous une licence maison assortie d'un déclencheur de chiffre d'affaires pour les activités de modèle en tant que service.
- C'est la taille qui décide de qui peut faire tourner quoi : Max représente 4 892 Go à télécharger ; le 27B compressé en 4 bits pèse 17,1 Go et tient sur une machine de 32 Go. Les versions communautaires en 4 bits ont dépassé 1,07 million de téléchargements en deux jours.
Image : Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Faire tourner soi-même le modèle d'un laboratoire de pointe, c'est aussi hériter de la machine et de son entretien.
La promesse portait une date, et la date a tenu
Le 4 août, nous avons couvert l'annonce elle-même en écrivant que l'attente se mesurait en « la semaine prochaine », pas en « un jour ». C'était le maximum que permettaient les faits d'alors. L'affaire s'est réglée proprement.
Qwen3.8-2.4T-A95B — commercialisé sous le nom de Qwen3.8-Max — est apparu avec son fichier de licence le 12 août. Qwen3.8-27B et une variante FP8 optimisée sont arrivés le 14 août. Les deux dates tombent dans la fenêtre que désignait « la semaine prochaine ». Dans un secteur où les modèles annoncés ne sortent régulièrement jamais, un laboratoire qui respecte une échéance verbale vieille de neuf jours mérite d'être signalé.
L'accueil a été immédiat et massif. Le fil Hacker News consacré au 27B a réuni 1 351 points et 769 commentaires en une journée. En quelques heures, des praticiens publiaient des configurations de déploiement fonctionnelles pour du matériel précis ; l'un d'eux a partagé les réglages pour un NVIDIA DGX Spark et pour une carte graphique grand public RTX 4090. Ce n'est pas ainsi que le secteur accueillait les modèles ouverts il y a deux ans, quand faire tourner une architecture inédite était un projet de week-end.
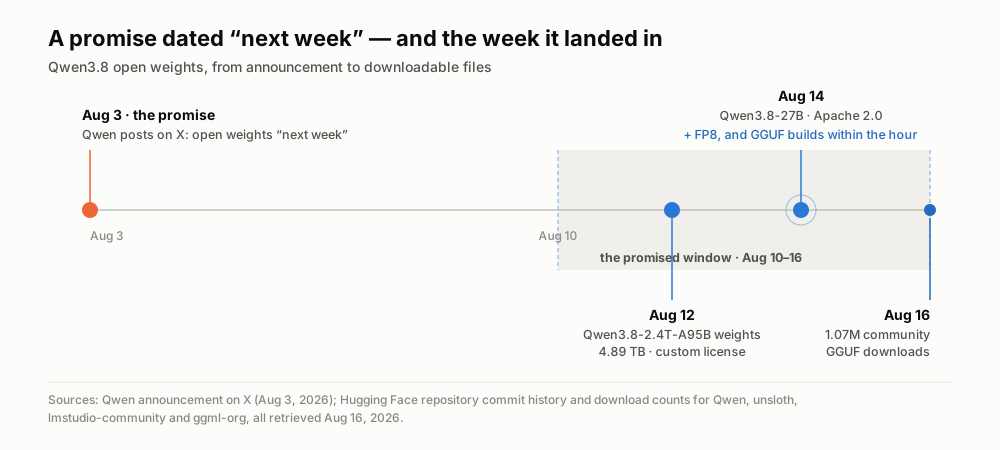
Une promesse datée et les deux livraisons qui sont tombées dedans. Dates issues de l'historique des dépôts Hugging Face, consulté le 16 août 2026.
Cinq termes, orientés vers la question « puis-je le faire tourner ? »
Si vous arrivez de nos articles précédents, vous savez déjà ce que sont les poids ouverts : le laboratoire publie l'immense grille de nombres appris qui constitue le modèle fini, et vous pouvez la télécharger, l'exécuter sur votre matériel et construire dessus sans payer à la requête. Ici, c'est la question suivante qui nous occupe, et elle est purement pratique : combien coûte l'exécution, en matériel ?
Les paramètres sont ces nombres appris, et leur nombre fixe la taille brute du modèle. La règle est d'une simplicité brutale : à la précision utilisée par les laboratoires pour l'entraînement, chaque milliard de paramètres représente environ 2 Go sur le disque, et il faut à peu près autant de mémoire vive pour héberger le modèle pendant son exécution. Un modèle de 27 milliards de paramètres est donc un téléchargement de 55 Go. Un modèle de 2 400 milliards approche les 5 To. D'où le fait que l'un relève de l'ordinateur portable et l'autre du centre de données.
La quantification comble cet écart, et c'est l'idée la plus utile pour qui veut exécuter des modèles chez soi. Les paramètres sont normalement stockés sur 16 bits de précision. La quantification les arrondit à moins de bits — 8, 4, parfois 2 — et le fichier rétrécit à peu près dans la même proportion. La quantification en 4 bits ramène ces 55 Go à environ 17 Go. Vous perdez un peu de précision et vous gagnez la possibilité de faire tourner la chose. GGUF est simplement le format de fichier dans lequel ces versions compressées circulent ; c'est ce que lisent llama.cpp, Ollama ou LM Studio. Quand vous voyez « Q4_K_M », lisez « la version 4 bits que tout le monde utilise ».
Dense contre mélange d'experts décide de la vitesse une fois que le modèle tient en mémoire. Qwen3.8-27B est dense : les 27 milliards de paramètres s'activent pour chaque mot produit. Qwen3.8-Max est un modèle à mélange d'experts — 2 400 milliards de paramètres au total, mais un routeur n'en sélectionne qu'environ 95 milliards par jeton, répartis sur 512 sous-réseaux spécialisés. Le total indique la facture de stockage ; le nombre actif indique la facture de calcul. Cette distinction a une conséquence pratique tranchante, nous y reviendrons.
La fenêtre de contexte est la quantité de texte que le modèle peut considérer d'un coup. Le 27B traite nativement 262 144 jetons — une pile de comptes rendus de réunion d'une heure — et peut être étiré jusqu'à un million par simple configuration.
La licence est la première chose à lire
Voici le constat qui porte tout le reste, et il contredit l'idée qu'une famille de modèles partage une famille de conditions.
Qwen3.8-27B est sous Apache 2.0. C'est l'extrémité permissive du spectre : utilisez, modifiez, affinez, intégrez dans un produit commercial, montez une entreprise dessus, sans rien devoir ni demander à personne. Aucun seuil de chiffre d'affaires, aucune obligation d'affichage du nom, aucune exclusion d'usage.
Qwen3.8-Max, non. Il sort sous une « Qwen3.8-Max License » maison qui commence comme du MIT puis ajoute deux conditions. Si votre produit dépasse 100 millions d'utilisateurs actifs mensuels ou 20 millions de dollars de revenu mensuel, vous devez afficher le nom du modèle dans votre interface. Et si vous exploitez une activité de modèle en tant que service ou d'assistant de travail IA dont le revenu dépasse 50 millions de dollars sur douze mois consécutifs, il vous faut un accord distinct avec Qwen avant tout usage commercial.
Pour un développeur indépendant ou une entreprise en usage interne, rien de tout cela ne mord. Mais c'est le même astérisque que nous avions signalé quand Kimi K3 est sorti sous licence maison plutôt que MIT, et la leçon se répète : « poids ouverts » et « licence ouverte » sont deux questions distinctes, et un laboratoire peut y répondre différemment pour deux modèles publiés à deux jours d'intervalle. Lisez la licence avant de tomber amoureux d'un score.
| Modèle | Paramètres totaux | Actifs par jeton | Taille du téléchargement | Licence | Environnement réaliste |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2 400 Md | 95 Md | 4 892 Go | Maison, seuil de revenu | Une grappe d'accélérateurs |
| Qwen3.8-Max, FP8 | 2 400 Md | 95 Md | 2 496 Go | Maison, seuil de revenu | Une grappe d'accélérateurs |
| Qwen3.8-27B | 27 Md, dense | 27 Md | 55,6 Go | Apache 2.0 | Station de travail multi-GPU |
| Qwen3.8-27B, FP8 | 27 Md, dense | 27 Md | 30,9 Go | Apache 2.0 | Un GPU haut de gamme |
| Qwen3.8-27B, Q4_K_M GGUF | 27 Md, dense | 27 Md | 17,1 Go | Apache 2.0 | Un portable de 32 Go ou une 4090 |
Ce qu'il faut vraiment pour faire tourner le 27B
La réponse honnête : moins que vous ne le pensez, et plus que ne le laissent croire les titres.
Le premier échelon tient en une commande. Le 27B est dans la bibliothèque d'Ollama ; ollama run qwen3.8 récupère une version de 18 Go avec une fenêtre de contexte de 256K et l'entrée d'images, parmi douze variantes dont une réglée pour les puces Apple. LM Studio, qui vous donne une fenêtre de conversation plutôt qu'un terminal, avait sa version en ligne quelques minutes après la sortie. Ni l'un ni l'autre ne vous demande d'avoir compris la section précédente.
Ensuite la réalité s'invite, sous forme de jetons par seconde. Les mesures rapportées par les praticiens dans le fil de sortie tombent à peu près là où le matériel le laisse prévoir. Sur une RTX 4090 avec la version 4 bits, quelqu'un a mesuré environ 48 jetons par seconde — largement plus rapide que votre lecture. Sur un Mac mini M4 Pro doté de 64 Go de mémoire, un autre obtient 12,75 jetons par seconde : utilisable, mais vous le regardez taper. Et sur un portable équipé d'un AMD 7840U et de 64 Go de DDR5 ordinaire, la même version 4 bits produit environ 4 jetons par seconde — techniquement, ça tourne ; en pratique, c'est un traitement par lots qu'on lance avant de partir.
Ce dernier chiffre est précisément là où la distinction dense/experts prend toute sa valeur. La même personne a mesuré, sur le même portable, un ancien modèle à mélange d'experts nominalement plus gros à environ 20 jetons par seconde — cinq fois plus rapide que le modèle dense plus petit, parce qu'une fraction seulement des paramètres s'active à chaque mot. Si vous cherchez quelque chose à faire tourner sur processeur, le nombre à comparer est celui des paramètres actifs, pas du total. C'est la leçon la plus contre-intuitive et la plus utile de l'IA locale.
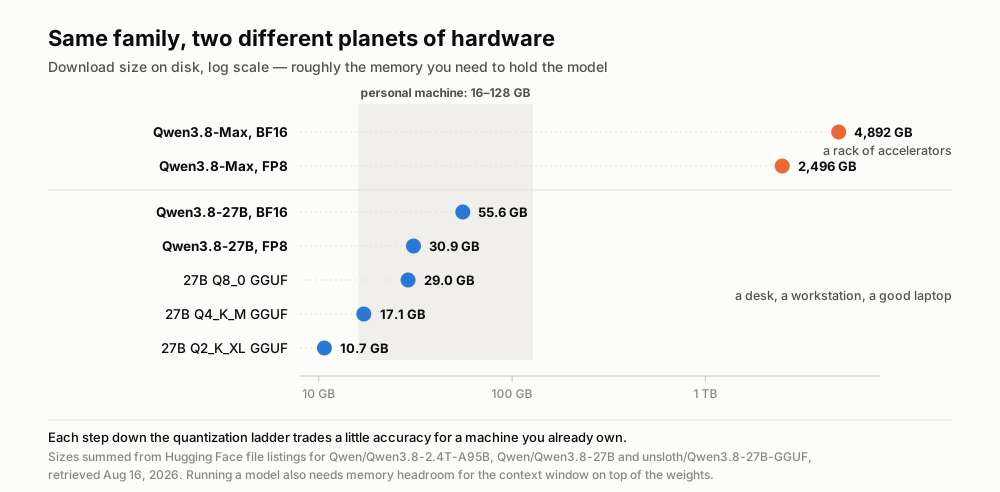
Deux membres de la même famille de modèles, séparés par un facteur 290 en taille de téléchargement. Tailles additionnées depuis les listes de fichiers Hugging Face, consultées le 16 août 2026.
Il y a trois ans, il fallait une fuite et un week-end
Pour mesurer le bond, comparez-le au point de départ des modèles locaux.
En février 2023, Meta n'a diffusé les poids du LLaMA original qu'à des chercheurs agréés. Ils ont fuité en une semaine environ, et toute la scène amateur des modèles locaux s'est bâtie sur un fichier que personne n'était censé détenir. Le 10 mars 2023, un développeur publiait llama.cpp, un petit programme en C++ dont le tour de force était de faire tourner le modèle à 7 milliards de paramètres sur un MacBook. Ce dépôt compte aujourd'hui 124 000 étoiles et il est l'ancêtre de pratiquement tous les outils « exécution locale » utilisés aujourd'hui.
Comparez les deux jours de sortie. En 2023 : un 7B fuité, pas de licence digne de ce nom, une semaine d'effort collectif pour le faire tourner, et un modèle plus intéressant qu'utile. En 2026 : un 27B d'un laboratoire de pointe, publié délibérément sous Apache 2.0, avec entrée image et vidéo, une fenêtre de contexte de 262K, et des versions communautaires terminées avant que la documentation du laboratoire n'ait cessé de bouger. Le premier commit de la conversion unsloth date du 14 août à 14 h 56 UTC — quatre minutes avant la dernière mise à jour de la fiche par Qwen.
Les chiffres d'adoption disent la même chose plus crûment. Au 16 août, les versions communautaires en 4 bits du 27B totalisaient 867 963 téléchargements chez un premier éditeur, 171 518 chez un deuxième et 34 520 chez un troisième : 1,07 million en deux jours. Les dépôts officiels de Qwen pour le 27B en ajoutent 215 000. Qwen3.8-Max, modèle bien plus capable, en est à 17 126 sur ses deux dépôts.
Relisez ce rapport. Le modèle à l'échelle de la frontière a récolté environ 1,6 % de l'attention accordée à celui qui tient sur un portable. Ce que le marché est allé chercher, ce n'est pas la capacité. C'est la portée.
Ce qu'un 27B local ne sait toujours pas faire
Vient la correction, car l'enthousiasme dépasse les preuves de manière prévisible.
Le tableau de benchmarks d'Alibaba place le 27B devant Opus 4.6 Max sur plusieurs mesures de programmation agentique et de suivi d'instructions — 61,7 contre 53,4 sur SWE-bench Pro, 79,5 contre 62,5 sur IFBench — et derrière sur d'autres, dont 30,8 contre 40,0 sur HLE, qui teste les connaissances générales. Chacun de ces chiffres est déclaré par l'éditeur. À l'heure où nous écrivons, Artificial Analysis, l'évaluateur indépendant sur lequel nous nous appuyons, n'a aucune entrée pour le 27B ; il classe en revanche Qwen3.8-Max au 10e rang sur 188 modèles avec un score d'intelligence de 58 — excellent, et c'est un autre modèle.
Les praticiens ont été plus tranchants que le tableur. L'objection la plus votée du fil de sortie, signée d'un utilisateur de longue date des modèles ouverts, était nette : ces modèles ne battent pas les meilleurs modèles hébergés en usage réel ; ils sont « suffisamment bons » pour quantité de tâches et tournent sur du matériel abordable — affirmation différente et plus modeste. Un autre commentaire a posé le plafond en termes physiques : on ne peut pas comprimer l'ensemble du savoir humain dans un fichier de 30 Go, donc les petits modèles restent comparativement faibles pour retrouver des faits obscurs, si affûtés soient-ils en code ou en usage d'outils.
Deux limites de plus n'apparaissent qu'à l'usage. La quantification n'est pas gratuite : un modèle fortement compressé a tendance à perdre le fil sur de longs contextes et peut tomber dans des boucles de répétition — d'où le conseil, pour qui a la mémoire, d'utiliser la version en pleine précision. Et cette génération de Qwen réfléchit beaucoup par défaut : un utilisateur a soumis au 27B, sur un Mac mini de 64 Go, les deux mots « svg owl » et l'a vu générer 21 769 jetons de raisonnement pendant 17 minutes et 12 secondes avant de répondre. La chouette était réussie. La facture en temps réel, elle, n'aurait été facturée par aucune API hébergée.
Reste le poste que personne ne compte : l'exploitation vous appartient désormais. Mises à jour de modèle, choix de quantification, marge mémoire, versions de pilotes, le ventilateur de la machine. L'API hébergée que vous vouliez éviter, c'était aussi une équipe de gens qui maintenait quelque chose en marche.
En résumé : les douves ont glissé vers le bas de la pile
Voici le point, et il dépasse une sortie de modèle.
Un laboratoire de pointe a publié un 27B performant un jeudi. Le samedi, plus d'un million de copies de versions compressées par la communauté étaient sur les machines des gens, il était à une commande de distance dans Ollama, et il était juridiquement libre d'en faire un commerce. Quel que soit l'avantage que ce modèle représente, il a mis environ deux jours à devenir accessible à tous les concurrents en même temps. Appelons cela les douves de deux jours : un avantage de modèle dont la demi-vie tourne désormais autour de 48 heures.
Ce n'est pas une prédiction. C'est une mesure, prise cette semaine, sur cette sortie.
Et elle redéfinit ce que signifie construire un produit d'IA. Quand la couche modèle devient une matière première que n'importe qui remplace en un après-midi, le modèle cesse d'être le terrain de la concurrence. Ce qui subsiste, c'est tout ce qui l'entoure : la fiabilité quand le serveur d'inférence tombe à trois heures du matin, les chaînes de données qui capturent, nettoient et retrouvent le bon contexte, l'évaluation qui vous dit si ça marche sur vos données et non sur celles d'un benchmark, une interface que quelqu'un utilisera vraiment, et les garanties de confiance — confidentialité, durée de conservation, qui voit quoi — qui décident si l'on vous confiera ses enregistrements de réunion.
Rien de tout cela ne se banalise en deux jours. Rien de tout cela n'a de bouton de téléchargement.
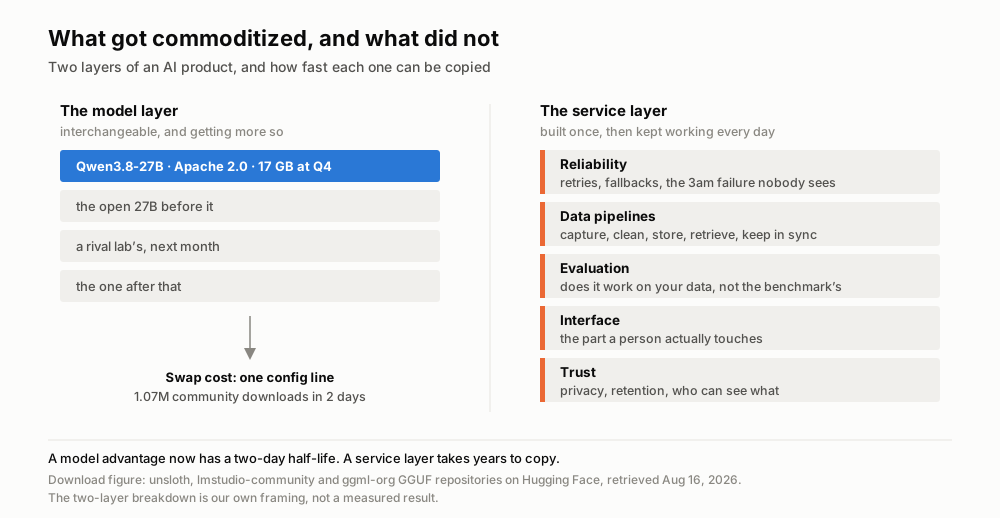
La couche devenue bon marché cette semaine, et celle qui ne l'est pas. Chiffres de téléchargement issus de Hugging Face, consultés le 16 août 2026 ; le découpage en deux couches est le nôtre.
La bonne réaction à l'arrivée d'un excellent modèle ouvert sur les portables n'est donc ni « les entreprises de modèles ont gagné » ni « les entreprises de produits ont perdu ». C'est que le travail intéressant est descendu d'un étage dans la pile, là où il est beaucoup plus difficile à copier et beaucoup moins amusant à raconter.
Où se situe Telli.sh : nous construisons exactement cette couche de service, sur des modèles ouverts. Telli.sh utilise déjà un modèle Qwen ouvert dans sa chaîne de synthèse, ce qui veut dire que chaque bond de qualité des modèles ouverts — celui-ci compris — se déverse directement dans la transcription, la traduction et les résumés de réunion, sans changement de prix de votre côté. Notre temps passe dans ce qui n'arrive pas dans un fichier GGUF : capturer l'audio de façon fiable, ne pas confondre les intervenants, transformer un enregistrement de 60 minutes en notes que vous retrouverez des mois plus tard, et dire clairement où vivent vos données.
Démarrer une note IA en direct
Sources
- Fiche et licence de Qwen3.8-27B, Hugging Face
- Fiche et licence de Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF : versions quantifiées et compteurs de téléchargement
- Qwen3.8 dans la bibliothèque de modèles Ollama
- Discussion Hacker News sur la sortie de Qwen3.8-27B (14 août 2026)
- Page modèle Artificial Analysis pour Qwen3.8 Max
- Annonce des poids ouverts par Qwen (@Alibaba_Qwen) sur X (3 août 2026)
- Dépôt llama.cpp, créé le 10 mars 2023
- Page de l'image sur Wikimedia Commons
