Le sprint open-weight chinois en trois semaines : Kimi K3, Qwen3.8-Max et le retournement qui pourrait tout arrêter
En trois semaines, les plus grands laboratoires d'IA chinois ont publié ou annoncé des modèles open-weight de pointe — Kimi K3, Qwen3.8-Max et DeepSeek V4 en disponibilité générale. Un guide en langage clair : ce qu'est chaque modèle, ce qui est réellement sorti et ce qui reste une promesse, et pourquoi Pékin pourrait désormais encadrer la vague qu'il a lui-même déclenchée.
Entre le 16 et le 26 juillet, trois des plus grands laboratoires d'IA chinois ont posé sur la table des modèles ouverts de niveau frontière. Moonshot AI a annoncé Kimi K3 le 16 juillet et publié les poids le 26 juillet. Alibaba a dévoilé Qwen3.8-Max le 19 juillet à la WAIC de Shanghai. La gamme V4 de DeepSeek a atteint la disponibilité générale (GA) autour du 20 juillet. Trois laboratoires, environ trois semaines.
Le schéma est difficile à manquer, et ce n'est pas celui sur lequel la scène chinoise des modèles ouverts a bâti sa réputation. Ces laboratoires étaient connus pour des modèles petits, rapides et bon marché, qui frappaient au-dessus de leur catégorie. Cette vague est le pari inverse : des systèmes à plusieurs milliers de milliards de paramètres, publiés — ou promis — en open weights.
Voici un décryptage honnête de cette vague : ce qui est réellement sorti, ce qui reste au stade de l'aperçu ou de la promesse, et le retournement qui l'a accompagnée — le gouvernement même qui a rendu ces publications possibles évalue désormais s'il faut les restreindre. Nous garderons le jargon au minimum et expliquerons le reste au fil de l'eau, pour que vous puissiez suivre l'histoire même si « open weights » et « mixture-of-experts » vous sont nouveaux. Si vous avez lu notre tour d'horizon de juillet, ceci en est la suite, et l'un de ses fils laissés en suspens vient de se dénouer.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
D'abord, les cinq idées qui rendent tout cela limpide
Si vous débutez dans ce coin de l'IA, cinq termes portent l'essentiel de l'histoire, et ils méritent une minute en langage clair avant d'aborder les modèles.
Les « open weights » (poids ouverts) sont toute la raison pour laquelle cette vague compte. Les poids d'un modèle sont l'immense grille de nombres qu'il a apprise pendant l'entraînement — en somme, le cerveau achevé. Quand un laboratoire publie les poids, vous pouvez télécharger ce fichier, faire tourner le modèle sur votre propre matériel, l'adapter et construire des produits dessus sans demander la permission à personne ni payer à la requête. L'alternative est un modèle fermé, comme la plupart des chatbots commerciaux, où les poids restent verrouillés sur les serveurs du fournisseur et où vous louez l'accès via une API payante. Les open weights transforment un modèle : d'un service qu'on loue, il devient une chose dont on possède une copie — et c'est cette différence qui fait qu'une industrie entière tend l'oreille quand un bon modèle sort.
Les « paramètres » sont ces nombres appris, et leur nombre est l'indicateur approximatif de ce qu'un modèle peut contenir. Un modèle à « 2,8 billions de paramètres » en compte 2,8 billions. Plus gros n'est pas automatiquement meilleur, mais à la frontière cela signifie généralement plus de marge pour raisonner — et, tout aussi important, plus de matériel pour le faire tourner. C'est là qu'intervient le « mixture-of-experts » (MoE). Au lieu d'activer tous les paramètres pour chaque mot, un modèle MoE est découpé en de nombreux sous-réseaux spécialisés appelés experts, et un routeur n'en choisit qu'une poignée pour chaque token. Donc quand vous lisez « 2,8 billions au total, 104 milliards actifs », cela veut dire que le modèle est énorme mais que seuls environ 104 milliards de paramètres travaillent à un instant donné — comme un hôpital comptant des milliers de spécialistes où chaque patient n'est vu que par les quelques-uns concernés. Le total laisse entrevoir sa capacité ; le nombre actif dit combien il coûte à servir. Cet écart est le chiffre le plus utile pour juger du coût.
Une « fenêtre de contexte » est la quantité de texte que le modèle peut garder en tête à la fois, comptée en tokens — et un token vaut environ trois quarts de mot. Une fenêtre d'un million de tokens n'est pas une spec abstraite : c'est plusieurs longs romans, ou des dizaines de transcriptions de réunions d'une heure, en une seule passe. C'est la différence entre résumer un seul e-mail et raisonner sur un trimestre entier d'e-mails.
Enfin, la licence — et c'est la partie que les praticiens devraient lire en premier, avant les benchmarks. La licence, c'est les petites lignes juridiques qui disent ce que vous avez le droit de faire des poids. MIT est l'étalon-or : utilisez, modifiez, intégrez dans un produit commercial, vous ne devez rien. Une licence maison peut avoir l'air ouverte tout en excluant précisément l'usage que vous aviez en tête — par exemple en vous facturant dès que l'activité bâtie dessus devient importante. Deux modèles peuvent tous deux être « open weights » et être à des années-lumière l'un de l'autre sur ce qui est légalement permis. Il est donc payant de lire cette ligne avant de tomber amoureux d'un score. Ces cinq idées en main, la vague se lit clairement.
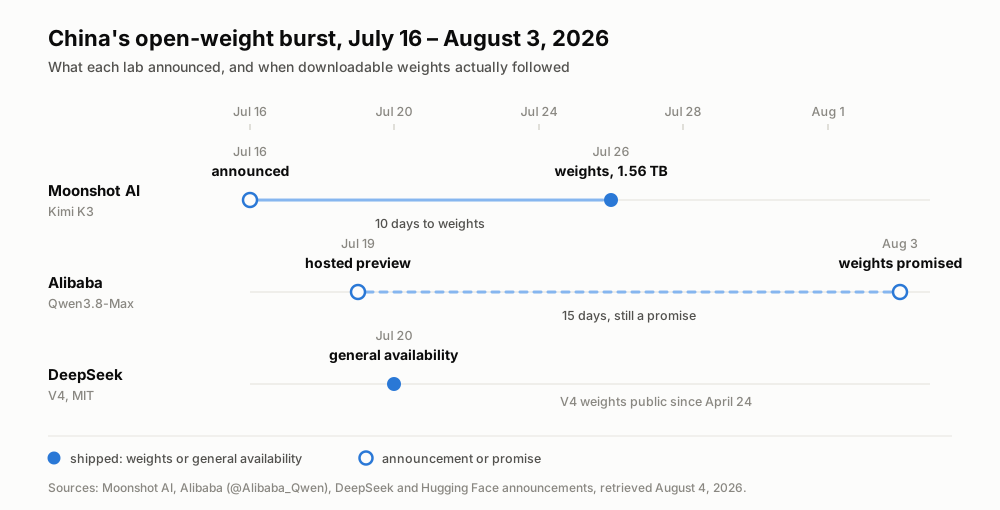
Trois laboratoires, trois semaines — et sur ces cinq moments, deux seulement ont réellement mis des poids entre les mains de quelqu'un. Dates issues des annonces des laboratoires, consultées le 4 août 2026.
Kimi K3 est celui qui est vraiment sorti
Commençons par Moonshot AI, le laboratoire pékinois derrière l'assistant Kimi, qui a passé l'année écoulée à se forger une réputation avec de grands modèles ouverts performants. Quand nous avons écrit sur Kimi K3 en juillet, les poids n'étaient qu'une promesse — Moonshot avait dit « d'ici le 27 juillet ». Ils sont arrivés le 26 juillet : 1,56 téraoctet réparti en 96 fragments sur Hugging Face, sous moonshotai/Kimi-K3. C'est là l'information. Une annonce est un communiqué de presse ; des poids téléchargeables sont un fait sur lequel on peut construire.
En clair, K3 est l'un des plus grands modèles ouverts jamais publiés — un système mixture-of-experts de 2,8 billions de paramètres au total et d'environ 104 milliards actifs par token, qui achemine à peu près 16 experts sur 896 via un mécanisme que Moonshot nomme Kimi Delta Attention, avec une fenêtre de contexte d'un million de tokens et un gain d'efficacité de mise à l'échelle rapporté d'environ 2,5x par rapport à son prédécesseur K2. Traduit de la fiche technique : il est très grand, relativement économique à faire tourner pour sa taille puisque seule une fraction s'active par token, et capable d'avaler d'un coup des entrées longues comme un livre.
Ces chiffres disent aussi qui va réellement le faire tourner. 1,56 téraoctet en 96 fragments, ce n'est pas un téléchargement de portable ; c'est un artefact de classe datacenter qui exige une grappe d'accélérateurs haut de gamme rien que pour être chargé. En pratique, presque aucun particulier n'hébergera K3 lui-même — on l'atteindra via des fournisseurs qui possèdent déjà le matériel, et ce marché est arrivé dès le premier jour : Together AI et Modal ont mis en ligne des points d'accès Kimi K3 hébergés à l'instant même où les poids ont atterri. C'est aussi ainsi qu'un lecteur curieux l'essaie aujourd'hui — non en téléchargeant 1,56 To, mais en appelant l'un de ces points d'accès hébergés ou en utilisant l'application Kimi. « Ouvert » signifie ici que les poids sont publics et que quiconque a le matériel peut les servir, ce qui maintient précisément la concurrence sur les prix ; cela ne veut pas dire que vous le ferez tourner sur votre bureau.
Est-il bon ? D'après le seul chiffre indépendant auquel nous nous fions ce tour-ci, oui. Dans le classement d'Artificial Analysis, il s'est hissé au 4ᵉ rang sur 189 modèles — derrière Claude Fable 5 et deux configurations GPT-5.6 « Sol », devant Opus 4.8 et GPT-5.5. Pour un modèle ouvert que l'on peut télécharger, figurer dans cette compagnie est en soi l'histoire.
Lisez ensuite la licence, car c'est là qu'« ouvert » gagne un astérisque. Kimi K3 n'est pas MIT. Il est diffusé sous une licence maison, la « Kimi K3 License », non approuvée par l'OSI et assortie d'une clause de seuil de revenus : faire tourner K3 comme moteur d'une grande activité de Model-as-a-Service exige un accord distinct avec Moonshot. Pour un développeur solo, ou une entreprise ordinaire qui l'utilise en interne, cela ne change rien. Mais pour quiconque bâtit un produit hébergé à grande échelle, « poids ouverts » et « licence ouverte » sont deux questions différentes — et ici, seule la première reçoit un oui sans ambiguïté.
Qwen3.8-Max est un aperçu, pas un téléchargement
Qwen est la famille de modèles d'Alibaba, et son équipe compte parmi les plus prolifiques du monde en modèles ouverts — c'est précisément cet historique qui rend le petit dernier déroutant. Présenté le 19 juillet à la WAIC de Shanghai, Qwen3.8-Max est le plus gros titre de la vague, et le plus tendre. C'est un MoE creux de 2,4 billions de paramètres — paramètres actifs non divulgués — et le premier Qwen au-delà du billion de paramètres à être multimodal, c'est-à-dire à prendre en entrée non seulement du texte mais aussi des images, de la vidéo et des documents.
Voici le piège qu'un débutant a besoin qu'on lui épelle : malgré le tapage, vous ne pouvez pas le télécharger. Pour l'instant, il n'existe que comme « aperçu hébergé » — qwen3.8-max-preview, accessible via le service maison d'Alibaba (son Token Plan et l'outil Qoder) à environ 10 % du tarif standard. Un aperçu hébergé signifie qu'Alibaba fait tourner le modèle sur ses serveurs et vous laisse l'appeler ; c'est le modèle en API louée, pas le modèle dont on possède une copie. Le qualifier aujourd'hui de sortie open-weight est prématuré.
Ce tableau a changé le 3 août. Le compte officiel Qwen sur X, @Alibaba_Qwen, a publié que les poids ouverts de Qwen3.8-Max arriveraient « la semaine prochaine » — et qu'un Qwen3.8-27B plus petit passerait aussi en open-weights. Le 27B n'est donc pas une rumeur, quoi qu'aient laissé entendre les bavardages antérieurs : c'est un engagement officiel, noir sur blanc, du propre compte d'Alibaba. Et la taille est l'essentiel. Là où le Max à 2,4 billions de paramètres, comme K3, ne tourne que dans un datacenter, un 27B est assez petit pour être servi sur une seule machine haut de gamme — le calibre qu'un particulier ou une petite équipe peut réellement auto-héberger. Cela adoucit vraiment l'image du « promis sans le moindre détail » : il y a désormais une taille et un horizon approximatif.
Les mises en garde honnêtes tiennent toujours, cela dit. « La semaine prochaine » est une direction, pas une date de livraison, et à l'heure où nous écrivons, le 4 août, rien n'a atterri sur l'organisation Qwen de Hugging Face — ses modèles les plus récents y datent de juin. La licence open-weight n'a pas non plus été publiée, et les premiers lecteurs des conditions de l'aperçu ont signalé de possibles restrictions régionales, non confirmées tant que la vraie licence n'apparaît pas — exactement la leçon « la licence d'abord » du b.a.-ba. L'affirmation d'Alibaba selon laquelle le modèle serait « juste derrière Fable 5 » reste une déclaration maison sans chiffres tiers, alors traitez-la comme une formule marketing d'un fournisseur jusqu'à ce que quelqu'un hors d'Alibaba la mesure. Si vous voulez essayer le modèle aujourd'hui, l'aperçu hébergé est la seule porte — mais pour la première fois, l'attente de poids téléchargeables se mesure en « la semaine prochaine », et non en « un jour ».
DeepSeek V4 a atteint la disponibilité générale en silence
DeepSeek est le laboratoire dont le modèle R1 a aidé à lancer la course actuelle aux modèles ouverts début 2025, et fidèle à lui-même, il a le moins communiqué ici tout en livrant le plus utilisable. Sa gamme V4, publiée dès le 24 avril, est celle que l'on peut adopter le plus simplement, car elle arrive sous la licence que le b.a.-ba a désignée comme l'étalon-or.
V4 se décline en deux tailles, toutes deux sous licence MIT. V4-Pro est le fleuron, 1,6 billion au total et 49 milliards de paramètres actifs ; V4-Flash est le poids plume, 284 milliards au total et 13 milliards actifs. Rappelez-vous ce que signifie le nombre actif : V4-Flash n'active que 13 milliards de paramètres par token, ce qui le rend bon marché et rapide à servir, et c'est ce qui en fait le choix économique pour le travail à gros volume — ce type de charge « transcrire et résumer » où le coût par token décide de tout. Les deux offrent une fenêtre de contexte d'un million de tokens et peuvent produire jusqu'à 384K tokens de sortie en une seule réponse, de quoi rédiger un long rapport, pas seulement un paragraphe. Autour du 20 juillet, V4 a atteint la disponibilité générale avec une tarification à la durée, ce qui a fait entrer une sortie de printemps dans le même cadre de trois semaines que K3 et Qwen.
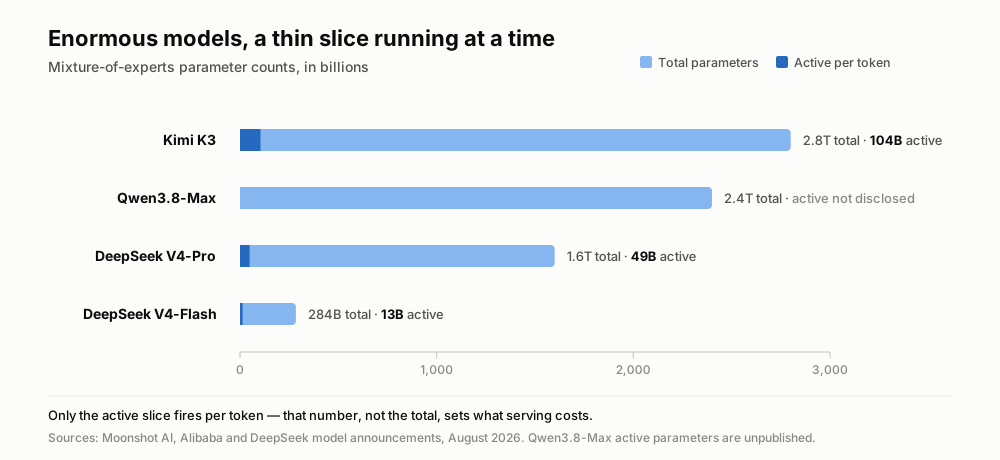
La barre claire, c'est la taille du modèle ; le petit segment foncé, ce qui s'allume réellement à chaque token. Alibaba n'a pas publié le nombre de paramètres actifs de Qwen3.8-Max.
Parce qu'il est MIT, V4 est celui sur lequel un adoptant peut bâtir avec le moins d'avocats : récupérer les poids (ou passer par un fournisseur hébergé), le faire tourner, l'expédier en commercial, ne rien devoir et ne demander à personne. Et pour être clair sur les numéros de version, puisque la rumeur les adore — il n'y a pas de R2, pas de V5, pas de V4.1. Il y a juste la famille V4 qui mûrit en quelque chose sur quoi les équipes peuvent compter.
L'écart se resserre plus vite que les classements ne l'admettent
En prenant du recul, la pente compte plus que les sorties individuelles. Pour Nathan Lambert, la distance entre les meilleurs modèles ouverts et les meilleurs modèles fermés s'est comprimée d'environ six à neuf mois à trois à cinq — « les modèles ouverts n'ont jamais été aussi proches de la frontière depuis DeepSeek R1 ». Dit simplement : les modèles librement téléchargeables ne sont plus qu'à quelques mois derrière les meilleurs modèles que l'on peut louer, là où il y a un an ils avaient un tour de retard confortable.
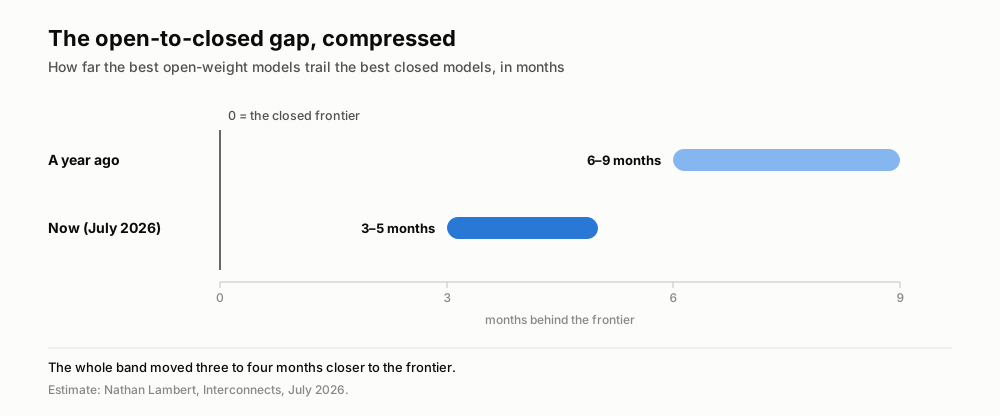
L'estimation de Lambert tracée à l'échelle : le camp ouvert ne s'est pas seulement rapproché, tout l'intervalle s'est resserré.
Les données d'usage vont dans le même sens. Sur OpenRouter, une place de marché qui répartit les requêtes entre de nombreux modèles, la part de tokens des modèles d'origine américaine est tombée d'environ 70 % en juin 2025 à environ 30 % un an plus tard, tandis que les modèles d'origine chinoise dépassent désormais régulièrement 30 %. Le prix y est pour beaucoup : les modèles ouverts chinois coûtent en général 60 à 90 % de moins par token, et l'hébergement a suivi immédiatement, comme l'ont montré ces points d'accès K3 dès le jour zéro.
Le changement le plus discret concerne l'échelle. La marque des modèles ouverts chinois, c'était petit, rapide, bon marché. K3 à 2,8 billions de paramètres et Qwen3.8-Max à 2,4 billions sont exactement l'inverse — un pari selon lequel voir grand dans l'ouvert en vaut désormais la peine. GLM-5.2 de Z.ai, publié le 16 juin sous MIT et en tête de la catégorie open-weight de l'Artificial Analysis Index à 51, est le même message venu d'un quatrième laboratoire.
Le retournement : le gouvernement qui a permis cela pourrait le restreindre
Puis le vent a tourné. Autour du 22 au 25 juillet, le Financial Times et Reuters ont rapporté que le ministère chinois du Commerce envisage des contrôles à l'exportation sur les modèles d'IA — y compris les LLM open-weight — Alibaba, ByteDance et Z.ai étant, dit-on, associés aux discussions. Le cadre évoqué est étagé : une obligation de déclaration pour les modèles les plus faibles, un examen de sécurité pour les plus puissants, et une possible interdiction de publier ouvertement les plus capables. Rien n'est encore loi. Mais la direction est frappante : la vague atteint peut-être son sommet au moment précis où son propre gouvernement commence à traiter ces modèles comme des exportations stratégiques plutôt que comme des contributions ouvertes.
En résumé : quand l'ouvert devient un actif stratégique
Le récit commode dit « la Chine a rattrapé son retard ». Le plus juste dit que les poids ouverts sont devenus un actif stratégique assez vite pour qu'un gouvernement veuille désormais garder la main sur le robinet. En trois semaines, les modèles ouverts sont passés d'un retard de deux à trois trimestres sur la frontière à un seul — et de petits et bon marché à figurer parmi les plus grands modèles jamais publiés, sous quelque forme que ce soit. La frontière ouverte n'a pas seulement bougé. Elle s'est déplacée vers un endroit d'où ses créateurs ne seront peut-être pas libres de continuer à livrer.
Pour les équipes qui construisent sur ces modèles, l'enseignement pratique reste le même, en un peu plus tranchant. Telli.sh fait déjà tourner un modèle ouvert, Qwen3, dans sa couche de résumé, si bien que chaque gain de qualité et de prix des modèles ouverts irrigue directement la transcription, la traduction et le résumé de réunions. Le nouvel élément, c'est l'approvisionnement : si les règles d'exportation chinoises se concrétisent comme le suggèrent les articles, savoir quels modèles ouverts resteront librement téléchargeables est à surveiller plutôt qu'à présumer. Que les modèles nourrissant cette couche s'améliorent est la tendance ; d'où ces modèles ont le droit de venir est le point à garder à l'œil.
Démarrer une note IA en direct
Sources
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
