Anonimowy model spalił 26 bilionów tokenów w cztery dni. Cennik pojawił się później: 24 centy.
20 sierpnia 2026 roku na OpenRouterze pojawił się model bez laboratorium, bez karty modelu i bez ceny, pod nazwą stealth/ox-alpha. Cztery dni później użytkownicy OpenCode przepuścili przez niego 26 bilionów tokenów. Sześć dni później Z.AI przyznało się do autorstwa: GLM-5.3-Flash, 320 miliardów parametrów, licencja MIT, 0,15 dolara za milion tokenów wejściowych. Dlaczego laboratoria publikują dziś modele bez własnej nazwy, co naprawdę mierzą te liczby ruchu i co cena mieszana 24 centów robi z ekonomią potoków głosowych.
20 sierpnia 2026 roku na OpenRouterze pojawił się model pod identyfikatorem stealth/ox-alpha. Bez przypisanego laboratorium. Bez karty modelu, bez tabeli benchmarków, bez wątku z ogłoszeniem. W polu ceny widniało 0 dolarów na wejściu, 0 dolarów na wyjściu. Miał za to okno kontekstowe na 1 048 576 tokenów, wejście tekstowe, obrazowe i wideo oraz jednowierszowy opis o długodystansowej inżynierii oprogramowania.
Cztery dni później OpenCode ogłosił, że jego użytkownicy przepuścili przez model 26 bilionów tokenów.
Sześć dni później Z.AI potwierdziło Bloombergowi, że model należy do nich, opublikowało wagi na licencji MIT i dołączyło cennik: piętnaście centów za milion tokenów wejściowych, pięćdziesiąt centów za milion wyjściowych. Nazwa brzmi GLM-5.3-Flash. Słowo „Flash" wykonuje w tym zdaniu ogromną pracę i właśnie dlatego piszemy ten tekst.
To komentarz, a nie relacja z premiery. Poniżej znajdziesz kalendarium sześciu dni wraz z liczbami ruchu i niezbędnymi zastrzeżeniami, argument za tym, dlaczego laboratoria coraz częściej wypuszczają modele bez czyjegokolwiek nazwiska, specyfikację i niezależne oceny teraz, gdy tożsamość jest znana, wyraźną listę twierdzeń, których nie udało nam się zweryfikować, oraz wyliczenie, co cena mieszana 24 centów robi z kosztem przetwarzania mowy. To bezpośrednia kontynuacja naszego porównania przed i po dotyczącego powrotu modeli lokalnych, a wniosek biegnie w tę samą stronę: cena kompetentnej inteligencji maszynowej wciąż spada, szybciej niż zakłada większość produktowych map drogowych.
W skrócie:
- Ruch był prawdziwy i rekordowy. 26 bilionów tokenów na OpenCode w cztery dni przy 327 000 unikalnych użytkowników oraz 11,6 biliona na OpenRouterze w trzy dni — największa premiera modelu w historii OpenRoutera, wobec poprzedniego rekordu 4,4 biliona.
- Tożsamość potwierdzona ze źródła pierwotnego. 26 sierpnia 2026 roku Z.AI przekazało Bloombergowi, że Ox Alpha to model z serii GLM; własna strona OpenRoutera podaje teraz, że model ukryty „został opracowany i był obsługiwany przez ZAI, ujawniony jako ZAI GLM-5.3-Flash".
- Najważniejsza jest cena. 320 miliardów parametrów łącznie przy 18 miliardach aktywnych, licencja MIT, 0,15 dolara na wejściu i 0,50 na wyjściu za milion tokenów — po zmieszaniu 0,24 dolara, wobec 10,00 dolarów za zamknięty flagowiec sprzed pół roku, który wyprzedza o 12,1 punktu w Intelligence Index od Artificial Analysis.
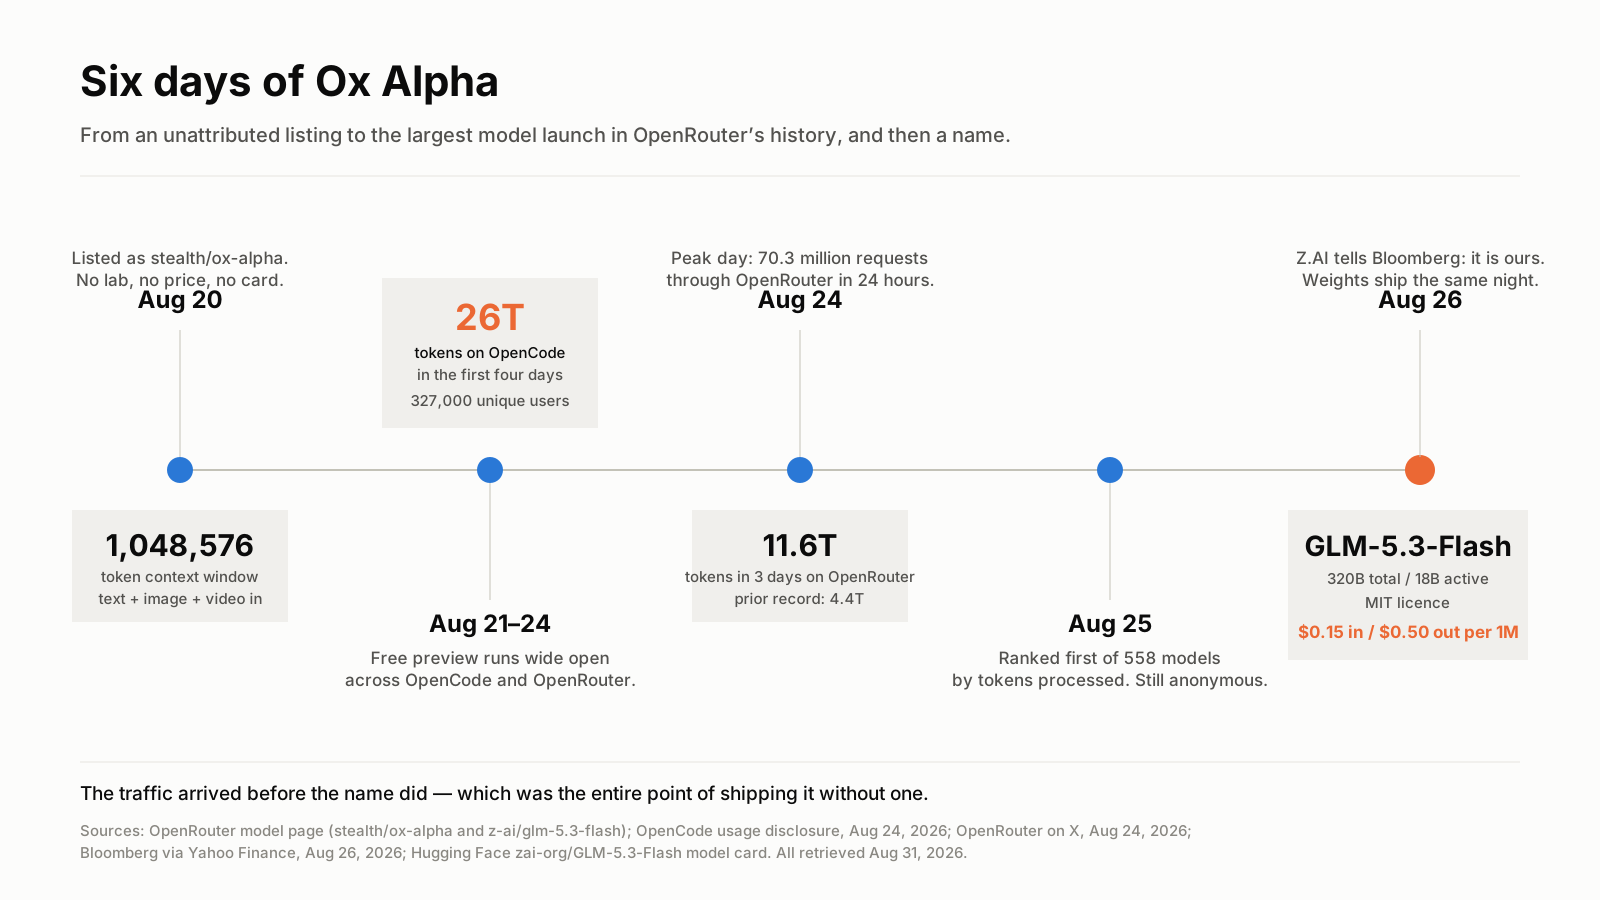
Cała historia od początku do końca zajęła mniej niż tydzień. Źródła na końcu tekstu.
Sześć dni, w kolejności, w jakiej się wydarzyły
20 sierpnia: wpis pojawia się na OpenRouterze i równocześnie wewnątrz OpenCode, otwartoźródłowego terminalowego agenta programistycznego stworzonego przez Daxa Raada. OpenCode przedstawia model jako darmowy, praktycznie nielimitowany, bez przechowywania danych na własnej trasie, i deklaruje zabezpieczoną przepustowość do 100 bilionów tokenów dziennie.
Od 21 do 24 sierpnia: użycie rośnie każdego dnia bez wyjątku. Punkt końcowy aktywności modeli OpenRoutera odnotował 27,0 miliona zapytań 21 sierpnia, 54,4 miliona 22 sierpnia (wzrost o 101,2 procent), 63,9 miliona 23 sierpnia i 70,3 miliona 24 sierpnia.
24 sierpnia: OpenCode publikuje liczby. 26 bilionów tokenów w pierwsze cztery dni, przy 327 000 unikalnych użytkowników i 8 328 244 zakończonych sesjach — średnio 3,2 miliona tokenów na sesję i około 25 sesji na użytkownika. To umieściło Ox Alpha na drugim miejscu wśród modeli śledzonych przez OpenCode, za DeepSeek V4 Flash z 33 bilionami i przed MiMo-V2.5 od Xiaomi z 12 bilionami. OpenRouter osobno podał 11,6 biliona tokenów w pierwsze trzy pełne dni, nazywając to największą premierą modelu w historii platformy; poprzedni rekordzista wygenerował w tym samym oknie 4,4 biliona.
25 sierpnia: API modeli OpenRoutera, posortowane według tokenów przetworzonych w minionym tygodniu, stawia Ox Alpha na pierwszym miejscu wśród 558 zwróconych modeli. Poza laboratorium nikt nie wie, kto go zbudował.
26 sierpnia: Z.AI potwierdza Bloombergowi, że Ox Alpha to nowy model z serii GLM. Wagi wychodzą tej samej nocy. Firmowy wpis premierowy podaje, że GLM-5.3-Flash był testowany anonimowo jako ox-alpha na OpenCode i OpenRouterze, „aby zebrać opinie użytkowników", a strona ukrytego modelu na OpenRouterze zostaje uzupełniona informacją, że model „został opracowany i był obsługiwany przez ZAI, ujawniony jako ZAI GLM-5.3-Flash".
Liczba ruchu jest prawdziwa. Nie jest jednak werdyktem o jakości.
To tutaj większość publikacji pobłądziła, więc określmy precyzyjnie, co mierzy te 26 bilionów tokenów.
Mierzy przepustowość darmowego punktu końcowego z oknem miliona tokenów, zużywaną głównie przez agentów programistycznych. Własny panel OpenCode podaje, że 93 procent tokenów wejściowych zostało obsłużonych z pamięci podręcznej — ten sam kontekst repozytorium, odczytywany raz za razem w toku długiej sesji. Ranking sortowany po przetworzonych tokenach daje ogromną przewagę mechaniczną każdemu darmowemu modelowi z gigantycznym oknem, bo szkielety agentowe wprowadzają kontekst na nowo, ponawiają nieudane wywołania narzędzi i zwracają wyjście narzędzi z powrotem do promptu. Długie sesje z założenia rozdymają tę liczbę.
Wartość 100 bilionów tokenów dziennie wymaga tego samego traktowania. To OpenCode opisywał zagregowaną przepustowość usługi, a nie dostarczone zużycie ani przydział na użytkownika. Rzeczywiste zużycie w pierwsze cztery dni wyniosło średnio około 6,5 biliona tokenów dziennie — 6,5 procent reklamowanego pułapu. Analityk Teortaxes zauważył, że wygenerowanie 100 bilionów tokenów wyjściowych dziennie przy 80 tokenach na sekundę wymagałoby około 580 000 ekwiwalentów GPU, a to dokładnie ten rodzaj liczby, przy którym warto zapytać, co się właściwie liczy, zanim się ją powtórzy.
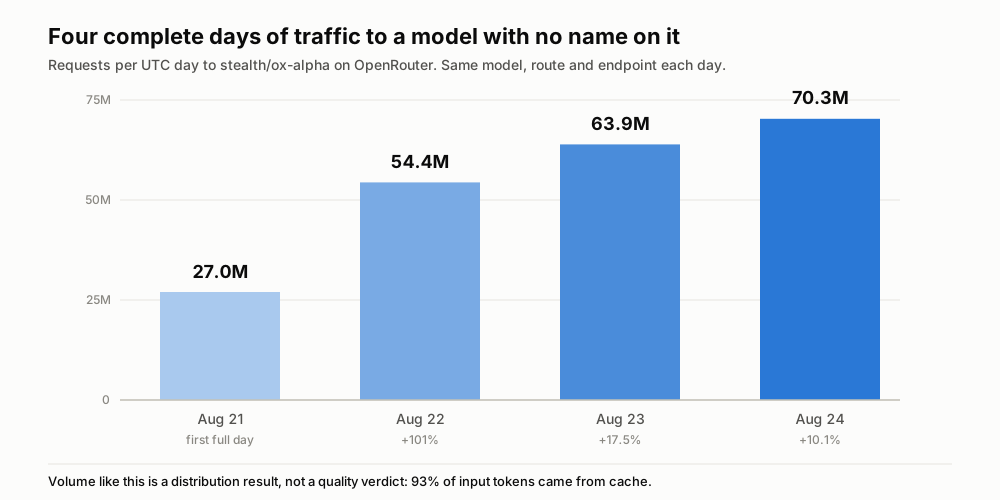
Dzienna liczba zapytań z punktu końcowego aktywności modeli OpenRoutera, migawka z pamięci podręcznej z 25 sierpnia 2026 roku. Platforma może korygować te wartości.
Co więc ruch faktycznie dowodzi? Że darmowy model o kształcie frontierowym z oknem miliona tokenów, umieszczony w dwóch miejscach, w których agenci programistyczni już mieszkają, nasyci popyt w ciągu 24 godzin. To wynik dystrybucji, a wyniki dystrybucji same w sobie warto badać. O tym, czy model jest dobry na twoim repozytorium, nie mówi nic.
Dlaczego laboratorium wypuszcza dziś model bez własnej nazwy
Tu następuje zwrot i wyraźnie go zaznaczamy: wszystko powyżej to pomiar, poniżej zaczyna się nasza interpretacja.
Anonimowa premiera kupuje laboratorium trzy rzeczy, których nie da się zdobyć inaczej. Nazwijmy tę kombinację dywidendą anonimowości.
Pierwsza to czysta ocena. Każda podpisana premiera ląduje wewnątrz uprzedzenia. Model z chińskiego laboratorium ocenia się miarą „zaskakująco dobry jak na model otwarty"; model z amerykańskiego laboratorium frontierowego miarą „czy warty tej podwyżki ceny". Zdejmij nazwę, a programiście zostaje wyłącznie wynik. Oceny, które napłynęły w tygodniu ukrycia, wykonali ludzie nieświadomi, czyj model chwalą — najdroższa rzecz do wyprodukowania w marketingu AI i najtańsza do zdobycia przez zwykłe niepowiedzenie.
Druga to koło zamachowe. Zagadka jest kampanią. Nikt nie pisze śledczego wpisu o rutynowej podbitce wersji, ale tydzień odcisków tokenizera, analizy warstwy serwowania i spekulacji produkuje ogromną ilość publikacji, których laboratorium nie musiało kupować. Ujawnienie ląduje potem na publiczności już zaangażowanej w odpowiedź. Z.AI dostało tydzień darmowej uwagi, a potem dzień premiery z wbudowaną puentą.
Trzecia to telemetria w skali, której pieniądze nie kupują łatwo. 8,3 miliona zakończonych sesji agentowych prawdziwej, niechlujnej, produkcyjnej w kształcie pracy to zbiór danych. Strona Ox Alpha na OpenRouterze mówiła, że prompty i odpowiedzi są zatrzymywane przez dostawcę i wyraźnie nie są używane do trenowania — do tego wrócimy za chwilę. Ale samo zatrzymywanie daje już tryby awarii, rozkłady opóźnień, wskaźniki błędów wywołań narzędzi i krzywe degradacji przy długim kontekście, w setkach tysięcy prawdziwych repozytoriów. Wewnętrzny zestaw testowy tego nie zapewni.
Ten zapis o warunkach przetwarzania danych zasługuje na osobną notę, bo to jedyna naprawdę nietypowa rzecz w całej historii. Z czternastu ukrytych wpisów, które OpenRouter prowadził od kwietnia 2025 roku, trzynaście nosiło jakąś wersję formuły „prompty i odpowiedzi są logowane przez dostawcę i mogą być używane do ulepszania modelu". Tylko przy Ox Alpha widniało zamiast tego: zatrzymywane, nieużywane do trenowania. Czy cię to uspokaja, zależy od tego, jaką wagę przypisujesz jednej linijce tekstu na stronie modelu platformy routującej. To co najmniej świadomy wybór — i pierwszy raz, gdy ukryty wpis go dokonuje.
Kryptonim stał się już osobnym gatunkiem
To nie jest nowy manewr. To wzorzec z pięcioma potwierdzeniami z pierwszej ręki na koncie, a znajomość tego dorobku pozwala właściwie skalibrować kolejny przypadek.
| Kryptonim | Okazał się być | Potwierdzone przez | Data | Dowód |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, przedpremierowa migawka OpenAI | Własny blog OpenRoutera | 14.04.2025 | Źródło pierwotne |
| Optimus Alpha | GPT-4.1, migawka bliższa wersji finalnej | Własny blog OpenRoutera | 14.04.2025 | Źródło pierwotne |
| Horizon Alpha / Horizon Beta | Wczesne punkty kontrolne GPT-5 | OpenRouter, „GPT-5 is now live" | 07.08.2025 | Źródło pierwotne |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, wersja bez i z rozumowaniem | Wyłącznie wnioskowanie społeczności | — | Raportowane, niepotwierdzone |
| Hunter Alpha / Healer Alpha | Xiaomi MiMo | Własny zespół MiMo w Xiaomi | 18.03.2026 | Źródło pierwotne |
| Owl Alpha | Meituan LongCat-2.0-Preview | Blog Meituan i @Meituan_LongCat | 30.06.2026 | Źródło pierwotne |
| Cypher Alpha / Aurora Alpha | Nigdy nierozstrzygnięte | — | — | Brak |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI dla Bloomberga; strona OpenRoutera uzupełniona | 26.08.2026 | Źródło pierwotne |
Z tej tabeli wynikają dwie rzeczy. Siedem z trzynastu historycznych wpisów zostało ostatecznie potwierdzonych oświadczeniem z pierwszej ręki — wskaźnik rozstrzygnięć znacznie lepszy, niż sugeruje folklor. Trzy z tych potwierdzeń przyszły od laboratorium, a nie od OpenRoutera, dlatego zestawienia śledzące wyłącznie blog OpenRoutera wciąż zaniżają liczby. I druga rzecz: gatunek zmienił scenę. Wiersze z 2025 roku to OpenAI i xAI. Wiersze z 2026 to Xiaomi, Meituan i Z.AI. Chińskie laboratoria nie wymyśliły ukrytej premiery; to one ją uprzemysłowiły.
Ujawnienie: 320 miliardów łącznie, 18 miliardów aktywnych, MIT
Teraz specyfikacja, zaczerpnięta z karty modelu samego Z.AI, a nie z czyjegokolwiek streszczenia.
GLM-5.3-Flash jest opisywany przez autorów jako „pierwszy natywnie multimodalny model serii GLM-5", z 320 miliardami parametrów łącznie i 18 miliardami aktywnych w konfiguracji mieszaniny ekspertów, trenowany na multimodalnym korpusie 30 bilionów tokenów. Architektura po raz pierwszy w serii łączy uwagę rzadką i liniową, uzupełnioną techniką, którą artykuł nazywa Manifold-Constrained Hyper-Connections. Okno kontekstowe to 1 048 576 tokenów, a maksymalna pojedyncza odpowiedź 131 072 tokeny. Głębokość rozumowania jest wystawiona jako parametr reasoning_effort z poziomami low, high i max, domyślnie max. Licencja to MIT — nie szyta na miarę licencja społecznościowa z progiem liczby użytkowników, tylko MIT.
Własną deklarację możliwości Z.AI warto zacytować dokładnie, bo jest ostrożniejsza niż otaczające ją publikacje: model „przewyższa GLM-5.2 w benchmarkach i rzeczywistych obciążeniach przy jednej dziesiątej ceny, zbliżając się do Claude Opus 4.8 w benchmarkach programistycznych i agentowych". Zbliżając się. Nie: przewyższając.
Dla niezależnego odczytu: Artificial Analysis już go zmierzyło. GLM-5.3-Flash uzyskuje 57 punktów w Artificial Analysis Intelligence Index, przy medianie 29 dla porównywalnych modeli o otwartych wagach. Przejście całego zestawu ewaluacyjnego kosztowało 138,02 dolara wydatków na API — cytujemy tę liczbę, bo to najuczciwsza pojedyncza dana w całym tekście na temat tego, ile dziś kosztuje korzystanie z inteligencji bliskiej frontierowi. Ta sama ewaluacja wskazuje dwie realne słabości: przy 45 tokenach wyjściowych na sekundę model jest wolny, a na ukończenie indeksu wygenerował 150 milionów tokenów wobec mediany 110 milionów, czyli jest rozwlekły. Rozwlekłość to rachunek, nawet gdy cena za token jest niska.
Prawdziwą wiadomością jest to, że model klasy Flash osiągnął 57 punktów
Zestawmy liczby obok siebie, z tą samą mieszaną konwencją 3:1 wejście-wyjście, której Epoch AI używa do porównań cenowych.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| Premiera | 05.02.2026 | 14.08.2026 | 26.08.2026 |
| Wagi | Zamknięte | Apache 2.0 | MIT |
| Intelligence Index | 44,9 | 52,0 | 57 |
| Cena za 1 mln wejściowych | 5,00 $ | 0,45 $ | 0,15 $ |
| Cena za 1 mln wyjściowych | 25,00 $ | 3,20 $ | 0,50 $ |
| Mieszana (3:1) | 10,00 $ | 1,09 $ | 0,24 $ |
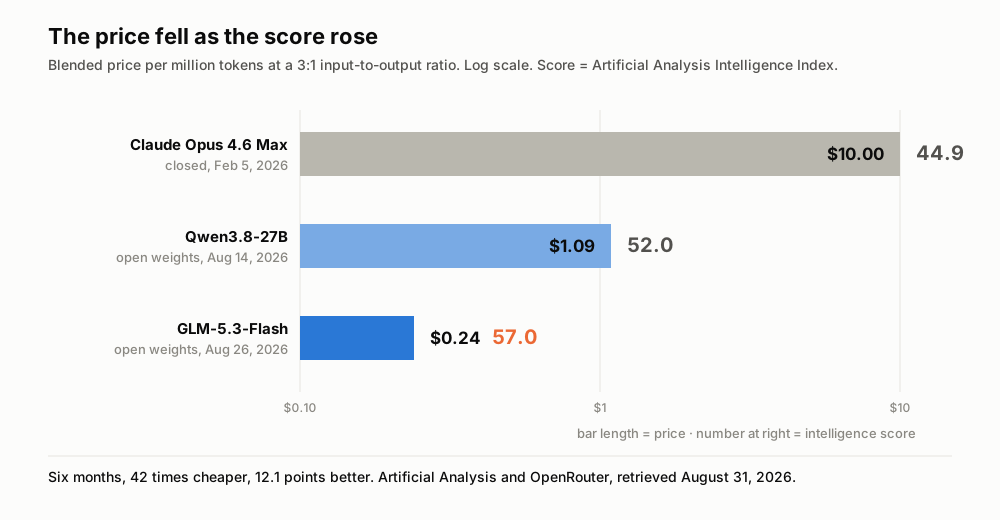
Długość słupka to cena, liczba po prawej stronie każdego słupka to wynik inteligencji. Artificial Analysis i OpenRouter, dane pobrane 31 sierpnia 2026 roku.
GLM-5.3-Flash kosztuje 42 razy mniej niż lutowy zamknięty flagowiec i wyprzedza go o 12,1 punktu w tym samym niezależnym indeksie. W porównaniu z otwartym modelem 27B, o którym pisaliśmy dziesięć dni temu, jest 4,6 razy tańszy i o 5 punktów lepszy. Obie te przepaście otworzyły się w ciągu pół roku.
To ta sama krzywa, którą nasz tekst o Qwen3.8 mierzył z drugiego końca: szereg Epoch AI o stałym progu, utrzymujący wynik benchmarku na stałym poziomie i śledzący najtańszy model, który go osiąga, wykazał spadek ceny wydajności klasy GPT-4 z 37,50 dolara za milion tokenów w marcu 2023 roku do 0,18 dolara w lutym 2025 — 208 razy taniej w 23 miesiące. GLM-5.3-Flash pokazuje, jak ta krzywa wygląda, gdy dociera do obecnego frontieru, a nie do sprzed trzech lat.
I zwróć uwagę na klasę. To nie jest flagowiec. „Flash" w nomenklaturze każdego laboratorium oznacza tani, szybki, obliczony na wolumen odpowiednik modelu, którym naprawdę chcą zrobić na tobie wrażenie. Ciekawy nie jest fakt, że chińskie laboratorium wypuściło mocny model. Ciekawe jest to, że wariant budżetowy jest już na tyle blisko frontieru, że tydzień anonimowych porównań twarzą w twarz nie zdradził gry od razu.
Cztery rzeczy, których nie zdołaliśmy zweryfikować — oznaczamy je jako takie
Entuzjazm wokół tej premiery wyprzedza dowody w konkretnych miejscach. Oto one.
Twierdzenie, że Ox Alpha „przewyższa GPT-5.6" w testach na kontekście miliona tokenów, pochodzi z opracowań osób trzecich, a nie z opublikowanej metodologii, którą moglibyśmy sprawdzić; punktem odniesienia samego Z.AI jest zresztą Claude Opus 4.8, a nie GPT-5.6. Traktuj porównanie z GPT-5.6 jako niezweryfikowane twierdzenie społeczności.
Szeroko powtarzany wynik 80 procent pass@1 na DeepSWE nie jest porównywalny z wartościami powyżej 96 procent na SWE-bench Verified, które pojawiają się obok w tych samych tabelach. Inny szkielet, inny zestaw zadań, inna trudność. Każda tabela stawiająca je w sąsiednich wierszach produkuje ranking, który nie istnieje.
Deklaracja Z.AI, że cały tydzień ukrycia był obsługiwany na krajowych chińskich akceleratorach, z trzykrotną poprawą serwowania end-to-end i kosztem na token porównywalnym ze sprzętem NVIDIA, pochodzi od dostawcy i nie została niezależnie zaudytowana. Jeśli się utrzyma, to najbardziej brzemienny w skutki szczegół całej historii; na razie jest to twierdzenie z komunikatu prasowego.
Wreszcie: darmowy podgląd był subsydium, a nie poziomem cennika. Skończył się. Aktualne ceny to 0,15 i 0,50 dolara, z rabatem promocyjnym 50 procent obowiązującym do 9 września 2026 roku, godz. 16:00 UTC — uczciwą liczbą docelową jest więc ta bez rabatu, a budżet należy planować względem 0,15 / 0,50 dolara, a nie względem tego, ile model kosztuje w tym tygodniu.
Co 24 centy robią z potokiem, który słucha, tłumaczy i streszcza
Produkty głosowe są nietypowo wystawione na cenę tokenów, ponieważ generują transkrypcje, a potem czytają je wielokrotnie. Każdy kolejny krok — dopracowanie, tłumaczenie, streszczenie, odpowiadanie na pytania — na nowo pochłania ten sam tekst. Oto arytmetyka, ze wszystkimi założeniami na wierzchu.
- Zacznij od realnej jednostki pracy. Sześćdziesięciominutowe spotkanie dwóch osób, przy około 130 słowach na minutę, daje mniej więcej 7800 słów. Z etykietami mówiących i znacznikami czasu przyjmij 12 000 tokenów transkrypcji.
- Dodaj przebieg streszczający. Pełna transkrypcja na wejściu, ustrukturyzowane notatki na wyjściu: 12 000 tokenów wejściowych, około 800 wyjściowych.
- Dodaj tłumaczenie na żywo na trzy języki docelowe. Każdy przebieg czyta transkrypcję i pisze porównywalną objętość: 12 000 na wejściu i 12 000 na wyjściu, trzykrotnie.
- Zsumuj spotkanie. 48 000 tokenów wejściowych i 36 800 wyjściowych.
- Wyceń dwa razy. Przy cenach GLM-5.3-Flash 0,15 / 0,50 dolara to spotkanie kosztuje 2,6 centa. Przy cenach Claude Opus 4.6 5,00 / 25,00 dolara to samo spotkanie kosztuje 1,16 dolara.
Czterdziestopięciokrotna różnica na jednej godzinie nagrania to nie optymalizacja pozycji w kosztorysie. To różnica między funkcją, której użycie starannie się mierzy, a funkcją, którą zostawia się włączoną domyślnie. Przy 1,16 dolara za spotkanie tłumaczenie na trzy języki dla każdego użytkownika to decyzja, którą ktoś z finansów musi zatwierdzić. Przy 2,6 centa to pole wyboru.
To właśnie ta część historii przetrwa kryptonim. Ukryta premiera była manewrem marketingowym, i to dobrym. Trwałym faktem jest natomiast to, że tania klasa w ofercie średniej wielkości laboratorium dostarcza dziś 57 punktów indeksu za mieszane 24 centy, z dołączoną licencją MIT — abyś mógł uruchomić model samodzielnie, jeśli cena kiedykolwiek pójdzie w złą stronę.
Podsumowanie: ciekawe ceny nie są już na frontierze
Przez trzy lata pytanie o wybór modelu brzmiało: „jak blisko frontieru możesz sobie pozwolić być". Sześć dni Ox Alpha odpowiedziało na inne: ile możliwości leży już poniżej klasy flagowej, wycenionych jak towar masowy, i jest wypuszczanych przez laboratoria na tyle pewne siebie, by testować je ze zdjętą nazwą.
Dywidenda anonimowości wypłaca się tylko wtedy, gdy model jest dość dobry, by przetrwać tydzień bez marki. Z.AI zainkasowało. Kolejny kryptonim, który pojawi się na platformie routującej, zasługuje na to samo traktowanie, jakie dostał Ox Alpha: uruchom go na własnych zadaniach, zanim ktokolwiek powie ci, czyj on jest — bo przez ten jeden tydzień to jedyna uczciwa ocena, jaką ktokolwiek dostaje.
Gdzie tu Telli.sh: ta krzywa jest powodem, dla którego budujemy nasz potok głosowy na warstwie dostawców silników, a nie wokół API jednego producenta. Telli.sh kieruje transkrypcję, tłumaczenie i streszczanie przez wymienne silniki, więc zejście o stopień na tej krzywej cenowej dociera jako lepsze notatki w tej samej cenie, a nie jako komunikat o zmianie cennika. Tym, czego nie daje żadna premiera modelu, jest reszta pracy: nagrać godzinę dźwięku bez utraty, rozdzielić mówiących, tłumaczyć na żywo na 15 języków i zostawić notatki, które w przyszłym kwartale nadal da się przeszukać.
Źródła
- Strona modelu
stealth/ox-alphana OpenRouterze — data wpisu 20 sierpnia 2026 roku, kontekst miliona tokenów i dopisana informacja potwierdzająca ZAI GLM-5.3-Flash; pobrano 31 sierpnia 2026 roku - Strona modelu
z-ai/glm-5.3-flashna OpenRouterze — aktualne ceny i okno rabatu promocyjnego do 9 września 2026 roku; pobrano 31 sierpnia 2026 roku - Karta modelu na Hugging Face, zai-org/GLM-5.3-Flash — 320 mld parametrów łącznie / 18 mld aktywnych, multimodalny korpus 30 bilionów tokenów, licencja MIT, poziomy
reasoning_efforti sformułowanie o zbliżaniu się do Claude Opus 4.8 - Anonimowy Ox Alpha przetwarza 26 bilionów tokenów na OpenCode i bije rekord premiery OpenRoutera — RuntimeWire, 26 sierpnia 2026 — 26 bilionów tokenów, 327 000 użytkowników, 8 328 244 sesje, wskaźnik 93 procent z pamięci podręcznej i rekord OpenRoutera 11,6 biliona tokenów
- Użycie, specyfikacja i poszlaki co do tożsamości Ox Alpha — LLM Rumors, 25 sierpnia 2026 — dzienne liczby zapytań i pierwsze miejsce wśród 558 modeli
- Ukryty model klasy frontierowej Ox Alpha pojawia się za darmo na OpenRouterze i w OpenCode — WinBuzzer, 24 sierpnia 2026 — deklaracja przepustowości 100 bilionów tokenów dziennie i szacunek GPU autorstwa Teortaxes
- Chińskie Z.AI stworzyło ukryty model Ox Alpha rywalizujący z DeepSeek — Bloomberg via Yahoo Finance, 26 sierpnia 2026 — potwierdzenie tożsamości z pierwszej ręki
- Ukryty model, który pokonał DeepSeek, należy do Zhipu — The Next Web — relacja z ujawnienia i zobowiązanie do otwartych wag
- Ukryte modele OpenRoutera: kim się okazały — Digital Applied, 22 sierpnia 2026 — spis czternastu wpisów, daty ujawnień, poziomy dowodów i porównanie warunków przetwarzania danych
- Artificial Analysis: analiza inteligencji, wydajności i ceny GLM-5.3-Flash — Intelligence Index 57, koszt ewaluacji 138,02 dolara, 45 tokenów na sekundę, 150 mln wygenerowanych tokenów; pobrano 31 sierpnia 2026 roku
- Epoch AI, „LLM inference prices have fallen rapidly but unequally across tasks", 12 marca 2025 — drabina cenowa o stałym progu stojąca za liczbą 208 razy
- Nasze porównanie przed i po dotyczące powrotu modeli lokalnych — liczby Qwen3.8-27B, krzywa cenowa i opóźnienie doganiania