이름 없는 모델이 나흘 만에 26조 토큰을 태웠습니다. 가격표는 나중에 붙었죠. 24센트.
2026년 8월 20일, 소속도 모델 카드도 가격도 없는 모델이 OpenRouter에 stealth/ox-alpha라는 이름으로 등장했습니다. 나흘 뒤 OpenCode 사용자들이 이 모델로 26조 토큰을 처리했고, 엿새 뒤 Z.AI가 정체를 밝혔습니다. GLM-5.3-Flash, 총 파라미터 320B, MIT 라이선스, 입력 100만 토큰당 0.15달러. 왜 요즘 연구소들은 자기 이름을 떼고 모델을 내놓는지, 그 트래픽 수치가 실제로 무엇을 측정한 것인지, 그리고 블렌디드 24센트가 음성 파이프라인 경제학에 무엇을 하는지 정리했습니다.
2026년 8월 20일, stealth/ox-alpha라는 슬러그를 달고 모델 하나가 OpenRouter에 나타났습니다. 붙어 있는 연구소 이름이 없었습니다. 모델 카드도, 벤치마크 표도, 공지 스레드도 없었습니다. 가격란에는 입력 0달러, 출력 0달러라고 적혀 있었죠. 대신 있는 것은 1,048,576 토큰짜리 컨텍스트 창, 텍스트와 이미지와 비디오 입력, 그리고 장기 소프트웨어 엔지니어링에 관한 한 줄짜리 설명이었습니다.
나흘 뒤, OpenCode는 자사 사용자들이 이 모델로 26조 토큰을 처리했다고 밝혔습니다.
엿새 뒤, Z.AI가 블룸버그에 이 모델이 자사 것이라고 확인했고, MIT 라이선스로 가중치를 공개했으며, 가격표를 붙였습니다. 입력 100만 토큰당 15센트, 출력 100만 토큰당 50센트. 이름은 GLM-5.3-Flash였습니다. 이 문장에서 "Flash"라는 단어가 엄청난 일을 하고 있고, 그것이 이 글을 쓰는 이유입니다.
이 글은 출시 소식이 아니라 논평입니다. 아래에서 다루는 것은 트래픽 수치와 거기 붙어야 할 단서가 포함된 엿새간의 타임라인, 왜 연구소들이 점점 아무 이름도 붙이지 않은 모델을 내놓는지에 대한 논증, 정체가 밝혀진 지금의 사양과 독립 평가 점수, 저희가 검증하지 못한 주장들의 명시적 목록, 그리고 블렌디드 24센트가 음성 파이프라인 비용에 무엇을 하는지에 대한 계산입니다. 로컬 모델의 반격을 다룬 비교 글의 직접적인 후속편이고, 결론이 향하는 방향도 같습니다. 유능한 기계 지능의 가격은 여전히 떨어지고 있고, 대부분의 제품 로드맵이 가정하는 것보다 빠릅니다.
요약:
- 트래픽은 실제였고 기록이었습니다. 나흘간 OpenCode에서 26조 토큰, 순 사용자 327,000명. OpenRouter에서는 사흘간 11.6조 토큰으로, 종전 최고치 4.4조를 넘어선 이 플랫폼 역사상 최대 규모의 모델 출시였습니다.
- 정체는 1차 출처로 확인됐습니다. Z.AI는 2026년 8월 26일 블룸버그에 Ox Alpha가 GLM 계열 모델이라고 밝혔고, OpenRouter 페이지에도 이 스텔스 모델이 "ZAI가 개발하고 운영했으며 ZAI GLM-5.3-Flash로 밝혀졌다"고 적혔습니다.
- 핵심은 가격입니다. 총 320B / 활성 18B 파라미터, MIT 라이선스, 100만 토큰당 입력 0.15달러 출력 0.50달러. 블렌디드로 0.24달러입니다. Artificial Analysis 인텔리전스 지수에서 이 모델보다 12.1점 낮은 반년 전 비공개 플래그십은 블렌디드 10.00달러였습니다.
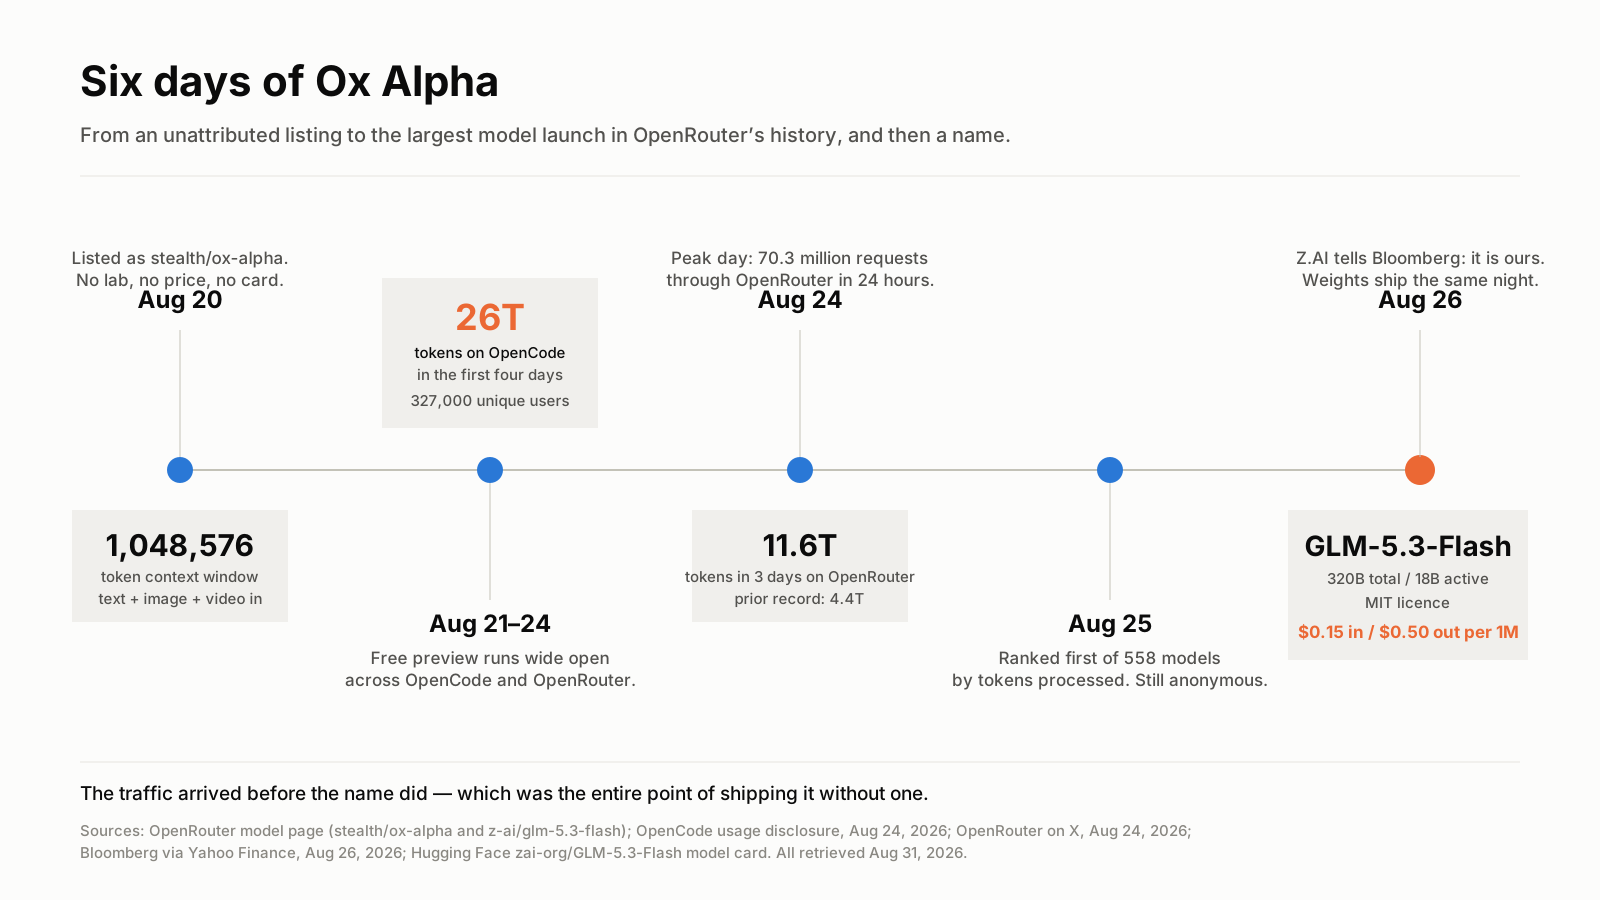
처음부터 끝까지 일주일이 걸리지 않았습니다. 출처는 글 말미에 정리했습니다.
엿새 동안 벌어진 일을 순서대로
8월 20일. OpenRouter에 등록되는 동시에, Dax Raad이 만든 오픈소스 터미널 코딩 에이전트 OpenCode 안에서도 사용할 수 있게 됐습니다. OpenCode는 이 모델을 무료, 사실상 무제한, 자사 경로를 통한 데이터 미보존으로 안내했고, 하루 최대 100조 토큰 규모의 용량을 확보했다고 밝혔습니다.
8월 21일부터 24일까지. 사용량이 하루도 빠짐없이 올랐습니다. OpenRouter의 모델 활동 엔드포인트 기준으로 8월 21일 2,700만 건, 8월 22일 5,440만 건(전일 대비 101.2% 증가), 8월 23일 6,390만 건, 8월 24일 7,030만 건이었습니다.
8월 24일. OpenCode가 수치를 공개합니다. 나흘간 26조 토큰, 순 사용자 327,000명, 완료된 세션 8,328,244건. 세션당 평균 320만 토큰, 사용자당 약 25세션입니다. 이 수치로 Ox Alpha는 OpenCode가 추적하는 모델 중 2위에 올랐습니다. 1위는 33조 토큰의 DeepSeek V4 Flash, 3위는 12조 토큰의 샤오미 MiMo-V2.5였습니다. OpenRouter는 별도로 첫 사흘간 11.6조 토큰을 기록했다고 밝히며 플랫폼 역사상 최대 규모의 모델 출시라고 표현했습니다. 같은 기간 종전 기록은 4.4조 토큰이었습니다.
8월 25일. 최근 일주일간 처리 토큰 기준으로 정렬한 OpenRouter 모델 API에서 Ox Alpha가 558개 모델 중 1위에 오릅니다. 이 시점까지도 연구소 밖 누구도 만든 주체를 몰랐습니다.
8월 26일. Z.AI가 블룸버그에 Ox Alpha가 자사 GLM 계열의 신규 모델이라고 확인합니다. 가중치는 같은 날 밤 공개됐습니다. 회사 자체 공개 글에는 사용자 피드백을 모으기 위해 GLM-5.3-Flash를 OpenCode와 OpenRouter에서 ox-alpha라는 이름으로 익명 테스트했다고 적혀 있습니다. OpenRouter 스텔스 페이지도 이 모델이 "ZAI가 개발하고 운영했으며 ZAI GLM-5.3-Flash로 밝혀졌다"고 수정됐습니다.
트래픽 수치는 진짜다. 다만 품질 판정은 아니다
여기서 대부분의 보도가 어긋났습니다. 26조 토큰이 정확히 무엇을 측정한 것인지 짚고 갑시다.
이 수치는 100만 토큰짜리 창을 가진 무료 엔드포인트의 처리량이고, 소비의 대부분은 코딩 에이전트가 했습니다. OpenCode 자체 대시보드에 따르면 입력 토큰의 93%가 캐시에서 제공됐습니다. 긴 세션 동안 같은 저장소 컨텍스트를 반복해서 다시 읽었다는 뜻이죠. 처리 토큰 수로 정렬하는 랭킹은 무료이면서 창이 큰 모델에게 엄청난 기계적 유리함을 줍니다. 에이전트 하네스는 컨텍스트를 다시 집어넣고, 실패한 도구 호출을 재시도하고, 도구 출력을 프롬프트로 되돌려 보내니까요. 세션이 길수록 숫자는 설계상 부풀려집니다.
하루 100조 토큰이라는 수치도 같은 취급이 필요합니다. 그건 OpenCode가 밝힌 총 서비스 용량이지, 실제로 전달된 사용량도 아니고 사용자 1인당 할당량도 아닙니다. 실제 사용량은 첫 나흘간 하루 평균 약 6.5조 토큰으로, 공표된 상한의 6.5% 수준이었습니다. 분석가 Teortaxes는 초당 80토큰 기준으로 하루 100조 개의 출력 토큰을 생성하려면 GPU 약 580,000장에 해당하는 자원이 필요하다고 지적했습니다. 바로 이런 숫자야말로 옮겨 적기 전에 무엇을 세고 있는지 되물어야 하는 종류입니다.
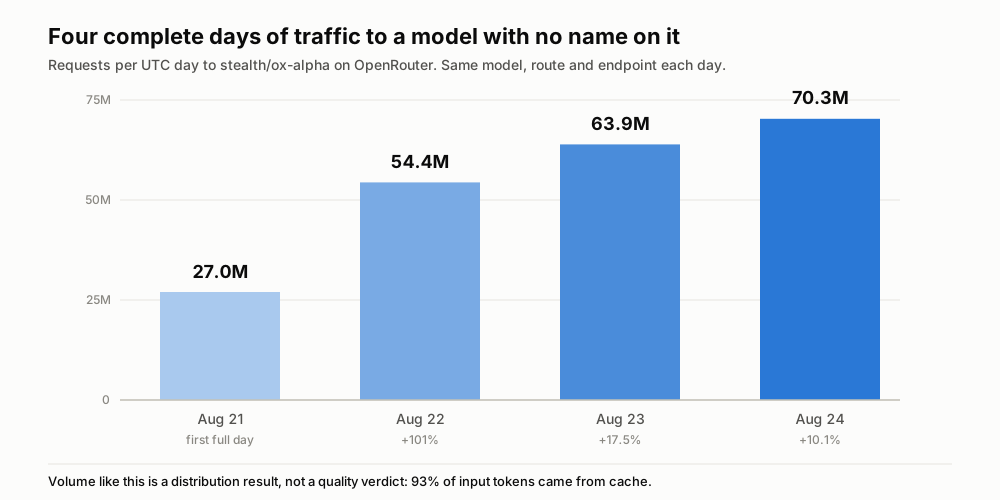
OpenRouter 모델 활동 엔드포인트의 일별 요청 수. 2026년 8월 25일 캐시 스냅샷 기준이며, 플랫폼에 의해 수치가 조정될 수 있습니다.
그렇다면 이 트래픽이 실제로 증명하는 건 무엇일까요. 100만 토큰 창을 가진 무료 프런티어급 모델을 코딩 에이전트가 이미 살고 있는 두 곳에 떨어뜨리면 24시간 안에 수요가 포화된다는 사실입니다. 이건 유통의 결과이고, 유통의 결과는 그 자체로 연구할 가치가 있습니다. 다만 이 모델이 여러분의 저장소에서 좋은지에 대해서는 아무것도 말해주지 않습니다.
연구소가 자기 이름을 떼고 모델을 내놓는 이유
여기서 관점이 바뀝니다. 위쪽은 측정이고, 아래쪽은 저희의 해석입니다.
익명 출시는 연구소에 다른 방법으로는 살 수 없는 세 가지를 사줍니다. 이 조합을 익명성 배당금이라고 부르겠습니다.
첫째는 깨끗한 평가입니다. 이름이 붙은 모든 출시는 선입견 안에 도착합니다. 중국 연구소의 모델은 "오픈 모델치고 놀랍네"라는 기준으로 채점되고, 미국 프런티어 연구소의 모델은 "가격 인상만큼의 값을 하나"라는 기준으로 채점되죠. 이름을 떼면 개발자가 반응할 대상은 출력밖에 남지 않습니다. 스텔스 기간에 돌아온 평가들은 누구의 모델을 칭찬하는지 전혀 모르는 사람들이 수행한 것이었습니다. AI 마케팅에서 인위적으로 만들어내기 가장 비싼 것이자, 그냥 말하지 않음으로써 가장 싸게 얻을 수 있는 것입니다.
둘째는 플라이휠입니다. 미스터리 자체가 캠페인입니다. 평범한 버전 업데이트에 대해 포렌식 블로그 글을 쓰는 사람은 없지만, 일주일간의 토크나이저 지문 분석과 서빙 계층 분석과 추측은 연구소가 돈 주고 사지 않은 막대한 양의 보도를 만들어냅니다. 그리고 정체 공개는 이미 답에 몰입한 청중 위로 떨어집니다. Z.AI는 일주일치 무료 관심을 얻은 다음, 반전이 내장된 출시일을 맞았습니다.
셋째는 돈으로 쉽게 살 수 없는 규모의 텔레메트리입니다. 실제로 지저분하고 프로덕션에 가까운 작업으로 이루어진 830만 건의 완료 에이전트 세션은 하나의 데이터셋입니다. Ox Alpha의 OpenRouter 페이지에는 프롬프트와 완성이 제공자에 의해 보존되지만 학습에는 사용되지 않는다고 적혀 있었습니다. 이 점은 잠시 뒤에 다시 다루겠습니다. 그러나 보존만으로도 수십만 개의 실제 저장소에 걸친 실패 양상, 지연 분포, 도구 호출 오류율, 장기 컨텍스트 열화 곡선을 얻을 수 있습니다. 사내 평가 스위트로는 나오지 않는 것들이죠.
이 데이터 약관 문구는 따로 언급할 가치가 있습니다. 이 이야기에서 유일하게 정말로 이례적인 부분이거든요. OpenRouter가 2025년 4월 이후 운영한 14개의 스텔스 등록 중 13개는 "프롬프트와 완성은 제공자가 기록하며 모델 개선에 사용될 수 있다"는 취지의 문구를 달고 있었습니다. Ox Alpha만이 보존하되 학습에는 쓰지 않는다고 적었습니다. 이걸 안심할 근거로 볼지는 라우팅 플랫폼의 모델 페이지에 적힌 한 줄에 얼마나 무게를 두느냐에 달려 있습니다. 최소한 의도적인 선택이고, 스텔스 등록에서 처음 있는 일입니다.
코드네임은 이제 하나의 장르가 됐다
새로운 수법이 아닙니다. 1차 출처로 확인된 사례가 다섯 건 쌓인 패턴이고, 그 이력을 알아야 다음 것을 제대로 가늠할 수 있습니다.
| 코드네임 | 실제 정체 | 확인 주체 | 날짜 | 근거 |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, OpenAI 사전 공개 스냅샷 | OpenRouter 자체 블로그 | 2025-04-14 | 1차 출처 |
| Optimus Alpha | GPT-4.1, 최종본에 더 가까운 스냅샷 | OpenRouter 자체 블로그 | 2025-04-14 | 1차 출처 |
| Horizon Alpha / Horizon Beta | 초기 GPT-5 체크포인트 | OpenRouter, "GPT-5 is now live" | 2025-08-07 | 1차 출처 |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, 비추론형과 추론형 | 커뮤니티 추론뿐 | — | 보도, 미확인 |
| Hunter Alpha / Healer Alpha | 샤오미 MiMo | 샤오미 MiMo 팀 | 2026-03-18 | 1차 출처 |
| Owl Alpha | 메이퇀 LongCat-2.0-Preview | 메이퇀 블로그와 @Meituan_LongCat | 2026-06-30 | 1차 출처 |
| Cypher Alpha / Aurora Alpha | 끝내 밝혀지지 않음 | — | — | 없음 |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI가 블룸버그에 확인, OpenRouter 페이지 수정 | 2026-08-26 | 1차 출처 |
이 표에서 두 가지가 나옵니다. 과거 13개 등록 중 7개가 결국 1차 출처의 확인을 받았습니다. 통념보다 훨씬 나은 해소율이죠. 그리고 그중 세 건의 확인은 OpenRouter가 아니라 연구소에서 나왔습니다. OpenRouter 블로그만 지켜보는 집계가 계속 과소 계산하는 이유입니다. 또 하나, 장르의 무대가 옮겨갔습니다. 2025년 행은 OpenAI와 xAI입니다. 2026년 행은 샤오미, 메이퇀, Z.AI입니다. 중국 연구소들이 스텔스 출시를 발명한 건 아니지만, 산업화한 건 그들입니다.
공개된 사양: 총 320B, 활성 18B, MIT
이제 사양입니다. 누군가의 요약이 아니라 Z.AI 자체 모델 카드에서 가져왔습니다.
GLM-5.3-Flash는 저자들 표현으로 "GLM-5 계열 최초의 네이티브 멀티모달 모델"이며, 총 3,200억 파라미터에 활성 파라미터는 180억인 전문가 혼합 구성입니다. 30조 토큰 규모의 멀티모달 코퍼스로 학습했습니다. 아키텍처는 이 계열에서 처음으로 희소 어텐션과 선형 어텐션을 결합했고, 논문이 Manifold-Constrained Hyper-Connections라고 부르는 기법을 함께 씁니다. 컨텍스트 창은 1,048,576 토큰, 단일 응답 최대 길이는 131,072 토큰입니다. 추론 깊이는 reasoning_effort 파라미터로 노출되며 low, high, max 세 단계가 있고 기본값은 max입니다. 라이선스는 MIT입니다. 사용자 수 조항이 달린 별도 커뮤니티 라이선스가 아니라, 그냥 MIT입니다.
Z.AI 자체의 성능 주장은 정확히 인용할 가치가 있습니다. 주변 보도보다 훨씬 절제되어 있거든요. 이 모델은 "10분의 1 가격으로 벤치마크와 실제 워크로드 전반에서 GLM-5.2를 능가하며, 코딩과 에이전트 벤치마크에서 Claude Opus 4.8에 근접한다"고 되어 있습니다. 근접한다는 것이지, 이긴다는 게 아닙니다.
독립적인 판정으로는 Artificial Analysis가 이미 측정을 마쳤습니다. GLM-5.3-Flash는 Artificial Analysis 인텔리전스 지수에서 57점을 기록했고, 비교 가능한 오픈 웨이트 모델의 중앙값은 29점입니다. 그 전체 평가 스위트를 돌리는 데 든 API 비용은 138.02달러였습니다. 이 글 전체에서 프런티어에 준하는 지능을 쓰는 데 실제로 얼마가 드는지를 가장 정직하게 보여주는 단일 수치라 인용합니다. 같은 평가는 실제 약점 두 가지도 짚습니다. 출력 속도가 초당 45토큰으로 느리고, 지수를 완주하며 1억 5,000만 토큰을 생성해 중앙값 1억 1,000만 토큰보다 장황합니다. 토큰당 가격이 작아도 장황함은 청구서입니다.
진짜 뉴스는 Flash 등급 모델이 57점을 받았다는 것
Epoch AI가 가격 비교에 쓰는 3:1 입출력 블렌딩 기준으로 나란히 놓아 봅시다.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| 공개일 | 2026-02-05 | 2026-08-14 | 2026-08-26 |
| 가중치 | 비공개 | Apache 2.0 | MIT |
| 인텔리전스 지수 | 44.9 | 52.0 | 57 |
| 입력 100만 토큰당 | $5.00 | $0.45 | $0.15 |
| 출력 100만 토큰당 | $25.00 | $3.20 | $0.50 |
| 블렌디드 (3:1) | $10.00 | $1.09 | $0.24 |
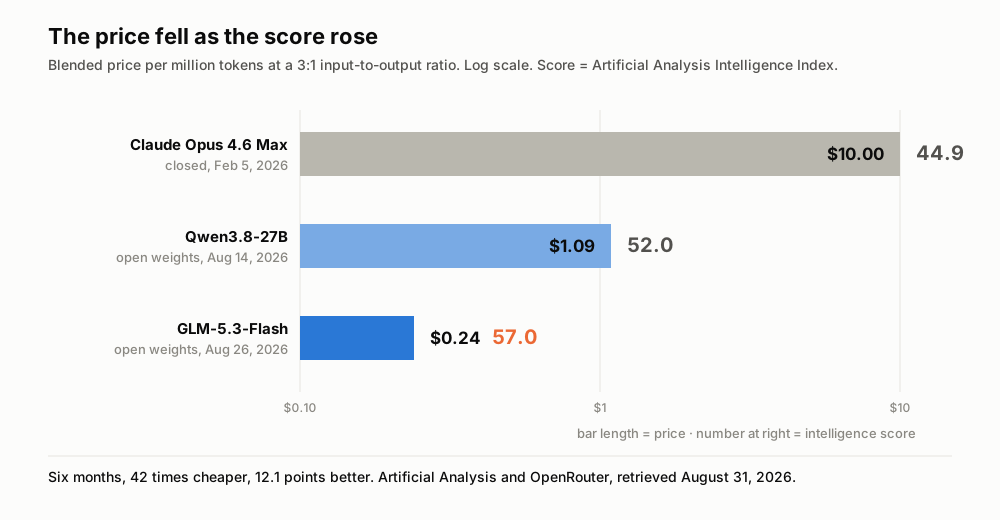
막대 길이는 가격이고, 각 막대 오른쪽 숫자는 지능 점수입니다. Artificial Analysis와 OpenRouter, 2026년 8월 31일 조회.
GLM-5.3-Flash는 2월의 비공개 플래그십보다 42배 싸고, 같은 독립 지수에서 12.1점 높습니다. 열흘 전에 다룬 오픈 27B와 비교하면 4.6배 싸고 5점 높습니다. 두 격차 모두 반년 안에 벌어졌습니다.
Qwen3.8 글이 반대편 끝에서 측정한 것과 같은 곡선입니다. 벤치마크 점수를 고정한 채 그 점수에 도달하는 가장 싼 모델을 추적한 Epoch AI의 고정 임계값 시계열은, GPT-4 수준 성능의 가격이 2023년 3월 100만 토큰당 37.50달러에서 2025년 2월 0.18달러로 떨어졌음을 보여줬습니다. 23개월 만에 208배입니다. GLM-5.3-Flash는 그 곡선이 3년 전 프런티어가 아니라 지금 프런티어에 도달했을 때의 모습입니다.
그리고 등급을 보세요. 이건 플래그십이 아닙니다. 어느 연구소의 작명법에서든 "Flash"는 정작 감탄시키고 싶은 모델의 값싸고 빠른 대량 처리용 형제를 뜻합니다. 흥미로운 사실은 중국 연구소가 강한 모델을 냈다는 게 아닙니다. 보급형 SKU가 이제 프런티어에 충분히 가까워서, 일주일간의 익명 정면 테스트로도 정체가 바로 드러나지 않았다는 것입니다.
검증하지 못한 네 가지, 그대로 표시합니다
이 출시를 둘러싼 열기는 특정 지점에서 근거를 앞질렀습니다. 그 지점들을 짚습니다.
Ox Alpha가 100만 토큰 컨텍스트 테스트에서 "GPT-5.6을 넘어선다"는 주장은 제3자 기사에서 나온 것이고, 저희가 들여다볼 수 있는 공개된 방법론은 없었습니다. Z.AI 자체의 비교 대상은 GPT-5.6이 아니라 Claude Opus 4.8입니다. GPT-5.6 비교는 미검증 커뮤니티 주장으로 취급하십시오.
널리 인용되는 DeepSWE pass@1 80%라는 점수는, 같은 표의 옆 칸에 놓이곤 하는 SWE-bench Verified 96% 이상의 수치와 비교 가능한 값이 아닙니다. 하네스가 다르고, 과제 집합이 다르고, 난이도가 다릅니다. 둘을 인접한 행에 놓는 표는 존재하지 않는 순위를 만들어내는 것입니다.
스텔스 기간 전체를 중국산 가속기로 서빙했으며 종단 간 서빙 성능이 3배 개선됐고 토큰당 비용이 엔비디아 하드웨어와 비슷하다는 Z.AI의 주장은 회사 발표이고 독립 감사를 받지 않았습니다. 사실로 확인된다면 이 이야기에서 가장 중대한 대목이지만, 지금은 보도자료상의 주장입니다.
그리고 무료 프리뷰는 요금제가 아니라 보조금이었고, 이미 끝났습니다. 현재 가격은 0.15달러와 0.50달러이며 2026년 9월 9일 16:00 UTC까지 50% 프로모션 할인이 적용됩니다. 즉 정직한 정상 가격은 할인 전 숫자이고, 예산은 이번 주 가격이 아니라 0.15달러 / 0.50달러 기준으로 잡아야 합니다.
듣고 번역하고 요약하는 파이프라인에서 24센트가 하는 일
음성 제품은 토큰 가격에 유난히 취약합니다. 전사본을 만들고 나서 그것을 반복해서 읽기 때문이죠. 정제, 번역, 요약, 질의응답 등 모든 후속 단계가 같은 텍스트를 다시 집어넣습니다. 가정을 전부 드러낸 계산은 이렇습니다.
- 실제 작업 단위에서 출발합니다. 분당 약 130단어로 진행된 2인 60분 회의는 약 7,800단어가 나옵니다. 화자 라벨과 타임스탬프까지 더하면 전사본은 12,000토큰으로 잡습니다.
- 요약 패스를 더합니다. 전사본 전체를 넣고 구조화된 노트를 받습니다. 입력 12,000토큰, 출력 약 800토큰.
- 3개 언어 실시간 번역을 더합니다. 각 패스가 전사본을 읽고 비슷한 분량을 씁니다. 입력 12,000, 출력 12,000을 세 번.
- 회의 전체를 합산합니다. 입력 48,000토큰, 출력 36,800토큰.
- 두 번 가격을 매깁니다. GLM-5.3-Flash의 0.15달러 / 0.50달러 기준으로 이 회의는 2.6센트입니다. Claude Opus 4.6의 5.00달러 / 25.00달러 기준으로는 같은 회의가 1.16달러입니다.
오디오 한 시간에 45배 차이는 항목 하나를 최적화하는 수준의 이야기가 아닙니다. 조심스럽게 사용량을 재는 기능이냐, 기본으로 켜두는 기능이냐의 차이입니다. 회의당 1.16달러라면 모든 사용자에게 3개 언어 번역을 제공하는 건 재무 담당자의 승인이 필요한 결정입니다. 2.6센트라면 체크박스 하나입니다.
코드네임보다 오래 남을 대목이 바로 이것입니다. 스텔스 출시는 마케팅 수법이었고, 좋은 수법이었습니다. 지속되는 사실은 중견 연구소 라인업의 저가 등급이 이제 블렌디드 24센트에 57점을 내놓는다는 것, 그리고 가격이 나중에 잘못된 방향으로 움직여도 직접 돌릴 수 있도록 MIT 라이선스가 붙어 있다는 것입니다.
결론: 흥미로운 가격은 더 이상 프런티어에 있지 않다
3년 동안 모델 선택의 질문은 "프런티어에 얼마나 가까이 갈 여유가 있는가"였습니다. Ox Alpha의 엿새는 다른 질문에 답했습니다. 지금 플래그십 등급 아래에 얼마나 많은 성능이 상품 가격으로 놓여 있으며, 연구소들이 자기 이름을 떼고 시험해도 될 만큼 자신 있는가.
익명성 배당금은 모델이 브랜드 없는 일주일을 견딜 만큼 좋아야만 지급됩니다. Z.AI는 받아냈습니다. 다음번에 라우팅 플랫폼에 나타날 코드네임도 Ox Alpha와 똑같이 대해야 합니다. 누구 것인지 알려주기 전에 여러분의 과제로 직접 돌려보세요. 그 일주일이야말로 누구에게든 주어지는 유일하게 정직한 평가이기 때문입니다.
Telli.sh는 어디에 있나: 이 곡선이 바로 저희가 음성 파이프라인을 한 벤더의 API가 아니라 엔진 프로바이더 계층 위에 짓는 이유입니다. Telli.sh는 전사, 번역, 요약을 교체 가능한 엔진으로 라우팅합니다. 그래서 이번 같은 가격 곡선의 한 계단은 가격 공지가 아니라 같은 값에 더 나은 노트로 도착합니다. 어떤 모델 출시도 대신해주지 않는 나머지 일은 따로 있습니다. 한 시간짜리 오디오를 끊기지 않게 담아내고, 화자를 구분하고, 15개 언어로 실시간 번역하고, 다음 분기에도 검색할 수 있는 노트를 남기는 일입니다.
출처
- OpenRouter
stealth/ox-alpha모델 페이지 — 2026년 8월 20일 등록일, 100만 토큰 컨텍스트, ZAI GLM-5.3-Flash 확인 문구. 2026년 8월 31일 조회 - OpenRouter
z-ai/glm-5.3-flash모델 페이지 — 현재 가격과 2026년 9월 9일까지의 프로모션 할인 기간. 2026년 8월 31일 조회 - Hugging Face 모델 카드, zai-org/GLM-5.3-Flash — 총 320B / 활성 18B 파라미터, 30조 토큰 멀티모달 코퍼스, MIT 라이선스,
reasoning_effort설정, Claude Opus 4.8에 근접한다는 표현 - 익명의 Ox Alpha, OpenCode에서 26조 토큰 처리하며 OpenRouter 출시 기록 경신 — RuntimeWire, 2026년 8월 26일 — 26조 토큰, 327,000명, 8,328,244세션, 93% 캐시 수치, OpenRouter의 11.6조 토큰 기록
- Ox Alpha 사용량, 사양, 정체 관련 정황 — LLM Rumors, 2026년 8월 25일 — 일별 요청 수와 558개 모델 중 1위 순위
- 프런티어급 스텔스 모델 Ox Alpha, OpenRouter와 OpenCode에 무료로 등장 — WinBuzzer, 2026년 8월 24일 — 하루 100조 토큰 용량 주장과 Teortaxes의 GPU 추정
- 중국 Z.AI가 DeepSeek에 필적하는 스텔스 모델 Ox Alpha를 만들었다 — 블룸버그, 야후 파이낸스 경유, 2026년 8월 26일 — 1차 출처 정체 확인
- DeepSeek을 이긴 스텔스 모델은 Zhipu의 것이다 — The Next Web — 공개 보도와 오픈 웨이트 약속
- OpenRouter 스텔스 모델의 실제 정체 — Digital Applied, 2026년 8월 22일 — 14개 등록 전수, 공개 날짜, 근거 등급, 데이터 약관 비교
- Artificial Analysis: GLM-5.3-Flash 지능, 성능, 가격 분석 — 인텔리전스 지수 57, 평가 비용 138.02달러, 초당 45토큰, 1억 5,000만 토큰 생성. 2026년 8월 31일 조회
- Epoch AI, "LLM inference prices have fallen rapidly but unequally across tasks", 2025년 3월 12일 — 208배 수치의 근거가 된 고정 임계값 가격 사다리
- 로컬 모델의 반격을 다룬 비교 글 — Qwen3.8-27B 수치, 가격 곡선, 추격 시차