Un modelo anónimo quemó 26 billones de tokens en cuatro días. La lista de precios llegó después: 24 centavos.
El 20 de agosto de 2026 apareció en OpenRouter un modelo sin laboratorio, sin ficha técnica y sin precio, bajo el nombre stealth/ox-alpha. Cuatro días después, los usuarios de OpenCode habían empujado 26 billones de tokens a través de él. Seis días después, Z.AI lo reclamó como suyo: GLM-5.3-Flash, 320.000 millones de parámetros, licencia MIT, 0,15 dólares por millón de tokens de entrada. Por qué los laboratorios publican ya modelos sin su propio nombre, qué miden realmente esas cifras de tráfico y qué supone un precio mezclado de 24 centavos para la economía de las canalizaciones de voz.
El 20 de agosto de 2026 apareció en OpenRouter un modelo bajo el identificador stealth/ox-alpha. No tenía laboratorio asociado. Ni ficha técnica, ni tabla de benchmarks, ni hilo de anuncio. El campo de precio decía 0 dólares de entrada, 0 dólares de salida. Lo que sí tenía era una ventana de contexto de 1.048.576 tokens, entrada de texto, imagen y vídeo, y una descripción de una línea sobre ingeniería de software de largo recorrido.
Cuatro días después, OpenCode informó de que sus usuarios habían empujado 26 billones de tokens a través de él.
Seis días después, Z.AI confirmó a Bloomberg que el modelo era suyo, publicó los pesos bajo licencia MIT y le puso una lista de precios: quince centavos por millón de tokens de entrada, cincuenta centavos por millón de salida. El nombre era GLM-5.3-Flash. La palabra «Flash» está haciendo un trabajo enorme en esa frase, y es la razón por la que escribimos este artículo.
Esto es un comentario, no una crónica de lanzamiento. Lo que sigue es la cronología de los seis días con sus cifras de tráfico y sus matices, un argumento sobre por qué los laboratorios publican cada vez más modelos sin el nombre de nadie encima, las especificaciones y puntuaciones independientes ahora que se conoce la identidad, una lista explícita de las afirmaciones que no hemos podido verificar y un cálculo detallado de lo que un precio mezclado de 24 centavos hace al coste de procesar voz. Es la secuela directa de nuestro antes y después sobre el regreso de los modelos locales, y apunta en la misma dirección: el precio de una inteligencia mecánica competente sigue cayendo, más rápido de lo que asumen la mayoría de las hojas de ruta de producto.
Resumen:
- El tráfico fue real y récord. 26 billones de tokens en OpenCode en cuatro días, con 327.000 usuarios únicos, y 11,6 billones en OpenRouter en tres días: el mayor lanzamiento de modelo de la historia de OpenRouter, frente a un récord anterior de 4,4 billones.
- La identidad está confirmada por fuente primaria. Z.AI declaró a Bloomberg el 26 de agosto de 2026 que Ox Alpha era un modelo de la serie GLM; la propia página de OpenRouter indica ahora que el modelo sigiloso «fue desarrollado y operado por ZAI, revelado como ZAI GLM-5.3-Flash».
- El precio es lo importante. 320.000 millones de parámetros totales y 18.000 millones activos, licencia MIT, 0,15 dólares de entrada y 0,50 de salida por millón de tokens: 0,24 dólares mezclados, frente a los 10,00 dólares del buque insignia cerrado de hace seis meses, al que supera por 12,1 puntos en el Intelligence Index de Artificial Analysis.
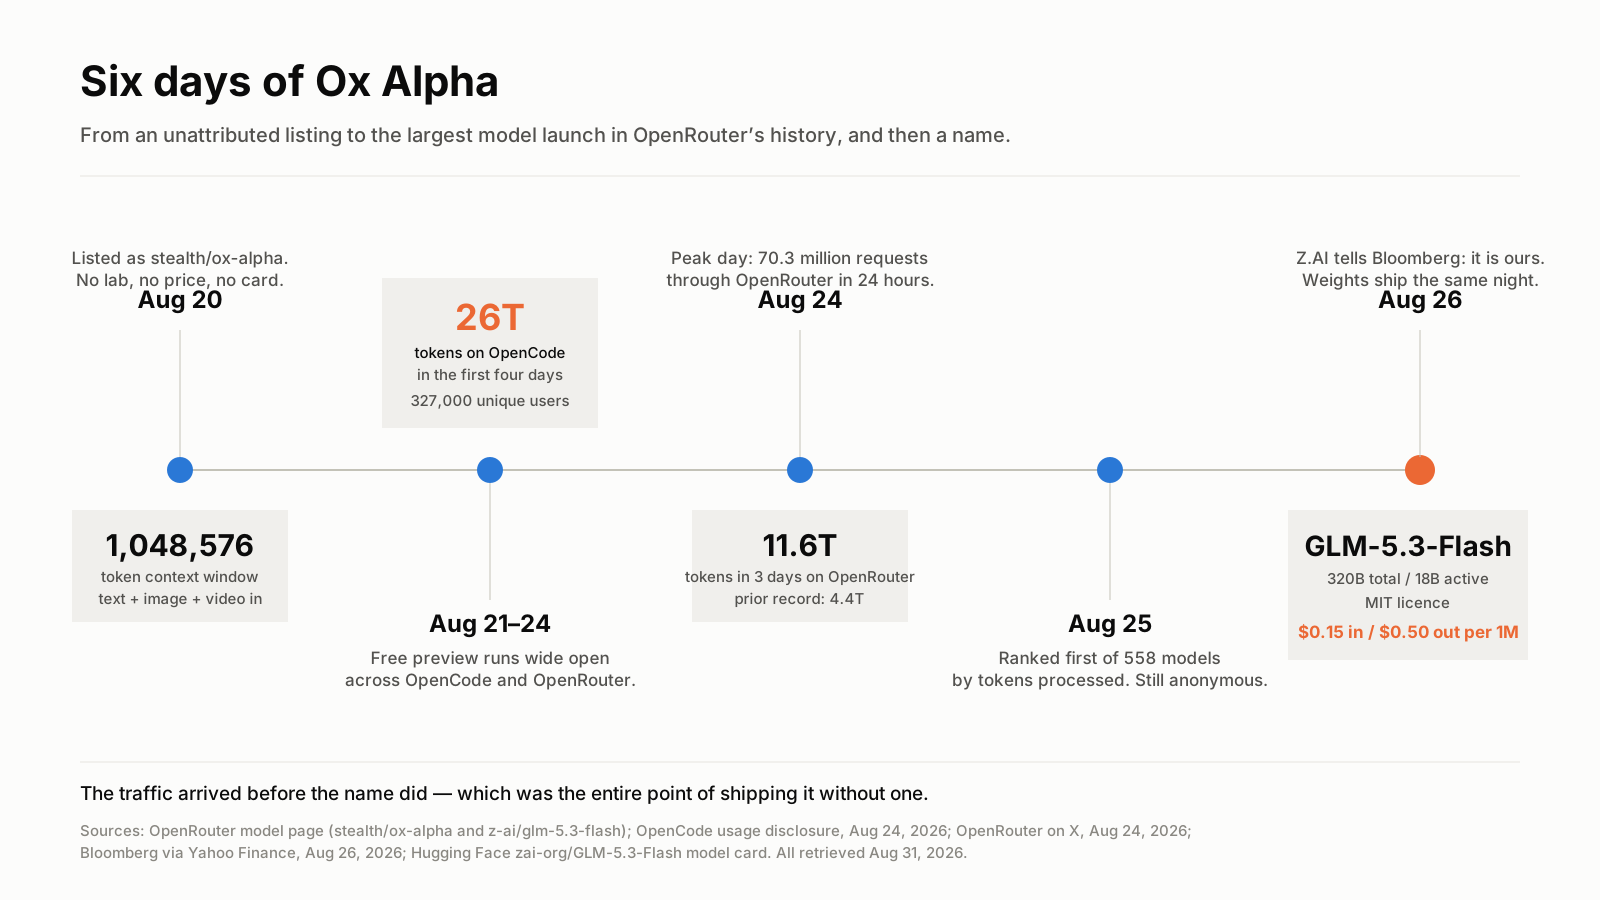
Todo el episodio, de principio a fin, duró menos de una semana. Fuentes al final del artículo.
Seis días, en el orden en que ocurrieron
20 de agosto: la ficha se publica en OpenRouter y simultáneamente dentro de OpenCode, el agente de programación de terminal de código abierto creado por Dax Raad. OpenCode lo anuncia como gratuito, prácticamente sin límite y sin retención de datos por su propia ruta, y afirma haber asegurado capacidad para hasta 100 billones de tokens diarios.
Del 21 al 24 de agosto: el uso sube todos y cada uno de los días. El endpoint de actividad de modelos de OpenRouter registró 27,0 millones de peticiones el 21 de agosto, 54,4 millones el 22 (un 101,2 % más), 63,9 millones el 23 y 70,3 millones el 24.
24 de agosto: OpenCode publica los números. 26 billones de tokens en los cuatro primeros días, con 327.000 usuarios únicos y 8.328.244 sesiones completadas, una media de 3,2 millones de tokens por sesión y unas 25 sesiones por usuario. Eso situó a Ox Alpha en segundo lugar entre los modelos que OpenCode rastrea, por detrás de DeepSeek V4 Flash con 33 billones y por delante del MiMo-V2.5 de Xiaomi con 12 billones. OpenRouter informó por separado de 11,6 billones de tokens en los tres primeros días completos, calificándolo del mayor lanzamiento de modelo de la historia de la plataforma; el anterior poseedor del récord generó 4,4 billones en la misma ventana inicial.
25 de agosto: la API de modelos de OpenRouter, ordenada por tokens procesados en la última semana, coloca a Ox Alpha en primer lugar entre 558 modelos devueltos. Nadie fuera del laboratorio sabe quién lo construyó.
26 de agosto: Z.AI confirma a Bloomberg que Ox Alpha es un nuevo modelo de su serie GLM. Los pesos se publican esa misma noche. El artículo de lanzamiento de la empresa afirma que probaron GLM-5.3-Flash de forma anónima como ox-alpha en OpenCode y OpenRouter «para recoger opiniones de los usuarios», y la página sigilosa de OpenRouter se corrige para indicar que el modelo «fue desarrollado y operado por ZAI, revelado como ZAI GLM-5.3-Flash».
La cifra de tráfico es real. No es un veredicto de calidad.
Aquí es donde se torció la mayor parte de la cobertura, así que seamos precisos sobre qué mide exactamente esa cifra de 26 billones de tokens.
Mide el rendimiento de un endpoint gratuito con una ventana de un millón de tokens, consumido sobre todo por agentes de programación. El propio panel de OpenCode indica que el 93 % de los tokens de entrada se sirvieron desde caché: el mismo contexto de repositorio, releído una y otra vez a lo largo de una sesión larga. Una clasificación ordenada por tokens procesados otorga una ventaja mecánica enorme a cualquier modelo gratuito con una ventana gigantesca, porque los arneses de agentes reinyectan contexto, reintentan llamadas a herramientas fallidas y devuelven la salida de las herramientas al prompt. Las sesiones largas inflan la cifra por diseño.
La cifra de 100 billones de tokens diarios merece el mismo tratamiento. Era OpenCode describiendo capacidad de servicio agregada, no uso entregado ni una asignación por usuario. El uso real promedió unos 6,5 billones de tokens diarios durante los cuatro primeros días: el 6,5 % del techo anunciado. El analista Teortaxes señaló que generar 100 billones de tokens de salida al día a 80 tokens por segundo requeriría unos 580.000 equivalentes de GPU, que es exactamente el tipo de número que debería llevarte a preguntar qué se está contando antes de repetirlo.
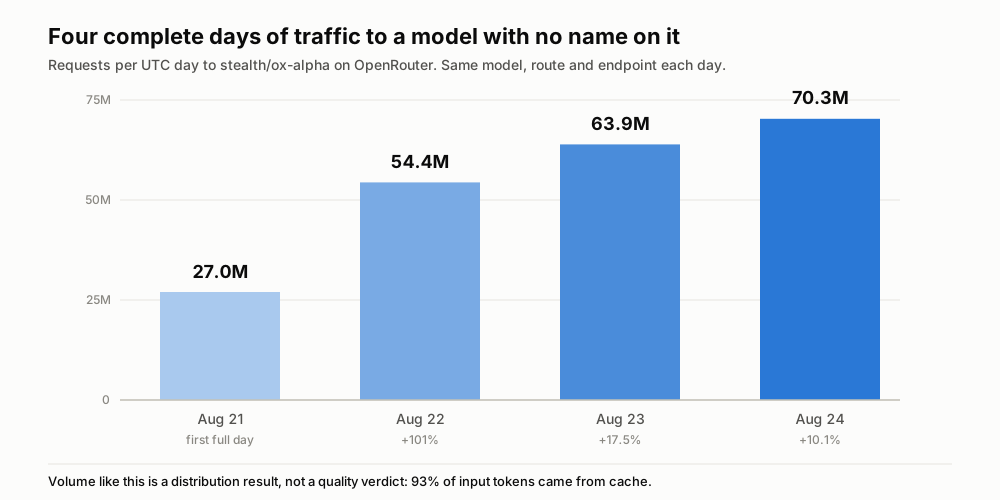
Peticiones diarias según el endpoint de actividad de modelos de OpenRouter, instantánea cacheada el 25 de agosto de 2026. La plataforma puede revisar estos valores.
Entonces, ¿qué demuestra realmente el tráfico? Que un modelo gratuito con forma de frontera y ventana de un millón de tokens, colocado en los dos lugares donde ya viven los agentes de programación, satura la demanda en 24 horas. Es un resultado de distribución, y los resultados de distribución merecen estudiarse por sí mismos. No dice nada sobre si el modelo es bueno en tu repositorio.
Por qué un laboratorio publica hoy un modelo sin su nombre encima
Aquí llega el giro, y lo marcamos con claridad: todo lo anterior es medición; lo que sigue es nuestra lectura.
Publicar de forma anónima le compra a un laboratorio tres cosas que no puede adquirir de ninguna otra manera. Llamemos a esa combinación el dividendo del anonimato.
La primera es una evaluación limpia. Todo lanzamiento con nombre aterriza dentro de un prejuicio. Un modelo de un laboratorio chino se califica contra «sorprendentemente bueno para ser abierto»; uno de un laboratorio frontera estadounidense se califica contra «¿compensa la subida de precio?». Quita el nombre y lo único a lo que puede reaccionar quien desarrolla es a la salida. Las valoraciones que llegaron durante la semana sigilosa las hicieron personas que no tenían ni idea de qué modelo estaban elogiando: lo más caro de fabricar en marketing de IA y lo más barato de obtener simplemente callándose.
La segunda es el volante de inercia. El misterio es la campaña. Nadie escribe un artículo forense sobre una actualización rutinaria de versión, pero una semana de huellas de tokenizador, análisis de la capa de servicio y especulación produce un volumen enorme de cobertura que el laboratorio no tuvo que comprar. La revelación aterriza después sobre una audiencia ya implicada en la respuesta. Z.AI obtuvo una semana de atención gratuita y luego un día de lanzamiento con el remate incorporado.
La tercera es telemetría a una escala que el dinero no compra fácilmente. 8,3 millones de sesiones de agente completadas, de trabajo real, desordenado y con forma de producción, son un conjunto de datos. La página de OpenRouter de Ox Alpha decía que los prompts y las respuestas los retenía el proveedor y explícitamente no se usaban para entrenar —volveremos a ello en un momento—, pero la mera retención ya rinde modos de fallo, distribuciones de latencia, tasas de error en llamadas a herramientas y curvas de degradación con contexto largo a lo largo de cientos de miles de repositorios reales. Eso no se consigue con una suite de evaluación interna.
Esa línea sobre condiciones de datos merece nota propia, porque es lo único genuinamente inusual de esta historia. De las catorce fichas sigilosas que OpenRouter ha operado desde abril de 2025, trece llevaban alguna versión de «los prompts y las respuestas los registra el proveedor y pueden usarse para mejorar el modelo». La de Ox Alpha decía en cambio: retenidos, no usados para entrenar. Que eso te tranquilice depende de cuánto peso le des a una línea de texto en la página de modelo de una plataforma de enrutado. Como mínimo, es una decisión deliberada, y es la primera vez que una ficha sigilosa la toma.
El nombre en clave ya es un género
No es una maniobra novedosa. Es un patrón con cinco confirmaciones de primera mano a sus espaldas, y conocer ese historial es lo que permite calibrar el siguiente caso.
| Nombre en clave | Resultó ser | Confirmado por | Fecha | Evidencia |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, instantánea previa al lanzamiento de OpenAI | El propio blog de OpenRouter | 14/04/2025 | Fuente primaria |
| Optimus Alpha | GPT-4.1, instantánea más cercana a la final | El propio blog de OpenRouter | 14/04/2025 | Fuente primaria |
| Horizon Alpha / Horizon Beta | Checkpoints tempranos de GPT-5 | OpenRouter, «GPT-5 is now live» | 07/08/2025 | Fuente primaria |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, versiones sin y con razonamiento | Solo inferencia de la comunidad | — | Reportado, sin confirmar |
| Hunter Alpha / Healer Alpha | Xiaomi MiMo | El propio equipo MiMo de Xiaomi | 18/03/2026 | Fuente primaria |
| Owl Alpha | Meituan LongCat-2.0-Preview | Blog de Meituan y @Meituan_LongCat | 30/06/2026 | Fuente primaria |
| Cypher Alpha / Aurora Alpha | Nunca resuelto | — | — | Ninguna |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI a Bloomberg; página de OpenRouter corregida | 26/08/2026 | Fuente primaria |
De esa tabla salen dos cosas. Siete de las trece fichas históricas acabaron confirmadas por una declaración de primera mano, una tasa de resolución bastante mejor de lo que sugiere el folclore, y tres de esas confirmaciones vinieron del laboratorio, no de OpenRouter, que es la razón por la que las recopilaciones que solo vigilan el blog de OpenRouter siguen quedándose cortas. Y el género ha cambiado de escenario. Las filas de 2025 son OpenAI y xAI. Las de 2026 son Xiaomi, Meituan y Z.AI. Los laboratorios chinos no inventaron el lanzamiento sigiloso; lo industrializaron.
La revelación: 320.000 millones totales, 18.000 millones activos, MIT
Vamos con las especificaciones, tomadas de la ficha de la propia Z.AI y no del resumen de nadie.
GLM-5.3-Flash es descrito por sus autores como «el primer modelo nativamente multimodal de la serie GLM-5», con 320.000 millones de parámetros totales y 18.000 millones activos en una configuración de mezcla de expertos, entrenado sobre un corpus multimodal de 30 billones de tokens. La arquitectura combina por primera vez en la serie atención dispersa y lineal, más una técnica que el artículo denomina Manifold-Constrained Hyper-Connections. La ventana de contexto es de 1.048.576 tokens, con una respuesta única máxima de 131.072 tokens. La profundidad de razonamiento se expone mediante un parámetro reasoning_effort con los ajustes low, high y max, con max por defecto. La licencia es MIT: no una licencia comunitaria a medida con un umbral de usuarios, sino MIT.
La afirmación de capacidad de la propia Z.AI merece cita literal, porque es más comedida que la cobertura que la rodea: el modelo «supera a GLM-5.2 en benchmarks y cargas de trabajo reales a una décima parte del precio, acercándose a Claude Opus 4.8 en benchmarks de programación y de agentes». Acercándose. No superando.
Para una lectura independiente, Artificial Analysis ya lo ha evaluado. GLM-5.3-Flash obtiene 57 en el Artificial Analysis Intelligence Index, frente a una mediana de 29 entre modelos de pesos abiertos comparables. Ejecutar esa suite completa costó 138,02 dólares de gasto en API, cifra que citamos porque es el dato aislado más honesto de todo este artículo sobre lo que cuesta hoy usar inteligencia cercana a la frontera. La misma evaluación señala dos debilidades reales: a 45 tokens de salida por segundo, el modelo es lento, y generó 150 millones de tokens completando el índice frente a una mediana de 110 millones, lo que lo hace verboso. La verbosidad es una factura aunque el precio por token sea pequeño.
Que un modelo de gama Flash llegue a 57 es la noticia de verdad
Pongamos las cifras una al lado de otra, con la misma convención mezclada 3:1 de entrada a salida que Epoch AI usa para comparar precios.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| Publicación | 05/02/2026 | 14/08/2026 | 26/08/2026 |
| Pesos | Cerrados | Apache 2.0 | MIT |
| Intelligence Index | 44,9 | 52,0 | 57 |
| Precio por millón de entrada | 5,00 $ | 0,45 $ | 0,15 $ |
| Precio por millón de salida | 25,00 $ | 3,20 $ | 0,50 $ |
| Mezclado (3:1) | 10,00 $ | 1,09 $ | 0,24 $ |
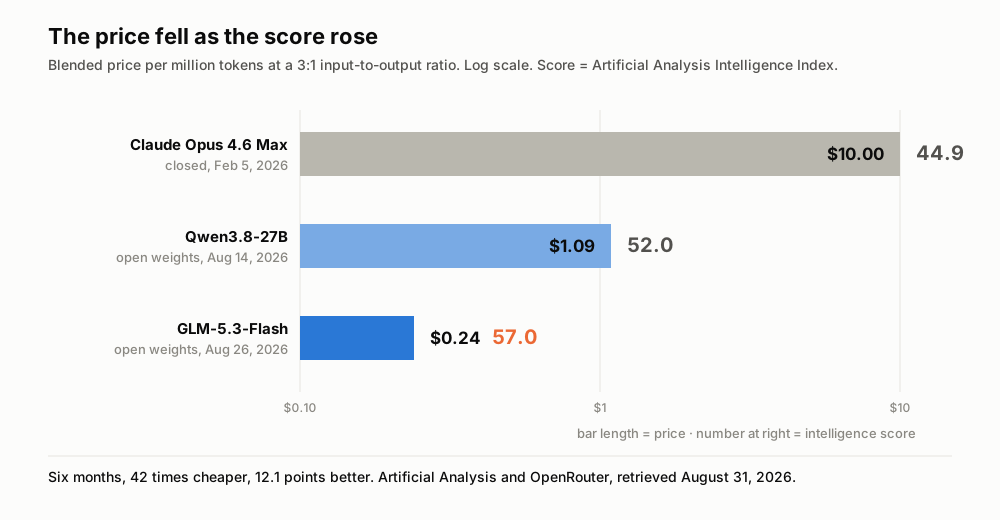
La longitud de la barra es el precio; el número a la derecha de cada barra es la puntuación de inteligencia. Artificial Analysis y OpenRouter, consultados el 31 de agosto de 2026.
GLM-5.3-Flash cuesta 42 veces menos que el buque insignia cerrado de febrero y puntúa 12,1 puntos más en el mismo índice independiente. Frente al 27B abierto del que escribimos hace diez días, es 4,6 veces más barato y 5 puntos mejor. Ambas brechas se abrieron en seis meses.
Es la misma curva que nuestro artículo sobre Qwen3.8 midió desde el otro extremo: la serie de umbral fijo de Epoch AI, que mantiene constante una puntuación de benchmark y sigue el modelo más barato que la alcanza, halló que el rendimiento de nivel GPT-4 cayó de 37,50 dólares por millón de tokens en marzo de 2023 a 0,18 dólares en febrero de 2025: 208 veces más barato en 23 meses. GLM-5.3-Flash es el aspecto que tiene esa curva cuando alcanza la frontera actual en lugar de una de hace tres años.
Y fíjate en la gama. Esto no es el buque insignia. «Flash», en la nomenclatura de cualquier laboratorio, designa al hermano barato, rápido y de alto volumen del modelo con el que de verdad quieren impresionarte. El hecho interesante no es que un laboratorio chino haya publicado un modelo potente. Es que la referencia económica está ya lo bastante cerca de la frontera como para que una semana de pruebas anónimas cara a cara no delatara el juego de inmediato.
Cuatro cosas que no hemos podido verificar, marcadas como tales
El entusiasmo en torno a este lanzamiento se adelanta a la evidencia en puntos concretos. Aquí están.
La afirmación de que Ox Alpha «supera a GPT-5.6» en pruebas de contexto de un millón de tokens procede de artículos de terceros, no de ninguna metodología publicada que hayamos podido inspeccionar, y el objetivo de comparación de la propia Z.AI es Claude Opus 4.8, no GPT-5.6. Trata la comparación con GPT-5.6 como una afirmación comunitaria no verificada.
La muy repetida puntuación del 80 % en pass@1 de DeepSWE no es comparable con los más de 96 % de SWE-bench Verified que aparecen a su lado en las mismas tablas. Arnés distinto, conjunto de tareas distinto, dificultad distinta. Cualquier tabla que los ponga en filas contiguas está produciendo una clasificación que no existe.
La afirmación de Z.AI de que toda la semana sigilosa se sirvió sobre aceleradores chinos domésticos, con una mejora de 3x en el servicio de extremo a extremo y un coste por token comparable al del hardware NVIDIA, procede del proveedor y no ha sido auditada de forma independiente. Si se sostiene, es el detalle más trascendente de la historia; ahora mismo es una afirmación de nota de prensa.
Y la vista previa gratuita era una subvención, no una gama. Se acabó. El precio actual es de 0,15 y 0,50 dólares, con un descuento promocional del 50 % vigente hasta el 9 de septiembre de 2026 a las 16:00 UTC, lo que significa que la cifra honesta en régimen estable es la que no lleva descuento: presupuesta contra 0,15 / 0,50 dólares y no contra lo que cuesta esta semana.
Qué hacen 24 centavos en una canalización que escucha, traduce y resume
Los productos de voz están inusualmente expuestos al precio de los tokens, porque generan transcripciones y luego las leen repetidamente. Cada paso posterior —depuración, traducción, resumen, respuesta a preguntas— vuelve a ingerir el mismo texto. Aquí está la aritmética, con todos los supuestos sobre la mesa.
- Parte de una unidad de trabajo real. Una reunión de 60 minutos entre dos personas, a unas 130 palabras por minuto, produce unas 7.800 palabras. Con etiquetas de hablante y marcas de tiempo, cuenta 12.000 tokens de transcripción.
- Añade la pasada de resumen. Toda la transcripción como entrada, notas estructuradas como salida: 12.000 tokens de entrada, unos 800 de salida.
- Añade traducción en directo a tres idiomas. Cada pasada lee la transcripción y escribe un volumen comparable: 12.000 de entrada y 12.000 de salida, tres veces.
- Suma la reunión. 48.000 tokens de entrada y 36.800 de salida.
- Ponle precio dos veces. A los 0,15 / 0,50 dólares de GLM-5.3-Flash, esa reunión cuesta 2,6 centavos. A los 5,00 / 25,00 dólares de Claude Opus 4.6, la misma reunión cuesta 1,16 dólares.
Una diferencia de 45 veces en una sola hora de audio no es la optimización de una partida contable. Es la diferencia entre una función cuyo uso mides con cuidado y una función que dejas encendida por defecto. A 1,16 dólares por reunión, traducir a tres idiomas para todos los usuarios es una decisión que alguien de finanzas tiene que aprobar. A 2,6 centavos, es una casilla de verificación.
Esa es la parte de esta historia que sobrevive al nombre en clave. El lanzamiento sigiloso fue una maniobra de marketing, y buena. El hecho duradero es que la gama barata del catálogo de un laboratorio mediano entrega ya 57 puntos de índice a 24 centavos mezclados, con una licencia MIT adjunta para que puedas ejecutarlo tú mismo si el precio se mueve alguna vez en la dirección equivocada.
Conclusión: la frontera ya no es donde están los precios interesantes
Durante tres años, la pregunta sobre selección de modelo fue «cuánto puedes permitirte acercarte a la frontera». Los seis días de Ox Alpha respondieron a otra distinta: cuánta capacidad hay ya por debajo de la gama insignia, con precio de materia prima, publicada por laboratorios lo bastante seguros como para probarla con su nombre retirado.
El dividendo del anonimato solo se cobra si el modelo es lo bastante bueno como para sobrevivir a una semana sin marca. Z.AI lo cobró. El próximo nombre en clave que aparezca en una plataforma de enrutado merece el mismo trato que recibió Ox Alpha: pruébalo en tus propias tareas antes de que nadie te diga de quién es, porque durante esa semana esa es la única evaluación honesta que consigue nadie.
Dónde encaja Telli.sh: esta curva es la razón por la que construimos nuestra canalización de voz sobre una capa de proveedores de motores en lugar de alrededor de la API de un único proveedor. Telli.sh enruta transcripción, traducción y resumen a través de motores intercambiables, de modo que un escalón hacia abajo en esta curva de precios llega como mejores notas al mismo precio, no como un anuncio de tarifas. La parte que ningún lanzamiento de modelo te da es el resto del trabajo: capturar una hora de audio sin perderla, mantener separados a los hablantes, traducir en directo a 15 idiomas y dejarte notas que todavía puedas buscar el trimestre que viene.
Empezar una nota IA en directo
Fuentes
- Página del modelo
stealth/ox-alphaen OpenRouter — fecha de publicación del 20 de agosto de 2026, contexto de un millón de tokens y la línea añadida que confirma ZAI GLM-5.3-Flash; consultada el 31 de agosto de 2026 - Página del modelo
z-ai/glm-5.3-flashen OpenRouter — precios actuales y la ventana de descuento promocional hasta el 9 de septiembre de 2026; consultada el 31 de agosto de 2026 - Ficha de modelo de Hugging Face, zai-org/GLM-5.3-Flash — 320.000 millones de parámetros totales / 18.000 millones activos, corpus multimodal de 30 billones de tokens, licencia MIT, ajustes de
reasoning_efforty la afirmación de acercarse a Claude Opus 4.8 - El anónimo Ox Alpha procesa 26 billones de tokens en OpenCode y bate el récord de lanzamiento de OpenRouter — RuntimeWire, 26 de agosto de 2026 — 26 billones de tokens, 327.000 usuarios, 8.328.244 sesiones, la cifra del 93 % de caché y el récord de 11,6 billones de tokens de OpenRouter
- Uso, especificaciones e indicios sobre la identidad de Ox Alpha — LLM Rumors, 25 de agosto de 2026 — peticiones diarias y el primer puesto entre 558 modelos
- El modelo sigiloso de nivel frontera Ox Alpha aparece gratis en OpenRouter y OpenCode — WinBuzzer, 24 de agosto de 2026 — la afirmación de capacidad de 100 billones de tokens diarios y la estimación de GPU de Teortaxes
- La china Z.AI creó el modelo sigiloso Ox Alpha, que rivaliza con DeepSeek — Bloomberg vía Yahoo Finance, 26 de agosto de 2026 — la confirmación de identidad de primera mano
- El modelo sigiloso que superó a DeepSeek pertenece a Zhipu — The Next Web — cobertura de la revelación y compromiso de pesos abiertos
- Modelos sigilosos de OpenRouter: quiénes resultaron ser — Digital Applied, 22 de agosto de 2026 — el censo de catorce fichas, fechas de revelación, niveles de evidencia y la comparación de condiciones de datos
- Artificial Analysis: análisis de inteligencia, rendimiento y precio de GLM-5.3-Flash — Intelligence Index 57, coste de evaluación de 138,02 dólares, 45 tokens por segundo, 150 millones de tokens generados; consultada el 31 de agosto de 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 de marzo de 2025 — la escalera de precios de umbral fijo tras la cifra de 208 veces
- Nuestro antes y después sobre el regreso de los modelos locales — las cifras de Qwen3.8-27B, la curva de precios y el desfase de alcance